Qu'est-ce que la Neural Architecture Search ? Quand l'IA conçoit son propre cerveau
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Concevoir un réseau de neurones exigeait autrefois un spécialiste de longue expérience, qui procédait par hypothèses éclairées : combien de couches ? Quelle taille ? Quels schémas de connexion ? Il fallait ensuite attendre plusieurs jours d'entraînement pour savoir si les choix avaient fonctionné.
La Neural Architecture Search inverse ce processus. Au lieu qu'un humain expérimente des architectures, un algorithme parcourt des milliers de conceptions possibles, entraîne et évalue chacune, puis converge vers une structure plus performante que ce qu'un concepteur isolé aurait trouvé. C'est l'un des exemples les plus clairs d'une IA utilisée pour améliorer l'IA.
Le cœur technique
La Neural Architecture Search (NAS) est une technique de machine learning qui automatise la conception des architectures de réseaux de neurones. Au lieu qu'un humain fixe le nombre de couches, les types de connexions, les fonctions d'activation et la taille des couches, la NAS traite ces choix de conception comme des paramètres à optimiser.
Ce domaine a été défriché chez Google Brain en 2016, quand Barret Zoph et Quoc Le ont utilisé l'apprentissage par renforcement pour rechercher des structures de réseaux de neurones optimales, produisant des architectures qui égalaient ou surpassaient les meilleurs modèles conçus à la main en reconnaissance d'images et en traitement du langage. Le revers : le calcul. Ces travaux d'origine exigeaient 800 GPU pendant des semaines.
La décennie écoulée s'est attachée à rendre la NAS praticable. Les techniques modernes, comme la NAS one-shot et la recherche d'architecture différentiable (DARTS), trouvent de bonnes architectures en quelques heures sur un seul GPU. Ces méthodes sont désormais intégrées aux plateformes AutoML d'entreprise : des équipes sans expertise ML poussée peuvent donc profiter de la NAS sans lancer la recherche elles-mêmes.
Comment fonctionne la recherche
Tout système de NAS repose sur trois composants qui travaillent ensemble :
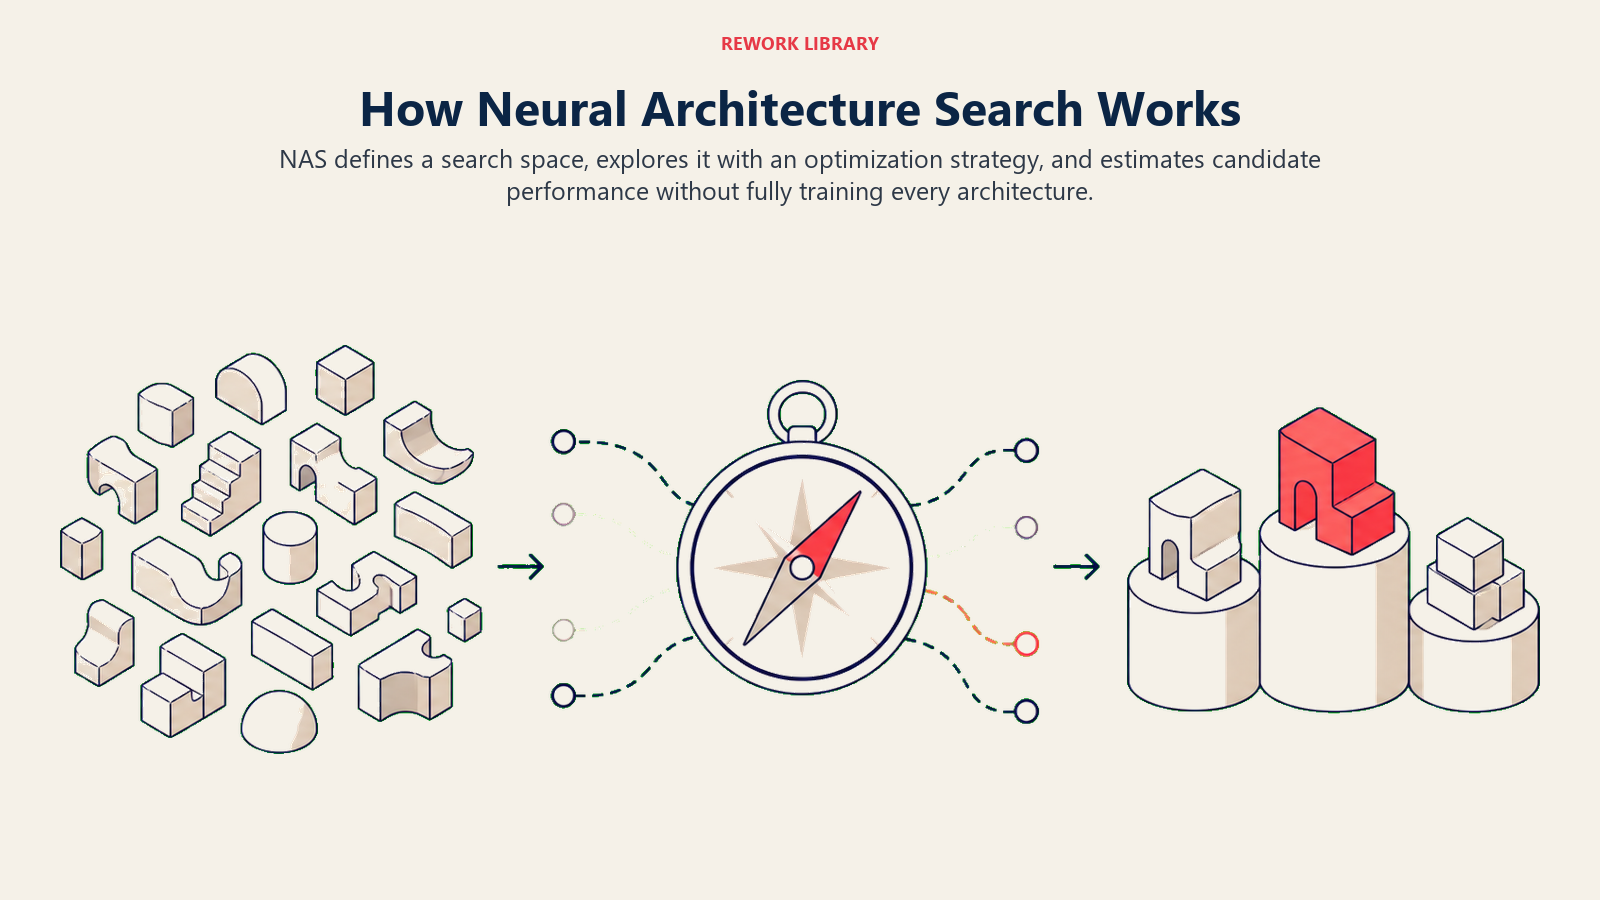
L'espace de recherche définit les choix d'architecture envisageables. Un grand espace couvre davantage de possibilités, mais prend plus de temps à explorer. Un espace bien conçu encode la connaissance du domaine : pour les tâches d'image, il peut se concentrer sur les couches convolutives et sur des schémas de connectivité dont l'efficacité est connue en vision ; pour les tâches de séquences, sur les mécanismes d'attention.
La stratégie de recherche décide comment explorer cet espace efficacement. Une recherche aléatoire naïve essaierait des milliers d'architectures au hasard et évaluerait chacune depuis zéro. Les stratégies modernes sont plus fines : l'apprentissage par renforcement entraîne un contrôleur qui apprend quels choix tendent à donner de bons résultats. Les algorithmes évolutionnaires entretiennent une population d'architectures et la font évoluer vers de meilleures performances. Les méthodes différentiables transforment les choix d'architecture discrets en paramètres continus que la descente de gradient peut optimiser directement, ce qui rend la recherche plusieurs ordres de grandeur plus rapide.
La stratégie d'estimation des performances évalue les architectures candidates sans le coût d'un entraînement complet de chacune. Entraîner une seule architecture jusqu'à convergence peut prendre des jours. Des techniques d'estimation comme le partage de poids, l'arrêt précoce ou l'entraînement sur de petits sous-ensembles de données permettent aux systèmes de NAS d'évaluer des milliers de candidats à un coût raisonnable.
Ce que produit la NAS
Les architectures issues de la NAS paraissent souvent étranges à l'œil humain. Elles rompent la structure ordonnée, couche après couche, qu'un concepteur humain dessinerait. Elles comportent des connexions de saut inhabituelles, des tailles de couches asymétriques et des micro-motifs récurrents que la recherche a jugés efficaces, sans qu'un humain ait besoin de comprendre pourquoi ils fonctionnent.
Et elles fonctionnent bien. EfficientNet, découvert par NAS, est resté pendant plusieurs années l'architecture dominante de classification d'images, surpassant les modèles conçus à la main à chaque point d'arbitrage entre précision et efficacité. Des variantes de MobileNet trouvées par NAS font tourner la compréhension d'images sur les smartphones et les appareils embarqués. MnasNet, optimisé spécifiquement pour le matériel mobile, réalise de la classification d'images sur des téléphones Android avec une latence de 75 ms, pour une précision équivalente à celle de modèles dix fois plus grands.
La prise en compte du matériel est un trait distinctif. La NAS peut optimiser non seulement la précision, mais aussi la latence sur un matériel précis, l'empreinte mémoire, la consommation d'énergie, ou toute combinaison de ces critères. Un modèle théoriquement efficace peut tourner lentement sur votre matériel d'inférence réel, parce qu'il s'adapte mal à la hiérarchie mémoire du GPU. Une NAS qui cherche directement sur des benchmarks matériels trouve des architectures rapides en pratique, et pas seulement sur le papier.
L'argumentaire métier : quand la NAS vaut-elle le coup ?
La NAS occupe un coin bien précis des décisions d'investissement en IA. Elle ne convient pas à toutes les équipes ni à tous les projets.
La NAS a du sens quand :
- Vous déployez un modèle à fort volume, où une baisse de 20 % du coût d'inférence se cumule en économies réelles
- Vous déployez sur du matériel contraint (mobile, appareils edge, systèmes embarqués) où les architectures standard ne tiennent pas
- Vous construisez un produit dont la qualité du modèle est un facteur de différenciation, et vous pouvez investir pour trouver la meilleure architecture possible
- Vous êtes un fournisseur de plateforme qui développe des capacités de base que de nombreux produits utiliseront
La NAS a moins de sens quand :
- Vous pouvez affiner un modèle pré-entraîné et qu'il répond à vos exigences (en général, le bon premier réflexe)
- Votre cas d'usage de l'IA évolue souvent, et l'architecture que vous optimisez aujourd'hui sera remplacée dans six mois
- Vous n'avez ni l'infrastructure ni l'expertise pour mener même une NAS moderne et efficace
La voie intermédiaire consiste à recourir aux plateformes AutoML qui intègrent la NAS en interne. Google Cloud AutoML, Azure Automated Machine Learning et Amazon SageMaker Autopilot s'appuient tous sur des techniques dérivées de la NAS, ce qui permet aux équipes d'en tirer un certain bénéfice sans lancer la recherche elles-mêmes.
La NAS dans le contexte de l'IA moderne
L'essor des grands modèles de langage et des foundation models a déplacé le terrain où la NAS a le plus d'impact. Pour les tâches de langage, affiner un LLM pré-entraîné l'emporte presque toujours sur l'entraînement d'une architecture optimisée par NAS à partir de zéro. Le foundation model contient trop de connaissances pré-apprises pour qu'on y renonce.
Mais la NAS reste très pertinente pour :
Les domaines spécialisés où il n'existe pas de foundation models, ou bien mal adaptés, comme l'imagerie médicale, les données de capteurs industriels et certains types de données scientifiques.
Le déploiement en edge, où la compression de modèles et la NAS attentive au matériel produisent ensemble des architectures qui tiennent sur des appareils aux contraintes sévères de mémoire et de calcul.
La conception de modèles efficaces pour du nouveau matériel, où les fabricants de puces utilisent la NAS pour trouver des architectures qui exploitent les caractéristiques propres à leur silicium.
L'architecture Transformer elle-même a été affinée par des processus de recherche proches de la NAS. De nombreuses innovations d'architecture modernes (schémas d'attention efficaces, couches creuses, structures de mixture d'experts) sont issues d'une recherche systématique parmi des choix d'architecture, même quand les chercheurs ne parlaient pas de NAS.
Concepts d'IA connexes
- Réseaux de neurones - Les briques de base que la NAS assemble en architectures
- Deep Learning - Le cadre plus large dans lequel s'inscrit la NAS
- Compression de modèles - Technique complémentaire pour faire tenir les modèles sur du matériel contraint
- Architecture Transformer - La famille d'architectures dominante que la NAS a aidé à affiner
- Edge AI - Le contexte de déploiement où la NAS attentive au matériel est la plus précieuse
- Foundation models - L'approche alternative quand le pré-entraînement à grande échelle l'emporte sur la recherche d'architecture sur mesure
Ressources externes
- DARTS Paper - L'article sur la recherche d'architecture différentiable qui a rendu la NAS praticable
- AutoML.org - Panorama des méthodes de machine learning automatisé, dont la NAS
Questions fréquentes sur la Neural Architecture Search
Qu'est-ce que la Neural Architecture Search ?
La Neural Architecture Search (NAS) est une méthode automatisée pour trouver des structures de réseaux de neurones optimales en explorant systématiquement des choix de conception comme les types de couches, leur taille et les schémas de connexion. Au lieu qu'un concepteur humain définisse l'architecture, un algorithme parcourt des milliers de candidats et repère ceux qui réussissent le mieux sur une tâche et une cible matérielle données.
La NAS est-elle pertinente si l'on utilise des modèles pré-entraînés ?
Moins pour les tâches de langage, où l'affinage d'un foundation model pré-entraîné est presque toujours le meilleur point de départ. La NAS reste très pertinente pour les domaines spécialisés sans bon foundation model, pour les déploiements soumis à des contraintes matérielles et pour tous les cas où entraîner un modèle à partir de zéro se justifie.
Quelle est la différence entre la NAS et l'AutoML ?
L'AutoML est la catégorie plus large des techniques qui automatisent certaines parties du pipeline de machine learning : prétraitement des données, feature engineering, sélection de modèle et réglage des hyperparamètres. La NAS vise spécifiquement l'automatisation de la conception de l'architecture du modèle. De nombreuses plateformes AutoML intègrent la NAS comme un composant parmi d'autres automatisations.
Combien de temps prend la NAS ?
Cela varie énormément. Les premières NAS exigeaient 800 GPU pendant des semaines. Les techniques modernes et efficaces, comme DARTS, trouvent des architectures compétitives en quelques heures sur un seul GPU. Avec les plateformes AutoML dans le cloud, vous obtenez des choix d'architecture de qualité NAS en quelques minutes, même si la recherche s'exécute sur l'infrastructure de la plateforme et non sur la vôtre.
