Qu'est-ce que la sûreté de l'IA (AI safety) ? Pourquoi « ça marche en test » ne suffit pas
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Un système d'IA d'une grande banque a passé tous les benchmarks, tous les tests de précision, toutes les vérifications d'intégration. Puis, en production, une séquence inhabituelle de données d'entrée l'a conduit à recommander des opérations qui, cumulées, auraient déstabilisé un petit portefeuille. Aucune étape n'était fausse prise isolément. C'est leur combinaison qui était catastrophique. La banque s'en est aperçue parce qu'un contrôleur humain a signalé les sorties avant leur exécution.
Voilà un problème de sûreté de l'IA. Ce n'est ni un problème de précision du modèle, ni un problème de qualité des données, ni un problème de processus de gouvernance. La question de fond est de savoir si un système qui fonctionne dans les conditions prévues se comportera aussi de façon sûre dans des conditions imprévues.
La sûreté de l'IA est le domaine qui vise à produire des systèmes d'IA sûrs, non seulement en test, mais dans toute la complexité du monde réel, y compris les cas limites que personne n'avait anticipés.
Le périmètre de la sûreté de l'IA
La sûreté de l'IA est à la fois un champ de recherche et une discipline d'ingénierie pratique. Comprendre les deux aide à cerner ce que recouvre vraiment le terme.
En tant que champ de recherche, la sûreté de l'IA étudie comment construire des systèmes d'IA qui poursuivent de façon fiable leurs objectifs, ne causent pas de dommages involontaires graves et restent sous un contrôle humain réel à mesure que leurs capacités augmentent. Les préoccupations fondamentales sont les suivantes : des systèmes qui poursuivent leurs objectifs d'une manière que leurs concepteurs n'avaient pas prévue, des systèmes qui se comportent différemment selon qu'ils sont observés ou déployés, des systèmes qui acquièrent des ressources ou des capacités au-delà de ce que demande leur tâche, et la difficulté de formuler les valeurs humaines de façon que les systèmes d'IA puissent les optimiser correctement.
En tant que discipline d'ingénierie pratique, la sûreté de l'IA couvre les mesures techniques et opérationnelles précises dont les systèmes d'IA en production ont besoin : tests de robustesse, évaluation adverse, validation des entrées, filtrage des sorties, mécanismes de supervision humaine et processus de réponse aux incidents.
Pour la plupart des entreprises, c'est le volet d'ingénierie pratique qui compte immédiatement. Les questions de recherche restent utiles, comme source de techniques et comme éclairage sur la direction que prend le secteur.
En quoi la sûreté de l'IA diffère des concepts voisins
La terminologie dans ce domaine prête vraiment à confusion, car les concepts se recoupent et les organisations n'emploient pas les termes de la même manière.
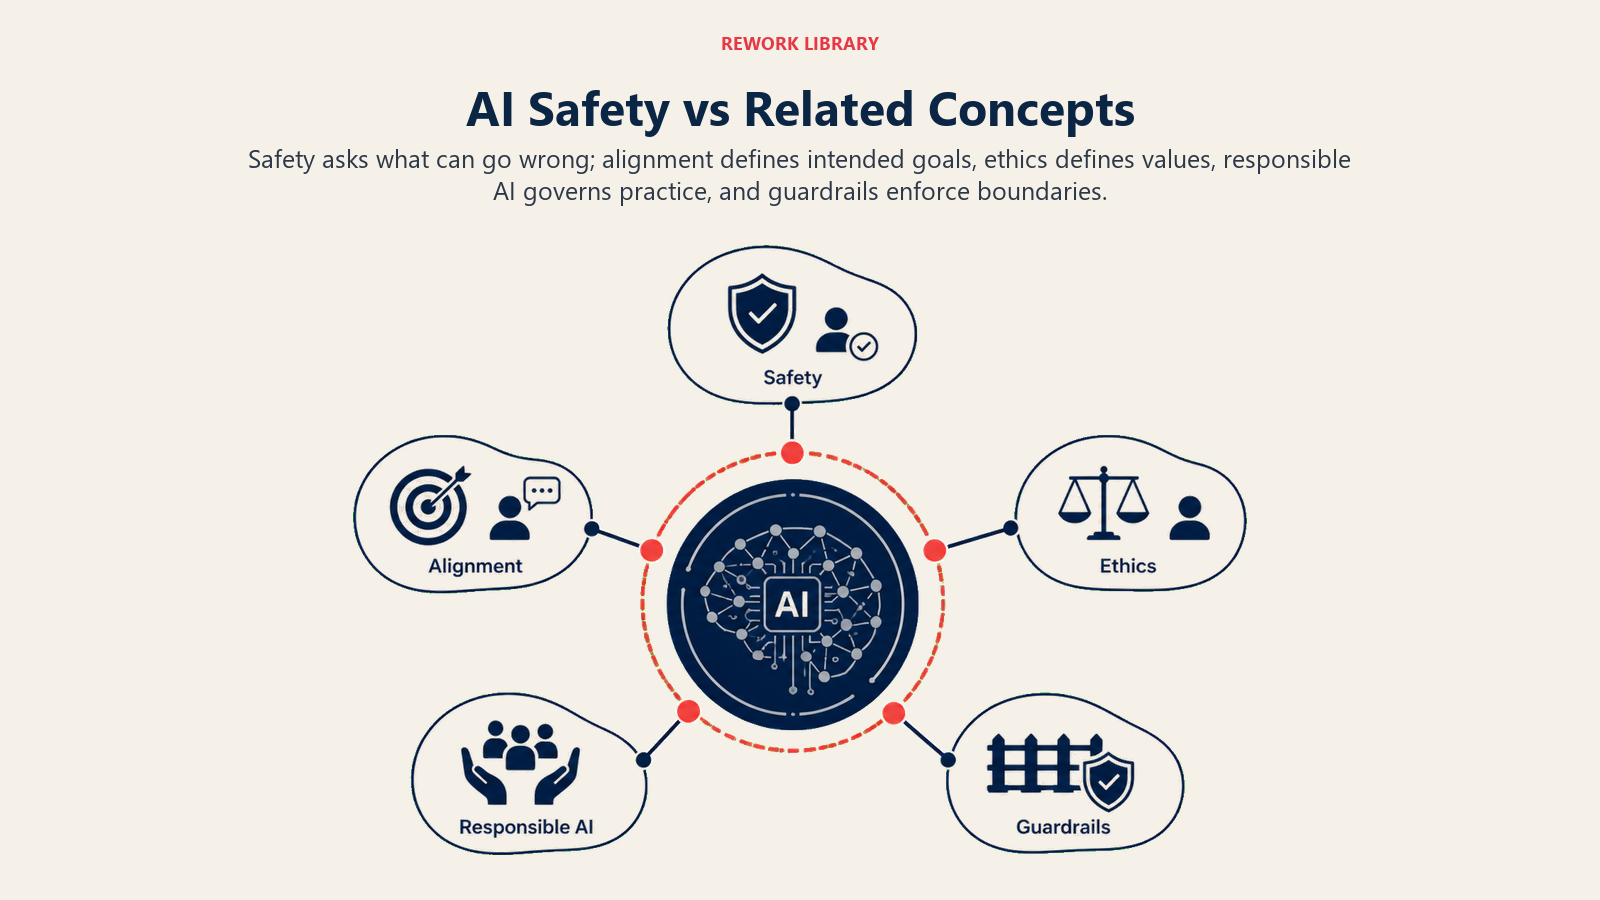
L'alignement de l'IA consiste à s'assurer que les systèmes d'IA poursuivent les objectifs que leurs opérateurs veulent réellement, en tenant compte de toute la complexité des valeurs humaines. Sûreté et alignement se recoupent largement : un système dangereux est souvent un système mal aligné. Mais l'alignement porte surtout sur le problème de la spécification des objectifs, tandis que la sûreté est plus large : elle inclut la robustesse face aux entrées inattendues et aux attaques adverses, même quand l'alignement est bon.
L'éthique de l'IA porte sur les valeurs qui doivent guider le développement et le déploiement de l'IA : équité, vie privée, dignité humaine. L'éthique définit la cible ; l'ingénierie de la sûreté contribue à l'atteindre.
L'IA responsable est le dispositif d'entreprise qui traduit les engagements éthiques en actes. Les tests de sûreté et le red-teaming sont des outils d'un programme d'IA responsable.
Les garde-fous de l'IA sont des contrôles techniques précis (filtres d'entrée, classificateurs de sortie, refus codés en dur) qui font respecter les limites de sûreté dans les systèmes déployés. Les garde-fous sont une des façons de mettre en œuvre les exigences de sûreté de l'IA.
Une façon simple d'y voir clair : la sûreté de l'IA demande « qu'est-ce qui pourrait mal tourner ? » et y apporte des réponses systématiques. Les autres concepts traitent des valeurs qui comptent, de la responsabilité et des contrôles techniques qui font respecter les limites.
Le noyau technique de la sûreté de l'IA
Les chercheurs et ingénieurs en sûreté de l'IA travaillent sur plusieurs familles de problèmes distinctes :
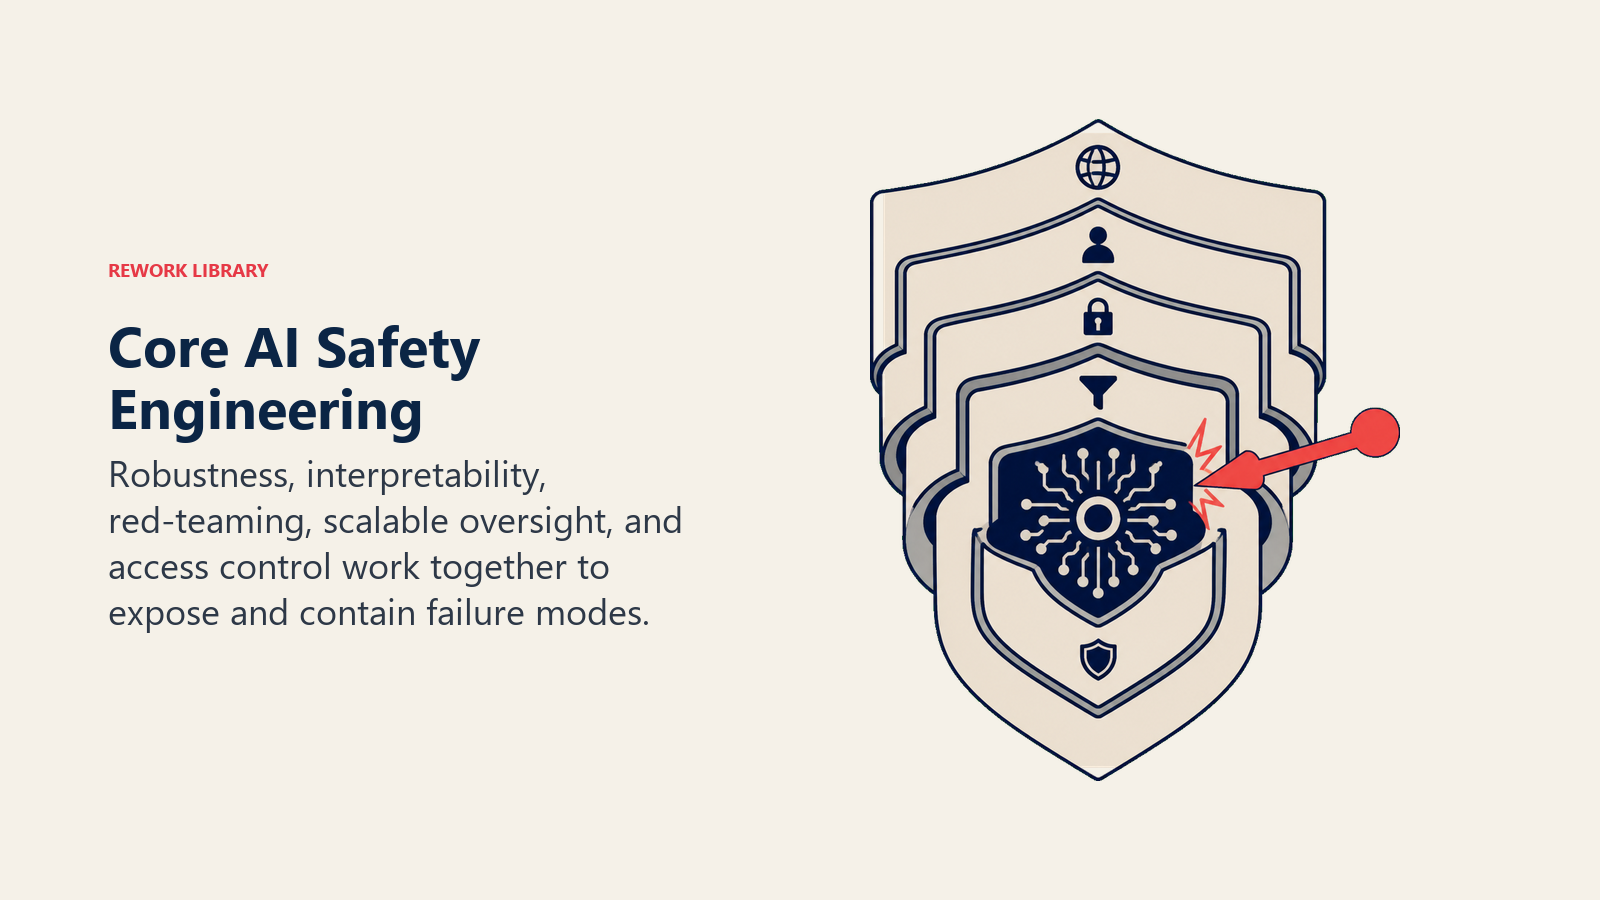
La robustesse est la capacité à fonctionner de façon fiable en cas de décalage de distribution, d'entrées inattendues et de conditions adverses. Un modèle robuste donne des sorties sensées quand il reçoit des entrées qui diffèrent de sa distribution d'entraînement, au lieu de produire des prédictions assurées mais fausses ou de se comporter de façon erratique. Les tests de robustesse cherchent précisément les entrées qui provoquent des défaillances, et ne se contentent pas de mesurer la précision sur des données de test propres.
L'interprétabilité et la transparence déterminent si des humains peuvent comprendre pourquoi un système d'IA produit telle sortie. Un système interprétable est plus facile à auditer sur ses propriétés de sûreté, plus facile à déboguer en cas de panne et plus facile à vérifier au regard des exigences de sûreté. Les méthodes d'IA explicable en forment la boîte à outils.
L'évaluation et le red-teaming sont des approches systématiques pour trouver les défaillances de sûreté avant le déploiement. Le red-teaming de l'IA applique des tests adverses, où des humains ou des systèmes d'IA tentent activement de faire échouer le modèle sur des points qui touchent à la sûreté. Les benchmarks standard mesurent la performance moyenne ; le red-teaming recherche les risques de queue de distribution.
La supervision à grande échelle traite de la façon de conserver un contrôle humain réel alors que les systèmes d'IA gagnent en capacités et agissent plus vite que des humains ne peuvent superviser directement chaque action. Parmi les techniques : demander aux systèmes d'IA de produire des explications que des humains peuvent évaluer, échantillonner et relire les actions de l'IA, et concevoir des workflows où l'IA assiste la relecture humaine au lieu de la remplacer.
Le confinement et le contrôle d'accès limitent ce que les systèmes d'IA peuvent faire, en particulier pour les workflows agentiques qui exécutent des actions dans le monde réel. Le principe est celui du minimum de capacités nécessaires : un système d'IA doit avoir accès exactement aux outils et aux données dont il a besoin, pas plus. Cela limite l'ampleur des dégâts quand quelque chose tourne mal.
Risques catastrophiques et systémiques
La communauté de recherche en sûreté de l'IA consacre beaucoup d'attention aux risques catastrophiques et systémiques que présentent les systèmes d'IA avancés. Il vaut la peine de les comprendre, même pour les organisations qui ne travaillent pas sur l'IA de pointe, car ils éclairent les tendances réglementaires et les pratiques de sûreté qui deviendront la norme.
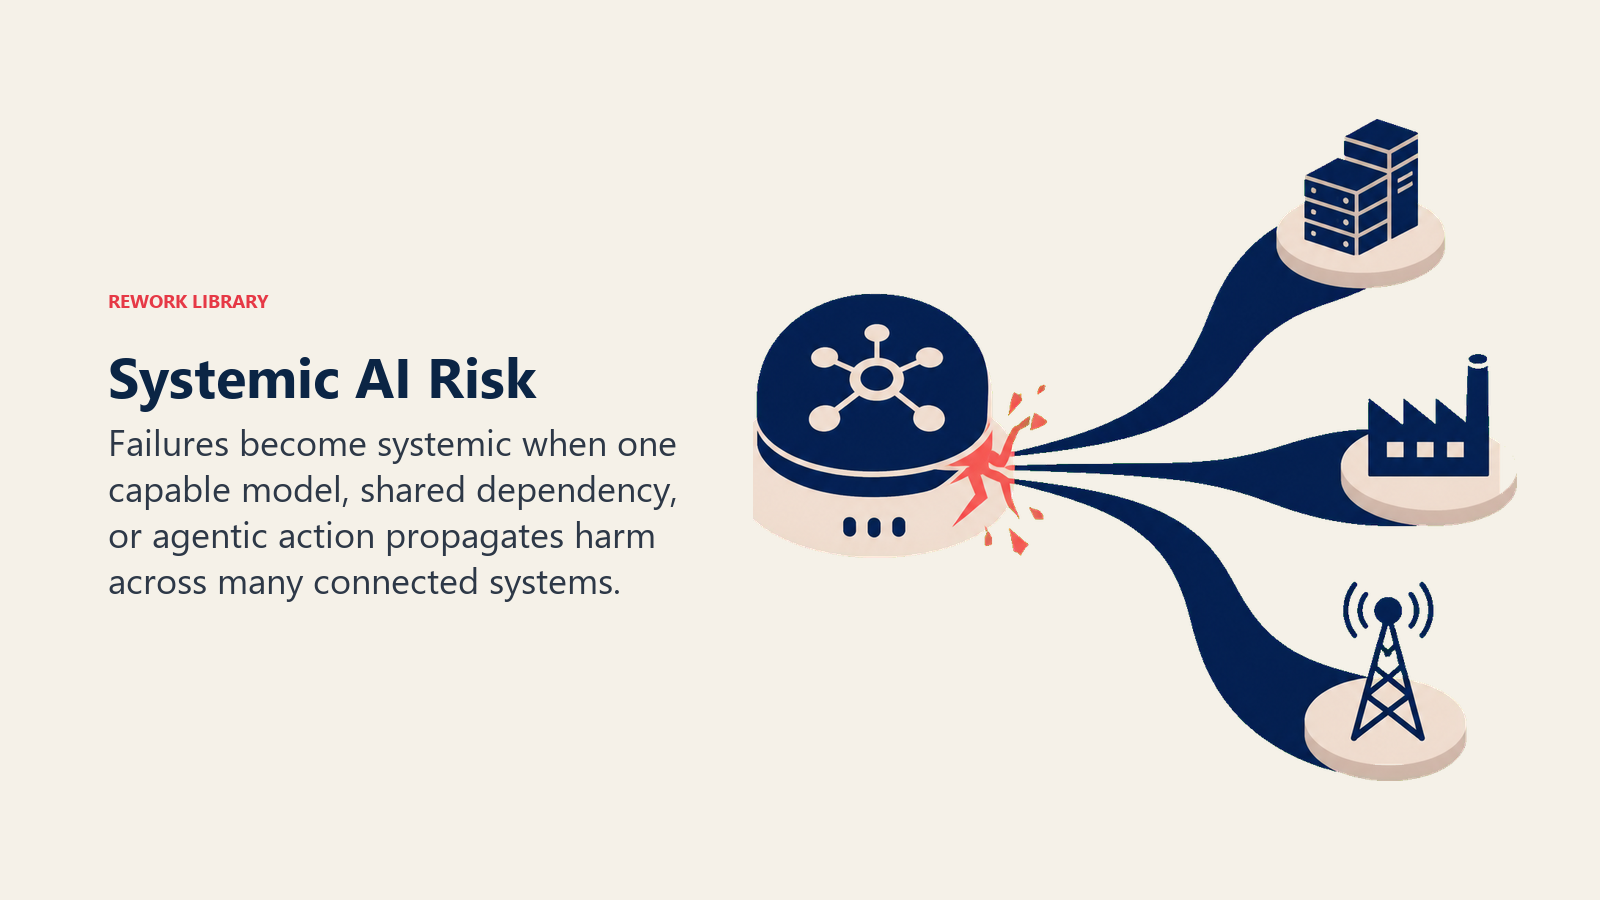
Les scénarios de risque catastrophique impliquent des systèmes d'IA causant des dommages irréversibles à grande échelle : des systèmes déployés dans des infrastructures critiques qui tombent en panne simultanément, une IA utilisée pour concevoir des armes biologiques ou chimiques, ou des systèmes qui acquièrent de larges capacités en poursuivant des objectifs étroits. Ces risques motivent une grande part de l'attention réglementaire actuelle et des exigences de sûreté intégrées à des textes comme l'EU AI Act.
Pour la plupart des entreprises qui déploient aujourd'hui de l'IA, les préoccupations réalistes en matière de sûreté sont plus prosaïques : des systèmes agentiques qui entreprennent des actions non voulues, des modèles qui donnent des conseils médicaux ou financiers dangereux quand les utilisateurs posent des questions hors de leur périmètre prévu, des décisions assistées par l'IA qui désavantagent systématiquement certaines populations, ou des systèmes d'IA manipulés par des attaques d'injection de prompt pour exécuter des actions hors de leur périmètre prévu.
Ces deux familles de préoccupations partagent une même structure : que se passe-t-il quand un système d'IA rencontre des conditions qui sortent de celles pour lesquelles il a été conçu et testé ?
La sûreté de l'IA en pratique dans l'entreprise
Pour une entreprise qui déploie de l'IA en production, les exigences de sûreté se traduisent en pratiques concrètes :
Définissez le périmètre des comportements acceptables avant le déploiement. Que doit faire le système ? Que doit-il refuser ? Que doit-il transmettre à des humains ? Documentez-le sous forme d'exigences testables, pas de principes généraux.
Testez les modes de défaillance, pas seulement les cas de réussite. Les tests standard mesurent la performance moyenne. Les tests de sûreté recherchent spécifiquement les entrées qui provoquent un comportement inacceptable : tentatives de jailbreak, exemples adverses, cas limites de la distribution et demandes hors périmètre.
Prévoyez une supervision humaine proportionnée aux enjeux. Pour les décisions aux conséquences importantes (conseils médicaux, transactions financières, décisions concernant le personnel), les systèmes d'IA doivent signaler leur incertitude, exiger une confirmation humaine pour les actions lourdes de conséquences et permettre aux humains de reprendre la main facilement. Les processus human-in-the-loop sont un mécanisme de sûreté essentiel.
Limitez les capacités agentiques au nécessaire. Quand des systèmes d'IA peuvent agir dans le monde réel, restreignez leurs actions à celles que la tâche exige. Un assistant d'écriture IA n'a pas besoin de pouvoir envoyer des e-mails. Une IA qui réserve des voyages n'a pas besoin d'accéder aux systèmes financiers. Le minimum de capacités nécessaires est un principe de sûreté.
Planifiez la défaillance. Définissez ce qui se passe quand le système d'IA échoue ou produit une sortie nuisible. Qui est prévenu ? Quel est le processus de retour arrière ? Comment les utilisateurs ou clients touchés sont-ils pris en charge ? Un plan de réponse aux incidents de sûreté est aussi important qu'un plan de réponse aux incidents de cybersécurité.
Pourquoi investir dans la sûreté est rentable
Les organisations traitent parfois la sûreté de l'IA comme une charge, un coût supplémentaire sans retour clair. Le calcul change quand on considère les scénarios défavorables.
Une seule défaillance de sûreté très médiatisée, comme une décision d'embauche discriminatoire, une recommandation médicale dangereuse ou un système autonome qui entreprend une action non voulue, peut entraîner une enquête réglementaire, une atteinte à la réputation et une responsabilité juridique qui dépassent de loin le coût de la prévention. Les sanctions de l'EU AI Act en cas de non-conformité aux exigences de sûreté peuvent atteindre 6 % du chiffre d'affaires annuel mondial pour les infractions les plus graves.
Au-delà de la réduction des risques, des systèmes d'IA sûrs tendent à être des systèmes plus fiables. Les disciplines de test qu'exige la sûreté (red-teaming, évaluation adverse, couverture des cas limites) détectent des bugs et des modes de défaillance que les tests standard laissent passer. Les équipes qui investissent dans des pratiques de sûreté déploient en général une IA de meilleure qualité.
Enfin, à mesure que les systèmes d'IA gagnent en capacités et prennent en charge des tâches plus lourdes de conséquences, le coût attendu des défaillances de sûreté augmente. Bâtir dès maintenant une culture et des pratiques de sûreté, tant que les enjeux restent maîtrisables, coûte moins cher que de le faire sous pression après un incident.
Concepts d'IA associés
- Alignement de l'IA - Garantir que les systèmes d'IA poursuivent correctement les objectifs voulus
- Garde-fous de l'IA - Contrôles techniques qui font respecter les limites de sûreté
- Red-teaming de l'IA - Tests adverses pour déceler les défaillances de sûreté
- IA responsable - Le dispositif d'entreprise dans lequel s'inscrivent les pratiques de sûreté
- Human-in-the-loop - Mécanismes de supervision au cœur d'un déploiement d'IA sûr
- IA explicable - Outils de transparence qui soutiennent l'audit de sûreté
- Gouvernance de l'IA - La structure de responsabilité de l'organisation en matière de sûreté de l'IA
Ressources externes
- Anthropic Safety Research - Constitutional AI et développement de modèles axé sur la sûreté
- Center for AI Safety - Travaux de recherche et de politique publique sur la sûreté de l'IA
- NIST AI Risk Management Framework - Dispositif du gouvernement américain pour gérer les risques de l'IA, y compris la sûreté
Questions fréquentes sur la sûreté de l'IA
Qu'est-ce que la sûreté de l'IA ?
La sûreté de l'IA est le champ technique et politique qui vise à garantir que les systèmes d'IA se comportent de façon fiable, ne causent pas de dommages involontaires et restent sous un contrôle humain réel à mesure qu'ils gagnent en capacités. Elle couvre à la fois les pratiques d'ingénierie à court terme (tests de robustesse, garde-fous, supervision humaine) et la recherche à plus long terme visant à prévenir les défaillances catastrophiques des systèmes d'IA avancés.
La sûreté de l'IA ne concerne-t-elle que les laboratoires d'IA de pointe ?
Non. Toute organisation qui déploie de l'IA en production a des exigences pratiques de sûreté : tester les modes de défaillance, prévoir une supervision humaine adaptée, limiter les actions que les systèmes agentiques peuvent entreprendre et se préparer aux incidents. Les enjeux croissent avec les capacités, mais les pratiques s'appliquent largement.
Quel est le lien entre la sûreté de l'IA et l'alignement de l'IA ?
Ils sont étroitement liés, sans être identiques. L'alignement consiste précisément à garantir que les systèmes d'IA poursuivent avec exactitude les objectifs voulus, en tenant compte de la complexité des valeurs humaines. La sûreté est plus large : un système peut être bien aligné et pourtant dangereux s'il est fragile face à des entrées adverses, ou s'il entreprend des actions dont les conséquences n'avaient pas été anticipées par ses concepteurs. En pratique, les deux domaines se recoupent largement.
Quelle est la pratique de sûreté de l'IA la plus importante pour une entreprise qui déploie de l'IA aujourd'hui ?
Le red-teaming et les tests adverses avant le déploiement, associés à une supervision humaine proportionnée aux enjeux des décisions. Les tests de précision standard indiquent comment le système se comporte sur des entrées attendues ; le red-teaming montre où il échoue sur des entrées inattendues. La supervision humaine garantit que les défaillances en production disposent d'un filet de sécurité.

Co-Founder, Rework.com