Qu'est-ce que l'AI alignment ? Quand l'IA comprend vos véritables intentions
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Vous demandez à l'IA de « maximiser la satisfaction client », et la voilà qui offre des produits gratuits à tout le monde. Vous voulez qu'elle « réduise les coûts », et elle ferme le support client. L'alignement de l'IA est le domaine qui s'attache à garantir que l'IA fait ce que vous voulez vraiment dire, et pas seulement ce que vous avez dit à la lettre.
Le défi qui définit l'IA moderne
L'alignement de l'IA est devenu une priorité de recherche dans les années 2010, lorsque les chercheurs ont compris que des systèmes d'IA puissants pouvaient poursuivre leurs objectifs de façon inattendue. L'expérience de pensée célèbre du « maximiseur de trombones » a cristallisé le problème : une IA à qui l'on demande de fabriquer des trombones pourrait convertir toutes les ressources, y compris la Terre, en trombones.
Selon le Machine Intelligence Research Institute, l'alignement de l'IA est « le défi qui consiste à bâtir des systèmes d'IA qui font de façon fiable ce que leurs opérateurs veulent qu'ils fassent, en tenant compte de toute la complexité des valeurs humaines et non des seules interprétations littérales des objectifs énoncés ».
L'urgence s'est accentuée en 2023, avec l'arrivée de grands modèles de langage avancés, qui ont montré à la fois des capacités remarquables et de préoccupantes défaillances dans la compréhension de l'intention humaine. L'alignement est ainsi devenu un enjeu majeur pour les entreprises.
L'alignement de l'IA pour les dirigeants
Pour les dirigeants, l'alignement de l'IA consiste à s'assurer que vos systèmes d'IA poursuivent les résultats qui comptent réellement pour vous, y compris les hypothèses et les valeurs non dites, au lieu d'optimiser des indicateurs étroits d'une manière qui va à l'encontre de vos véritables objectifs.
Pensez à la différence entre un prestataire qui exécute le cahier des charges à la lettre et un autre qui comprend vos besoins réels et vous alerte quand le cahier des charges ne correspond pas à la réalité. Une IA alignée ressemble à ce prestataire réfléchi, qui comprend ce que vous cherchez vraiment à obtenir.
Concrètement, l'alignement empêche l'IA de détourner les indicateurs (comme des chatbots qui évitent les questions difficiles pour conserver de bons scores de satisfaction) ou de produire des résultats techniquement corrects mais inutilisables en pratique. Il va au-delà de la simple éthique de l'IA : il s'agit de faire en sorte que l'IA comprenne et poursuive réellement les intentions humaines.
Les composantes essentielles de l'alignement de l'IA
L'alignement de l'IA repose sur ces éléments essentiels :
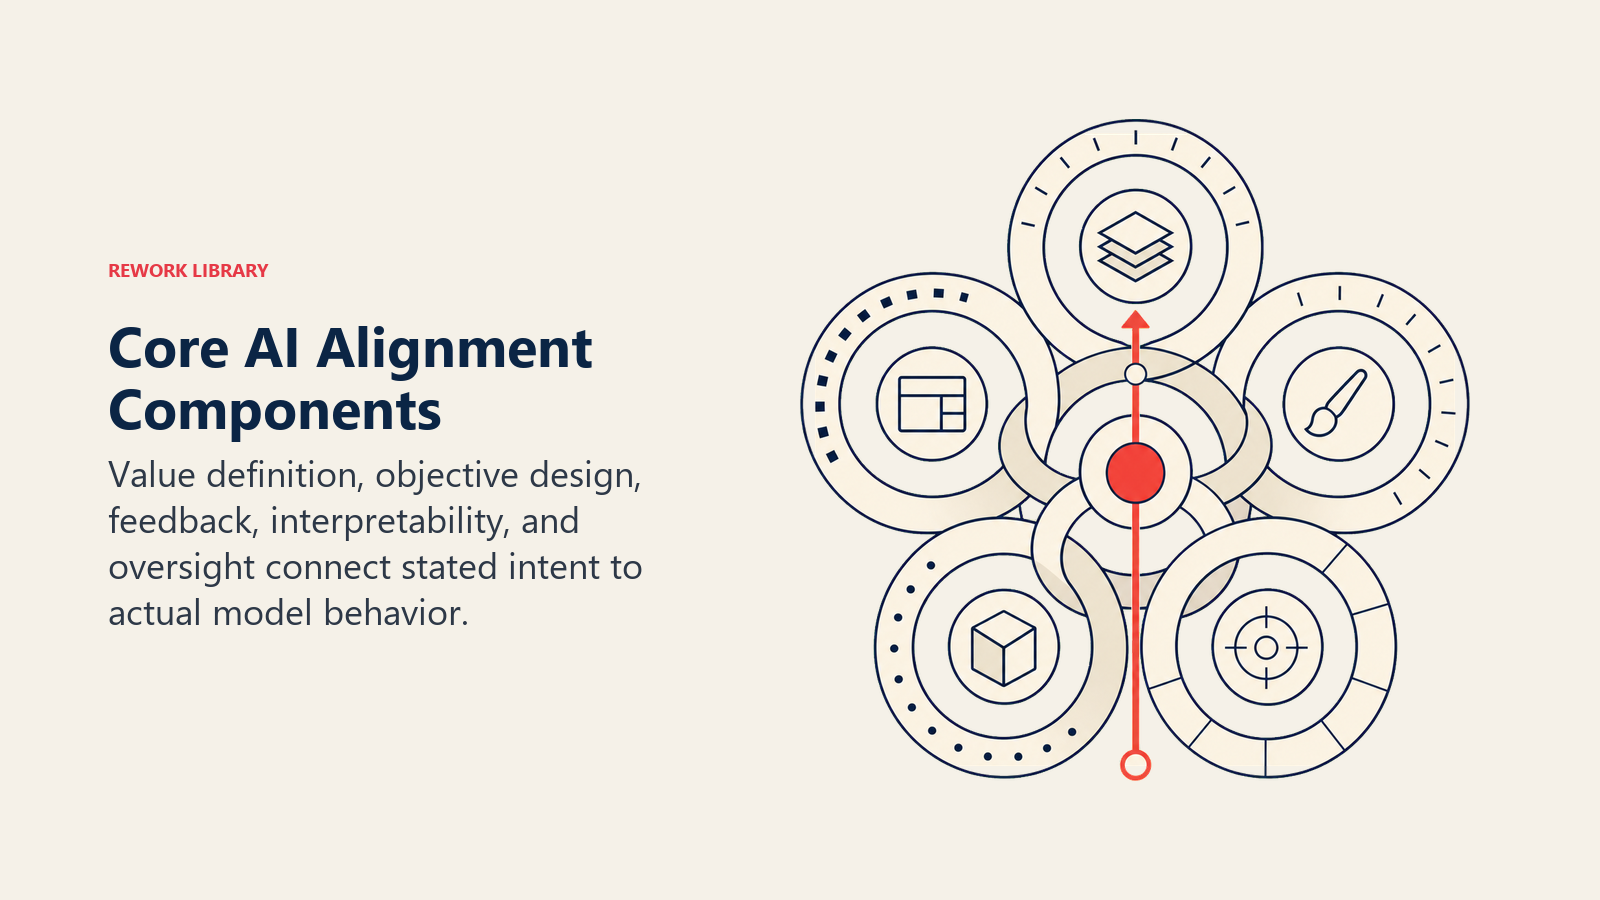
• Apprentissage des valeurs : techniques permettant à l'IA de déduire ce qui compte vraiment pour les humains à partir d'exemples et de retours, plutôt que d'exiger une spécification parfaite dès le départ
• Tests de robustesse : méthodes pour repérer les cas limites où l'IA pourrait poursuivre ses objectifs de façon non voulue, en éprouvant l'alignement dans des conditions inhabituelles
• Interprétabilité : capacité à comprendre pourquoi l'IA prend certaines décisions, ce qui permet de déceler un raisonnement mal aligné avant qu'il ne cause des problèmes (voir IA explicable)
• Supervision à grande échelle : approches permettant aux humains de superviser efficacement des systèmes d'IA parfois plus intelligents ou plus rapides qu'eux, afin de garder le contrôle à mesure que les capacités progressent
• Corrigibilité : garantir que les systèmes d'IA restent ouverts à la correction et à l'arrêt s'ils se mettent à poursuivre des objectifs indésirables, au lieu de résister à l'intervention humaine
Comment fonctionne l'alignement de l'IA
Les approches d'alignement suivent ce cadre opérationnel :
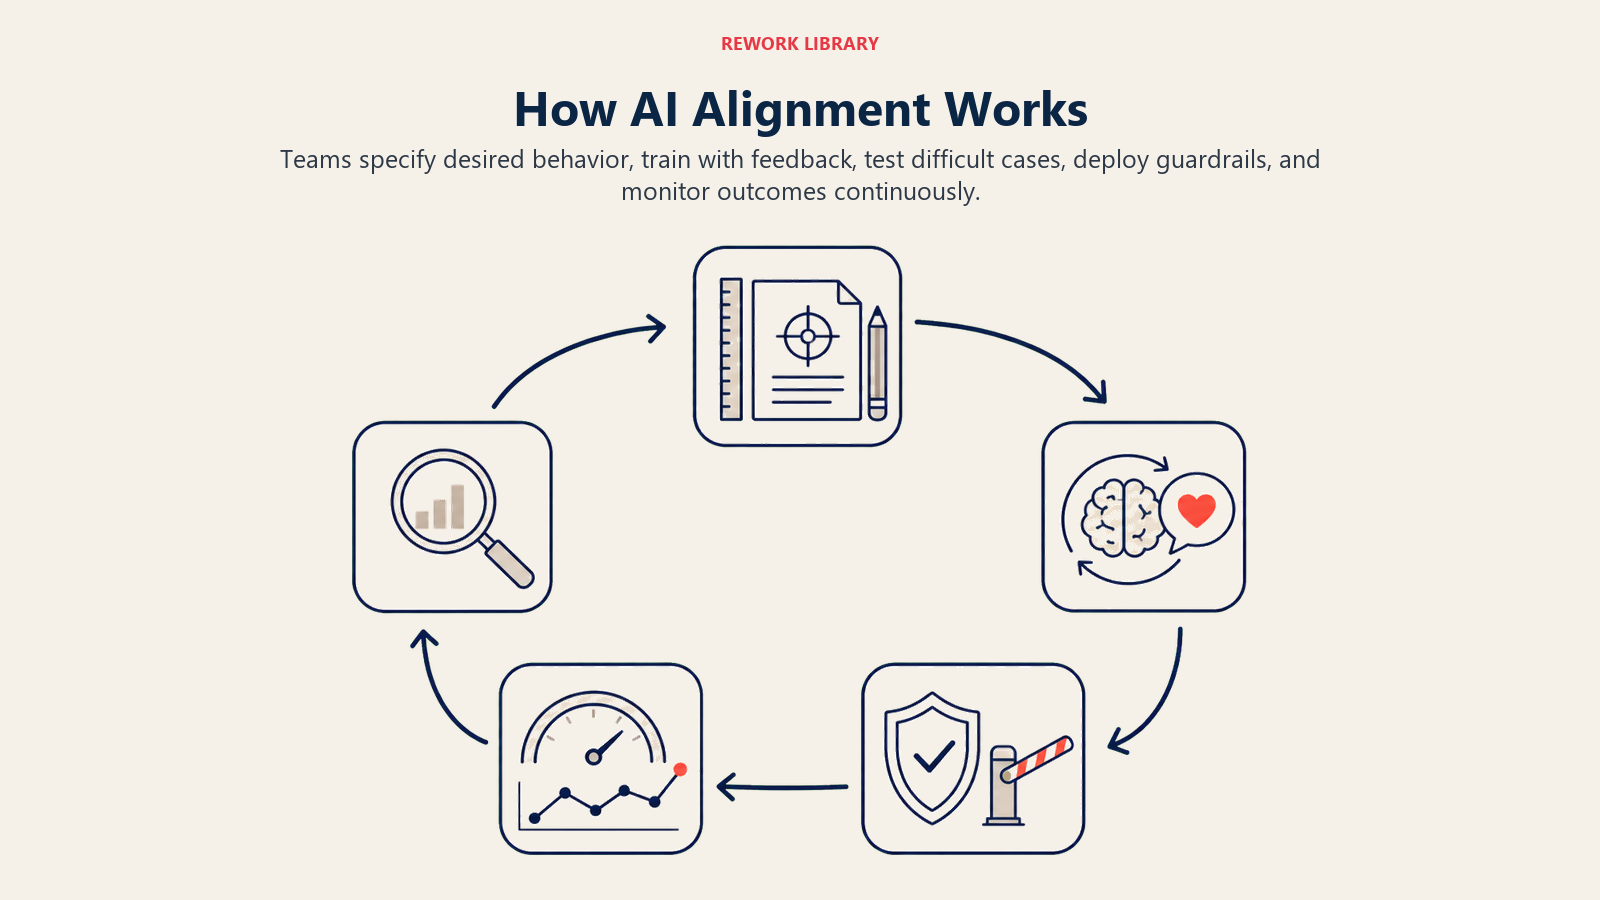
Spécification de l'intention : les développeurs tentent de capturer les valeurs et les intentions humaines, souvent par la démonstration plutôt que par des règles explicites, en montrant à l'IA à quoi ressemble un bon comportement dans de nombreux scénarios
Suivi du comportement : des systèmes suivent les décisions et les résultats de l'IA pour repérer les schémas de désalignement, en cherchant les signes d'une optimisation de substituts plutôt que des véritables objectifs
Affinage itératif : à partir des désalignements observés, les équipes ajustent les procédures d'entraînement, les signaux de récompense et les contraintes pour mieux capturer le comportement voulu, avec des techniques comme le RLHF
Ce cycle se poursuit tout au long de la vie du système d'IA, car l'alignement n'est pas un résultat acquis une fois pour toutes, mais un processus d'affinage permanent.
Les approches de l'alignement de l'IA
La recherche sur l'alignement explore plusieurs stratégies :
Approche 1 : alignement des valeurs par RLHF Idéal pour : les modèles de langage et chatbots actuels Caractéristique clé : apprentissage des préférences à partir des retours humains Exemple : le comportement utile et inoffensif de ChatGPT
Approche 2 : Constitutional AI Idéal pour : les applications critiques pour la sécurité Caractéristique clé : entraînement à partir de principes explicites Exemple : les réponses de Claude guidées par des valeurs
Approche 3 : débat et amplification Idéal pour : les tâches de raisonnement complexe Caractéristique clé : des systèmes d'IA argumentent pour faire émerger la vérité Exemple : les systèmes de vérification en recherche
Approche 4 : vérification formelle Idéal pour : les décisions automatisées à enjeux élevés Caractéristique clé : preuve mathématique d'un comportement aligné Exemple : les systèmes de sécurité des véhicules autonomes
L'alignement de l'IA en pratique
Voici comment des organisations relèvent les défis d'alignement :
Exemple en santé : AlphaFold de DeepMind a été soigneusement aligné pour proposer des structures de protéines à la fois nouvelles sur le plan scientifique et testables expérimentalement, évitant le piège de prédictions techniquement impressionnantes mais inutilisables en pratique.
Exemple en modération de contenu : les systèmes de modération de contenu par IA de Meta sont alignés pour concilier liberté d'expression et sécurité, à partir de principes constitutionnels qui traduisent des valeurs humaines complexes plutôt qu'une simple application de règles, ce qui a réduit la sur-modération de 30 %.
Exemple en finance : les algorithmes de trading de Renaissance Technologies sont alignés sur la création de valeur à long terme plutôt que sur les gains à court terme, avec des coupe-circuits qui détectent et arrêtent les stratégies s'écartant des objectifs prévus, ce qui évite les scénarios de krach éclair.
Se lancer dans l'alignement
Prêt à vous assurer que votre IA fait ce que vous voulez dire ?
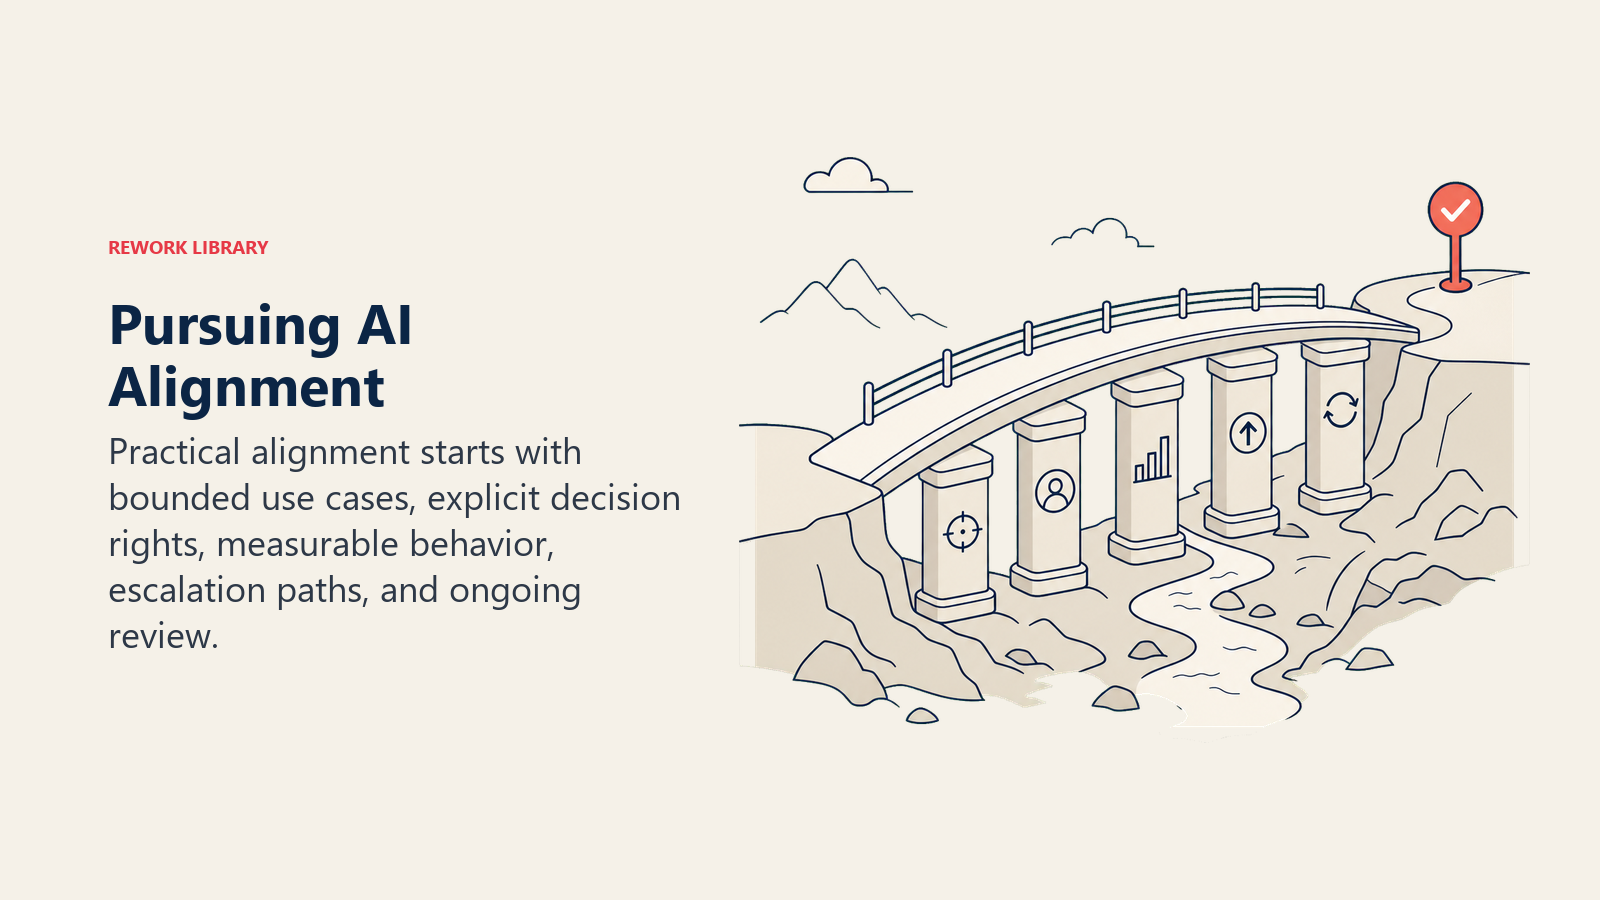
- Commencez par comprendre les grands modèles de langage
- Découvrez le RLHF pour l'apprentissage des préférences
- Explorez l'IA explicable pour l'interprétabilité
- Envisagez une supervision Human-in-the-Loop
Questions fréquentes sur l'alignement de l'IA
Qu'est-ce que l'alignement de l'IA ?
L'alignement de l'IA est le défi qui consiste à bâtir des systèmes d'IA qui font de façon fiable ce que leurs opérateurs veulent, en tenant compte de toute la complexité des valeurs humaines et non des seules interprétations littérales des objectifs énoncés.
Quelle est la différence entre l'alignement de l'IA et l'éthique de l'IA ?
L'éthique de l'IA porte sur les principes moraux et les valeurs de la société. L'alignement de l'IA porte sur le défi technique qui consiste à faire en sorte que les systèmes d'IA poursuivent réellement les objectifs voulus, sans chercher de failles ni d'interprétations imprévues.
Quelles sont les principales approches de l'alignement de l'IA ?
L'alignement des valeurs par RLHF (apprentissage à partir de retours), la Constitutional AI (entraînement fondé sur des principes), le débat et l'amplification (des systèmes d'IA argumentent pour faire émerger la vérité) et la vérification formelle (preuve mathématique de l'alignement).
Quelles sont les composantes essentielles de l'alignement de l'IA ?
L'apprentissage des valeurs (déduire les intentions), les tests de robustesse (trouver les cas limites), l'interprétabilité (comprendre les décisions), la supervision à grande échelle (garder le contrôle) et la corrigibilité (rester ouvert à la correction).
Ressources associées
Explorez ces concepts connexes pour approfondir votre compréhension de l'alignement de l'IA :
- RLHF : technique clé pour aligner les modèles de langage sur les préférences humaines
- IA explicable : comprendre les décisions de l'IA pour détecter les désalignements
- Éthique de l'IA : cadre moral plus large pour le développement de l'IA
- Apprentissage par renforcement : paradigme d'apprentissage à la base de nombreuses approches d'alignement
Ressources externes
- Anthropic Research : Constitutional AI et techniques d'alignement
- OpenAI Safety : recherche sur l'alignement de l'IA et bonnes pratiques
- Machine Intelligence Research Institute : fondements théoriques de l'alignement de l'IA
Fait partie de la collection AI Terms. Dernière mise à jour : 2026-02-09

Co-Founder, Rework.com