Qu'est-ce que la latence de l'IA ? Pourquoi le temps de réponse détermine la valeur de l'IA en production
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Un commercial demande à votre assistant IA de résumer un compte avant un appel. Si la réponse arrive en 2 secondes, il l'utilise à chaque fois. Si elle met 18 secondes, il cesse de s'en servir en moins d'une semaine. La fonctionnalité existe toujours et l'IA fonctionne toujours, mais la latence a tué l'adoption avant que quiconque ne s'en aperçoive.
Pour les dirigeants qui déploient de l'IA, la latence n'est pas un détail technique. Elle sépare un investissement qui change les comportements d'un investissement discrètement abandonné. Comprendre ce qui la détermine et ce que vous pouvez maîtriser est une nécessité pratique pour quiconque parraine un déploiement d'IA.
Ce que la latence signifie dans les systèmes d'IA
La latence est le temps écoulé entre l'envoi d'une requête à un système d'IA et la réception d'une réponse complète. En langage courant : combien de temps cela prend-il ?
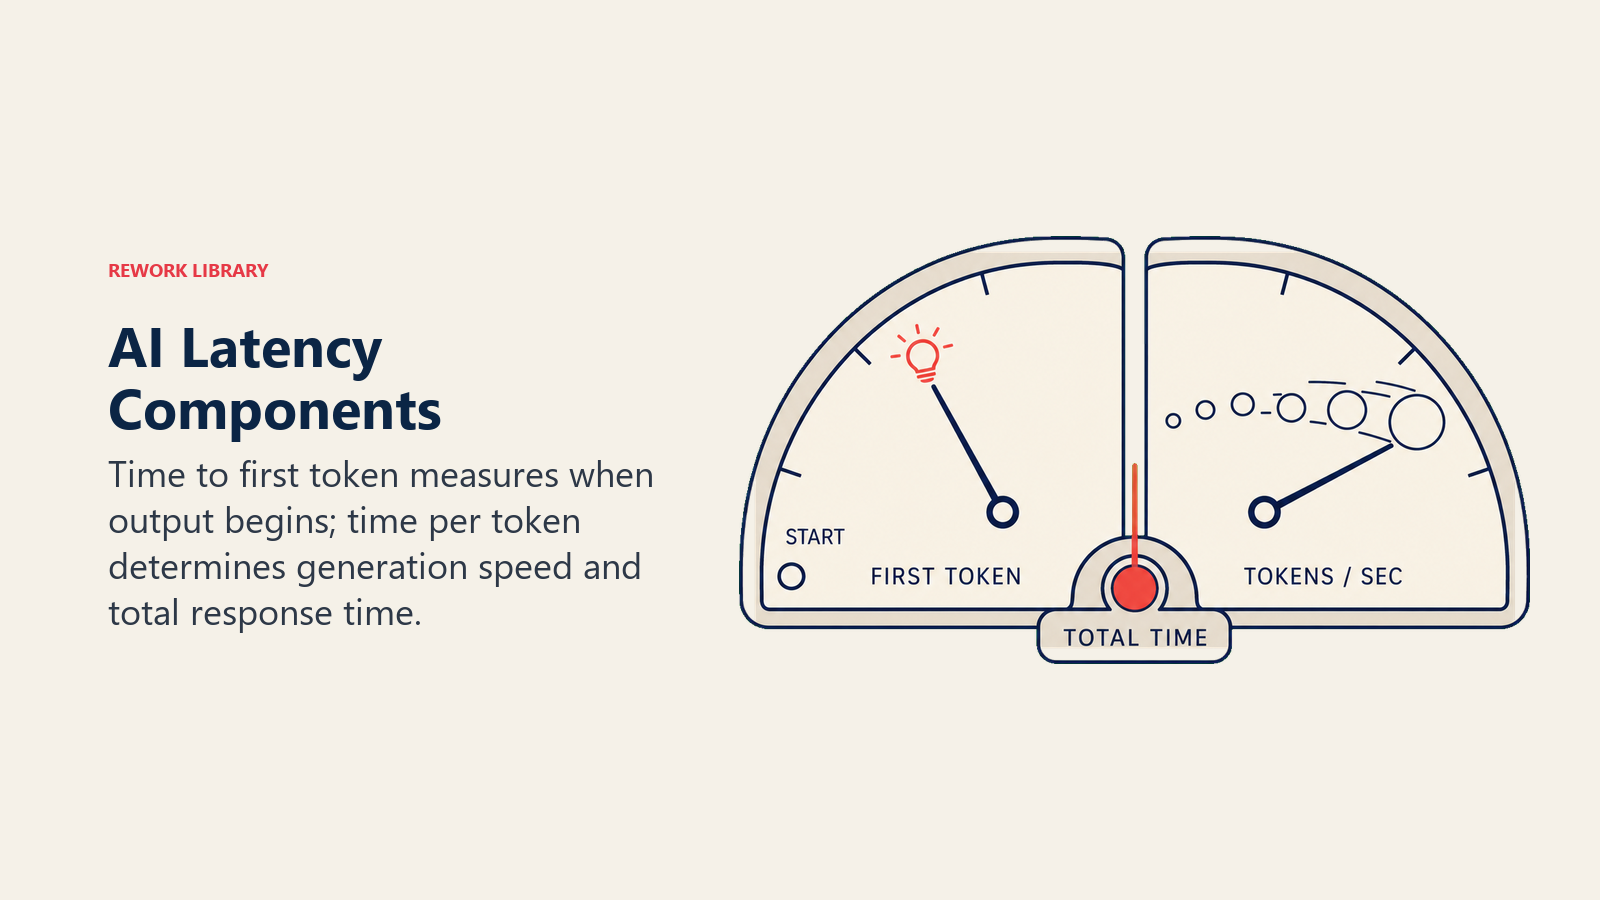
Mais ce chiffre unique masque des écarts importants. Les ingénieurs IA mesurent généralement deux composantes distinctes :
Time to first token (TTFT). Le temps qui s'écoule avant que le modèle ne commence à produire une sortie. Pour les réponses en streaming (le texte s'affiche mot après mot), c'est ce que les utilisateurs perçoivent comme la rapidité avec laquelle l'IA se met à répondre. Un TTFT élevé donne l'impression que le système est figé.
Time per output token (TPOT). La vitesse à laquelle le modèle génère chaque token après le premier. Pour les réponses longues, c'est elle qui détermine le temps total. Avec un TTFT rapide mais un TPOT lent, l'IA démarre vite puis avance péniblement dans une longue réponse.
Le temps de réponse total est la somme des deux. Pour une réponse de 500 tokens avec un TTFT de 50 ms et 20 ms par token, le temps total est de 10 secondes. Pour une réponse de 50 tokens, il est de 1 seconde.
La métrique réellement pertinente dépend du cas d'usage. Pour un assistant conversationnel, le TTFT compte le plus. Pour un outil de traitement de documents en batch qui tourne la nuit, le débit total importe davantage que la vitesse d'une requête isolée.
Ce qui détermine la latence
La latence d'un système d'IA provient de plusieurs sources distinctes. Identifier celle qui domine dans votre déploiement indique où concentrer vos efforts.
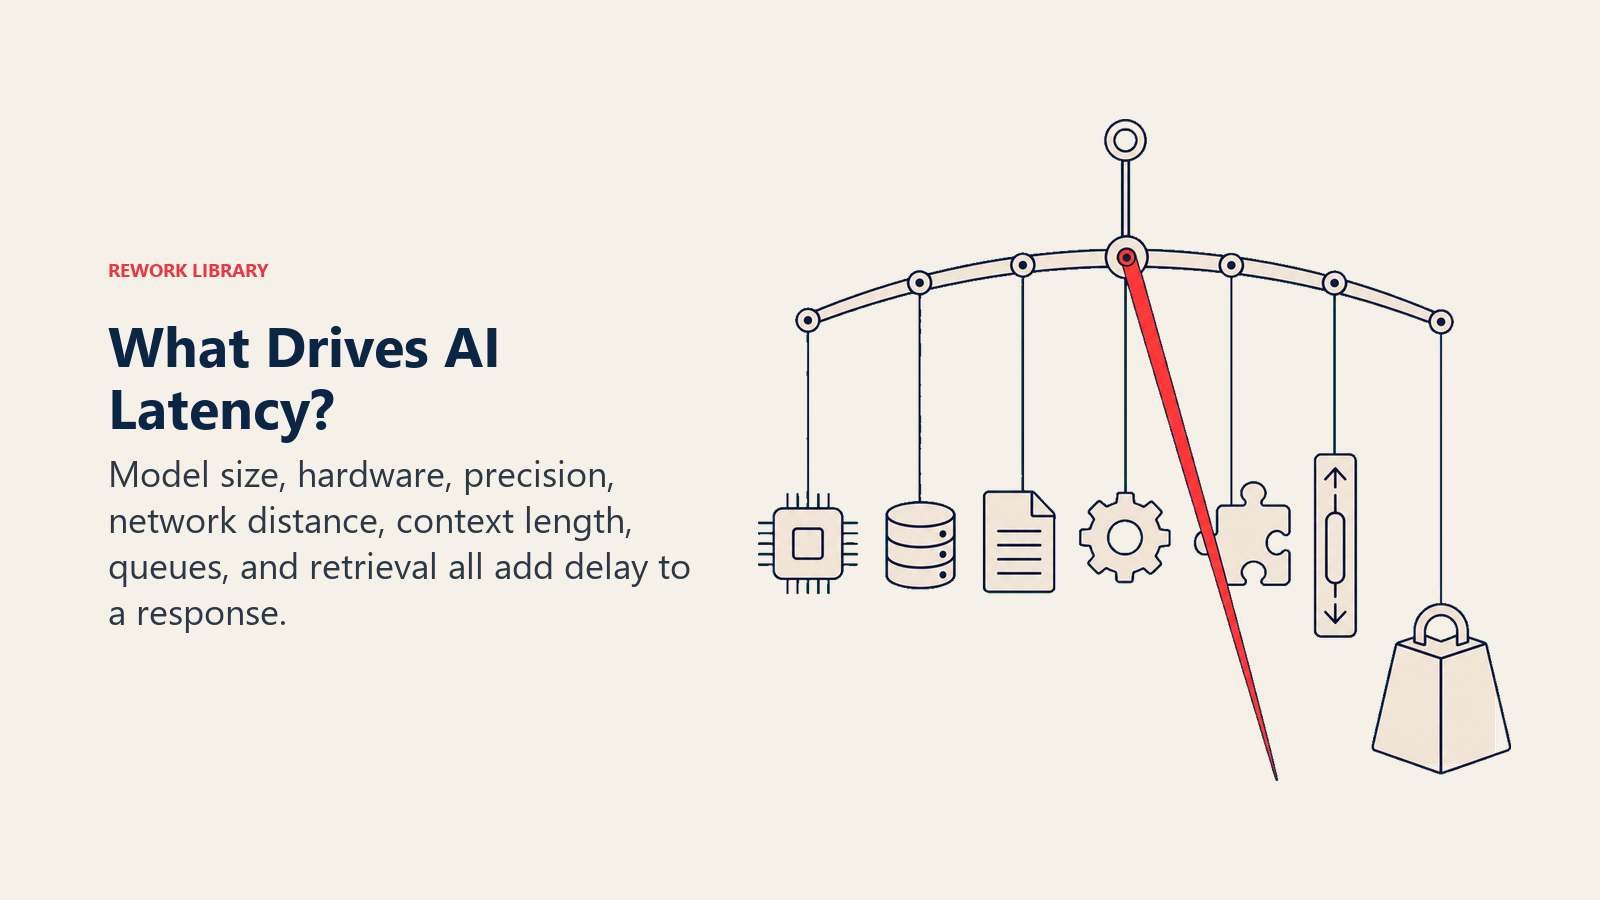
Taille du modèle. Les modèles plus grands (avec plus de paramètres) sont plus lents à exécuter. Les modèles de classe GPT-4 comptent des centaines de milliards de paramètres. Un petit modèle spécialisé peut en avoir 7 milliards. Le plus petit répond plus vite, parfois 10 à 20 fois plus vite, mais avec des capacités moindres. C'est l'arbitrage central de l'optimisation de l'inférence.
Matériel. L'inférence d'IA s'exécute sur des GPU ou des puces spécialisées (TPU, AWS Inferentia, etc.). Le même modèle tourne nettement plus vite sur un GPU H100 haut de gamme que sur une instance d'un niveau inférieur. Les fournisseurs cloud hiérarchisent la disponibilité des GPU ; les petits déploiements reçoivent souvent du matériel plus ancien.
Quantization et précision. Les modèles peuvent s'exécuter avec une précision numérique plus faible (par exemple INT8 au lieu de FP16) pour réduire les besoins en mémoire et en calcul. Une quantization bien mise en œuvre peut diviser la latence par 2 à 4 avec un impact modéré sur la qualité pour de nombreuses tâches.
Distance réseau. Si votre application est en Europe et que le point d'accès d'inférence de votre fournisseur d'IA se trouve dans la région US East, vous ajoutez 80 à 150 ms de latence réseau aller-retour avant même que le modèle ne commence à réfléchir. Pour les applications en temps réel, le choix de la région compte.
Longueur du contexte. Dans les modèles Transformer, le calcul de l'attention croît de façon quadratique avec la taille de la fenêtre de contexte. Envoyer un contexte de 100 000 tokens est bien plus lent qu'un contexte de 1 000 tokens. Les applications à contexte long (analyse de documents, revue de code sur de grandes bases) paient un coût de latence significatif.
Batching et profondeur de file d'attente. Les points d'accès d'inférence dans le cloud servent de nombreux utilisateurs en même temps. Quand la demande monte en flèche, les requêtes patientent dans une file d'attente. Cette attente est invisible pour l'utilisateur, mais elle peut ajouter plusieurs secondes au temps de réponse sous charge.
Étapes de récupération. Les systèmes de retrieval-augmented generation ajoutent une étape de recherche avant l'inférence du modèle. Une recherche vectorielle bien optimisée prend de 50 à 200 ms. Une recherche mal optimisée peut prendre de 2 à 5 secondes et dominer toute la latence.
Pourquoi elle compte plus que la plupart des métriques
Les études sur l'expérience utilisateur et l'adoption de l'IA montrent un schéma constant : les seuils de temps de réponse décident si une fonctionnalité devient une habitude ou une source de friction.
Pour les usages interactifs (assistants, copilotes, recherche), une réponse en moins de 2 secondes paraît instantanée. Entre 2 et 5 secondes, le délai se remarque mais reste acceptable. Au-delà de 5 secondes, les utilisateurs décrochent, cessent d'attendre ou trouvent des contournements. Au-delà de 10 secondes pour une requête courante, les taux d'adoption chutent brutalement et ne remontent souvent pas, même quand le système s'améliore.
Cela crée un problème cumulatif pour l'IA en entreprise. Un système lent au lancement habitue les utilisateurs à la lenteur et les pousse à développer des comportements d'évitement (ignorer la fonctionnalité, la contourner). Même si la latence s'améliore ensuite, le changement de comportement est déjà acquis.
L'enseignement pour l'entreprise : les seuils de latence doivent être définis comme des critères d'acceptation avant le déploiement, et non mesurés après le lancement comme une réflexion tardive.
L'alternative de l'Edge AI
Une réponse architecturale à la latence de l'inférence dans le cloud consiste à rapprocher le modèle de l'utilisateur, au sens propre. L'Edge AI exécute des modèles plus petits et optimisés sur des appareils locaux ou du matériel sur site, ce qui supprime totalement la latence réseau.
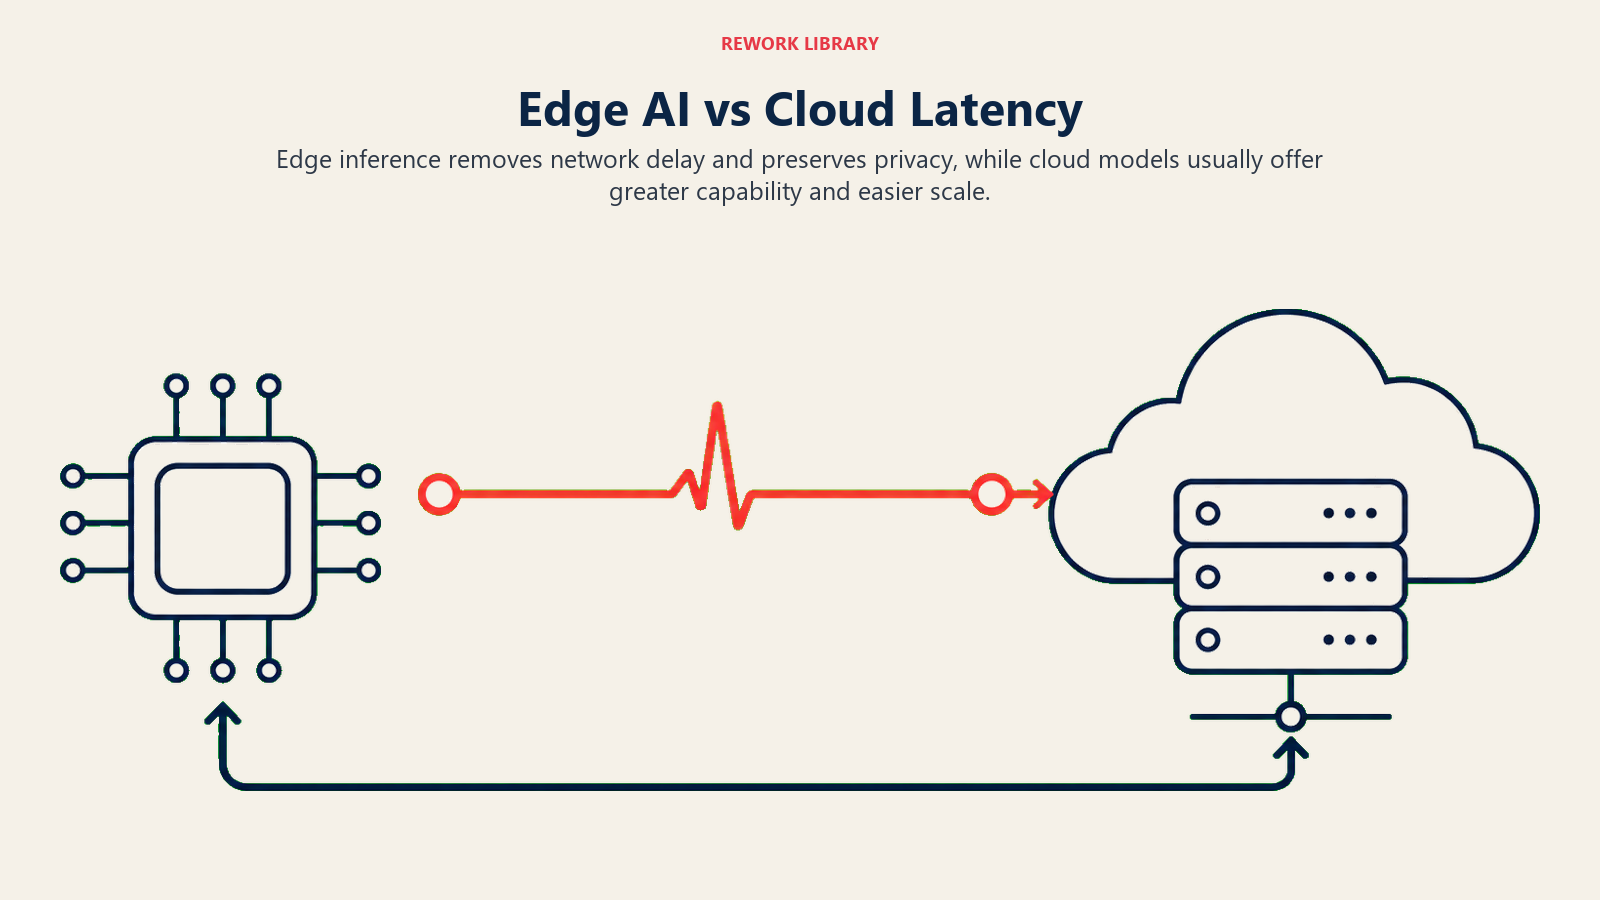
Pour les cas d'usage où la confidentialité des données est essentielle (santé, juridique, finance), le déploiement en edge évite aussi que les données quittent le périmètre de contrôle de l'organisation. En contrepartie, les modèles edge sont généralement plus petits et moins performants que les modèles de pointe hébergés dans le cloud.
Le cadre de décision est simple : si votre cas d'usage exige une réponse quasi instantanée (interfaces vocales, numérisation de documents en temps réel, outils pour commerciaux terrain avec une connectivité peu fiable), le déploiement en edge mérite d'être évalué. Si votre cas d'usage tolère quelques secondes (analyse asynchrone, batch nocturne, enrichissement en arrière-plan), l'inférence dans le cloud avec un modèle de pointe est généralement le bon choix.
Ce que les dirigeants peuvent influencer
Les équipes techniques pilotent l'essentiel des décisions d'optimisation de la latence, mais les dirigeants maîtrisent plusieurs facteurs qui fixent l'enveloppe de latence opérationnelle.
Conception du cas d'usage. Les workflows asynchrones (préparer un résumé avant la réunion, et non pendant) transforment une latence de 15 secondes en non-sujet. Une bonne conception produit supprime souvent la latence comme contrainte en décalant le moment où le calcul a lieu.
Arbitrages sur le choix du modèle. Choisir entre un modèle de pointe et un modèle spécialisé plus petit est souvent une décision métier qui comporte une dimension de latence. Un modèle plus petit, affiné pour votre tâche précise, peut être plus rapide et moins cher tout en respectant les exigences de qualité. Cela suppose un suivi des modèles pour valider la qualité avant de déployer des alternatives plus légères.
Définition des SLA. Fixer des SLA de latence explicites (par exemple « 95e centile des réponses en moins de 3 secondes ») donne aux équipes d'ingénierie un objectif concret et met en place l'outillage de mesure pour détecter une dégradation avant les utilisateurs.
Budget d'infrastructure. Les niveaux de GPU premium coûtent plus cher. Les points d'accès d'inférence à moindre coût sont plus lents. Il vaut mieux expliciter cet arbitrage que de le laisser en défaut invisible.
Chiffres clés :
- La latence de l'IA comporte deux composantes : le time to first token (réactivité perçue par l'utilisateur) et le temps de réponse total (pertinent pour les sorties longues).
- Les principaux facteurs sont la taille du modèle, le niveau de matériel, la quantization, la distance réseau, la longueur du contexte et la profondeur de file d'attente sous charge.
- L'adoption par les utilisateurs décroche généralement au-delà de 5 secondes pour les usages interactifs et ne remonte souvent pas, même quand la latence s'améliore ensuite.
- Les choix d'architecture (workflows asynchrones, déploiement en edge, choix du modèle) peuvent supprimer ou reformuler les contraintes de latence au lieu de simplement les optimiser.
- Les SLA de latence doivent être définis avant le déploiement, et non mesurés après le lancement.
Questions fréquentes sur la latence de l'IA : pourquoi le temps de réponse détermine la valeur de l'IA en production
Comment savoir quel seuil de latence est acceptable pour notre cas d'usage ?
Définissez-le à partir du comportement des utilisateurs, pas d'hypothèses. Pour une nouvelle fonctionnalité, lancez un pilote avec un échantillon représentatif et mesurez à partir de quel délai l'usage décroche. Pour le remplacement d'un workflow existant, mesurez le temps que prend le workflow actuel. Une fonctionnalité d'IA plus lente que le processus manuel qu'elle remplace ne sera pas adoptée.
Peut-on réduire la latence sans changer de modèle ni de matériel ?
Oui, plusieurs approches n'exigent aucun changement de modèle ni d'infrastructure : mettre en cache les requêtes courantes (si votre cas d'usage comporte des demandes similaires et répétées), réduire la taille du contexte (n'envoyer que le contexte pertinent plutôt que tout l'historique de la conversation), pré-calculer de façon asynchrone (générer les sorties probables avant que l'utilisateur ne les demande) et optimiser l'étape de récupération dans les architectures RAG.
Une latence plus faible est-elle toujours préférable ?
Pas toujours. Pour un traitement batch nocturne, la précision et le coût comptent davantage que la vitesse. Optimiser la latence se fait souvent au détriment du coût (un matériel plus rapide coûte plus cher) ou de la qualité (les modèles plus petits sont plus rapides mais moins performants). L'objectif est d'atteindre le seuil qu'exige l'expérience utilisateur, et non de minimiser la latence pour elle-même.
Qu'est-ce que le streaming et pourquoi est-il utile ?
Le streaming signifie que le modèle envoie les tokens à l'utilisateur au fur et à mesure de leur génération, sans attendre que la réponse soit complète. Le temps de calcul total n'est pas réduit, mais la réactivité perçue s'améliore fortement parce que l'utilisateur voit la progression. La plupart des interfaces d'IA de type chat utilisent le streaming par défaut.
