Qu'est-ce que le Mixture of Experts ? L'IA qui n'active que ce dont elle a besoin
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
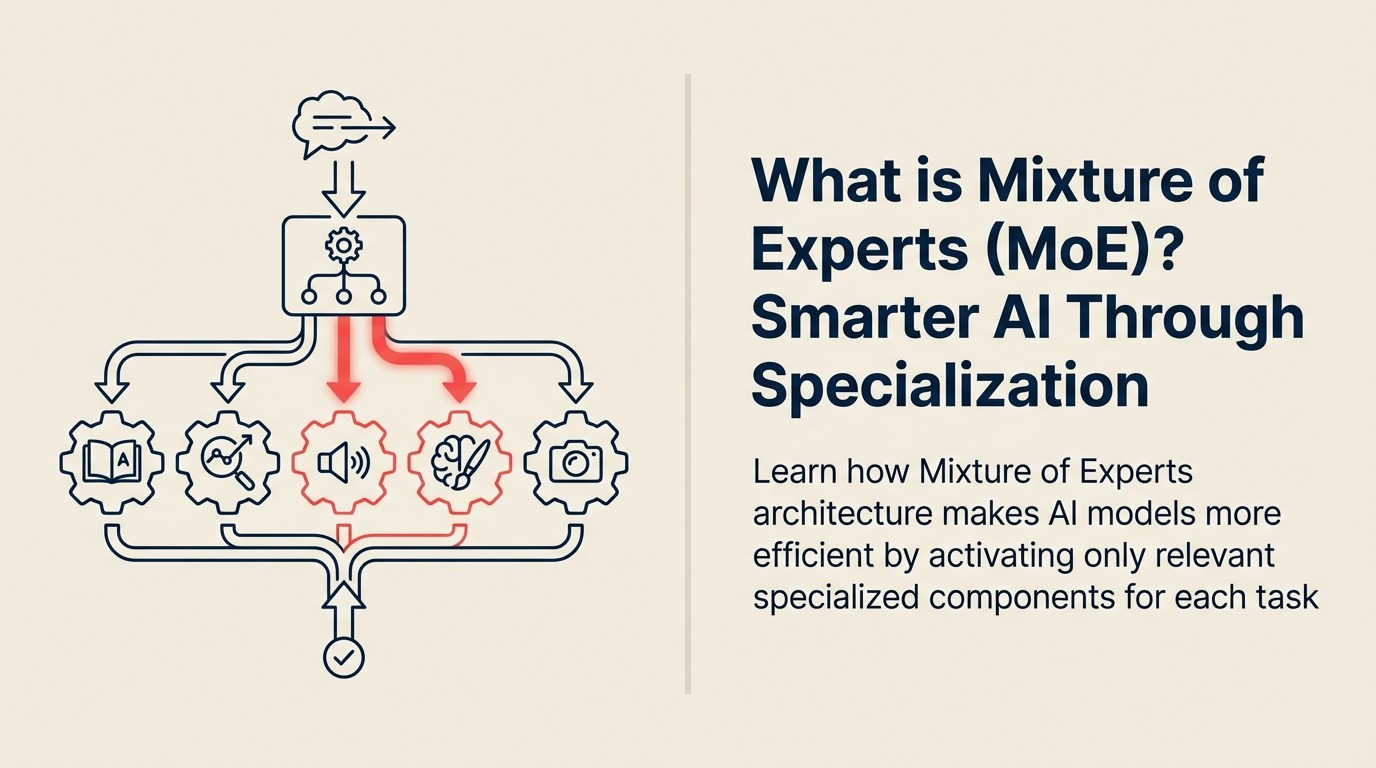
Imaginez que votre cerveau active chaque neurone à chaque pensée : lire un e-mail consommerait autant d'énergie que résoudre une équation d'analyse. En réalité, votre cerveau n'active que les zones dont il a besoin. Le Mixture of Experts (MoE) apporte cette efficacité à l'IA, avec des sous-modèles spécialisés qui ne s'activent que lorsque leur expertise est requise.
L'architecture qui a changé l'économie de l'IA
Le Mixture of Experts est issu de la recherche universitaire des années 1990, mais il est devenu important en pratique en 2024, lorsqu'OpenAI a révélé que GPT-4 repose sur une architecture MoE. Cette avancée a montré que plus gros n'est pas toujours mieux : un routage plus intelligent l'emporte sur la force brute.
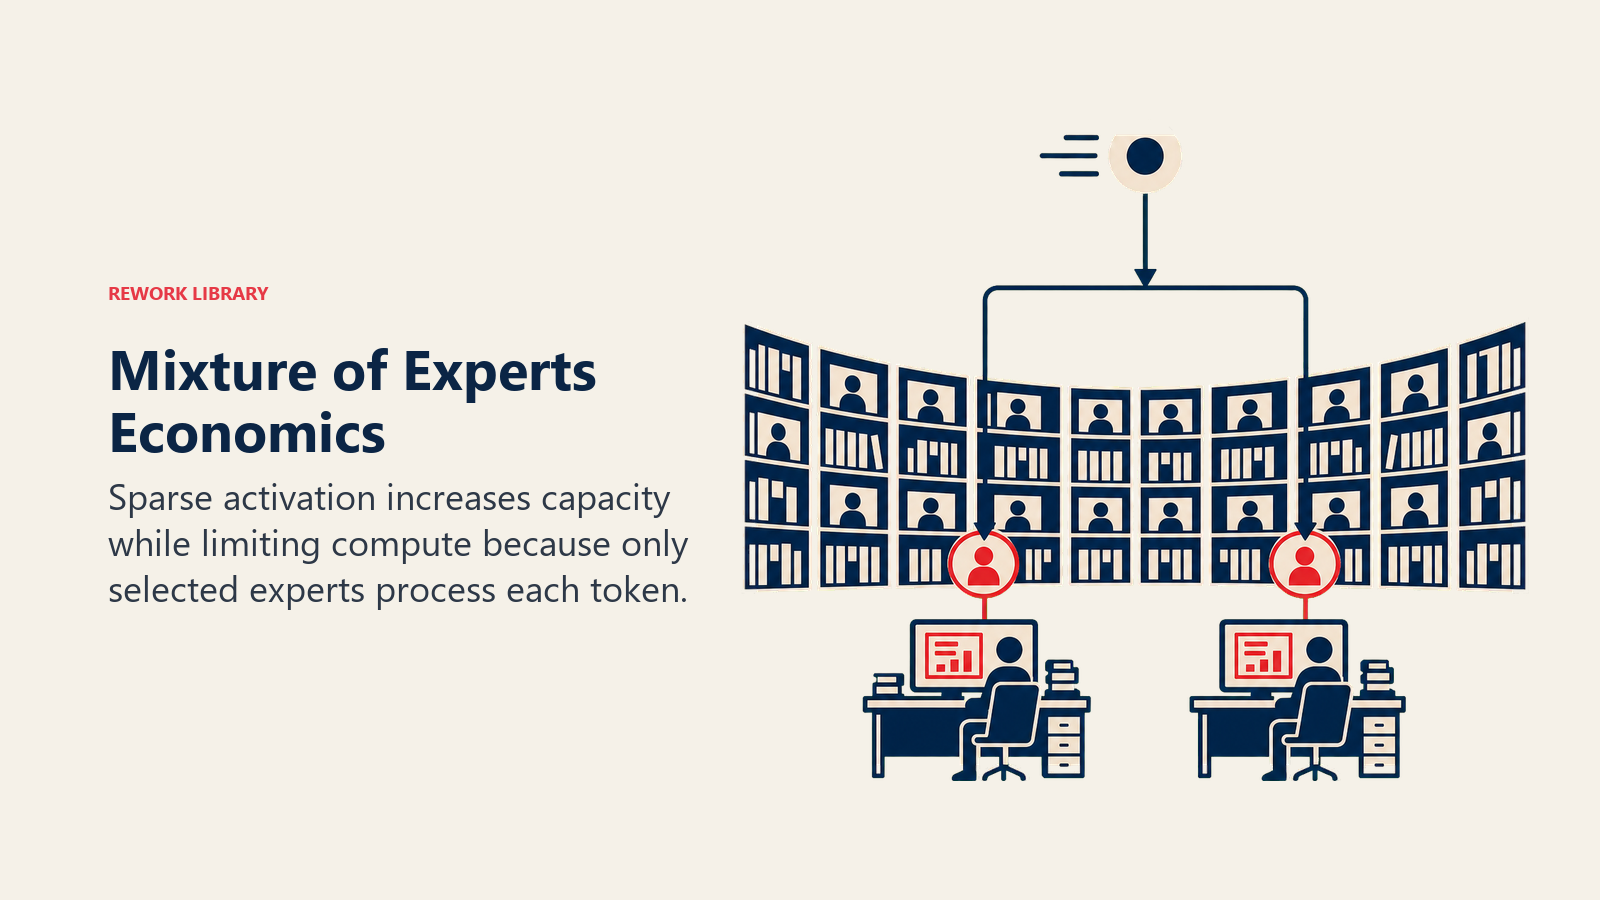
Selon Google Research, le MoE est « une architecture de réseau de neurones qui contient plusieurs sous-réseaux spécialisés (les experts), où un mécanisme de gating oriente dynamiquement chaque entrée vers les experts les plus pertinents, en n'activant qu'une fraction de la capacité totale du modèle pour chaque inférence ».
Le tournant est venu quand Mistral AI a publié Mixtral 8x7B en décembre 2023 : ce modèle MoE a montré qu'il pouvait égaler les performances de modèles bien plus gros avec 5 fois moins de calcul, ce qui rend l'IA puissante accessible à des organisations plus petites.
Le Mixture of Experts pour les dirigeants
Pour les dirigeants, le MoE signifie obtenir des performances de niveau GPT-4 à une fraction du coût et du temps de traitement, car l'IA n'active intelligemment que les composants spécialisés nécessaires à chaque requête, au lieu de faire tourner tout l'énorme modèle.
Comparez une entreprise qui consulterait tous les services pour chaque question à une autre qui oriente chaque question vers les bons spécialistes. Le MoE, c'est un excellent coordinateur qui sait aussitôt quel expert mobiliser et évite le gaspillage qui consiste à solliciter tout le monde.
Concrètement, les modèles MoE répondent plus vite, coûtent moins cher en infrastructure et offrent un meilleur rapport performance/prix que les modèles denses classiques : des grands modèles de langage poussés deviennent ainsi économiquement viables pour davantage de cas d'usage.
Les composants essentiels du Mixture of Experts
Les systèmes MoE reposent sur les éléments suivants :
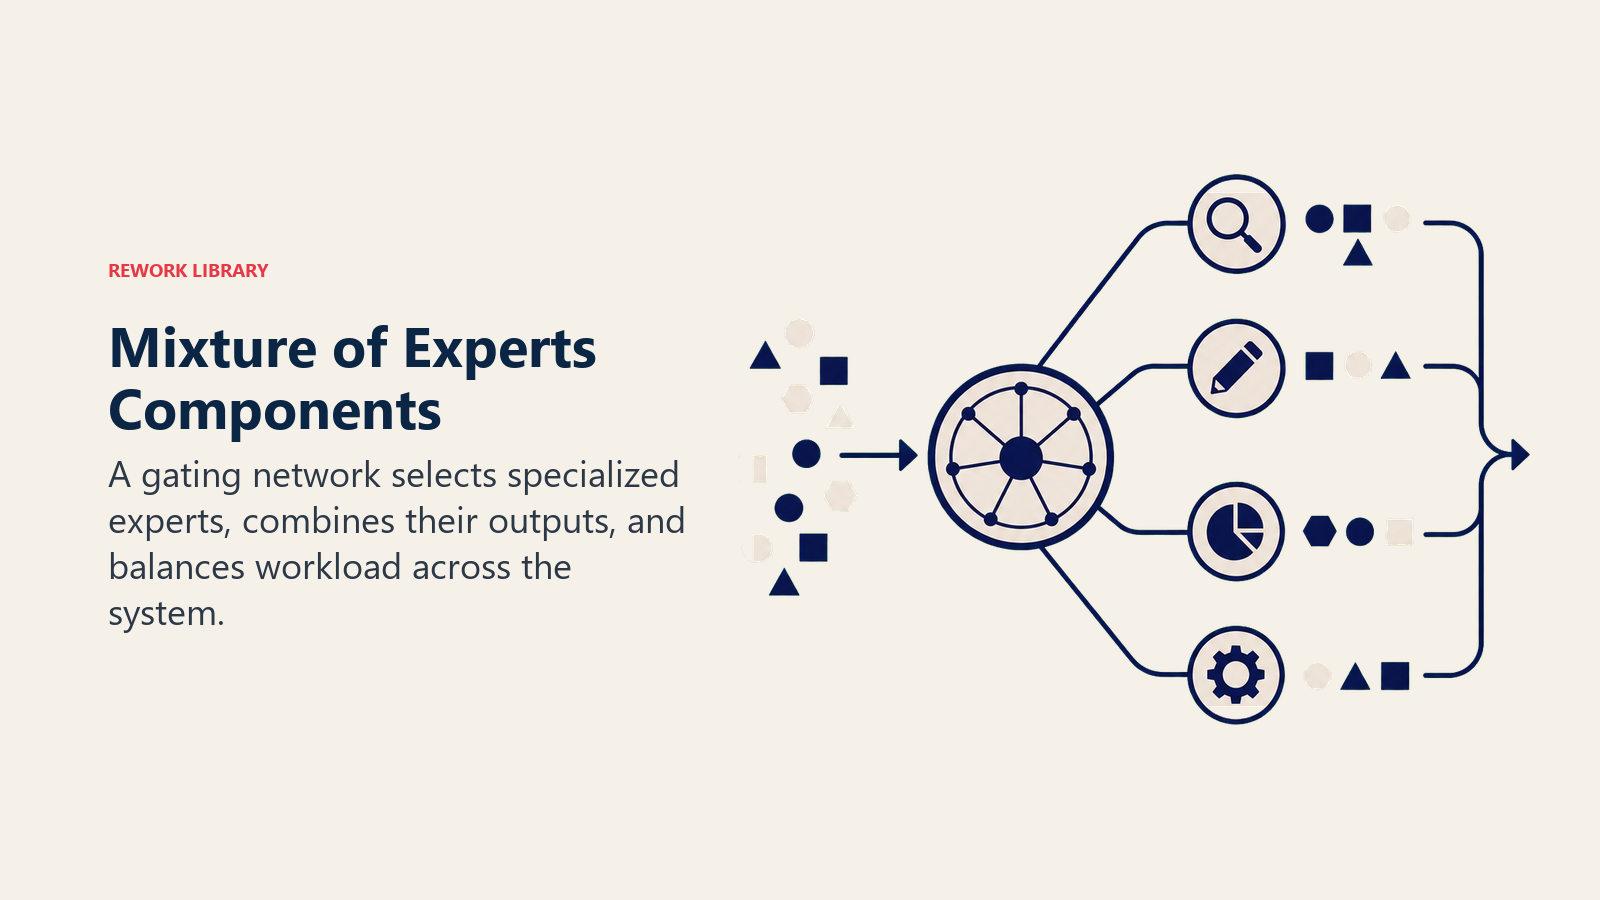
• Réseaux d'experts : plusieurs sous-modèles spécialisés, chacun excellant sur certains types d'entrées ou de tâches, comme des services qui maîtrisent chacun un domaine différent
• Réseau de gating : le système de routage qui décide quels experts activer pour chaque entrée, en analysant la requête et en sélectionnant les spécialistes les plus pertinents
• Activation parcimonieuse (sparse activation) : seuls 1 à 3 experts s'activent par entrée, et non tous, ce qui réduit fortement le calcul tout en préservant la qualité grâce à une sélection fine
• Équilibrage de charge : des mécanismes qui garantissent que les experts sont sollicités à peu près également dans le temps, pour que certains ne soient pas surchargés pendant que d'autres restent inactifs
• Spécialisation des experts : au fil de l'entraînement, les experts se concentrent naturellement sur des schémas différents : l'un excelle en code, un autre en rédaction créative, un autre en analyse
Comment fonctionne le Mixture of Experts
Les modèles MoE suivent ce cycle de fonctionnement :
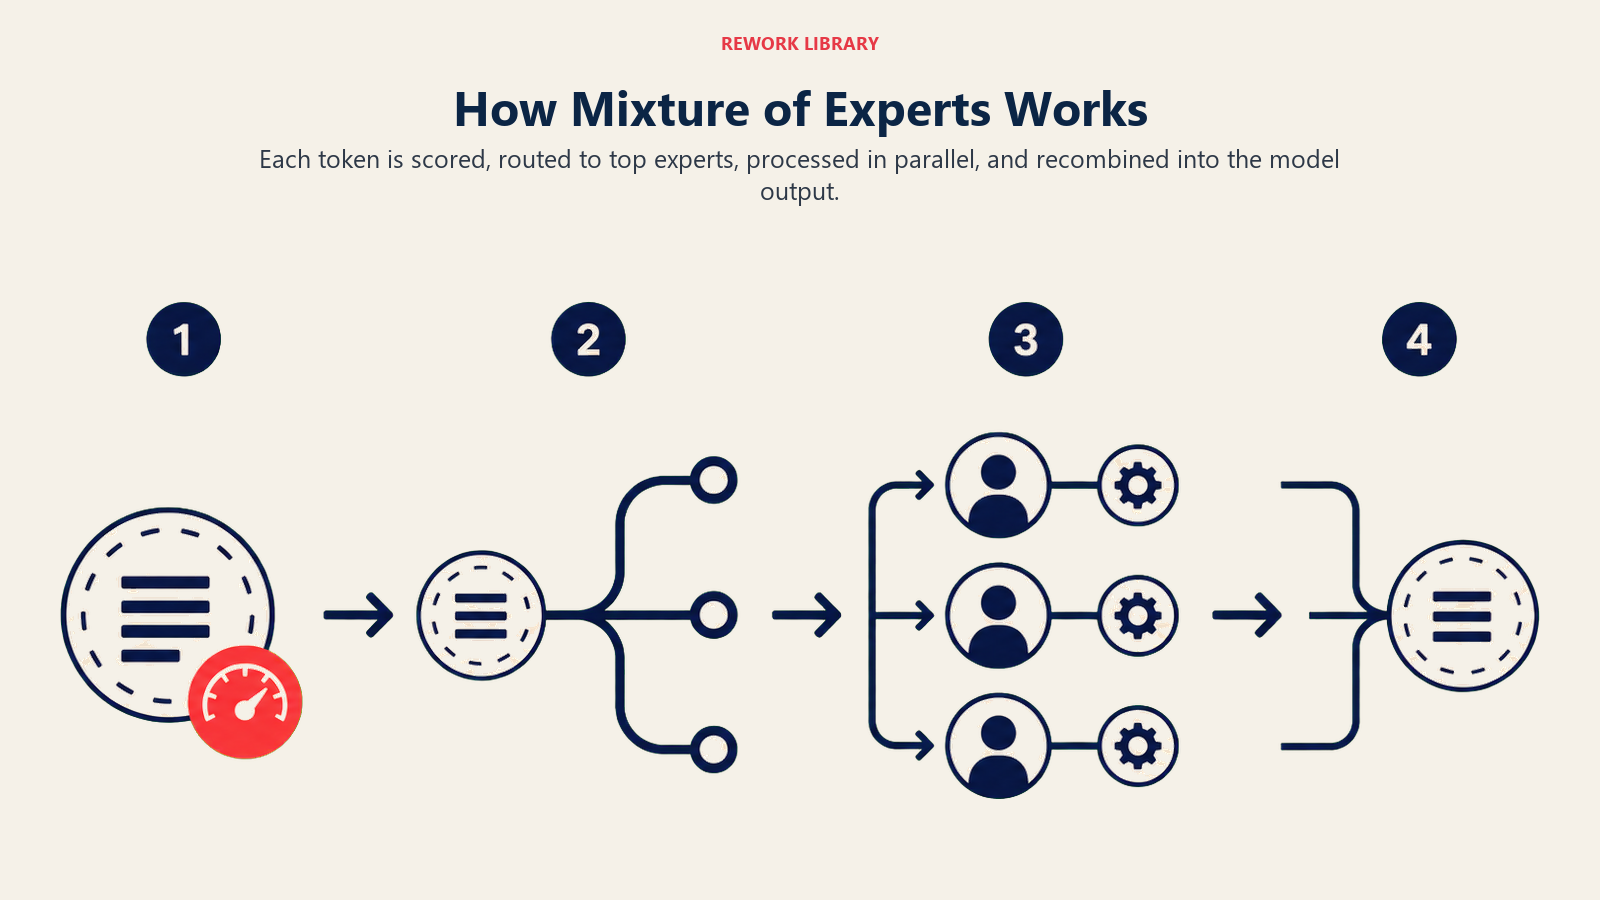
Analyse de l'entrée : lorsque vous soumettez une requête, le réseau de gating l'analyse pour comprendre quel type d'expertise est nécessaire, en examinant les schémas linguistiques et le contenu
Sélection des experts : à partir de cette analyse, le réseau de gating oriente votre entrée vers les 1 à 3 experts les plus pertinents parmi des centaines potentiellement disponibles
Traitement spécialisé : seuls les experts sélectionnés s'activent et traitent votre entrée, chacun apportant son savoir spécialisé pendant que les autres restent en veille, ce qui économise énormément de calcul
Ce routage dynamique se fait en quelques millisecondes, et le réseau de gating apprend avec le temps quels experts traitent le mieux quels types de requêtes.
Les types d'implémentations MoE
Les architectures MoE répondent à des besoins différents :
Type 1 : MoE parcimonieux (sparse) Idéal pour : une inférence efficace à grande échelle Caractéristique clé : oriente vers un petit sous-ensemble d'experts Exemple : GPT-4, Mixtral 8x7B pour l'efficacité des coûts
Type 2 : MoE dense Idéal pour : des performances maximales Caractéristique clé : active la plupart des experts, voire tous Exemple : modèles de recherche qui privilégient la qualité sur la vitesse
Type 3 : MoE hiérarchique Idéal pour : les tâches complexes qui couvrent plusieurs domaines Caractéristique clé : sélection d'experts en cascade à plusieurs niveaux Exemple : systèmes multimodaux qui traitent texte, image et audio
Type 4 : MoE souple (soft) Idéal pour : un mélange fluide des experts Caractéristique clé : combinaison pondérée de plusieurs experts Exemple : systèmes qui exigent un dosage nuancé entre domaines
Le MoE à l'épreuve des résultats
Voici comment des organisations tirent parti du MoE :
Exemple en outils pour développeurs : Ghostwriter, de Replit, utilise une architecture MoE pour assister le code dans des dizaines de langages de programmation : il active à la demande des experts propres à chaque langage et réduit la latence de réponse de 60 % par rapport aux modèles denses.
Exemple en support client : l'agent d'IA d'Intercom s'appuie sur le MoE pour orienter les questions vers des experts spécialisés (problèmes techniques, facturation, questions produit, demandes générales). La précision de résolution progresse de 35 % et chaque serveur gère 3 fois plus de conversations.
Exemple en traduction : DeepL emploie des modèles MoE dont les experts sont spécialisés par paire de langues et par domaine (juridique, médical, technique), ce qui donne une qualité de traduction supérieure de 25 % aux approches à modèle unique sur les contenus spécialisés.
Mettre en œuvre le MoE
Prêt à obtenir plus avec moins ?
- Commencez par les bases des grands modèles de langage
- Comprenez l'architecture des réseaux de neurones
- Découvrez les techniques d'optimisation de modèles
- Envisagez le fine-tuning pour développer une expertise métier
Questions fréquentes sur le Mixture of Experts
Qu'est-ce que le Mixture of Experts (MoE) ?
Le Mixture of Experts est une architecture de réseau de neurones qui contient plusieurs sous-réseaux spécialisés (les experts) : un mécanisme de gating oriente dynamiquement chaque entrée vers les experts les plus pertinents et n'active qu'une fraction de la capacité totale à chaque inférence.
Quelle est la différence entre le MoE et les réseaux de neurones classiques ?
Les réseaux denses classiques activent tous leurs paramètres pour chaque entrée. Les réseaux MoE n'activent que les experts spécialisés pertinents et obtiennent de meilleures performances avec moins de calcul, grâce à un routage intelligent des entrées.
Quels sont les principaux types d'implémentations MoE ?
Le MoE parcimonieux (active peu d'experts pour l'efficacité), le MoE dense (en active la plupart pour la qualité), le MoE hiérarchique (sélection en cascade) et le MoE souple (mélange pondéré des experts).
Quels sont des exemples de modèles MoE ?
GPT-4 (le modèle phare d'OpenAI), Mixtral 8x7B (le modèle efficace de Mistral AI), Switch Transformer (le modèle de Google à mille milliards de paramètres) et divers modèles spécialisés par domaine qui utilisent le routage d'experts.
Ressources associées
Explorez ces notions voisines pour approfondir votre compréhension du Mixture of Experts :
- Grands modèles de langage : les systèmes que les architectures MoE améliorent
- Réseaux de neurones : l'architecture de base des réseaux d'experts
- Optimisation de modèles : techniques pour un déploiement d'IA efficace
- Architecture Transformer : l'architecture de base souvent associée au MoE
Ressources externes
- Google Research : Sparse Expert Models : recherches sur les architectures MoE efficaces
- Meta AI : Model Efficiency : avancées en activation parcimonieuse et routage d'experts
- Microsoft Research : Scalable AI : implémentations MoE en entreprise
Fait partie de la Collection AI Terms. Dernière mise à jour : 2026-02-09

Co-Founder, Rework.com