Qu'est-ce que la compression de modèles ? Faire tenir la puissance de l'IA dans un format plus petit
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Un hôpital veut exécuter un modèle d'IA de diagnostic directement sur une tablette au chevet du patient. Le modèle est précis, mais il exige un serveur à 30 000 $. La compression de modèles peut le réduire d'un facteur 10 pour le faire tenir sur un appareil à 500 $, avec seulement 3 % de précision en moins. Ce n'est pas qu'une prouesse technique : c'est la différence entre un projet pilote et un vrai déploiement.
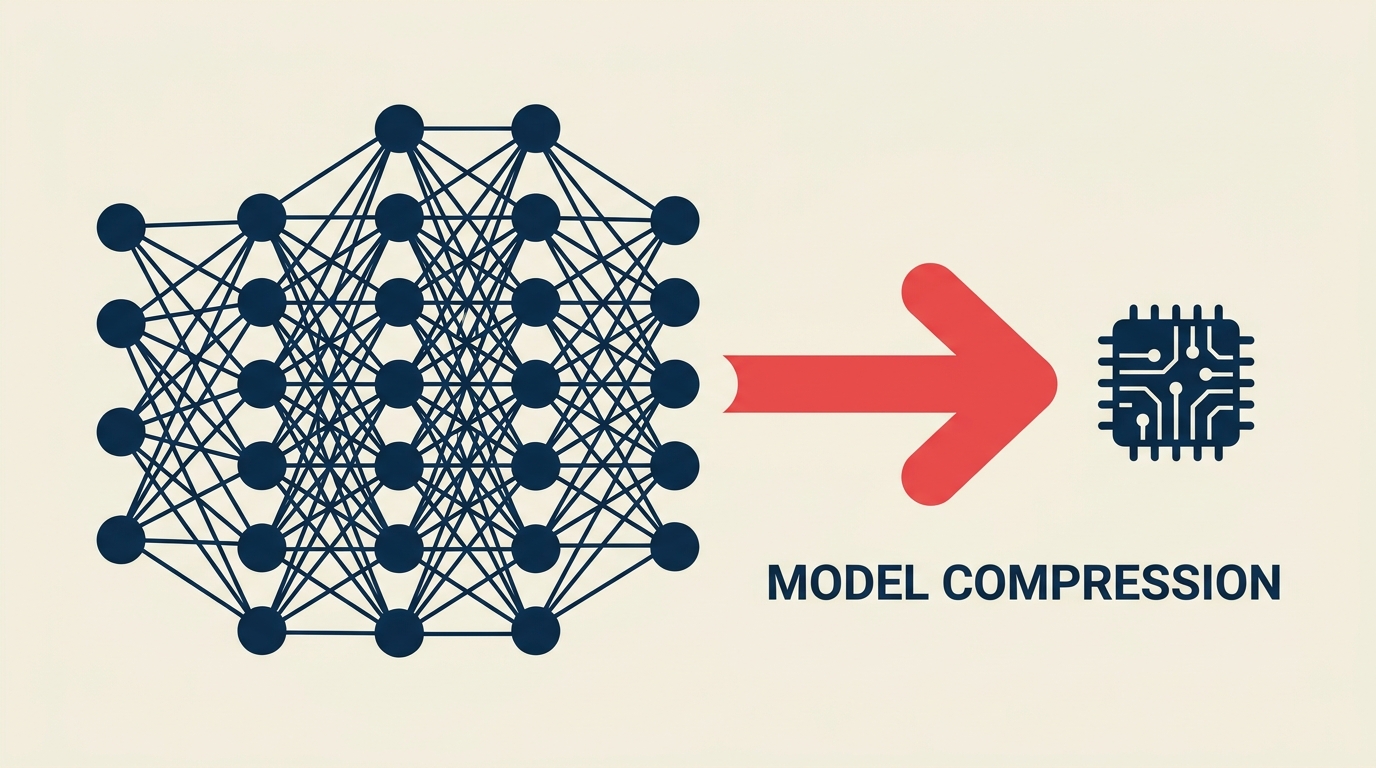
La compression de modèles regroupe les techniques qui rendent les modèles d'IA plus petits, plus rapides et moins chers à exécuter, sans les vider de leur utilité.
Ce que signifie vraiment la compression de modèles
La compression de modèles consiste à réduire la taille et les besoins de calcul d'un modèle d'IA entraîné, tout en préservant autant que possible ses performances d'origine. Elle se situe entre l'entraînement du modèle et son déploiement en production, et c'est l'étape qui rend les capacités théoriques de l'IA utilisables dans de vrais contextes métier.
Le besoin est apparu clairement quand les organisations ont mesuré l'écart entre « impressionnant en démo » et « abordable à grande échelle ». Un modèle de langage de classe GPT compte des centaines de milliards de paramètres, chacun mobilisant de la mémoire et du calcul pendant l'inférence. Le faire tourner en production pour des milliers d'utilisateurs quotidiens peut coûter des dizaines de milliers de dollars par mois. Des versions compressées du même modèle peuvent réduire ce coût de 60 à 90 % avec une dégradation minime de la qualité.
Pour les dirigeants, la compression de modèles signifie ceci : le modèle d'IA que votre équipe a évalué en démo peut réellement tourner sur votre infrastructure, à un coût qui rend le ROI viable.
Les quatre techniques de base
La compression de modèles n'est pas une technique unique. C'est une boîte à outils de quatre grandes approches, souvent combinées :
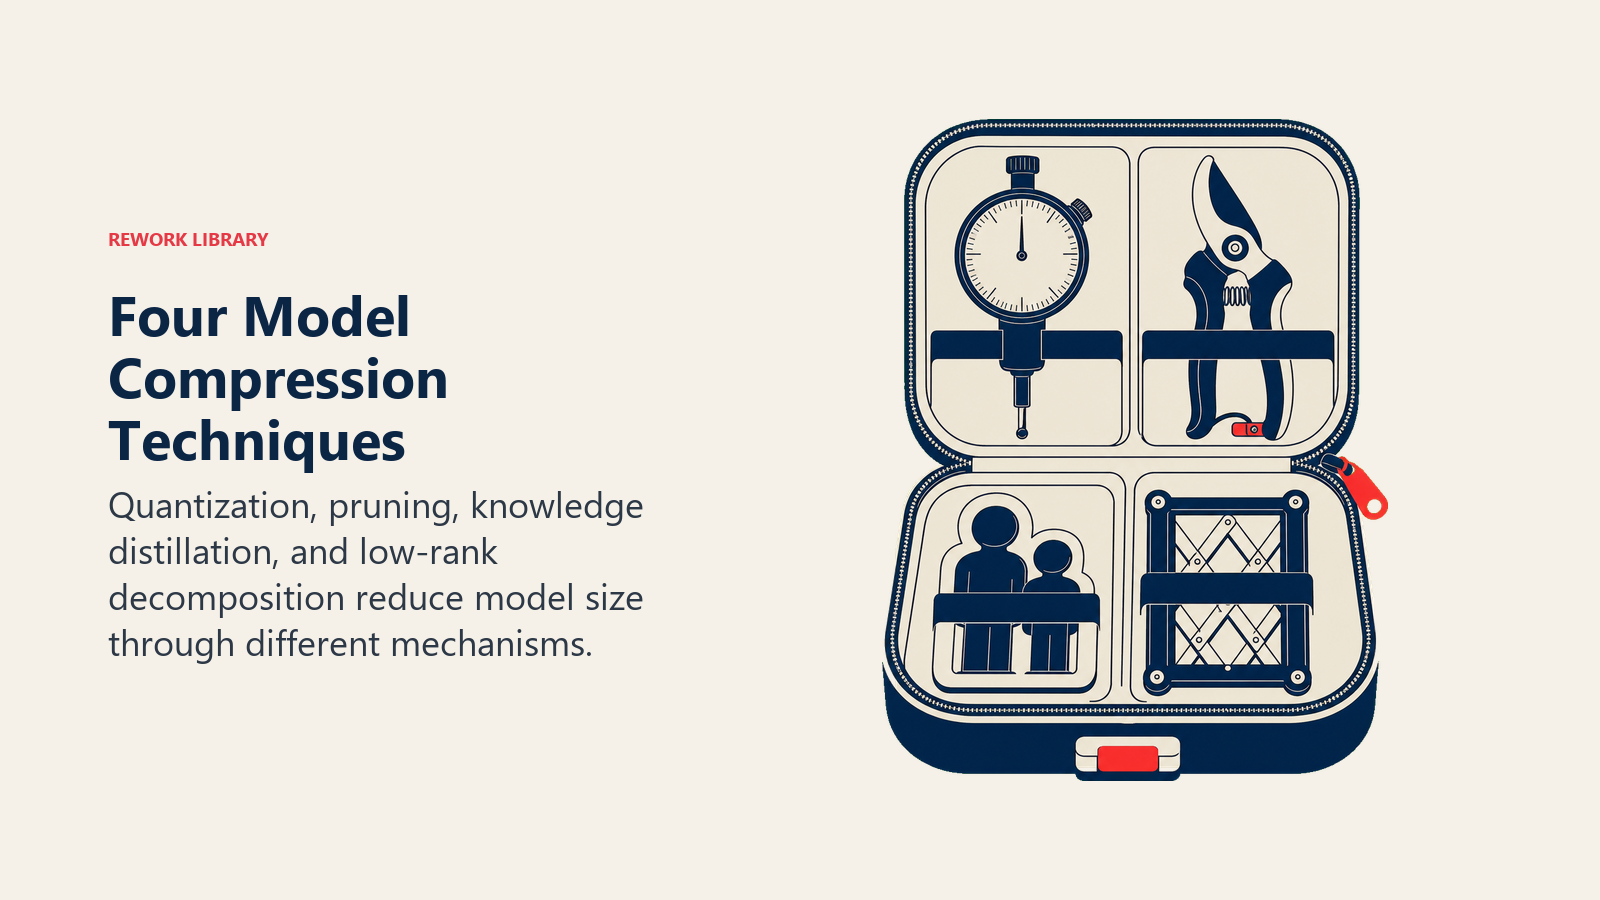
La quantization convertit les nombres de haute précision qui représentent les poids du modèle, de la virgule flottante 32 bits vers des entiers 8 bits, voire des valeurs 4 bits. Cela revient à arrondir les nombres avec moins de décimales. Le modèle devient 4 à 8 fois plus petit et s'exécute plus vite, généralement avec moins de 2 % de perte de précision. C'est la technique la plus répandue, car elle ne demande aucun réentraînement. Pour aller plus loin, consultez quantization.
Le pruning (élagage) supprime les poids individuels ou les neurones entiers qui contribuent peu à la sortie du modèle. Comme on taille un arbre de décision, il repère les composants qui travaillent le moins et les retire. Le pruning non structuré peut éliminer 50 à 90 % des poids pour un coût modéré en précision ; le pruning structuré (suppression de couches entières ou de têtes d'attention) est plus facile à accélérer en pratique. La distillation de connaissances suit souvent le pruning pour retrouver la précision perdue.
La distillation de connaissances entraîne un « élève » plus petit à imiter le comportement d'un « enseignant » plus grand. L'élève n'apprend pas seulement à partir des données d'entraînement : il apprend à reproduire les schémas de sortie de l'enseignant. On obtient ainsi des modèles compacts qui dépassent leur poids, parce qu'ils sont formés par un enseignant plus performant. La distillation demande du temps d'entraînement, mais produit les modèles compressés de meilleure qualité.
La décomposition de rang faible découpe de grandes matrices de poids en matrices plus petites qui capturent la même information plus efficacement, un peu comme la compression JPEG d'une image la représente par des combinaisons de motifs plus simples. Elle est particulièrement efficace dans les modèles à architecture Transformer, où les multiplications de matrices dominent le coût de calcul.
Où se situent les arbitrages
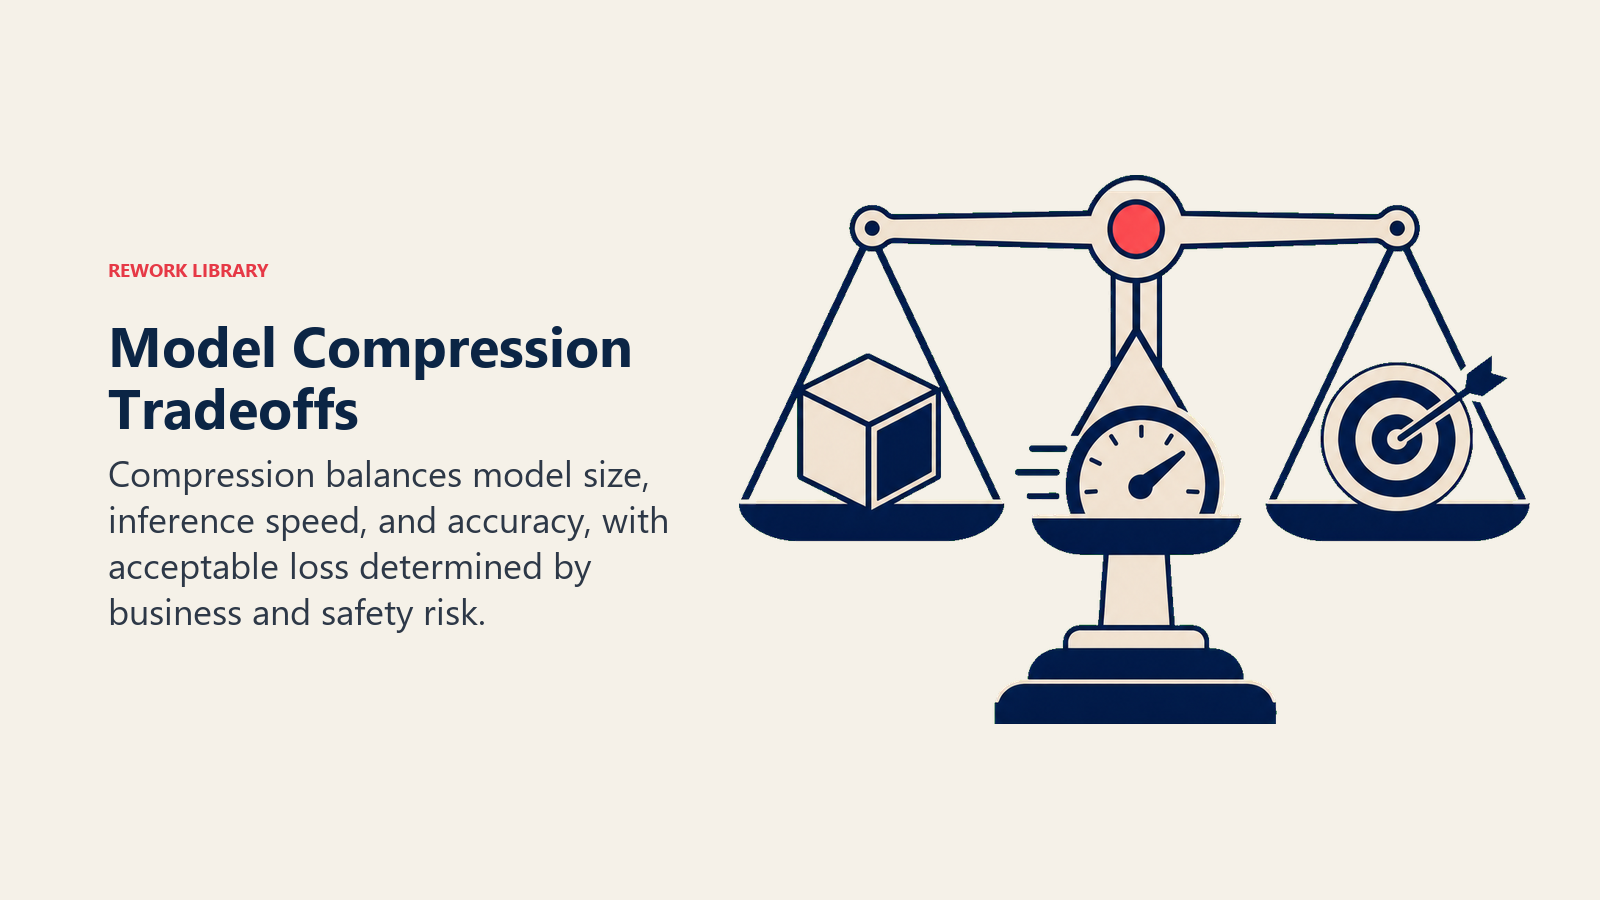
La compression de modèles implique toujours un triangle d'arbitrage : taille du modèle, vitesse d'inférence et précision. La question pratique est de savoir quelle dégradation de précision est acceptable pour votre cas d'usage.
Pour de nombreuses applications d'entreprise, la réponse est : plus que vous ne le pensez. Un chatbot de service client précis à 1 % de moins, mais qui répond en 100 ms au lieu de 800 ms et coûte 80 % de moins à exécuter, est un bien meilleur produit. Le gain d'expérience utilisateur l'emporte sur l'écart marginal de précision.
Pour les applications critiques en matière de sécurité (diagnostic médical, scoring du risque financier, systèmes autonomes), même de faibles pertes de précision exigent une validation rigoureuse. Les modèles compressés destinés à ces usages doivent être testés avec soin par rapport à l'original avant déploiement.
La bonne nouvelle : les techniques de compression modernes ont énormément progressé. Les modèles LLaMA de Meta ont montré qu'une quantization 4 bits conserve plus de 95 % des performances en pleine précision. DistilBERT, de Google, atteint 97 % des performances de BERT pour 40 % de sa taille.
Pourquoi cela compte pour le déploiement de l'IA
L'argumentaire en faveur de la compression de modèles s'appuie sur trois dimensions :
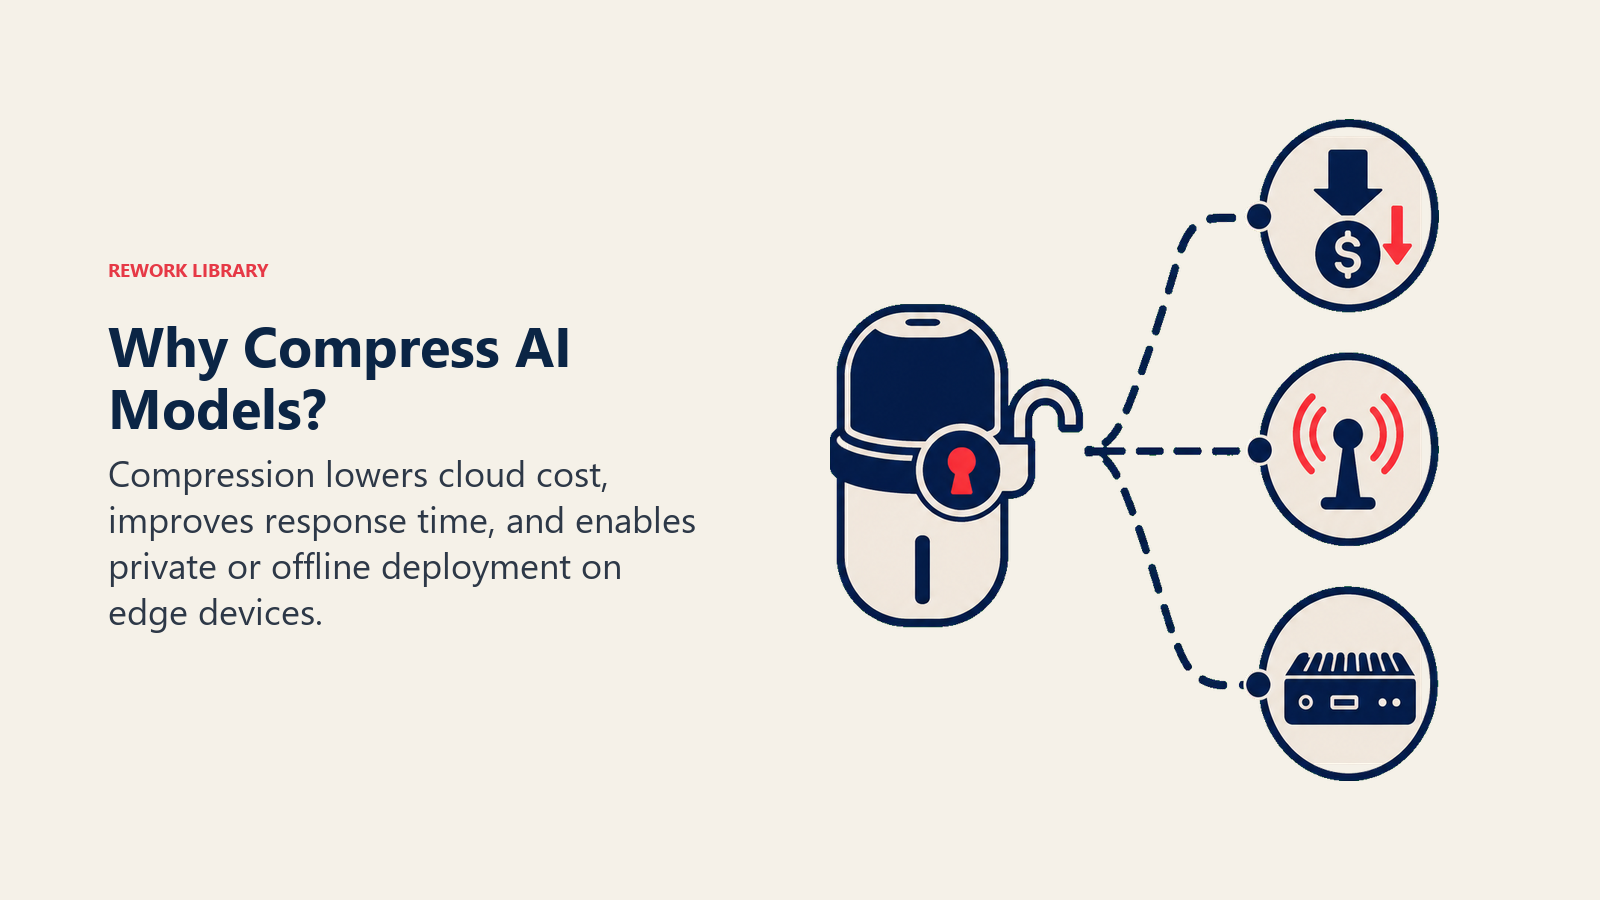
Réduction des coûts. Les coûts d'inférence dans le cloud croissent avec le calcul. Une compression par 4 se traduit généralement par un coût d'inférence 3 à 4 fois plus faible. À grande échelle, l'effet est considérable. Une entreprise qui effectue 10 millions d'appels d'API d'IA par jour peut réduire son budget d'infrastructure d'IA de 500 000 $ par an grâce à une compression poussée.
Amélioration de la latence. Les modèles plus petits répondent plus vite. Pour les applications destinées aux utilisateurs, où le temps de réponse influe sur les taux de conversion et la satisfaction, passer de 200 ms à 50 ms peut améliorer nettement les indicateurs métier.
Déploiement en edge. Certains cas d'usage de l'IA exigent d'exécuter les modèles là où la connectivité cloud est limitée, ou là où la confidentialité interdit d'envoyer les données à l'extérieur. L'inspection qualité en usine, les applications mobiles et les dispositifs de santé profitent tous de modèles qui tiennent sur du matériel local. L'Edge AI, comme mode de déploiement, dépend entièrement de l'efficacité de la compression de modèles.
Le pipeline de compression en pratique
Les organisations qui déploient l'IA à grande échelle appliquent généralement la compression comme une étape systématique du pipeline après l'entraînement :
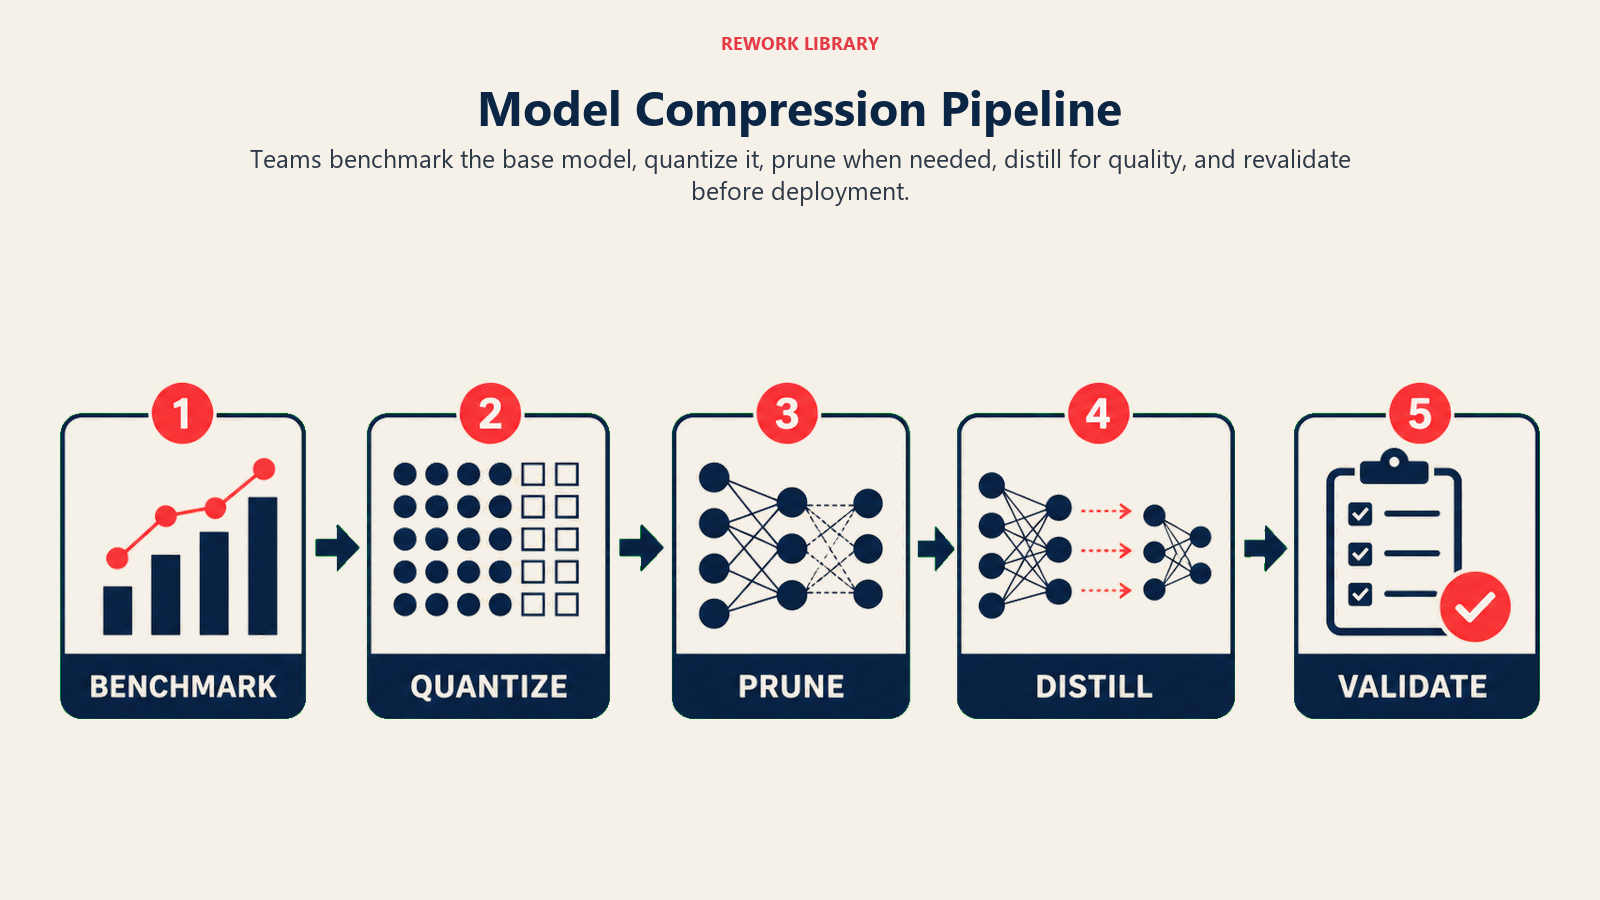
D'abord, l'équipe évalue le modèle de base à l'aune de benchmarks de précision propres à la tâche. Cela fournit une référence pour mesurer la qualité de la compression.
Ensuite, on applique la quantization, en général d'abord en 8 bits pour voir si elle répond aux exigences, puis en 4 bits si une compression supplémentaire est nécessaire. C'est l'étape la plus rapide, et elle suffit souvent.
Troisièmement, si les exigences de latence ou de taille ne sont toujours pas atteintes, on applique le pruning, en commençant généralement par supprimer les poids de plus faible amplitude jusqu'à 50 % de parcimonie, puis on réévalue.
Enfin, si le cas d'usage justifie l'investissement en entraînement, la distillation crée une architecture plus petite, entraînée sur les sorties du modèle compressé ou du modèle d'origine. C'est l'approche de meilleure qualité, mais aussi la plus coûteuse.
Les pipelines MLOps automatisent de plus en plus ce processus : la compression et le benchmarking s'exécutent dans le workflow de déploiement du modèle, et non plus comme un exercice ponctuel.
Ce que la compression ne peut pas faire
La compression de modèles optimise un modèle existant. Elle ne corrige pas un modèle mal entraîné, nourri de mauvaises données ou fondamentalement inadapté à la tâche. Compresser un modèle biaisé donne un modèle biaisé plus petit. Compresser un modèle de langage qui hallucine produit un modèle qui hallucine à moindre coût.
La phase de compression est aussi celle où une dégradation subtile de la précision peut apparaître d'une façon que les tests de benchmark n'avaient pas révélée. Un modèle compressé peut se comporter à l'identique sur des données de test mises de côté, mais échouer sur des cas limites réels que votre jeu de test ne couvrait pas. Le suivi des modèles après le déploiement d'un modèle compressé est aussi important que pour le modèle d'origine.
Concepts d'IA connexes
- Quantization - La technique de compression la plus répandue
- Distillation de connaissances - Entraîner de petits modèles à imiter de grands modèles
- Optimisation de l'inférence - L'ensemble plus large des techniques pour une inférence d'IA plus rapide et moins chère
- Edge AI - Pourquoi la compression permet un déploiement hors du cloud
- MLOps - Comment la compression s'insère dans les workflows d'IA en production
- Suivi des modèles - Suivre les performances d'un modèle compressé en production
Ressources externes
- Hugging Face Optimum - Boîte à outils open source de compression et d'optimisation de modèles
- NVIDIA TensorRT - Optimisation de l'inférence en production avec compression intégrée
- Google ML Practicum - Guides pratiques sur l'efficacité des modèles
Questions fréquentes sur la compression de modèles
Qu'est-ce que la compression de modèles ?
La compression de modèles est un ensemble de techniques qui réduisent la taille, les besoins en mémoire et le coût d'inférence d'un modèle d'IA tout en conservant le plus de précision possible. Les principales méthodes sont la quantization (réduction de la précision numérique), le pruning (suppression des poids à faible impact), la distillation de connaissances (entraîner un modèle plus petit à imiter un modèle plus grand) et la décomposition de rang faible.
Quelle précision perd-on en compressant un modèle ?
Pour la plupart des applications métier, les techniques de compression modernes entraînent une perte de précision inférieure à 2-5 %. La quantization 8 bits perd en général moins de 1 %. L'arbitrage acceptable dépend du cas d'usage : le service client et les applications de contenu tolèrent bien de petites pertes ; les applications critiques en matière de sécurité exigent des tests rigoureux.
Quand une entreprise doit-elle investir dans la compression de modèles ?
Quand les coûts d'inférence pèsent réellement dans le budget, quand la latence des réponses affecte l'expérience utilisateur, ou quand vous devez déployer l'IA sur des appareils edge ou dans des environnements sans accès fiable au cloud. Si vous effectuez des millions d'appels d'inférence par mois, même une quantization de base s'amortit probablement en quelques semaines.
La compression de modèles revient-elle à utiliser un modèle plus petit ?
Pas tout à fait. La compression part d'un grand modèle bien entraîné et le rend plus petit. Utiliser un modèle plus petit revient à entraîner de zéro une architecture compacte. La compression donne généralement de meilleurs résultats pour une même taille cible, car le modèle élève bénéficie des connaissances déjà présentes dans le modèle plus grand.

Co-Founder, Rework.com