Was ist Context Engineering?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Aktualisiert im Juli 2026
Context Engineering ist die Disziplin, alles zusammenzustellen, was ein Large Language Model zum Zeitpunkt der Inferenz sieht, den System-Prompt, abgerufene Dokumente, Tool-Ausgaben, Gesprächsverlauf und Arbeitsgedächtnis, damit es genau die Informationen hat, die es braucht, um eine Aufgabe gut zu erledigen. Es ist die Praxis, die Prompt Engineering 2025 und 2026 als zentrale Fähigkeit beim Bau von KI abgelöst hat.
Für Führungskräfte macht Context Engineering den Unterschied zwischen einem KI-System, das rät, und einem, das weiß. Ein Support-Agent, der Bestellhistorie, Rückgaberichtlinie und frühere Tickets des Kunden in seinen Arbeitskontext zieht, bevor er antwortet, liegt öfter richtig als einer, der sich allein auf einen cleveren Prompt verlässt. Der Prompt ist eine Eingabe unter vielen; Context Engineering ist die Aufgabe, all diese gemeinsam zu managen, bei jedem einzelnen Aufruf, nicht nur beim ersten.
Warum Context Engineering Prompt Engineering abgelöst hat
Prompt Engineering behandelte gute KI-Ausgaben als Formulierungsproblem: die magische Phrase finden, die richtige Persona, die perfekte Anweisungsstruktur, dann würde das Modell liefern. Diese Sichtweise ergab Sinn, solange ein einzelner gut formulierter Prompt das meiste war, was ein Nutzer kontrollierte. Sie hörte auf, Sinn zu ergeben, sobald Teams anfingen, KI-Agenten und mehrstufige Systeme zu bauen, in denen der Prompt nur ein kleiner, fester Teil eines viel größeren, sich ständig ändernden Informationspools ist, mit dem das Modell arbeiten muss.
Der Begriff „Context Engineering" wurde Mitte 2025 durch zwei prominente Stimmen der KI-Branche popularisiert. Andrej Karpathy nannte es „die feinfühlige Kunst und Wissenschaft, das Kontextfenster mit genau den richtigen Informationen für den nächsten Schritt zu füllen", und argumentierte, dass „Context Engineering" weit besser beschreibe, womit produktive KI-Teams tatsächlich ihre Zeit verbringen, als „Prompt Engineering" es je tat. Etwa zur selben Zeit beschrieb Shopify-CEO Tobi Lutke es öffentlich als „die Kunst, allen Kontext bereitzustellen, damit die Aufgabe plausibel vom LLM gelöst werden kann".
Anthropics Engineering-Team fasste den Wandel in der eigenen Anleitung zum Bau von KI-Agenten so zusammen: Context Engineering ist „die Gesamtheit der Strategien zur Kuratierung und Pflege der optimalen Menge an Tokens" während der Inferenz, die System-Prompt, Tools, Beispiele, Nachrichtenverlauf und abgerufene Daten gemeinsam umfassen, nicht den Prompt isoliert betrachtet. Die zugrunde liegende Erkenntnis hinter diesem Wandel: Frontier-Modelle sind inzwischen stark genug für die meisten Geschäftsaufgaben. Die Lücke zwischen einem System, das funktioniert, und einem, das es nicht tut, hängt heute meist davon ab, welche Informationen dem Modell gegeben wurden, nicht mit welchen Worten man danach fragte.
Kernkomponenten von Context Engineering
Jedes context-engineered System besteht aus denselben paar Bausteinen, die bei jedem Modellaufruf zusammengestellt und neu zusammengestellt werden.
- System-Prompt: Die dauerhaften Anweisungen, die Rolle, Tonfall und Grenzen der KI festlegen. Das ist, was die meisten Menschen mit „Prompt Engineering" meinen, jetzt nur noch eine Eingabe unter mehreren.
- Memory: Kurzfristiges Arbeitsgedächtnis für die aktuelle Aufgabe, plus längerfristiges Gedächtnis für Fakten, Präferenzen und Ergebnisse, die über Sitzungen hinweg erhalten bleiben sollen. Siehe AI Memory dafür, wie sich das von den Trainingsdaten eines Modells unterscheidet.
- Retrieval-Augmented Generation (RAG): Der Mechanismus, um relevante Dokumente, Datensätze oder Wissensdatenbankeinträge genau dann in den Kontext zu ziehen, wenn sie gebraucht werden, statt zu hoffen, dass das Modell sie bereits kennt. Ausführlich behandelt in Retrieval-Augmented Generation.
- Tools: Die Funktionen, APIs und Systeme, die das Modell aufrufen kann, und ebenso wichtig, die Ausgaben dieser Aufrufe, die dann Teil des Kontexts für den nächsten Schritt werden. Siehe Tool Use.
- Beispiele: Eine kleine Zahl gut gewählter, repräsentativer Beispiele (Few-Shot-Demonstrationen), die dem Modell zeigen, wie eine gute Ausgabe aussieht, kuratiert nach Relevanz statt nach erschöpfender Abdeckung.
- State: Der laufende Gesprächsverlauf, bereits ergriffene Maßnahmen und Zwischenergebnisse, die einen mehrstufigen Agenten vom ersten bis zum letzten Schritt konsistent halten, statt jeden Wechsel als Neuanfang zu behandeln.
Wird auch nur einer dieser Bausteine falsch gehandhabt (eine überladene Tool-Liste, ein veraltetes Memory, ein irrelevantes abgerufenes Dokument), verschlechtert das die Ausgabequalität genauso stark wie früher ein schlecht formulierter Prompt.
Wie Context Engineering in agentischen Systemen funktioniert
In einem agentischen KI-System wird der Kontext nicht einmal zusammengestellt und dann sich selbst überlassen. Er wird bei jedem Schritt der Schleife neu aufgebaut oder aktualisiert: Das System sammelt, was es aktuell weiß (System-Prompt, Memory, abgerufene Daten), das Modell denkt über diesen Kontext nach und entscheidet über eine Aktion, Tool Use führt diese Aktion an einem realen System aus, und das Ergebnis fließt zurück in den Kontext für die nächste Entscheidung. Mehrstufige agentische Workflows können diese Schleife Dutzende oder Hunderte Male durchlaufen, bevor eine Aufgabe erledigt ist, was bedeutet, dass sich kleine Kontextfehler am Anfang bis zum Ende aufsummieren können.
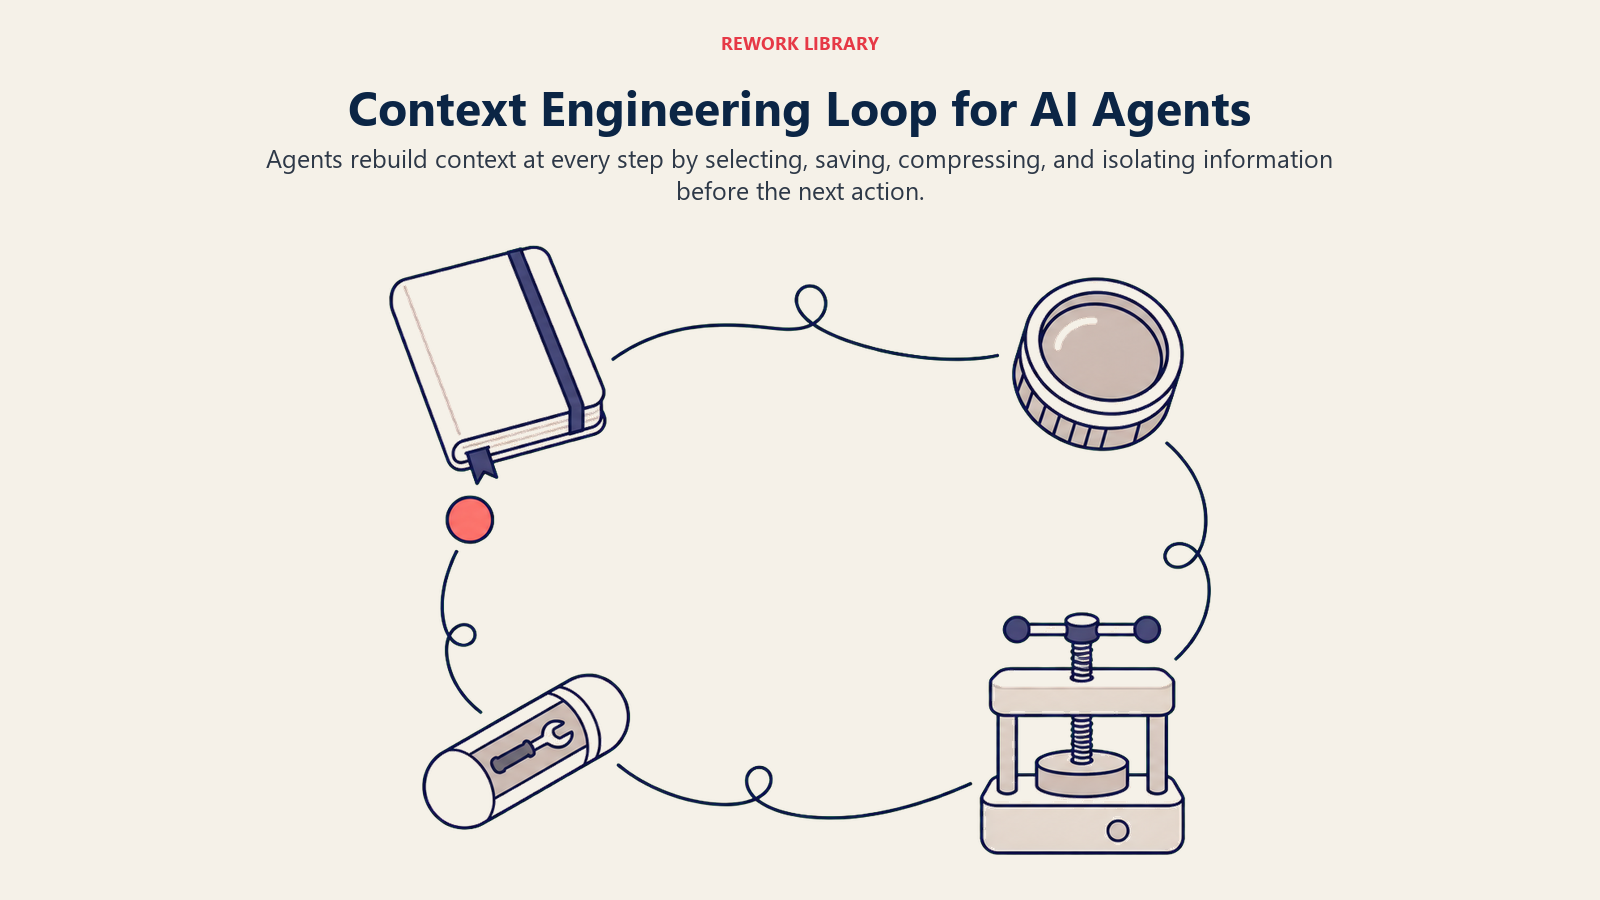
Das Engineering-Team von LangChain hat die praktische Arbeit des Context Engineering in vier wiederkehrende Strategien gegliedert: write (dem Agenten einen Ort geben, um Informationen außerhalb des Hauptkontexts zu speichern, wie Scratchpads oder Notizen), select (nur das heranziehen, was für den aktuellen Schritt relevant ist, nicht jedes verfügbare Dokument), compress (Kontext zusammenfassen oder kürzen, sobald er zu lang wird) und isolate (eine komplexe Aufgabe auf mehrere Agenten oder Sub-Kontexte aufteilen, damit kein einzelner Kontext überladen wird). Der Großteil der produktiven Context-Engineering-Arbeit ist eine Kombination dieser vier Bewegungen, fortlaufend wiederholt, während die Aufgabe läuft. KI-Orchestrierung ist die Schicht, die dies typischerweise über einem einzelnen Agenten oder über mehrere hinweg steuert.
Kontextfenster-Management und Fehlermodi
Jedes Modell hat ein endliches Kontextfenster, die maximale Anzahl an Tokens, die es auf einmal verarbeiten kann. Aber Context Engineering existiert, weil das Überlaufen des Fensters in der Praxis nicht das Hauptproblem ist. Forschung von Chroma testete 18 Frontier-Modelle, darunter GPT-4.1, Claude Opus 4, Gemini 2.5 und Qwen3, mit Eingaben von 25 bis 10.000 Wörtern und stellte fest, dass die Genauigkeit bei einfachen Abruf- und Erinnerungsaufgaben mit zunehmender Eingabelänge stetig abnahm, deutlich bevor irgendein Modell sein angegebenes Token-Limit erreichte. Dieser allmähliche Rückgang hat einen Namen: Context Rot, die Tendenz, dass die Fähigkeit eines Modells, Informationen korrekt zu nutzen, mit der Menge des gehaltenen Kontexts sinkt, selbst bei Aufgaben, die es mit einer kürzeren Eingabe mühelos lösen würde.
Context Rot ist kein einzelner Fehler, sondern ein Bündel verwandter Fehler. Der Autor Drew Breunig katalogisierte vier spezifische Muster, die das meiste erklären, worauf Praktiker stoßen:
- Context Poisoning: Eine Halluzination oder ein Fehler wird in den Kontext geschrieben (eine falsche Tatsache in einer Memory-Notiz, eine falsche Annahme in einem verfolgten Ziel) und wird dann wiederholt referenziert, wodurch sich der Fehler verstärkt statt korrigiert zu werden.
- Context Distraction: Das Modell stützt sich zu stark auf den angesammelten Verlauf und beginnt, vergangene Aktionen zu wiederholen, statt frisch über den nächsten Schritt nachzudenken.
- Context Confusion: Irrelevante Informationen im Kontext fließen in die Antwort ein und senken die Antwortqualität, selbst wenn die korrekte Information ebenfalls vorhanden war.
- Context Clash: Zu unterschiedlichen Zeitpunkten einer langen Sitzung hinzugefügte Informationen beginnen, sich zu widersprechen, und das Modell hat keine verlässliche Möglichkeit zu wissen, welche Version aktuell ist.
Ein gut dokumentiertes reales Beispiel für Context Poisoning: Google DeepMinds eigenes Projekt Gemini Plays Pokemon, ein live gestreamtes Experiment, bei dem Gemini 2.5 Pro autonom Pokemon Blau durchspielte. An einem Punkt halluzinierte der Agent, er müsse ein Item namens „TEA" finden (das es in dieser Spielversion nicht gibt), schrieb dieses falsche Ziel in seinen dauerhaften Kontext und verfolgte dann stundenlang ein unmögliches Ziel, bevor das Team ihn wieder freibekam. Die Lösung in produktiven Systemen ist kein größeres Kontextfenster, sondern das aktive Managen dessen, was im Kontext bleibt und wie lange.
Context Engineering vs. Prompt Engineering
| Aspekt | Prompt Engineering | Context Engineering |
|---|---|---|
| Kernfrage | Welche Worte erzielen die beste Antwort? | Welche Informationen braucht das Modell, um erfolgreich zu sein? |
| Umfang | Eine einzelne Anweisung oder Nachricht | Alles im Arbeitskontext des Modells: Prompt, Memory, Tools, abgerufene Daten, Verlauf |
| Zeitpunkt | Einmal geschrieben, meist statisch | Fortlaufend kuratiert, bei jedem Schritt neu zusammengestellt |
| Hauptfähigkeit | Schreiben und Formulieren | Auswählen, Komprimieren und Strukturieren von Informationen |
| Häufiger Fehler | Vage oder mehrdeutige Anweisungen | Context Rot: Poisoning, Distraction, Confusion, Clash |
| Passt am besten zu | Einzelrunden-Chat, einfache Q&A | Mehrstufige agentische Workflows, RAG-Systeme, lange laufende Agenten |
| Wo es heute steht | Eine Teilmenge von Context Engineering | Die übergeordnete Disziplin, die Prompt Engineering einschließt |
Prompt Engineering ist nicht verschwunden, es wurde aufgenommen. Einen klaren System-Prompt zu schreiben ist weiterhin ein Teil der Arbeit, nur nicht mehr die ganze Aufgabe.
Reale Anwendungsfälle von Context Engineering
Kundensupport-Agenten: Bevor geantwortet wird, ruft das System Kontostatus, Bestellhistorie und das für die Frage relevante Richtliniendokument des Kunden ab und hält diesen Kontext für den Rest des Gesprächs verfügbar, statt ihn bei jedem Wechsel erneut abzurufen.
Coding-Agenten: Tools wie Claude Code und ähnliche Coding-Assistenten verwalten den Repository-Kontext direkt und entscheiden, welche Dateien, früheren Änderungen und Testergebnisse im Arbeitskontext des Modells bleiben, während eine Aufgabe über viele Schritte fortschreitet, da das Einbeziehen des gesamten Codebestands auf einmal jedes Fenster sprengen und Context Rot begünstigen würde.
Vertriebs- und RevOps-Agenten: Ein Agent, der einen Lead qualifiziert oder nachfasst, zieht relevante CRM-Datensätze, frühere Interaktionen und Kontodetails über RAG heran, statt sich auf das allgemeine Wissen des Modells über das Unternehmen zu verlassen.
Lange laufende autonome Agenten: Browser-Use- und Recherche-Agenten, die über viele Schritte oder Sitzungen hinweg arbeiten, sind auf bewusstes Memory-Management angewiesen, speichern Wichtiges dauerhaft und entfernen Unwichtiges, damit der Arbeitskontext fokussiert bleibt, statt alles anzusammeln, was der Agent je gesehen hat.
Wichtige Fakten
- Anthropic definiert Context Engineering als „die Gesamtheit der Strategien zur Kuratierung und Pflege der optimalen Menge an Tokens", die einem Modell während der Inferenz zur Verfügung stehen, und umfasst System-Prompt, Tools, Beispiele und Nachrichtenverlauf, nicht den Prompt allein. Anthropic Engineering
- Andrej Karpathys Beitrag vom Juni 2025, der Context Engineering als „die feinfühlige Kunst und Wissenschaft, das Kontextfenster mit genau den richtigen Informationen für den nächsten Schritt zu füllen" beschreibt, gilt weithin als Ursprung der Popularisierung des Begriffs. X / Karpathy
- Chromas Context-Rot-Forschung testete 18 Frontier-Modelle, darunter GPT-4.1, Claude Opus 4, Gemini 2.5 und Qwen3, über Eingabelängen von 25 bis 10.000 Wörtern und stellte eine konsistent sinkende Genauigkeit bei wachsenden Eingaben fest, deutlich bevor das angegebene Kontextlimit eines Modells erreicht wurde. Chroma Research
- LangChains State-of-AI-Agents-Umfrage 2026 ergab, dass 57 % der befragten Teams inzwischen Agenten im produktiven Einsatz betreiben, wobei die Ausgabequalität, einschließlich des Managements von Kontext im großen Maßstab, von 32 % als größte Hürde für zuverlässige Produktionsleistung genannt wurde. LangChain
- Das Engineering-Team von LangChain ordnet die praktische Arbeit des Context Engineering vier wiederkehrenden Strategien zu: write, select, compress und isolate. LangChain Blog
- Google DeepMinds Projekt Gemini Plays Pokemon lieferte einen dokumentierten Fall von Context Poisoning: Ein halluziniertes Spielziel gelangte in den dauerhaften Kontext des Agenten und brachte dessen Spielverlauf für Stunden aus der Bahn, bevor das Team eingreifen konnte. TechCrunch
- Der Autor Drew Breunig katalogisierte vier unterschiedliche Kontext-Fehlermodi, Poisoning, Distraction, Confusion und Clash, die zusammen das meiste erklären, was Praktiker als Context Rot bezeichnen. dbreunig.com
Häufig gestellte Fragen zu Context Engineering
Was ist Context Engineering einfach erklärt?
Context Engineering ist die Praxis, zu entscheiden, welche Informationen ein Large Language Model sieht, bevor es antwortet, den System-Prompt, abgerufene Dokumente, Tool-Ergebnisse, Memory und Gesprächsverlauf, damit es hat, was es für die Aufgabe braucht. Es ist umfassender als das Schreiben eines guten Prompts.
Wie unterscheidet sich Context Engineering von Prompt Engineering?
Prompt Engineering konzentriert sich auf die Formulierung einer einzelnen Anweisung. Context Engineering verwaltet alles, was das Modell bei jedem Schritt sieht: den Prompt plus Memory, abgerufene Daten, Tool-Ausgaben und Verlauf, fortlaufend kuratiert statt einmal geschrieben.
Was sind die Hauptkomponenten von Context Engineering?
Der System-Prompt, kurz- und langfristiges Memory, Retrieval-Augmented Generation (RAG) zum Heranziehen relevanten Wissens, Tools und ihre Ausgaben, kuratierte Beispiele und der laufende Gesprächs-State.
Was ist Context Rot?
Context Rot ist die Tendenz, dass Genauigkeit und Erinnerungsfähigkeit eines Modells sinken, je mehr Informationen sein Kontext enthält, und zwar deutlich bevor das angegebene Kontextfenster-Limit des Modells erreicht wird. Es ist kein harter Abbruch, sondern ein allmählicher Rückgang.
Was ist Context Poisoning?
Context Poisoning tritt auf, wenn eine Halluzination oder ein Fehler in den dauerhaften Kontext eines Systems geschrieben wird, etwa in eine Memory-Notiz oder ein verfolgtes Ziel, und dann immer wieder referenziert wird, wodurch sich der ursprüngliche Fehler verstärkt statt korrigiert zu werden.
Wer hat den Begriff Context Engineering geprägt?
Der Begriff fand Mitte 2025 breite Verbreitung, nach Beiträgen von Andrej Karpathy und Shopify-CEO Tobi Lutke, und wurde rasch von KI-Labs wie Anthropic sowie Frameworks wie LangChain in ihrer eigenen Engineering-Anleitung übernommen.
Ersetzt Context Engineering Prompt Engineering vollständig?
Nein. Einen klaren, gut strukturierten Prompt zu schreiben, bleibt Teil der Arbeit, nur eben eine Komponente innerhalb der größeren Disziplin Context Engineering statt der gesamten Aufgabe.
Wie hängt Context Engineering mit RAG zusammen?
Retrieval-Augmented Generation ist eines der wichtigsten Werkzeuge, die Context Engineers nutzen: Statt zu hoffen, dass ein Modell etwas bereits weiß, ruft RAG das relevante Dokument oder den Datensatz ab und fügt es genau dann dem Kontext hinzu, wenn es gebraucht wird.
Was ist ein guter erster Schritt, um Context Engineering zu üben?
Prüfen Sie, was bei einem echten produktiven Aufruf tatsächlich im Kontext Ihres Systems steckt, den Prompt, abgerufene Daten, Tool-Ausgaben und Verlauf, und suchen Sie nach Veraltetem, Irrelevantem oder Fehlendem, bevor Sie annehmen, dass die Prompt-Formulierung das Problem ist.
Verwandte KI-Konzepte
- Was ist Agentic AI? - Die autonomen Systeme, die auf gut konstruierten Kontext angewiesen sind, um zuverlässig zu funktionieren
- Kontextfenster - Das Token-Limit, innerhalb dessen Context Engineering arbeiten muss
- Prompt Engineering - Die engere Disziplin, die Context Engineering aufgenommen und erweitert hat
- Large Language Models - Die Systeme, die den für sie zusammengestellten Kontext verarbeiten
- Retrieval-Augmented Generation - Die wichtigste Technik, um externes Wissen in den Kontext zu ziehen
- AI Memory - Kurz- und langfristiges Gedächtnis als Komponente des Context Engineering
- Tool Use - Wie Tool-Ausgaben Teil des laufenden Kontexts eines Agenten werden
- Model Context Protocol - Der offene Standard, um externe Tools und Daten konsistent in den Kontext eines Modells einzuspeisen
- Agentische Workflows - Mehrstufige Prozesse, bei denen der Kontext über viele Schritte hinweg konsistent bleiben muss
- KI-Orchestrierung - Die Koordinationsschicht, die Kontext über mehrere Agenten oder Schritte hinweg verwaltet
Externe Ressourcen
- Anthropic: Effective Context Engineering for AI Agents - Anthropics eigene Anleitung zur Kuratierung von Kontext für die Zuverlässigkeit von Agenten
- LangChain: Context Engineering for Agents - Das Write-Select-Compress-Isolate-Framework
- LangChain: State of AI Agents 2026 - Umfragedaten zur Einführung produktiver Agenten und zu Qualitätshürden
- Chroma Research: Context Rot - Benchmark-Daten zur Leistungsverschlechterung über 18 Frontier-Modelle
- Drew Breunig: How Long Contexts Fail - Die vier benannten Kontext-Fehlermodi
- TechCrunch: Google's Gemini Panicked While Playing Pokemon - Ein dokumentierter realer Fall von Context Poisoning
Teil der AI Terms Collection. Zuletzt aktualisiert: 2026-07-16

Co-Founder, Rework.com
On this page
- Warum Context Engineering Prompt Engineering abgelöst hat
- Kernkomponenten von Context Engineering
- Wie Context Engineering in agentischen Systemen funktioniert
- Kontextfenster-Management und Fehlermodi
- Context Engineering vs. Prompt Engineering
- Reale Anwendungsfälle von Context Engineering
- Wichtige Fakten
- Verwandte KI-Konzepte
- Externe Ressourcen