¿Qué es Clustering? Descubriendo las Tribus Ocultas en tus Datos
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
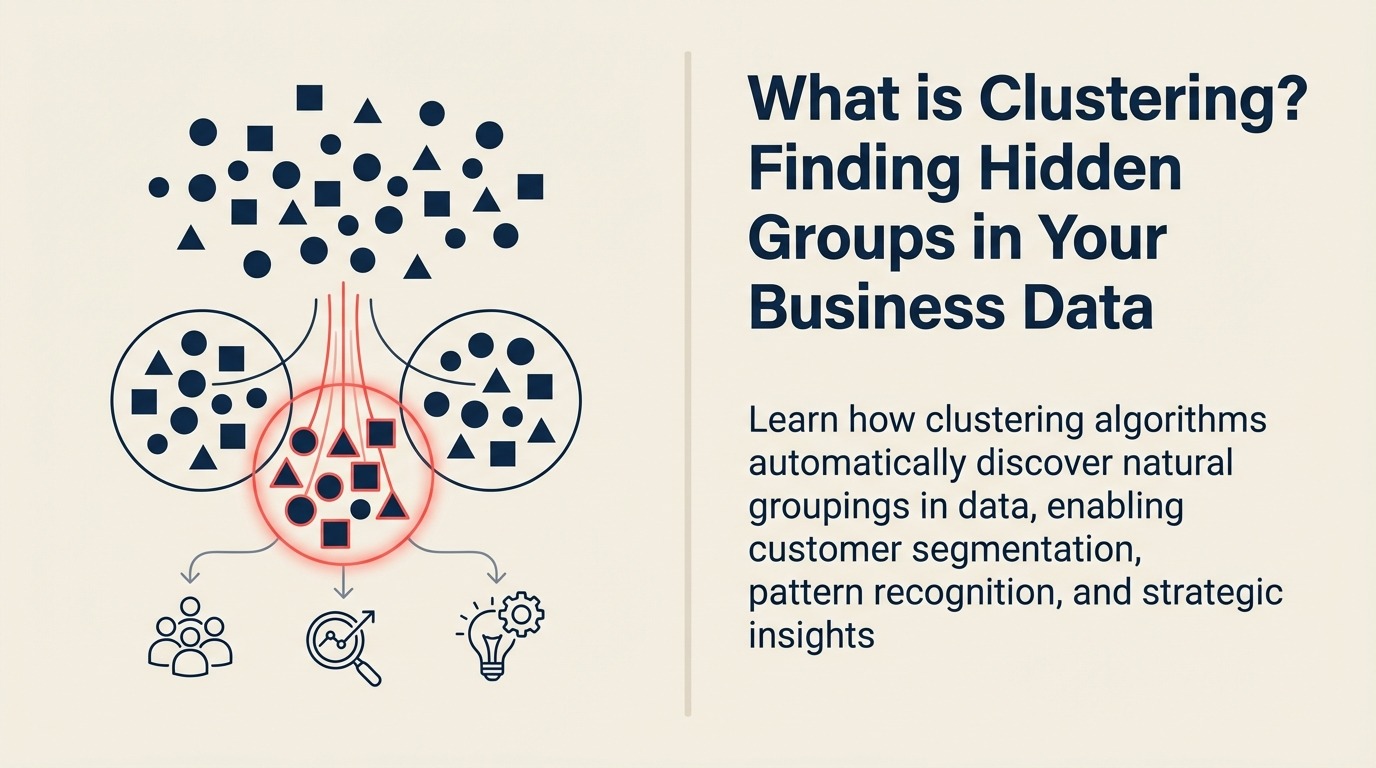
El clustering empresarial es una técnica de unsupervised machine learning que agrupa clientes, productos o mercados en segmentos naturales según cómo se comportan realmente, sin que usted defina los grupos de antemano. Revela segmentos de alto valor que la demografía tradicional pasa por alto, y por eso las empresas lo usan para la segmentación de clientes, el análisis de mercado y el descubrimiento de patrones.
El 87% de las empresas segmenta clientes incorrectamente. Usan demografía básica - edad, ingresos, ubicación - cuando el verdadero oro está en patrones de comportamiento. Ahí es donde entra clustering. Es IA que encuentra grupos naturales en tus datos, revelando segmentos que nunca supiste que existían. Como el minorista que descubrió que sus "compradores de yogur del domingo por la mañana" eran su segmento más rentable.
Entendiendo Clustering
¿Sabes cómo las personas naturalmente forman grupos en fiestas? Los fanáticos del deporte gravitan juntos, los padres se encuentran, los tecnólogos se agrupan en esquinas. Los algoritmos de clustering hacen lo mismo con datos - encontrando agrupaciones naturales sin que se les diga qué buscar.
Más técnicamente, clustering es una técnica de unsupervised machine learning que agrupa puntos de datos similares basándose en sus características. A diferencia de la clasificación (que necesita etiquetas), clustering descubre patrones por sí solo.
La diferencia clave es descubrimiento versus predicción. La clasificación de supervised learning pregunta "¿Es este cliente de alto valor?" cuando ya sabes qué significa alto valor. Clustering pregunta "¿Qué tipos de clientes tenemos?" y deja que los datos revelen la respuesta.
Cómo Funciona Realmente Clustering
Clustering opera midiendo similitud. Primero, representa cada punto de datos en espacio matemático - la edad del cliente podría ser una dimensión, frecuencia de compra otra, valor promedio de orden una tercera. Como trazar puntos en un mapa multidimensional.
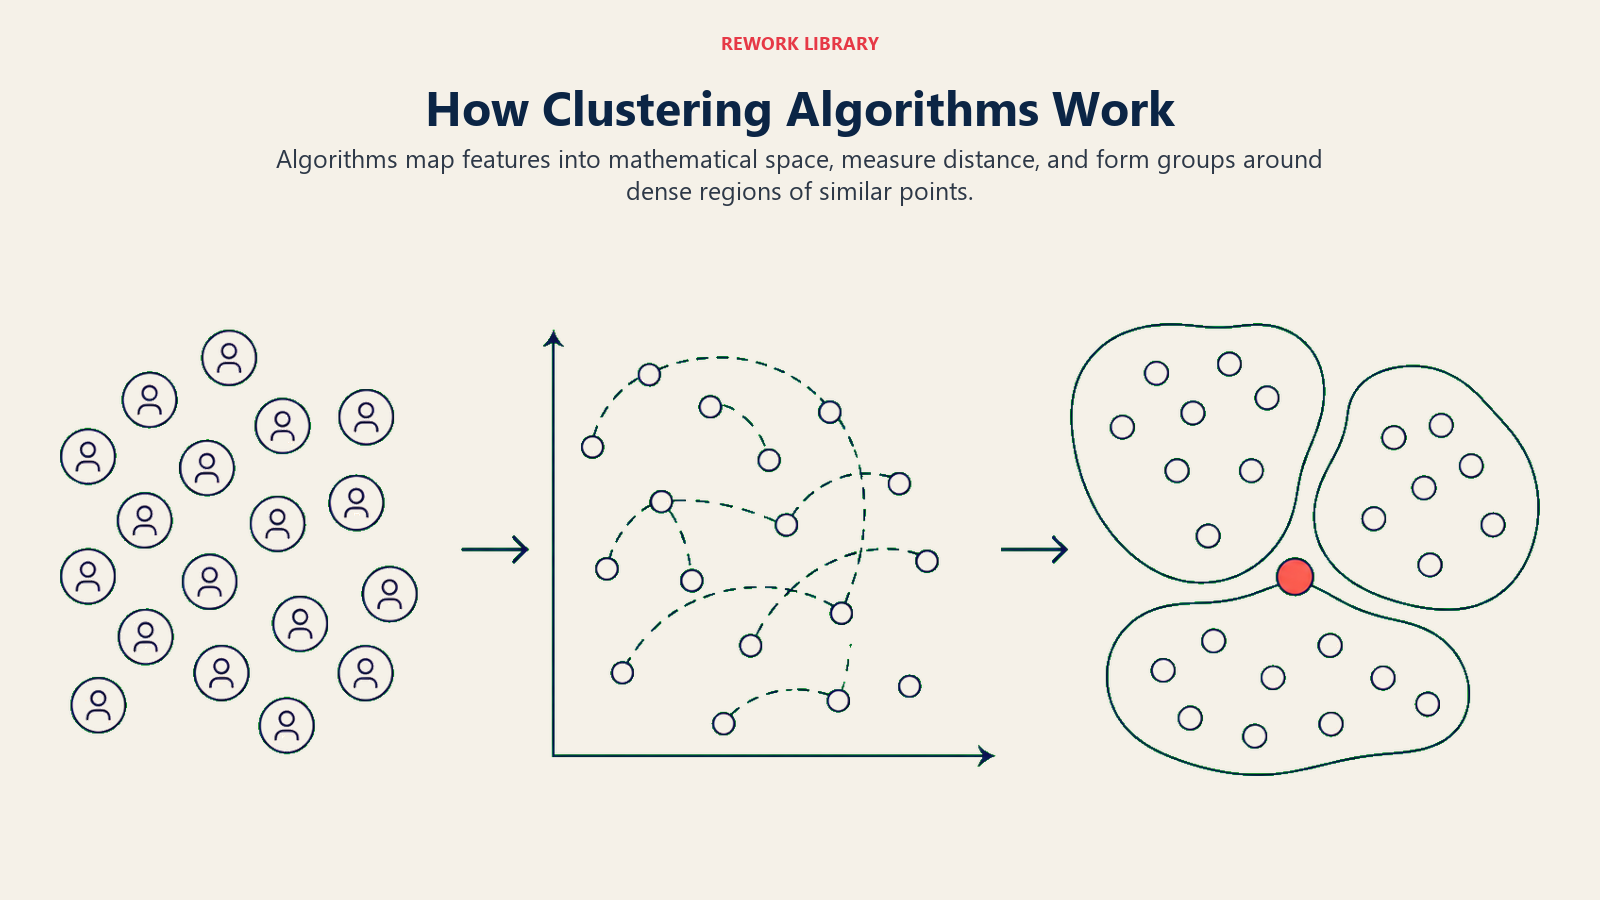
Luego, los algoritmos calculan distancias entre todos los puntos. Ítems similares están cerca juntos, ítems diferentes lejos. Un comprador de lujo y un comprador económico podrían estar distantes incluso si tienen la misma edad y ubicación.
Finalmente, se forman grupos basados en proximidad. El algoritmo dibuja límites alrededor de áreas densas de puntos similares. Podrías descubrir cinco segmentos distintos de clientes donde pensabas que tenías dos.
La magia ocurre al definir "similitud" - los algoritmos modernos de machine learning pueden manejar cientos de dimensiones y relaciones complejas que los humanos no pueden visualizar.
Aplicaciones de Clustering del Mundo Real
Segmentación de Clientes Retail Un minorista de moda aplicó clustering a historial de compras, comportamiento de navegación y patrones de devoluciones. Descubrió siete segmentos incluyendo "seguidores de tendencias" (compran inmediatamente después del lanzamiento) y "cazadores de ofertas" (solo compran artículos con descuento). Marketing personalizado a cada segmento aumentó ingresos 34%.
Grupos de Pacientes Healthcare Hospital agrupó datos de pacientes más allá de factores de riesgo tradicionales. Encontró subgrupos que respondían diferentemente a tratamientos. Un cluster de diabetes respondió 3x mejor a intervenciones de estilo de vida que medicación. La personalización del tratamiento mejoró resultados 40%.
Evaluación de Riesgo Financiero Banco agrupó solicitantes de préstamos para pequeñas empresas usando métricas financieras, datos de industria y patrones de transacciones. Identificó clusters de riesgo que la puntuación tradicional omitió. Tasas de default cayeron 25% mientras tasas de aprobación aumentaron 15%.
Optimización de Cadena de Suministro Fabricante agrupó proveedores por desempeño de entrega, métricas de calidad y patrones de comunicación. Reveló patrones ocultos de confiabilidad. Reestructuró relaciones con proveedores, reduciendo retrasos en 30%.
Tipos de Algoritmos de Clustering
K-Means Clustering El caballo de batalla del clustering. Especificas cuántos clusters quieres, encuentra las mejores agrupaciones. Perfecto para segmentación de clientes donde necesitas grupos distintos que no se superpongan. Rápido y escalable.
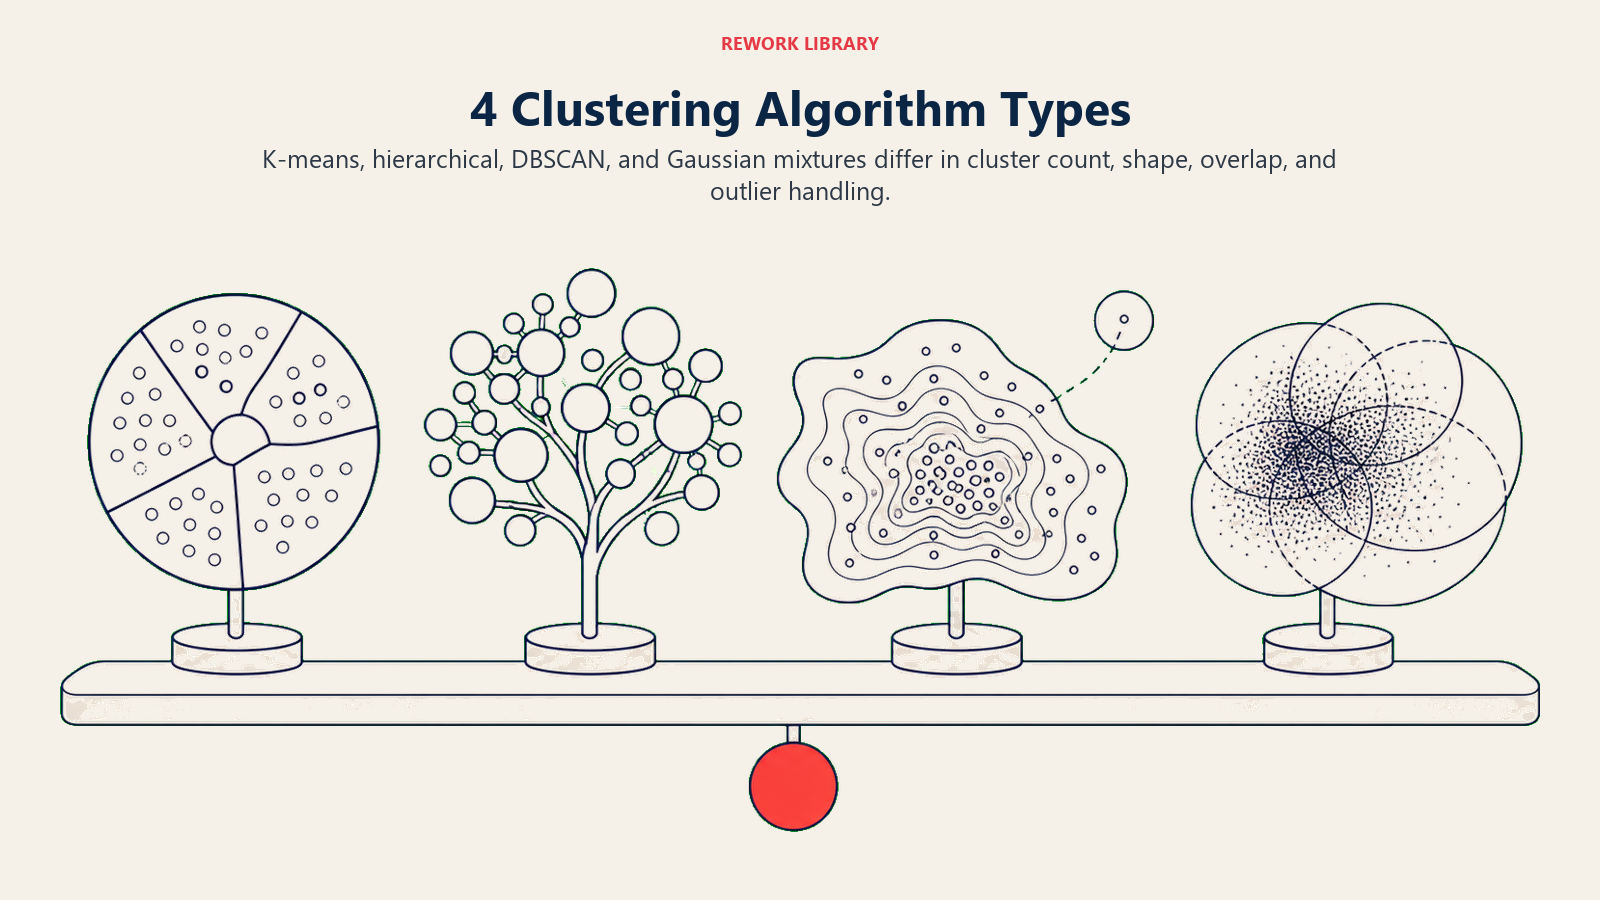
Hierarchical Clustering Construye un árbol de clusters - como organizar una empresa desde departamentos a equipos a individuos. Excelente cuando necesitas diferentes niveles de granularidad. Cadenas retail usan esto para agrupaciones de tiendas.
DBSCAN (Density-Based) Encuentra clusters de forma arbitraria e identifica outliers. Excelente para detección de fraude y anomaly detection - transacciones normales se agrupan juntas, fraudulentas destacan como outliers.
Gaussian Mixture Models Asume que los datos vienen de múltiples distribuciones estadísticas. Sofisticado pero poderoso. Usado en manufactura para identificar diferentes estados de calidad en producción.
Elegir el algoritmo adecuado depende de si ya sabe cuántos grupos espera, de si los grupos se superponen y de si necesita señalar outliers. Esta tabla asocia cada algoritmo con la situación empresarial a la que mejor se ajusta:
| Algoritmo | ¿Hay que definir el número de clusters? | Maneja outliers | Mejor uso empresarial |
|---|---|---|---|
| K-Means | Sí | No (fuerza cada punto en un grupo) | Segmentos de clientes limpios y distintos |
| Hierarchical | No | Limitado | Agrupaciones de tiendas o productos en varios niveles |
| DBSCAN | No | Sí (los aísla) | Detección de fraude y anomalías |
| Gaussian Mixture | Sí | Suave (probabilístico) | Segmentos superpuestos, estados de calidad |
Una regla práctica: comience con K-Means cuando quiera segmentos simples y sin superposición y tenga una idea aproximada de cuántos esperar; luego pruebe DBSCAN si sus datos tienen ruido o le importan los puntos que no encajan en ningún grupo. El hierarchical clustering se justifica cuando una misma segmentación debe servir a varias decisiones a la vez, como una vista regional y una vista por tienda a partir de los mismos datos.
La Diferencia del Clustering
Antes del Clustering: Marketing envía misma campaña a "Mujeres 25-34" Después del Clustering: Cinco segmentos distintos identificados:
- Profesionales enfocadas en carrera (responden a mensajes de eficiencia)
- Nuevas madres (valoran seguridad y conveniencia)
- Entusiastas del fitness (quieren características de rendimiento)
- Estudiantes conscientes del presupuesto (sensibles al precio)
- Compradores eco-conscientes (sostenibilidad importa)
Resultado: Tasas de click aumentaron 250%. Misma audiencia, segmentación más inteligente.
Cuándo Clustering Tiene Sentido
Imagina que tienes miles de productos pero no sabes cómo organizarlos. Las categorías tradicionales (electrónica, ropa) son demasiado amplias. Clustering revela agrupaciones naturales basadas en cómo compran realmente los clientes - "esenciales de compra rápida" o "compras que requieren investigación."
O digamos que estás entrando a un nuevo mercado. No conoces los segmentos de clientes aún. Clustering analiza early adopters y revela tipos distintos de usuarios a los que apuntar.
Hoja de Ruta de Implementación
Semana 1: Preparación de Datos
- Reúne características relevantes (comportamiento > demografía)
- Limpia y normaliza datos mediante data curation apropiada (crítico para clustering)
- Elimina outliers obvios
- Crea características derivadas (ratios, frecuencias)
Semana 2: Exploración
- Prueba múltiples algoritmos
- Experimenta con diferentes números de clusters
- Valida que resultados tengan sentido empresarial
- Obtén input de stakeholders sobre agrupaciones
Semana 3-4: Validación
- Prueba estabilidad de clusters a lo largo del tiempo
- Asegura que clusters sean accionables
- Calcula métricas empresariales por cluster
- Diseña estrategias específicas por cluster
Mes 2+: Operacionalización
- Automatiza asignación de cluster para nuevos datos vía prácticas de MLOps
- Crea dashboards de monitoreo
- Desarrolla tratamientos específicos por cluster
- Mide impacto y refina
Herramientas para Clustering
Soluciones No-Code:
- Tableau - Clustering integrado ($70/usuario/mes)
- Microsoft Power BI - Características de auto-clustering ($10/usuario/mes)
- Google Analytics 4 - Descubrimiento de audiencias (Gratis con límites)
Librerías Python (Gratis):
- scikit-learn - Todos los algoritmos principales
- HDBSCAN - Clustering de densidad avanzado
- pyclustering - Algoritmos especializados
Plataformas Enterprise:
- SAS Enterprise Miner - Suite completa de clustering (Precio personalizado)
- IBM SPSS Modeler - Clustering visual ($99/usuario/mes)
- DataRobot - Clustering automatizado ($75K+/año)
Servicios Cloud:
- AWS SageMaker - Clustering integrado ($0.05/hora)
- Google Vertex AI - AutoML clustering ($20/hora)
- Azure ML - Módulos de clustering ($9.90/hora de cómputo)
Errores Comunes de Clustering
Error 1: Forzar Número Incorrecto de Clusters CEO quiere 5 segmentos de clientes porque competidores tienen 5. Los datos claramente muestran 3 u 8 grupos naturales. Solución: Deja que los datos guíen números de clusters. Usa gráficos de codo y puntuaciones de silueta. La lógica empresarial debe refinar, no definir.
Error 2: Usar Características Incorrectas Agrupando clientes por edad e ingresos cuando el comportamiento de compra varía más por estilo de vida y valores. Solución: Enfócate en características de comportamiento y transaccionales. La demografía son actores secundarios, no protagonistas.
Error 3: Ignorar Evolución de Clusters Segmentos de clientes definidos en 2019, nunca actualizados. COVID cambió todo. Solución: Re-clustering trimestral o cuando ocurren eventos importantes. Implementa model monitoring para rastrear deriva de clusters.
Estrategias Avanzadas de Clustering
Multi-View Clustering Combina diferentes perspectivas de datos. Agrupa clientes por comportamiento de compra Y interacciones de soporte Y actividad del sitio web. Revela segmentos más ricos.
Semi-Supervised Clustering Incorpora algunas etiquetas conocidas para guiar clustering. "Sabemos que estos son clientes VIP, encuentra grupos similares." Balancea descubrimiento con conocimiento empresarial.
Dynamic Clustering Clusters que evolucionan a lo largo del tiempo. Rastrea cómo los clientes se mueven entre segmentos. Usa time series analysis para predecir transiciones de segmentos. Permite intervenciones proactivas.
Midiendo Éxito de Clustering
Métricas Técnicas:
- Coeficiente de silueta (separación de clusters)
- Índice Davies-Bouldin (compacidad de clusters)
- Puntuación Calinski-Harabasz (definición de clusters)
Métricas Empresariales:
- Ingresos por cluster
- Tasas de respuesta de marketing por cluster
- Diferencias de retención entre clusters
- Costos operacionales por cluster
Prueba de Accionabilidad: ¿Puedes crear estrategias distintas por cluster? Si todos los clusters reciben el mismo tratamiento, el clustering falló.
Clustering Específico por Industria
E-commerce:
- Grupos de afinidad de productos
- Segmentos de comportamiento de compra
- Clusters de compradores estacionales
- Grupos de sensibilidad al precio
B2B:
- Segmentación de cuentas
- Grupos de patrones de uso
- Clusters de potencial de crecimiento mejorados por predictive analytics
- Segmentos de perfiles de riesgo
Healthcare:
- Grupos de riesgo de pacientes
- Clusters de respuesta a tratamiento
- Segmentos de utilización de recursos
- Grupos de predicción de resultados
Haciendo que Clustering Funcione para Ti
Mira, clustering no es magia. Pero si estás tratando a todos los clientes igual, estás dejando dinero sobre la mesa.
Empieza pequeño: agrupa tus 1000 clientes principales por comportamiento de compra. Encontrarás segmentos que nunca imaginaste.
Aprende Más
Explora conceptos relacionados para profundizar tu comprensión de clustering y descubrimiento basado en datos:
- Unsupervised Learning - La categoría más amplia de técnicas ML que descubren patrones sin etiquetas
- Deep Learning - Enfoques neuronales avanzados para tareas complejas de clustering
- Neural Networks - La arquitectura subyacente que impulsa algoritmos modernos de clustering
- Business Intelligence - Cómo los insights de clustering alimentan la toma de decisiones estratégica
Recursos Externos
- Stanford HAI: Clustering Research - Investigación académica sobre algoritmos de clustering
- Scikit-learn Clustering Guide - Documentación práctica de implementación
- Papers With Code: Clustering - Últimas técnicas de clustering y benchmarks
Preguntas Frecuentes sobre Clustering
¿Qué es Clustering?
Clustering es una técnica de unsupervised machine learning que agrupa puntos de datos similares basándose en sus características, descubriendo patrones naturales sin que se le diga qué buscar.
¿Cuál es la diferencia entre clustering y clasificación?
La clasificación predice categorías cuando ya sabes qué categorías existen. Clustering descubre grupos desconocidos en datos sin etiquetas o categorías predefinidas.
¿Cuáles son los cuatro tipos principales de algoritmos de clustering?
K-Means (especifica número de clusters), Hierarchical (construye árbol de clusters), DBSCAN (encuentra formas arbitrarias y outliers), y Gaussian Mixture Models (asume distribuciones estadísticas).
¿Cuáles son los beneficios clave del clustering para negocios?
Descubrimiento de segmentos ocultos de clientes, personalización mejorada, mejor comprensión del mercado, optimización de recursos e identificación de patrones que la segmentación tradicional omite.
¿Cuáles son errores comunes en implementación de clustering?
Forzar número incorrecto de clusters (deja que datos guíen), usar características incorrectas (enfócate en comportamiento sobre demografía), e ignorar evolución de clusters (los segmentos cambian con el tiempo).
Parte de la [Colección de Términos de IA]. Última actualización: 2026-07-21

Co-Founder, Rework.com
On this page
- Entendiendo Clustering
- Cómo Funciona Realmente Clustering
- Aplicaciones de Clustering del Mundo Real
- Tipos de Algoritmos de Clustering
- La Diferencia del Clustering
- Cuándo Clustering Tiene Sentido
- Hoja de Ruta de Implementación
- Herramientas para Clustering
- Errores Comunes de Clustering
- Estrategias Avanzadas de Clustering
- Midiendo Éxito de Clustering
- Clustering Específico por Industria
- Haciendo que Clustering Funcione para Ti
- Aprende Más
- Recursos Externos