Was ist ein KI-Chip?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Aktualisiert im Juli 2026
Ein KI-Chip ist ein Prozessor, der eigens dafür gebaut wurde, Workloads für künstliche Intelligenz auszuführen: neuronale Netze zu trainieren und laufen zu lassen. Anders als eine Allzweck-CPU ist er auf die massive parallele Mathematik optimiert, die KI erfordert. GPUs, TPUs, NPUs und kundenspezifische ASICs sind allesamt KI-Chips, die jeweils auf unterschiedliche Weise Flexibilität gegen Geschwindigkeit und Effizienz eintauschen.
Jede KI-Funktion, mit der Ihr Unternehmen in Berührung kommt, ein Chatbot, der eine Kundenfrage beantwortet, ein Betrugsmodell, das eine Transaktion bewertet, ein Prognosetool, das Nachfrage vorhersagt, läuft irgendwo auf einem dieser Chips. Sie kaufen vielleicht nie selbst einen. Aber Preis, Verfügbarkeit und Leistung von KI-Chips bestimmen, was Ihre KI-Tools kosten, wie schnell sie reagieren und welche Anbieter bestimmte Funktionen überhaupt anbieten können. Damit sind KI-Chips ein Geschäftsthema, nicht nur ein technisches.
Warum herkömmliche CPUs dafür nicht gebaut sind
Eine CPU (Central Processing Unit) ist darauf ausgelegt, eine Sache sehr gut zu erledigen: eine Folge komplexer Befehle so schnell wie möglich nacheinander auszuführen. Das ist ideal für den Betrieb eines Betriebssystems, einer Tabellenkalkulation oder eines Webservers, Aufgaben, die überwiegend sequenziell und verzweigungsintensiv sind.
KI-Workloads sehen völlig anders aus. Das Training eines neuronalen Netzes oder das Ausführen von Inferenz auf einem Large Language Model bedeutet, dieselbe einfache Operation, meist Matrixmultiplikation, gleichzeitig über Millionen oder Milliarden von Datenpunkten hinweg auszuführen. Eine CPU verfügt nur über eine Handvoll leistungsstarker Kerne und verarbeitet diese Workload deshalb in kleinen Häppchen, einen nach dem anderen. Ein KI-Chip hat Tausende einfacherer Kerne, die alle gleichzeitig dieselbe Operation auf unterschiedlichen Daten ausführen.
Dieser Unterschied heißt Parallelität, und er ist der ganze Grund, warum KI-Chips existieren. Eine moderne GPU kann weit über 10.000 Verarbeitungskerne haben, verglichen mit dem guten Dutzend einer High-End-CPU. Speziell für KI-Mathematik bedeutet das Trainingsläufe, die Tage statt Monate dauern, und Inferenz-Antworten, die in Millisekunden statt Sekunden eintreffen. Eine CPU kann technisch gesehen ein KI-Modell ausführen. Sie kann es nur nicht mit der Geschwindigkeit oder zu den Kosten tun, die KI im großen Maßstab kommerziell sinnvoll machen.
Die wichtigsten Arten von KI-Chips
Nicht alle KI-Chips sind gleich aufgebaut. Jeder Typ geht einen anderen Kompromiss zwischen roher Flexibilität und roher Geschwindigkeit ein.
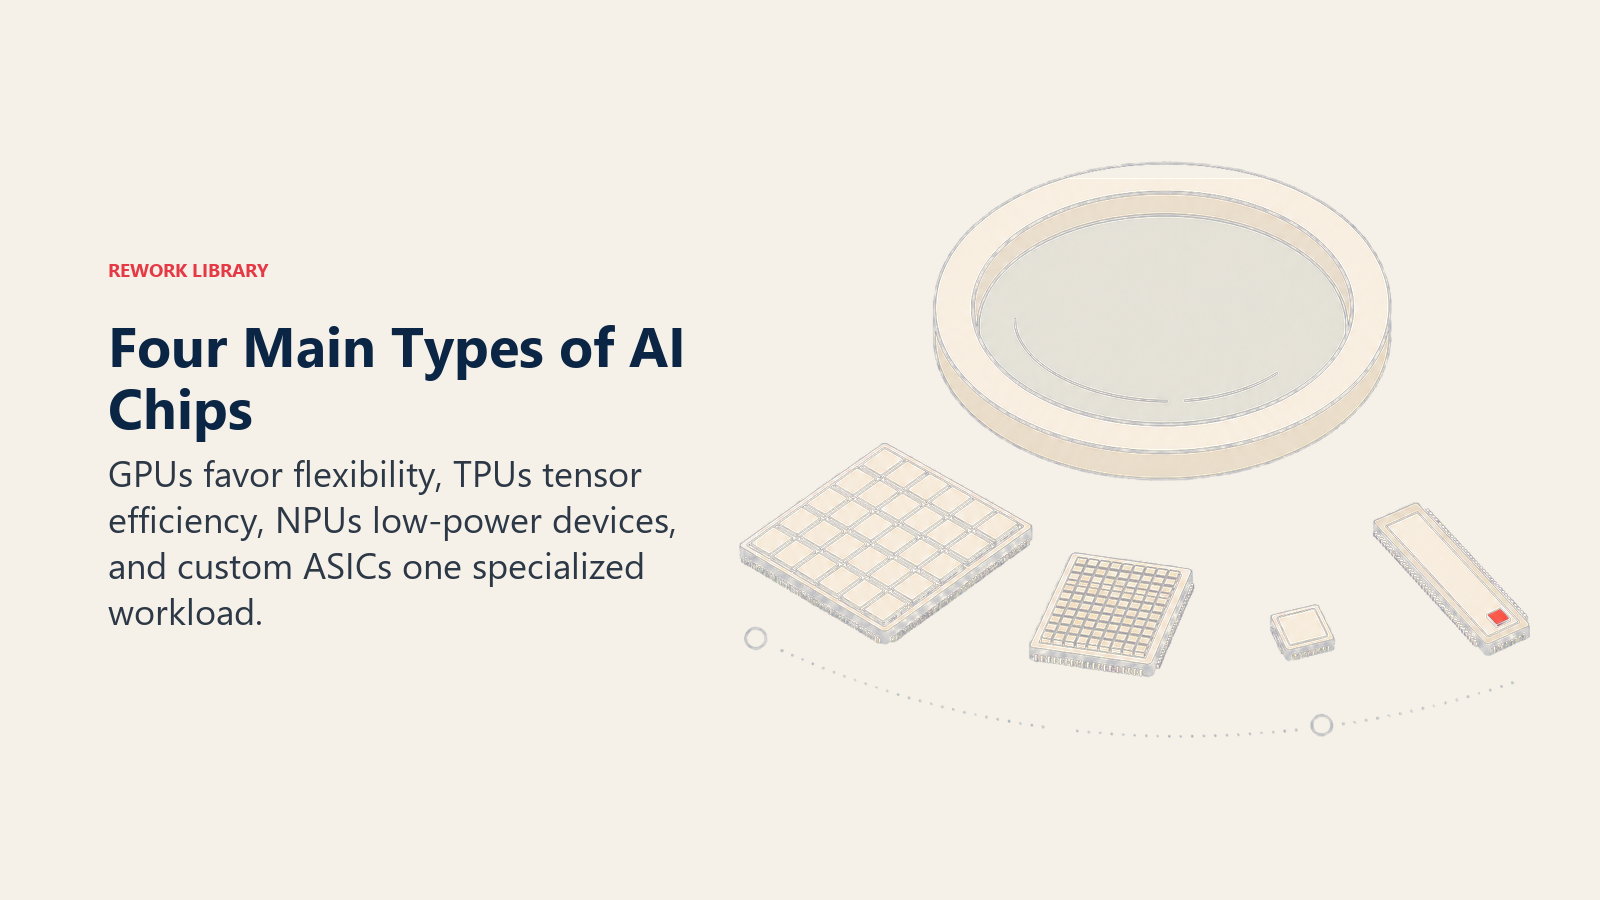
GPU (Graphics Processing Unit). Ursprünglich für die Darstellung von Videospielgrafiken gebaut, stellten sich GPUs als äußerst geeignet für die parallele Mathematik heraus, die KI benötigt. Sie sind heute der am weitesten verbreitete KI-Chip, weil sie flexibel genug sind, um fast jede KI-Workload zu bewältigen, von Computer Vision bis zu Sprachmodellen, und weil sie von einem ausgereiften Software-Ökosystem profitieren, das die meisten KI-Tools bereits unterstützen.
TPU (Tensor Processing Unit). Ein Chip, den Google speziell für die "Tensor"-Mathematik entworfen hat, die Deep Learning antreibt. TPUs sind weniger flexibel als GPUs, aber effizienter für die konkreten Workloads, für die sie gebaut sind. Google nutzt sie für die eigenen KI-Produkte und vermietet die Kapazität über Google Cloud.
NPU (Neural Processing Unit). Ein kleinerer, stromsparender Chip, der in Smartphones, Laptops und andere Endgeräte eingebaut wird, um KI-Aufgaben lokal statt in der Cloud auszuführen. NPUs tauschen rohe Leistung gegen Effizienz ein, weshalb sie in Edge-AI-Einsätzen wie geräteinternen Sprachassistenten, Kameraverarbeitung und Echtzeitübersetzung vorkommen.
Kundenspezifischer ASIC (Application-Specific Integrated Circuit). Ein Chip, der von Grund auf für eine eng umrissene Aufgabe entworfen wurde, in diesem Fall, um die spezifische KI-Workload eines Unternehmens so effizient wie möglich auszuführen. ASICs opfern Flexibilität vollständig zugunsten maximaler Leistung pro Dollar bei einer bekannten Aufgabe. Googles TPU ist technisch gesehen ein ASIC, ebenso wie die kundenspezifischen Chips, die Amazon, Microsoft und Meta jeweils für ihre eigenen Rechenzentren entwickelt haben.
| Chip-Typ | Gebaut für | Flexibilität | Typischer Einsatz | Beispielhersteller |
|---|---|---|---|---|
| GPU | Allzweck-Parallelmathematik | Hoch | Training und Ausführung der meisten KI-Modelle | Nvidia, AMD |
| TPU | Tensor-/Matrixmathematik für Deep Learning | Mittel | Googles eigene KI-Produkte, Google-Cloud-Vermietung | |
| NPU | Stromsparende, geräteinterne KI | Niedrig | Smartphones, Laptops, Kameras, Offline-KI | Apple, Qualcomm, Intel |
| Kundenspezifischer ASIC | Spezifische Workload eines einzelnen Unternehmens | Am niedrigsten | Rechenzentren der Hyperscaler, ein Zweck | Amazon, Microsoft, Meta, OpenAI |
Trainings-Chips vs. Inferenz-Chips
KI-Chips unterteilen sich auch entlang einer zweiten Linie: für welche Phase des KI-Lebenszyklus sie gebaut sind.
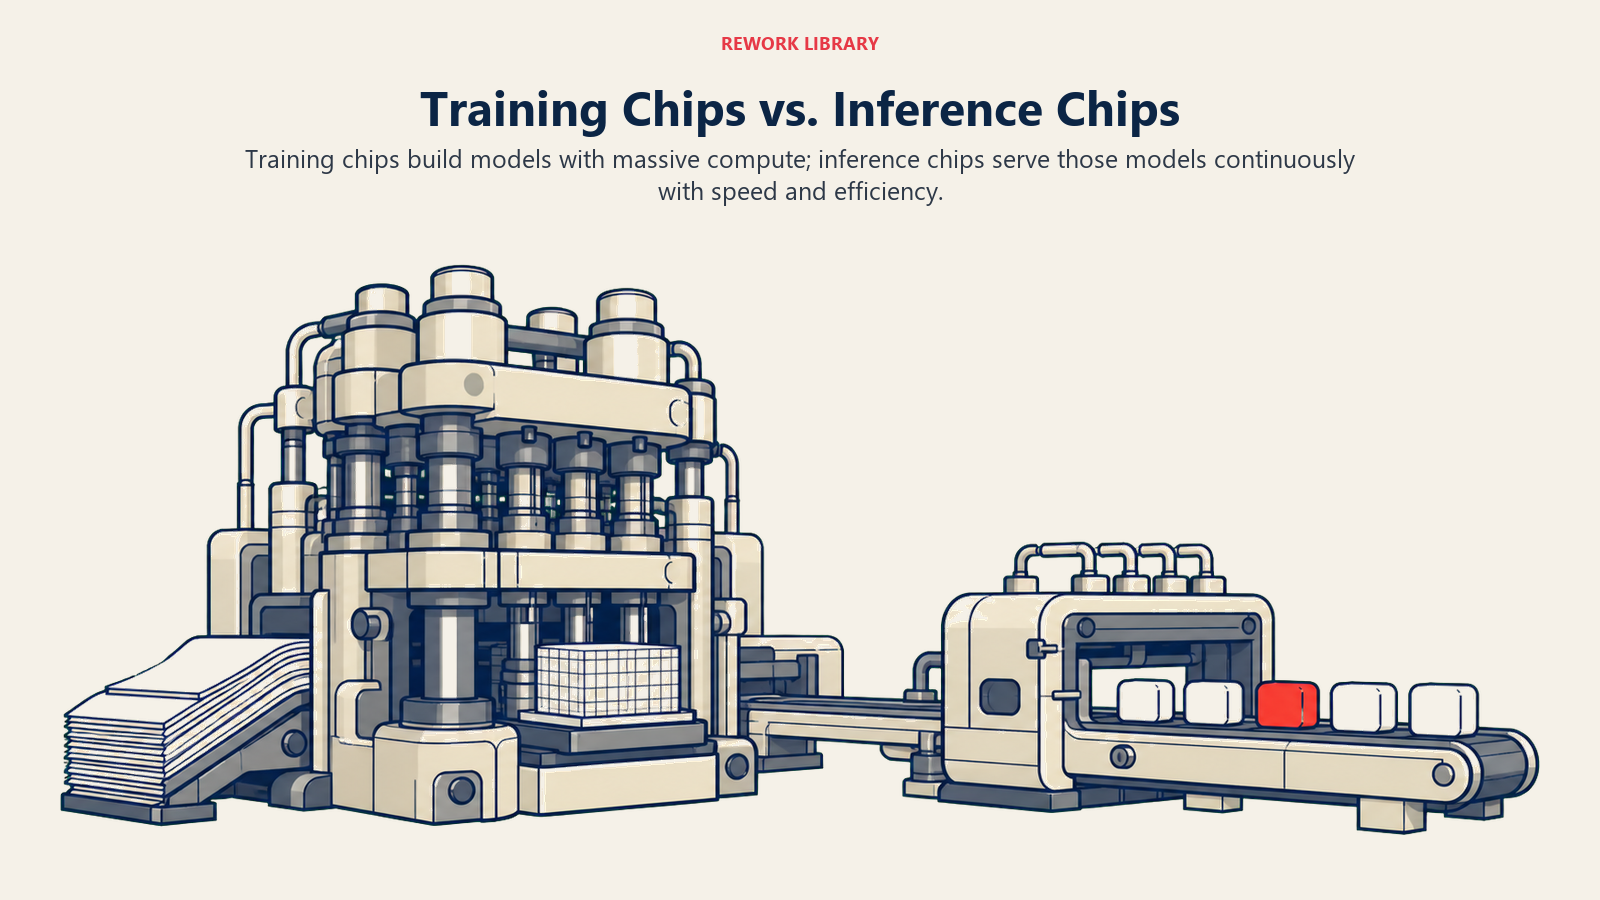
Trainings-Chips leisten die Schwerstarbeit, ein Modell zu unterrichten, wobei über Tage oder Wochen hinweg Milliarden von Parametern anhand riesiger Datensätze angepasst werden. Diese Arbeit ist extrem rechenintensiv und toleriert etwas Latenz, da sie ein einmaliges oder periodisches Projekt ist und keine live, nutzerorientierte Aufgabe. High-End-GPUs und TPUs dominieren hier, weil sie zu Tausenden zu Trainingsclustern vernetzt werden können.
Inferenz-Chips lassen das trainierte Modell auf neue, reale Eingaben los, der Schritt, in dem ein Chatbot tatsächlich eine Frage beantwortet oder ein Betrugsmodell tatsächlich eine Transaktion bewertet. Die vollständige Mechanik dazu finden Sie unter KI-Inferenz. Weil Inferenz kontinuierlich stattfindet und oft in Echtzeit reagieren muss, sind Inferenz-Chips häufig anders optimiert als Trainings-Chips: kleiner, günstiger, energieeffizienter, manchmal sogar eigens gebaute ASICs statt Allzweck-GPUs. Techniken zur Inferenzoptimierung wie Quantisierung und Modellkompression existieren speziell, um Modelle günstiger auf Inferenz-Hardware laufen zu lassen, ohne viel Genauigkeit zu opfern.
Eine nützliche Denkweise dazu: Trainings-Chips sind die Fabrik, die das Modell baut. Inferenz-Chips sind das Fließband, das es betreibt, jeden einzelnen Tag, solange das Produkt existiert. Die meisten Organisationen, die auf Foundation Models aufbauen, kommen nie direkt mit einem Trainings-Chip in Berührung. Fast jeder kommt mit Inferenzkosten in Berührung.
Wer KI-Chips herstellt: Die wichtigsten Akteure
Nvidia ist der dominierende GPU-Hersteller für KI-Training und Inferenz in Rechenzentren, und das Nächste, was die Branche einer Standardwahl hat. Das Rechenzentrumssegment, das fast ausschließlich vom Verkauf von KI-Chips getragen wird, erzielte Anfang 2026 in einem einzigen Rekordquartal 62,3 Milliarden US-Dollar, während der Jahresumsatz mit Rechenzentren für das Geschäftsjahr 2025 115,2 Milliarden US-Dollar erreichte, ein Plus von 142 Prozent gegenüber dem Vorjahr.
AMD ist Nvidias wichtigster GPU-Konkurrent und bietet eine alternative Architektur, die manche Hyperscaler und Cloud-Anbieter nutzen, um ihre Versorgung zu diversifizieren und über den Preis zu verhandeln.
Google baut eigene TPUs, statt sich für einen Großteil seiner internen KI-Workload auf handelsübliche GPUs zu verlassen, und vermietet diese Kapazität dann über Google Cloud.
Kundenspezifische Hyperscaler-Chips sind eine schnell wachsende Kategorie. Amazon, Microsoft, Meta und zunehmend auch OpenAI und Anthropic haben jeweils in eigens gebaute ASICs investiert, die für ihre eigene KI-Infrastruktur entworfen wurden, oft in Zusammenarbeit mit Chipdesign-Partnern wie Broadcom oder Marvell, statt selbst Fertigungskapazität aufzubauen.
Edge-NPU-Hersteller, darunter Apple, Qualcomm und Intel, bauen die stromsparenden Chips, die KI direkt in Smartphones, Laptops und Endgeräte bringen, eine zunehmend wichtige Kategorie, da immer mehr KI lokal statt in der Cloud läuft.
TSMC, die taiwanesische Foundry, fertigt physisch den überwiegenden Großteil dieser Chips für nahezu jedes oben genannte Unternehmen. Fast keines der Unternehmen, die KI-Chips entwerfen, fertigt sie auch tatsächlich; TSMCs fortschrittliche Fertigungs- und Packaging-Kapazität ist einer der engsten Engpässe der Branche.
Der KI-Chip-Markt 2026 und Exportkontrollen
Der KI-Chip-Markt ist zum Schwerpunkt der gesamten Halbleiterbranche geworden. Chips für generative KI sollen 2026 laut Deloittes Halbleiterbranchen-Ausblick 2026 auf fast 500 Milliarden US-Dollar Umsatz zusteuern, etwa die Hälfte der gesamten globalen Halbleiterbranche im Umfang von 975 Milliarden US-Dollar. Die CEO von AMD hat ihre eigene Schätzung für den adressierbaren Gesamtmarkt von KI-Beschleuniger-Chips für Rechenzentren auf 1 Billion US-Dollar bis 2030 angehoben.
Dieses Wachstum beginnt, nicht nur die Verkaufszahlen, sondern auch die Anbieterstruktur selbst neu zu ordnen. Kundenspezifische ASICs, einst eine Nischenalternative zu Nvidias GPUs, sollen laut TrendForces Server-Prognose vom Januar 2026 2026 auf 27,8 Prozent der KI-Server-Auslieferungen kommen, gegenüber 69,7 Prozent für GPU-basierte Systeme. Jeder große Hyperscaler hat inzwischen ein eigenes Chip-Programm laufen, eine direkte Reaktion auf GPU-Kosten und Lieferengpässe.
Exportkontrollen fügen eine weitere Komplexitätsebene hinzu. Die US-Regierung schränkt ein, welche KI-Chips nach China verkauft werden dürfen, eine Politik, die sich wiederholt verändert hat. Nvidias GPUs der Blackwell-Generation bleiben vom chinesischen Markt ausgeschlossen, während der H200-Chip, etwa sechsmal leistungsfähiger als der zuvor erlaubte H20, im Rahmen einer Regel des US-Handelsministeriums exportfähig wurde, die stufenweise bis Ende 2025 und Anfang 2026 in Kraft trat. Am 1. Juni 2026 stellte das Handelsministerium klar, dass die Lizenzpflicht auch für die Auslandstöchter chinesisch geführter Unternehmen gilt, nicht nur für Einheiten physisch innerhalb Chinas. Für jedes Unternehmen, das auf globale KI-Anbieter oder Lieferketten angewiesen ist, wirken sich diese Regeln direkt darauf aus, welche Chips, und damit welche KI-Funktionen, in welchen Märkten verfügbar sind.
Wichtige Fakten
- Nvidias Rechenzentrumssegment verzeichnete Anfang 2026 einen Rekordumsatz von 62,3 Milliarden US-Dollar in einem einzigen Quartal, ein Plus von 75 Prozent gegenüber dem Vorjahr, laut dem bei der SEC eingereichten Ergebnisbericht von NVIDIA.
- Für das gesamte Geschäftsjahr 2025 erreichte NVIDIAs Rechenzentrumsumsatz insgesamt 115,2 Milliarden US-Dollar, ein Plus von 142 Prozent gegenüber dem Vorjahr, laut den bei der SEC eingereichten Q4-Ergebnissen des Geschäftsjahres 2025.
- Chips für generative KI sollen 2026 laut Deloittes Halbleiterbranchen-Ausblick 2026 auf fast 500 Milliarden US-Dollar Umsatz zusteuern, nahe der Hälfte der globalen Halbleiterbranche im Umfang von 975 Milliarden US-Dollar.
- AMD-CEO Lisa Su hat ihre Prognose für den adressierbaren Gesamtmarkt von KI-Beschleuniger-Chips für Rechenzentren auf 1 Billion US-Dollar bis 2030 angehoben, wie in Deloittes Halbleiterbranchen-Ausblick 2026 zitiert.
- Kundenspezifische ASIC-Systeme sollen 2026 laut TrendForces Prognose für KI-Server-Auslieferungen vom Januar 2026 27,8 Prozent der KI-Server-Auslieferungen ausmachen, gegenüber 69,7 Prozent für GPU-basierte Systeme.
- Nvidias H200-Chip, etwa sechsmal leistungsfähiger als der zuvor erlaubte H20, wurde im Rahmen einer am 1. Juni 2026 klargestellten Regel des Handelsministeriums exportfähig nach China, während GPUs der Blackwell-Generation von diesem Markt ausgeschlossen bleiben, laut Berichterstattung von Al Jazeera über die Vorgaben des Handelsministeriums.
Warum KI-Chips für Führungskräfte wichtig sind
Die meisten Führungskräfte werden nie direkt einen Chip kaufen. Sie kaufen ein Cloud-KI-Abonnement, ein SaaS-Tool mit eingebauten KI-Funktionen oder eine API von einem Foundation-Model-Anbieter. Aber die Chip-Ebene taucht auf drei konkrete Arten trotzdem auf der Rechnung auf.
Kosten. Chip-Knappheit und Nachfrage bestimmen, was KI-Anbieter Ihnen berechnen. Wenn Trainings- und Inferenzkapazität knapp ist, steigen API-Preise und Cloud-KI-Kosten mit. Dieses Verständnis der Ebene hilft zu erklären, warum manche KI-Funktionen teuer sind und andere nicht, und ist ein wichtiger Input für jede Analyse der gesamten Betriebskosten von KI.
Verfügbarkeit. Exportkontrollen, Kapazitätsgrenzen bei Foundries und Chip-Engpässe bei Hyperscalern können bestimmen, welche KI-Anbieter tatsächlich in dem Umfang und mit der Zuverlässigkeit liefern können, den Sie brauchen, besonders für regulierte Branchen oder globale Geschäftstätigkeiten, die eingeschränkte Märkte umfassen.
Leistung und Latenz. Der Chip, auf dem ein Anbieter Inferenz ausführt, beeinflusst, wie schnell Ihre KI-Funktion reagiert. Ein langsamer, überlasteter GPU-Cluster hinter einem Chatbot erzeugt dieselbe frustrierende Verzögerung, die ein Kunde spürt, unabhängig davon, wie gut das zugrundeliegende Modell ist.
Sie müssen kein Halbleiterexperte werden, um KI-Initiativen gut zu führen. Aber wenn sich die Preise eines Anbieters ändern, ein Rollout ins Stocken gerät oder eine neue Funktion plötzlich verfügbar wird, ist die Chip-Ebene, und die Unternehmen, die diese Chips entwickeln, fertigen und exportieren, sehr oft der Grund dafür.
Verwandte KI-Konzepte
- KI-Inferenz - Die Produktionsphase, in der KI-Chips tatsächlich Geschäftswert erzeugen
- Edge-AI - KI lokal auf NPUs statt auf Cloud-GPUs ausführen
- Inferenzoptimierung - Techniken, die KI-Chips Modelle schneller und günstiger ausführen lassen
- Quantisierung - Ein Modell verkleinern, damit es effizient auf kleineren Chips läuft
- Modellkompression - Modellgröße reduzieren für günstigere, schnellere Chip-Leistung
- Large Language Models - Die Modelle, für deren Training und Betrieb KI-Chips am häufigsten gebaut werden
- Foundation Models - Die Basismodelle, auf die die meisten Unternehmen über chipgestützte APIs zugreifen
- Deep Learning - Die Techniken neuronaler Netze, die die Nachfrage nach spezialisierten KI-Chips geschaffen haben
- Neuronale Netze - Die zugrundeliegende Architektur, auf deren Berechnung KI-Chips optimiert sind
- MLOps - Die Verwaltung der Modell-Deployments, die auf KI-Chip-Infrastruktur laufen
Externe Ressourcen
- NVIDIA Investor Relations - Offizielle vierteljährliche Offenlegungen zu Rechenzentrums- und KI-Chip-Umsätzen
- TrendForce - Marktforschung und Prognosen zu Halbleitern und KI-Servern
- Deloitte Halbleiterbranchen-Ausblick 2026 - Jährliche Analyse der KI-Chip-Nachfrage und der Größe des Halbleitermarkts
Häufig gestellte Fragen zu KI-Chips
Was ist ein KI-Chip in einfachen Worten?
Ein KI-Chip ist ein Prozessor, der eigens dafür gebaut wurde, Workloads für künstliche Intelligenz effizient auszuführen. Statt wie eine CPU Befehle nacheinander auszuführen, führt er Tausende einfacher Berechnungen parallel aus, was tatsächlich benötigt wird, um KI-Modelle zu trainieren und laufen zu lassen.
Was ist der Unterschied zwischen einer GPU, TPU, NPU und einem ASIC?
Eine GPU ist ein flexibler, weit verbreiteter KI-Chip, der ursprünglich für Grafik gebaut wurde. Eine TPU ist Googles Chip, eigens für Deep-Learning-Mathematik gebaut. Eine NPU ist ein kleiner, stromsparender Chip, der in Smartphones und Laptops für geräteinterne KI eingebaut ist. Ein kundenspezifischer ASIC ist von Grund auf für die spezifische Workload eines Unternehmens entworfen und tauscht Flexibilität gegen maximale Effizienz. Alle vier sind KI-Chips, sie treffen nur unterschiedliche Kompromisse.
Warum kann ein gewöhnlicher Computerprozessor KI nicht so gut ausführen wie ein KI-Chip?
Eine CPU hat eine kleine Anzahl leistungsstarker Kerne, die für sequenzielle Aufgaben gebaut sind. KI-Workloads brauchen dieselbe einfache Mathematik gleichzeitig über Millionen von Datenpunkten wiederholt, wofür die Tausenden parallelen Kerne eines KI-Chips gebaut sind. Eine CPU kann KI-Modelle ausführen, nur weit langsamer und zu deutlich höheren Kosten pro Aufgabe.
Wer sind die größten KI-Chip-Hersteller?
Nvidia führt den GPU-Markt für KI-Training und Inferenz an. AMD ist der wichtigste GPU-Konkurrent. Google baut TPUs für die eigenen KI-Produkte und Google Cloud. Amazon, Microsoft, Meta und weitere Hyperscaler entwerfen zunehmend kundenspezifische ASICs für ihre eigenen Rechenzentren. TSMC fertigt die physischen Chips für nahezu alle diese Unternehmen.
Was ist der Unterschied zwischen Trainings-Chips und Inferenz-Chips?
Trainings-Chips leisten die intensive, einmalige Arbeit, ein Modell anhand riesiger Datensätze zu unterrichten, und tolerieren dafür höhere Latenz im Austausch für rohe Rechenleistung. Inferenz-Chips lassen das bereits trainierte Modell auf live, reale Eingaben los, meist optimiert auf Geschwindigkeit, Kosten und Energieeffizienz, da Inferenz kontinuierlich im Produktionsmaßstab stattfindet.
Warum sind Exportkontrollen für KI-Chips für Unternehmen wichtig?
Exportkontrollen bestimmen, welche KI-Chips in welche Länder verkauft werden dürfen, was beeinflusst, welche KI-Infrastruktur und Cloud-Kapazität in unterschiedlichen Märkten tatsächlich verfügbar ist. Für Unternehmen, die global tätig sind oder auf Anbieter mit internationalen Rechenzentren angewiesen sind, können diese Regeln die Verfügbarkeit von Diensten, die Preise und den Zugang zu bestimmten KI-Funktionen direkt beeinflussen.
Muss jedes Unternehmen KI-Chips verstehen, um KI zu nutzen?
Nein. Die meisten Unternehmen kommen mit KI-Chips nur indirekt in Berührung, über Cloud-Abonnements, SaaS-Tools oder API-basierte KI-Funktionen. Aber Chip-Kosten, -Verfügbarkeit und -Leistung bestimmen die Preisgestaltung der Anbieter, den Zeitpunkt von Funktions-Rollouts und die Reaktionsgeschwindigkeit, sodass ein grundlegendes Verständnis Führungskräften hilft, Entscheidungen von KI-Anbietern und Budgetänderungen einzuordnen.
Ist Nvidia das einzige Unternehmen, das KI-Chips herstellt?
Nein, auch wenn es der Marktführer bei GPUs für KI-Training und Inferenz in Rechenzentren ist. Google, AMD, Amazon, Microsoft, Meta, Apple und Qualcomm entwerfen alle eigene KI-Chips für unterschiedliche Zwecke, vom Training im Cloud-Maßstab bis zur geräteinternen Inferenz in Smartphones und Laptops.

Co-Founder, Rework.com
On this page
- Warum herkömmliche CPUs dafür nicht gebaut sind
- Die wichtigsten Arten von KI-Chips
- Trainings-Chips vs. Inferenz-Chips
- Wer KI-Chips herstellt: Die wichtigsten Akteure
- Der KI-Chip-Markt 2026 und Exportkontrollen
- Wichtige Fakten
- Warum KI-Chips für Führungskräfte wichtig sind
- Verwandte KI-Konzepte
- Externe Ressourcen