O que é um Chip de IA?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Atualizado em julho de 2026
Um chip de IA é um processador construído especificamente para executar workloads de inteligência artificial: treinar e executar neural networks. Diferente de uma CPU de uso geral, ele é otimizado para o cálculo matemático massivamente paralelo que a IA exige. GPUs, TPUs, NPUs e ASICs personalizados são todos chips de IA, cada um trocando flexibilidade por velocidade e eficiência de formas diferentes.
Toda funcionalidade de IA que sua empresa usa, seja um chatbot respondendo à pergunta de um cliente, um modelo de fraude avaliando uma transação ou uma ferramenta de previsão estimando a demanda, roda em algum desses chips. Você talvez nunca compre um diretamente. Mas o preço, a disponibilidade e o desempenho dos chips de IA moldam quanto suas ferramentas de IA custam, quão rápido elas respondem e quais fornecedores conseguem sequer oferecer certas funcionalidades. Isso torna os chips de IA um tema de negócios, não só de engenharia.
Por Que CPUs Comuns Não Foram Feitas Para Isso
Uma CPU (central processing unit, ou unidade central de processamento) é projetada para fazer muito bem uma única coisa: executar uma sequência de instruções complexas, uma após a outra, o mais rápido possível. Isso é ideal para rodar um sistema operacional, uma planilha ou um servidor web, tarefas que são majoritariamente sequenciais e cheias de desvios condicionais.
Workloads de IA não se parecem nada com isso. Treinar uma neural network ou executar inferência em um large language model significa realizar a mesma operação simples, principalmente multiplicação de matrizes, em milhões ou bilhões de pontos de dados ao mesmo tempo. Uma CPU tem apenas um punhado de núcleos poderosos, então processa esse workload em pequenos lotes, um após o outro. Um chip de IA tem milhares de núcleos mais simples que executam a mesma operação simultaneamente em pedaços diferentes de dados.
Essa diferença é chamada de paralelismo, e é o motivo pelo qual os chips de IA existem. Uma GPU moderna pode ter bem mais de 10.000 núcleos de processamento, contra a dúzia ou pouco mais de uma CPU de ponta. Especificamente para matemática de IA, isso se traduz em treinamentos que levam dias em vez de meses, e respostas de inferência que chegam em milissegundos em vez de segundos. Uma CPU consegue, tecnicamente, executar um modelo de IA. Só não consegue fazer isso na velocidade ou no custo que tornam a IA comercialmente viável em escala.
Os Principais Tipos de Chips de IA
Nem todos os chips de IA são construídos da mesma forma. Cada tipo faz uma troca diferente entre flexibilidade bruta e velocidade bruta.
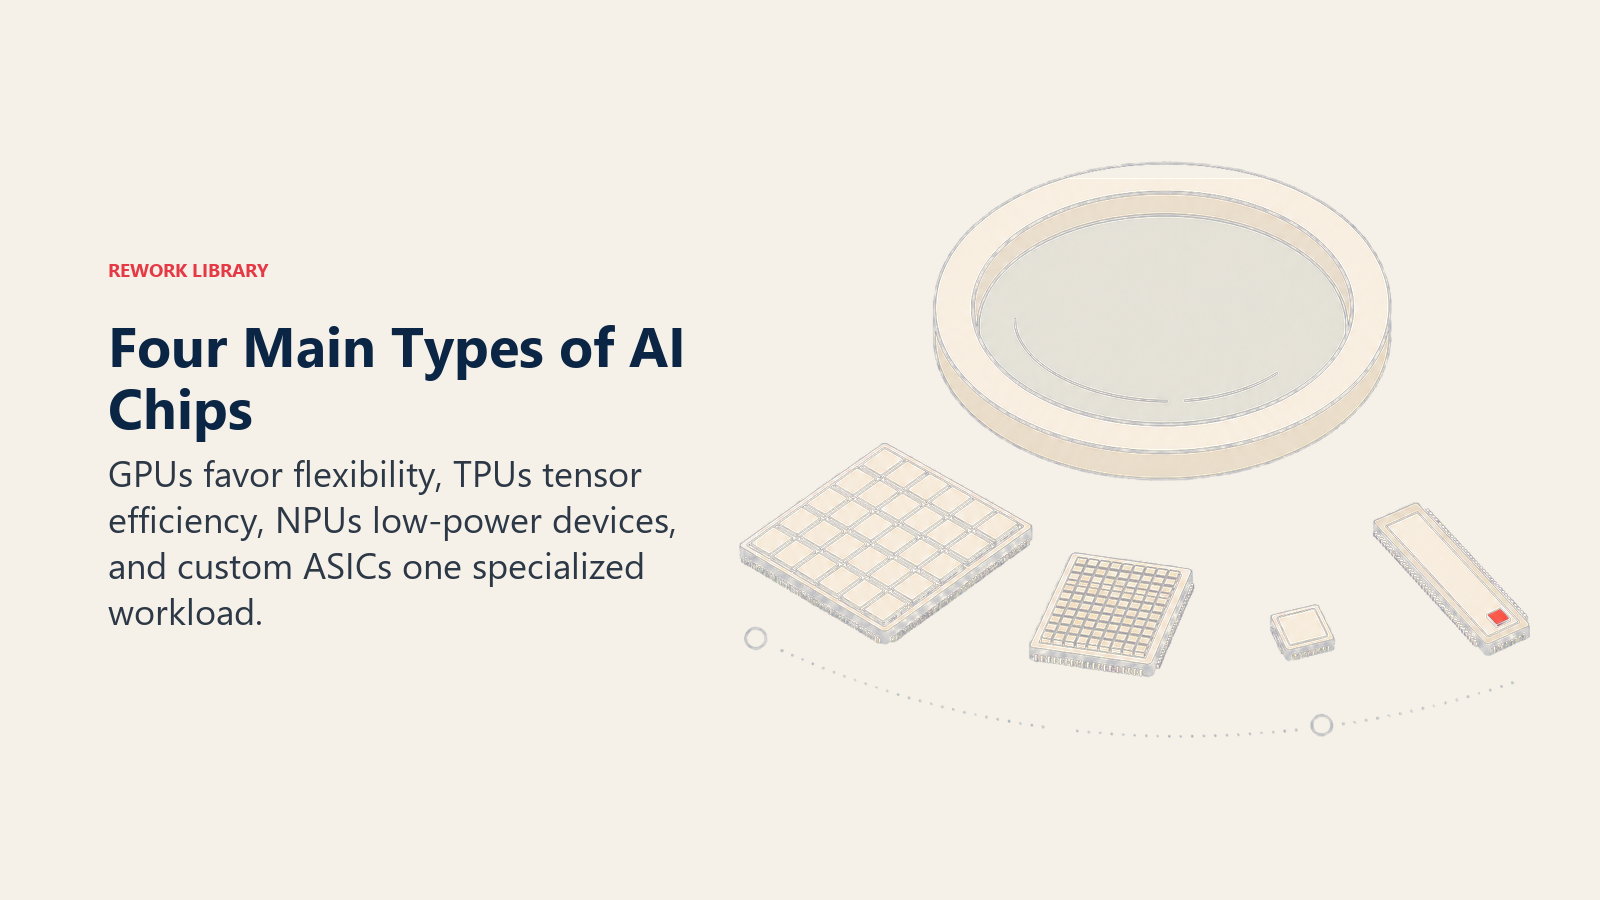
GPU (Graphics Processing Unit). Originalmente criada para renderizar gráficos de videogame, a GPU acabou se mostrando extremamente boa na matemática paralela que a IA precisa. É o chip de IA mais usado hoje porque é flexível o suficiente para lidar com quase qualquer workload de IA, de computer vision a modelos de linguagem, e se beneficia de um ecossistema de software maduro que a maioria das ferramentas de IA já suporta.
TPU (Tensor Processing Unit). Um chip que o Google projetou especificamente para a matemática de "tensores" que sustenta o deep learning. As TPUs são menos flexíveis que as GPUs, mas mais eficientes para os workloads específicos para os quais foram criadas. O Google as usa para rodar seus próprios produtos de IA e as aluga através do Google Cloud.
NPU (Neural Processing Unit). Um chip menor e de baixo consumo, embutido em celulares, laptops e outros dispositivos de consumo para executar tarefas de IA localmente, em vez de enviar dados para a nuvem. As NPUs trocam poder bruto por eficiência, o que explica por que aparecem em implantações de edge AI como assistentes de voz no próprio dispositivo, processamento de câmera e tradução em tempo real.
ASIC personalizado (Application-Specific Integrated Circuit). Um chip projetado do zero para uma única tarefa restrita, nesse caso, executar o workload de IA específico de uma empresa da forma mais eficiente possível. Os ASICs sacrificam toda a flexibilidade em troca do máximo desempenho por dólar em uma tarefa conhecida. A TPU do Google é, tecnicamente, um ASIC; assim como os chips personalizados que Amazon, Microsoft e Meta construíram, cada uma, para seus próprios data centers.
| Tipo de chip | Feito para | Flexibilidade | Uso típico | Fabricante exemplo |
|---|---|---|---|---|
| GPU | Matemática paralela de uso geral | Alta | Treinar e executar a maioria dos modelos de IA | Nvidia, AMD |
| TPU | Matemática de tensores/matrizes para deep learning | Média | Produtos de IA do próprio Google, aluguel via Google Cloud | |
| NPU | IA de baixo consumo, no próprio dispositivo | Baixa | Celulares, laptops, câmeras, IA offline | Apple, Qualcomm, Intel |
| ASIC personalizado | Workload específico de uma empresa | Mínima | Data centers de hyperscalers, propósito único | Amazon, Microsoft, Meta, OpenAI |
Chips de Treinamento vs. Chips de Inferência
Os chips de IA também se dividem em uma segunda linha: para qual etapa do ciclo de vida da IA foram construídos.
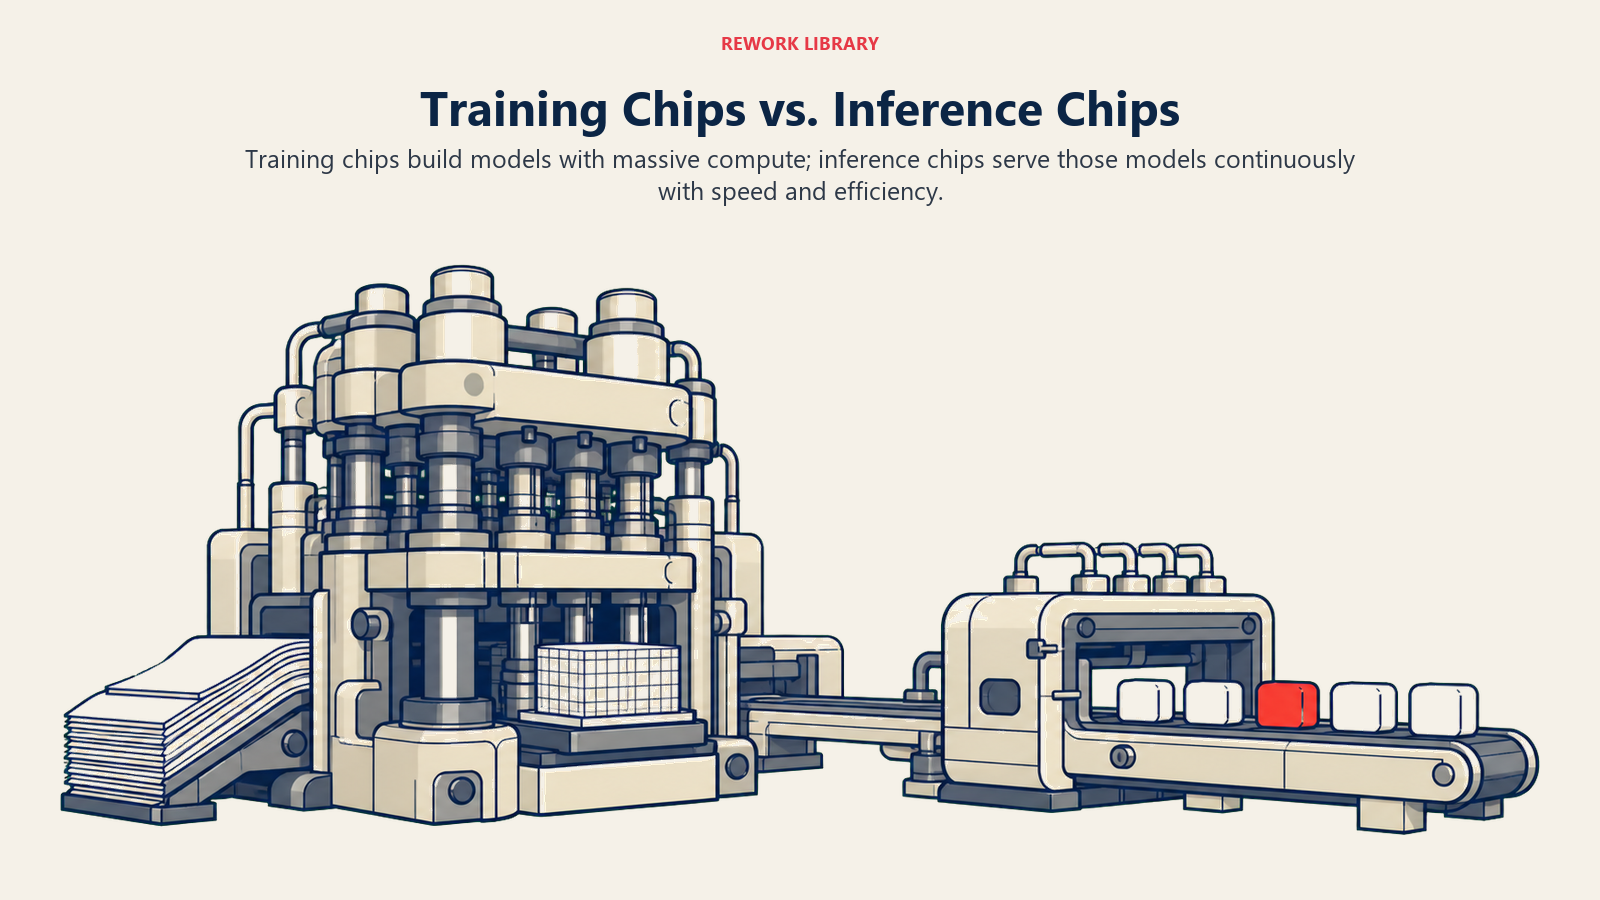
Os chips de treinamento fazem o trabalho pesado de ensinar um modelo, ajustando bilhões de parâmetros em enormes conjuntos de dados ao longo de dias ou semanas. Esse trabalho é extremamente intensivo em computação e tolera alguma latência, já que é um projeto pontual ou periódico, não uma tarefa ao vivo voltada ao usuário. GPUs e TPUs de ponta dominam aqui porque podem ser conectadas em rede, aos milhares, em clusters de treinamento.
Os chips de inferência executam o modelo já treinado contra entradas novas e reais, a etapa em que um chatbot de fato responde a uma pergunta ou um modelo de fraude de fato avalia uma transação. Veja AI inference para entender toda a mecânica. Como a inferência acontece continuamente e muitas vezes precisa responder em tempo real, os chips de inferência costumam ser otimizados de forma diferente dos chips de treinamento: menores, mais baratos, mais eficientes em energia, às vezes até ASICs projetados especificamente em vez de GPUs de uso geral. Técnicas de Inference Optimization, como Quantization e Model Compression, existem justamente para tornar os modelos mais baratos de rodar em hardware de inferência sem sacrificar muita precisão.
Uma forma útil de pensar nisso: os chips de treinamento são a fábrica que constrói o modelo. Os chips de inferência são a linha de montagem que o executa, todos os dias, enquanto o produto existir. A maioria das organizações que constroem sobre Foundation Models nunca chega a tocar em um chip de treinamento diretamente. Quase todo mundo, porém, sente o custo de inferência.
Quem Fabrica Chips de IA: Os Principais Players
A Nvidia é a fabricante dominante de GPUs para treinamento de IA e inferência em data center, e o mais próximo que a indústria tem de uma escolha padrão. Sua divisão de data center, impulsionada quase inteiramente pelas vendas de chips de IA, gerou $62,3 bilhões em um único trimestre recorde no início de 2026, com a receita anual de data center do ano fiscal de 2025 chegando a $115,2 bilhões, alta de 142% em relação ao ano anterior.
A AMD é a principal concorrente da Nvidia em GPUs, oferecendo uma arquitetura alternativa que alguns hyperscalers e provedores de nuvem usam para diversificar o fornecimento e negociar preço.
O Google constrói suas próprias TPUs em vez de depender de GPUs de mercado para boa parte do seu workload interno de IA, e depois aluga essa capacidade através do Google Cloud.
Silício personalizado de hyperscalers é uma categoria em rápido crescimento. Amazon, Microsoft, Meta e, cada vez mais, OpenAI e Anthropic investiram cada uma em ASICs sob medida, projetados para sua própria infraestrutura de IA, frequentemente trabalhando com parceiros de design de chips como Broadcom ou Marvell em vez de construir capacidade própria de fabricação.
Fabricantes de NPU de edge, incluindo Apple, Qualcomm e Intel, constroem os chips de baixo consumo que colocam IA diretamente em celulares, laptops e dispositivos de consumo, uma categoria cada vez mais importante à medida que mais IA passa a rodar localmente em vez de na nuvem.
A TSMC, a fundição taiwanesa, fabrica fisicamente a grande maioria desses chips para praticamente todas as empresas listadas acima. Quase nenhuma das empresas que projetam chips de IA de fato as fabrica; a capacidade avançada de manufatura e empacotamento da TSMC é um dos gargalos mais apertados da indústria.
O Mercado de Chips de IA em 2026 e os Controles de Exportação
O mercado de chips de IA se tornou o centro de gravidade de toda a indústria de semicondutores. Espera-se que os chips de IA generativa se aproximem de $500 bilhões em receita em 2026, cerca de metade dos $975 bilhões da indústria global de semicondutores, segundo a Deloitte's 2026 Semiconductor Industry Outlook. A CEO da AMD elevou sua própria estimativa para o mercado endereçável total de chips aceleradores de IA para data centers a $1 trilhão até 2030.
Esse crescimento está começando a remodelar quem fornece os chips, não só quantos são vendidos. Os ASICs personalizados, antes uma alternativa de nicho às GPUs da Nvidia, devem responder por 27,8% das remessas de servidores de IA em 2026, contra 69,7% para sistemas baseados em GPU, segundo a previsão de servidores de janeiro de 2026 da TrendForce. Todo grande hyperscaler já tem seu próprio programa de chips em andamento, uma resposta direta às restrições de custo e fornecimento de GPU.
Os controles de exportação acrescentam outra camada de complexidade. O governo dos Estados Unidos restringe quais chips de IA podem ser vendidos para a China, uma política que mudou repetidamente. As GPUs da geração Blackwell da Nvidia continuam banidas do mercado chinês, enquanto seu chip H200, cerca de seis vezes mais potente que o H20 antes permitido, se tornou elegível para exportação sob uma regra do Departamento de Comércio que entrou em vigor por etapas ao longo do fim de 2025 e início de 2026. Em 1º de junho de 2026, o Comércio esclareceu que a exigência de licenciamento também se aplica às subsidiárias no exterior de empresas sediadas na China, e não apenas a entidades fisicamente dentro do país. Para qualquer empresa que dependa de fornecedores globais de IA ou de cadeias de suprimento internacionais, essas regras afetam diretamente quais chips, e portanto quais capacidades de IA, estão disponíveis em quais mercados.
Dados Importantes
- A divisão de data center da Nvidia registrou receita recorde de $62,3 bilhões em um único trimestre no início de 2026, alta de 75% em relação ao ano anterior, segundo o relatório de resultados da NVIDIA arquivado na SEC.
- No ano fiscal completo de 2025, a receita de data center da NVIDIA totalizou $115,2 bilhões, alta de 142% em relação ao ano anterior, de acordo com os resultados do quarto trimestre do ano fiscal de 2025 arquivados na SEC.
- Espera-se que os chips de IA generativa se aproximem de $500 bilhões em receita em 2026, perto de metade dos $975 bilhões da indústria global de semicondutores, segundo a Deloitte's 2026 Semiconductor Industry Outlook.
- A CEO da AMD, Lisa Su, elevou sua projeção para o mercado endereçável total de chips aceleradores de IA para data centers a $1 trilhão até 2030, conforme citado na Deloitte's 2026 Semiconductor Industry Outlook.
- Os sistemas ASIC personalizados devem representar 27,8% das remessas de servidores de IA em 2026, contra 69,7% para sistemas baseados em GPU, de acordo com a previsão de remessas de servidores de IA de janeiro de 2026 da TrendForce.
- O chip H200 da Nvidia, cerca de seis vezes mais potente que o H20 antes permitido, se tornou elegível para exportação para a China sob uma regra do Departamento de Comércio esclarecida em 1º de junho de 2026, enquanto as GPUs da geração Blackwell continuam banidas desse mercado, segundo a cobertura da Al Jazeera sobre a orientação do Departamento de Comércio.
Por Que os Chips de IA Importam para Líderes Empresariais
A maioria dos executivos nunca vai comprar um chip diretamente. Eles vão comprar uma assinatura de IA em nuvem, uma ferramenta SaaS com funcionalidades de IA embutidas, ou uma API de um provedor de foundation model. Mas a camada de chips ainda aparece na conta de três formas concretas.
Custo. A escassez e a demanda de chips determinam quanto os fornecedores de IA cobram de você. Quando a capacidade de treinamento e inferência está apertada, o preço de API e os custos de IA em nuvem sobem junto. Entender essa camada ajuda a explicar por que algumas funcionalidades de IA são caras e outras não, e é um insumo essencial para qualquer análise de AI total cost of ownership.
Disponibilidade. Controles de exportação, limites de capacidade de fundições e escassez de chips entre hyperscalers podem determinar quais fornecedores de IA conseguem realmente entregar na escala e confiabilidade que você precisa, especialmente para setores regulados ou operações globais que abrangem mercados restritos.
Desempenho e latência. O chip em que um fornecedor roda a inferência afeta a velocidade de resposta da sua funcionalidade de IA. Um cluster de GPU lento e sobrecarregado por trás de um chatbot produz a mesma latência frustrante para o cliente, não importa quão bom seja o modelo por trás dele.
Você não precisa virar especialista em semicondutores para conduzir bem as iniciativas de IA. Mas quando o preço de um fornecedor muda, um lançamento atrasa ou uma nova funcionalidade de repente fica disponível, a camada de chips, e as empresas que projetam, fabricam e exportam esses chips, é, com muita frequência, o motivo.
Conceitos Relacionados de IA
- AI Inference - A fase de produção em que os chips de IA de fato geram valor de negócio
- Edge AI - Executar IA localmente em NPUs em vez de GPUs na nuvem
- Inference Optimization - Técnicas que fazem os chips de IA rodar modelos mais rápido e mais barato
- Quantization - Reduzir um modelo para que rode com eficiência em chips menores
- Model Compression - Reduzir o tamanho do modelo para desempenho de chip mais barato e rápido
- Large Language Models - Os modelos que os chips de IA mais frequentemente treinam e executam
- Foundation Models - Os modelos base que a maioria das empresas acessa via APIs movidas a chips
- Deep Learning - As técnicas de neural networks que criaram a demanda por chips de IA especializados
- Neural Networks - A arquitetura subjacente que os chips de IA são otimizados para calcular
- MLOps - Gerenciar as implantações de modelo que rodam sobre a infraestrutura de chips de IA
Recursos Externos
- NVIDIA Investor Relations - Divulgações trimestrais oficiais de receita de data center e chips de IA
- TrendForce - Pesquisas e previsões de mercado de semicondutores e servidores de IA
- Deloitte 2026 Semiconductor Industry Outlook - Análise anual da demanda por chips de IA e do dimensionamento do mercado de semicondutores
Perguntas Frequentes sobre Chips de IA
O que é um chip de IA em termos simples?
Um chip de IA é um processador construído especificamente para executar workloads de inteligência artificial com eficiência. Em vez de executar instruções uma de cada vez, como uma CPU, ele realiza milhares de cálculos simples em paralelo, que é exatamente o que treinar e executar modelos de IA exige.
Qual é a diferença entre uma GPU, uma TPU, uma NPU e um ASIC?
Uma GPU é um chip de IA flexível e amplamente usado, originalmente criado para gráficos. Uma TPU é o chip do Google, feito sob medida para a matemática de deep learning. Uma NPU é um chip pequeno e de baixo consumo, embutido em celulares e laptops para IA no próprio dispositivo. Um ASIC personalizado é projetado do zero para o workload específico de uma empresa, trocando flexibilidade por eficiência máxima. Os quatro são chips de IA; eles só fazem trocas diferentes.
Por que um processador comum não consegue rodar IA tão bem quanto um chip de IA?
Uma CPU tem um pequeno número de núcleos poderosos, feitos para tarefas sequenciais. Workloads de IA precisam da mesma matemática simples repetida em milhões de pontos de dados simultaneamente, que é exatamente para o que servem os milhares de núcleos paralelos de um chip de IA. Uma CPU consegue rodar modelos de IA, só que muito mais devagar e a um custo por tarefa muito mais alto.
Quem são os maiores fabricantes de chips de IA?
A Nvidia lidera o mercado de GPUs para treinamento e inferência de IA. A AMD é sua principal concorrente em GPUs. O Google constrói TPUs para seus próprios produtos de IA e para o Google Cloud. Amazon, Microsoft, Meta e outros hyperscalers projetam cada vez mais ASICs personalizados para seus próprios data centers. A TSMC fabrica fisicamente os chips para quase todas essas empresas.
Qual é a diferença entre chips de treinamento e chips de inferência?
Os chips de treinamento fazem o trabalho intensivo e pontual de ensinar um modelo em conjuntos de dados massivos, tolerando latência mais alta em troca de poder de computação bruto. Os chips de inferência executam o modelo já treinado contra entradas reais e ao vivo, geralmente otimizados para velocidade, custo e eficiência energética, já que a inferência acontece continuamente em escala de produção.
Por que os controles de exportação de chips de IA importam para as empresas?
Os controles de exportação determinam quais chips de IA podem ser vendidos para quais países, o que afeta qual infraestrutura de IA e capacidade de nuvem está de fato disponível em diferentes mercados. Para empresas que operam globalmente ou dependem de fornecedores com data centers internacionais, essas regras podem afetar diretamente a disponibilidade de serviços, o preço e quais capacidades de IA são acessíveis onde.
Toda empresa precisa entender chips de IA para usar IA?
Não. A maioria das empresas interage com chips de IA indiretamente, através de assinaturas em nuvem, ferramentas SaaS ou funcionalidades de IA baseadas em API. Mas o custo, a disponibilidade e o desempenho dos chips determinam o preço dos fornecedores, o cronograma de lançamento de funcionalidades e a velocidade de resposta, então um entendimento básico ajuda os líderes a interpretar decisões de fornecedores de IA e mudanças de orçamento.
A Nvidia é a única empresa que fabrica chips de IA?
Não, embora seja a líder de mercado em GPUs usadas para treinamento de IA e inferência em data center. Google, AMD, Amazon, Microsoft, Meta, Apple e Qualcomm projetam seus próprios chips de IA para propósitos diferentes, do treinamento em escala de nuvem à inferência no próprio dispositivo em celulares e laptops.

Co-Founder, Rework.com
On this page
- Por Que CPUs Comuns Não Foram Feitas Para Isso
- Os Principais Tipos de Chips de IA
- Chips de Treinamento vs. Chips de Inferência
- Quem Fabrica Chips de IA: Os Principais Players
- O Mercado de Chips de IA em 2026 e os Controles de Exportação
- Dados Importantes
- Por Que os Chips de IA Importam para Líderes Empresariais
- Conceitos Relacionados de IA
- Recursos Externos