¿Qué es un Chip de IA?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Actualizado en julio de 2026
Un chip de IA es un procesador diseñado específicamente para ejecutar cargas de trabajo de inteligencia artificial: entrenar y ejecutar redes neuronales. A diferencia de una CPU de uso general, está optimizado para las operaciones matemáticas masivamente paralelas que requiere la IA. Las GPU, las TPU, las NPU y los ASIC personalizados son todos chips de IA, y cada uno intercambia flexibilidad por velocidad y eficiencia de formas distintas.
Toda función de IA que su empresa utiliza, un chatbot que responde la pregunta de un cliente, un modelo antifraude que evalúa una transacción, una herramienta de pronóstico que predice la demanda, se ejecuta en algún lugar sobre uno de estos chips. Es posible que usted nunca compre uno directamente. Pero el precio, la disponibilidad y el rendimiento de los chips de IA determinan cuánto cuestan sus herramientas de IA, qué tan rápido responden y qué proveedores pueden siquiera ofrecer ciertas capacidades. Eso convierte a los chips de IA en un tema empresarial, no solo de ingeniería.
Por Qué las CPU Convencionales No Están Diseñadas para Esto
Una CPU (unidad central de procesamiento) está diseñada para hacer muy bien una sola cosa: ejecutar una secuencia de instrucciones complejas, una tras otra, lo más rápido posible. Eso es ideal para ejecutar un sistema operativo, una hoja de cálculo o un servidor web, tareas que son en su mayoría secuenciales y con muchas ramificaciones.
Las cargas de trabajo de IA no se parecen en nada a eso. Entrenar una red neuronal o ejecutar inferencia en un modelo de lenguaje grande significa realizar la misma operación simple, en su mayoría multiplicación de matrices, en millones o miles de millones de puntos de datos a la vez. Una CPU solo tiene un puñado de núcleos potentes, por lo que procesa esa carga de trabajo en lotes pequeños, uno tras otro. Un chip de IA tiene miles de núcleos más simples que ejecutan todos la misma operación sobre distintos fragmentos de datos de forma simultánea.
Esa diferencia se llama paralelismo, y es la razón por la que existen los chips de IA. Una GPU moderna puede tener más de 10,000 núcleos de procesamiento, frente a la docena o así de una CPU de gama alta. Para las matemáticas de IA específicamente, eso se traduce en ejecuciones de entrenamiento que toman días en lugar de meses, y respuestas de inferencia que llegan en milisegundos en lugar de segundos. Una CPU puede técnicamente ejecutar un modelo de IA. Simplemente no puede hacerlo a la velocidad ni al costo que hacen que la IA sea comercialmente útil a escala.
Los Principales Tipos de Chips de IA
No todos los chips de IA están construidos de la misma manera. Cada tipo hace una compensación distinta entre flexibilidad pura y velocidad pura.
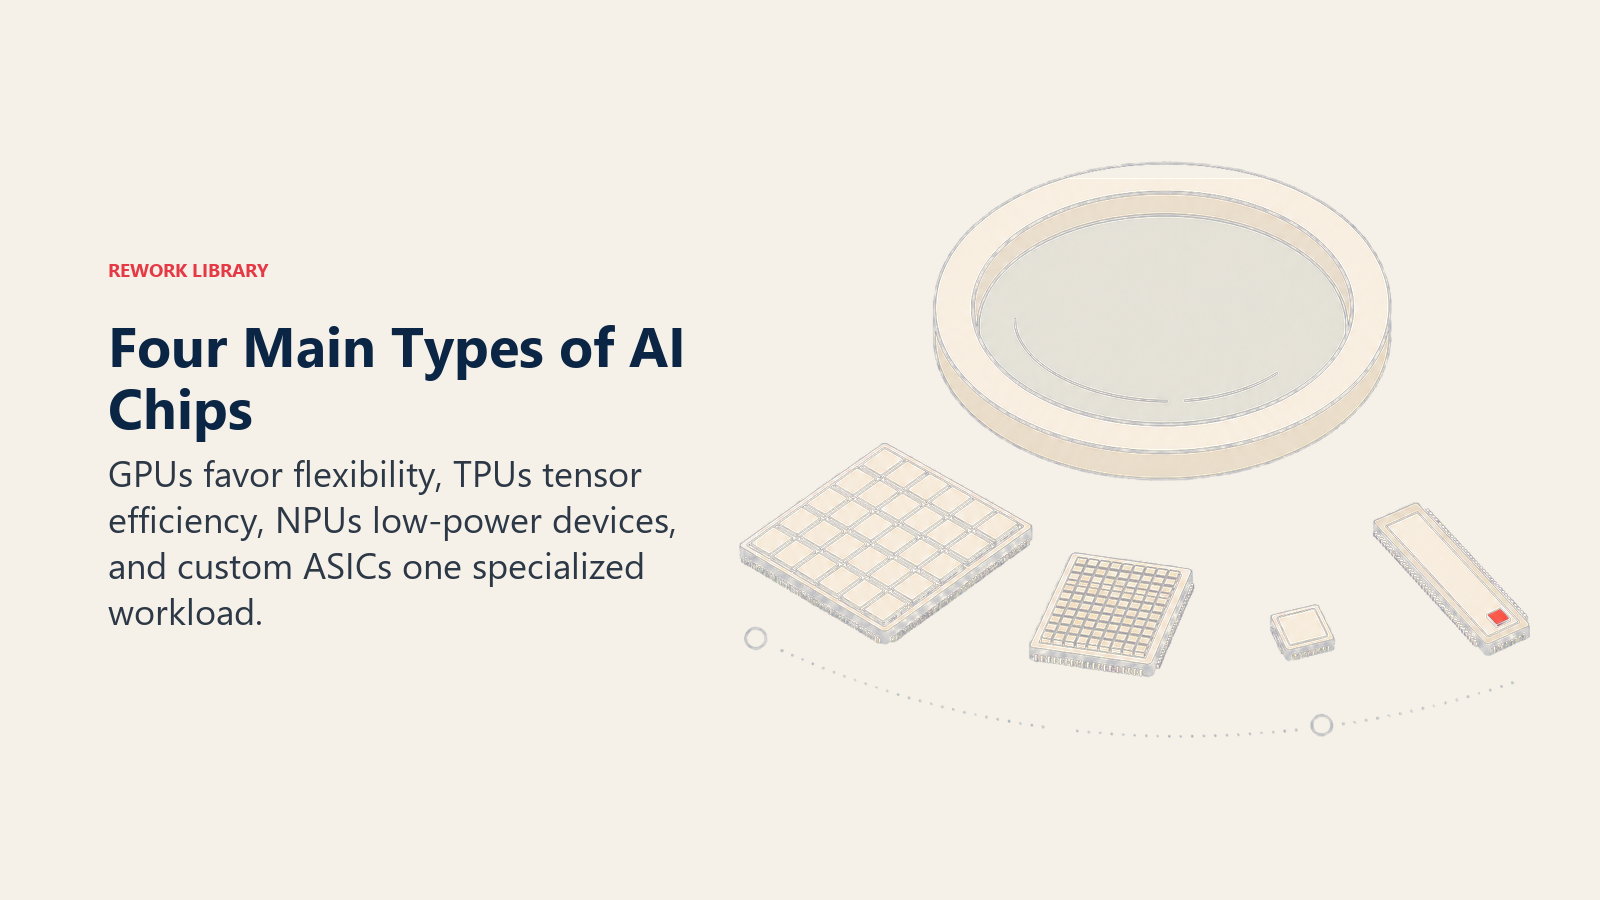
GPU (Unidad de Procesamiento Gráfico). Originalmente construidas para renderizar gráficos de videojuegos, las GPU resultaron ser extremadamente buenas en las matemáticas paralelas que necesita la IA. Son el chip de IA más usado hoy en día porque son lo bastante flexibles para manejar casi cualquier carga de trabajo de IA, desde visión por computadora hasta modelos de lenguaje, y se benefician de un ecosistema de software maduro que ya es compatible con la mayoría de las herramientas de IA.
TPU (Unidad de Procesamiento Tensorial). Un chip que Google diseñó específicamente para las matemáticas de "tensores" que impulsan el deep learning. Las TPU son menos flexibles que las GPU, pero más eficientes para las cargas de trabajo específicas para las que fueron construidas. Google las usa para ejecutar sus propios productos de IA y las alquila a través de Google Cloud.
NPU (Unidad de Procesamiento Neuronal). Un chip más pequeño y de bajo consumo, integrado en teléfonos, laptops y otros dispositivos de consumo para ejecutar tareas de IA de forma local en lugar de enviar datos a la nube. Las NPU sacrifican potencia bruta a cambio de eficiencia, razón por la cual aparecen en despliegues de Edge AI como asistentes de voz en el dispositivo, procesamiento de cámara y traducción en tiempo real.
ASIC personalizado (Circuito Integrado de Aplicación Específica). Un chip diseñado desde cero para una tarea muy concreta, en este caso, ejecutar la carga de trabajo de IA específica de una empresa con la máxima eficiencia posible. Los ASIC sacrifican por completo la flexibilidad a cambio del máximo rendimiento por dólar en una tarea conocida. La TPU de Google es técnicamente un ASIC; también lo son los chips personalizados que Amazon, Microsoft y Meta han construido cada uno para sus propios centros de datos.
| Tipo de chip | Diseñado para | Flexibilidad | Uso típico | Fabricante ejemplo |
|---|---|---|---|---|
| GPU | Matemáticas paralelas de uso general | Alta | Entrenar y ejecutar la mayoría de los modelos de IA | Nvidia, AMD |
| TPU | Matemáticas de tensores/matrices para deep learning | Media | Productos de IA propios de Google, alquiler en Google Cloud | |
| NPU | IA de bajo consumo en el dispositivo | Baja | Teléfonos, laptops, cámaras, IA sin conexión | Apple, Qualcomm, Intel |
| ASIC personalizado | Carga de trabajo específica de una empresa | Mínima | Centros de datos de hyperscalers, un solo propósito | Amazon, Microsoft, Meta, OpenAI |
Chips de Entrenamiento vs. Chips de Inferencia
Los chips de IA también se dividen según una segunda línea: para qué etapa del ciclo de vida de la IA fueron construidos.
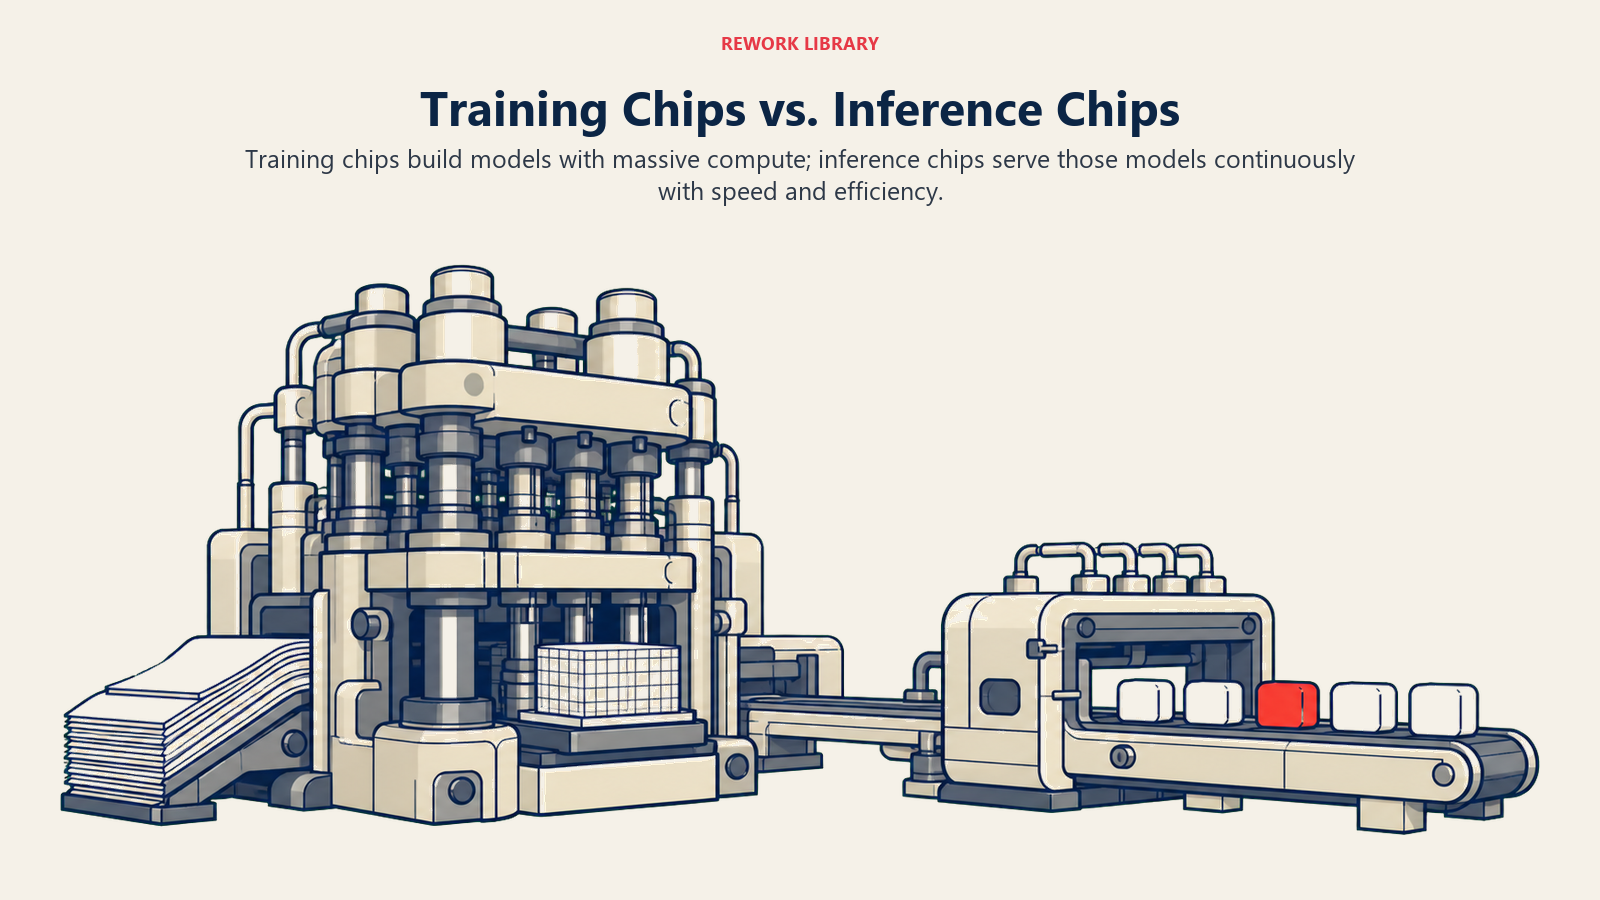
Los chips de entrenamiento hacen el trabajo pesado de enseñar a un modelo, ajustando miles de millones de parámetros en grandes conjuntos de datos durante días o semanas. Este trabajo es extremadamente intensivo en cómputo y tolera algo de latencia, ya que es un proyecto único o periódico y no una tarea en vivo de cara al usuario. Las GPU y TPU de gama alta dominan aquí porque pueden conectarse en red por miles en clústeres de entrenamiento.
Los chips de inferencia ejecutan el modelo ya entrenado contra entradas nuevas del mundo real, el paso en el que un chatbot realmente responde una pregunta o un modelo antifraude realmente evalúa una transacción. Consulte inferencia de IA para conocer toda la mecánica. Debido a que la inferencia ocurre de forma continua y a menudo necesita responder en tiempo real, los chips de inferencia suelen optimizarse de forma distinta a los chips de entrenamiento: más pequeños, más económicos, más eficientes en consumo de energía, a veces incluso ASIC diseñados a propósito en lugar de GPU de uso general. Técnicas de optimización de inferencia como la cuantización y la compresión de modelos existen específicamente para hacer que los modelos sean más económicos de ejecutar en hardware de inferencia sin sacrificar mucha precisión.
Una forma útil de pensarlo: los chips de entrenamiento son la fábrica que construye el modelo. Los chips de inferencia son la línea de ensamblaje que lo ejecuta, todos los días, mientras el producto exista. La mayoría de las organizaciones que construyen sobre foundation models nunca tocan directamente un chip de entrenamiento. Casi todas asumen el costo de inferencia.
Quién Fabrica los Chips de IA: Los Actores Clave
Nvidia es el fabricante dominante de GPU para entrenamiento de IA e inferencia en centros de datos, y lo más parecido a una opción predeterminada que tiene la industria. Su segmento de centros de datos, impulsado casi por completo por las ventas de chips de IA, generó $62.3 mil millones en un solo trimestre récord a principios de 2026, con ingresos de centros de datos de todo el año fiscal 2025 que alcanzaron los $115.2 mil millones, un aumento del 142 por ciento interanual.
AMD es el principal competidor de Nvidia en GPU, y ofrece una arquitectura alternativa que algunos hyperscalers y proveedores de nube usan para diversificar el suministro y negociar precios.
Google construye sus propias TPU en lugar de depender de GPU comerciales para gran parte de su carga de trabajo interna de IA, y luego alquila esa capacidad a través de Google Cloud.
El silicio personalizado de los hyperscalers es una categoría en rápido crecimiento. Amazon, Microsoft, Meta y, cada vez más, OpenAI y Anthropic han invertido cada uno en ASIC diseñados a propósito para su propia infraestructura de IA, a menudo trabajando con socios de diseño de chips como Broadcom o Marvell en lugar de construir capacidad de fabricación propia.
Los fabricantes de NPU para el borde, incluidos Apple, Qualcomm e Intel, construyen los chips de bajo consumo que llevan la IA directamente a teléfonos, laptops y dispositivos de consumo, una categoría cada vez más importante a medida que más IA se ejecuta de forma local en lugar de en la nube.
TSMC, la fundición taiwanesa, fabrica físicamente la gran mayoría de estos chips para casi todas las empresas mencionadas anteriormente. Casi ninguna de las empresas que diseñan chips de IA los fabrica realmente; la capacidad de manufactura y empaquetado avanzado de TSMC es uno de los cuellos de botella más ajustados de la industria.
El Mercado de Chips de IA en 2026 y los Controles de Exportación
El mercado de chips de IA se ha convertido en el centro de gravedad de toda la industria de semiconductores. Se proyecta que los chips de IA generativa se acerquen a $500 mil millones en ingresos en 2026, aproximadamente la mitad de los $975 mil millones de la industria global de semiconductores, según la perspectiva de la industria de semiconductores 2026 de Deloitte. La directora ejecutiva de AMD ha elevado su propia estimación del mercado total direccionable de chips aceleradores de IA para centros de datos a $1 billón de dólares para 2030.
Ese crecimiento está empezando a redefinir quién suministra los chips, no solo cuántos se venden. Se pronostica que los ASIC personalizados, alguna vez una alternativa de nicho a las GPU de Nvidia, representen el 27.8 por ciento de los envíos de servidores de IA en 2026, frente al 69.7 por ciento de los sistemas basados en GPU, según el pronóstico de servidores de enero de 2026 de TrendForce. Cada gran hyperscaler tiene ahora su propio programa de chips en marcha, una respuesta directa a las restricciones de costo y suministro de las GPU.
Los controles de exportación añaden otra capa de complejidad. El gobierno de Estados Unidos restringe qué chips de IA se pueden vender a China, una política que ha cambiado repetidamente. Las GPU de la generación Blackwell de Nvidia siguen prohibidas en el mercado chino, mientras que su chip H200, aproximadamente seis veces más potente que el H20 previamente permitido, se volvió elegible para exportación bajo una regla del Departamento de Comercio que entró en vigor de forma escalonada entre finales de 2025 y principios de 2026. El 1 de junio de 2026, el Departamento de Comercio aclaró que el requisito de licencia también se aplica a las subsidiarias en el extranjero de empresas con sede en China, no solo a las entidades ubicadas físicamente dentro de China. Para cualquier empresa que dependa de proveedores globales de IA o cadenas de suministro, estas reglas afectan directamente qué chips, y por lo tanto qué capacidades de IA, están disponibles en cada mercado.
Datos Clave
- El segmento de centros de datos de Nvidia registró ingresos récord de $62.3 mil millones en un solo trimestre a principios de 2026, un aumento del 75 por ciento interanual, según el informe de resultados de NVIDIA presentado ante la SEC.
- En el año fiscal completo 2025, los ingresos por centros de datos de NVIDIA totalizaron $115.2 mil millones, un aumento del 142 por ciento respecto al año anterior, según los resultados del cuarto trimestre del año fiscal 2025 de la empresa presentados ante la SEC.
- Se proyecta que los chips de IA generativa se acerquen a $500 mil millones en ingresos en 2026, cerca de la mitad de los $975 mil millones de la industria global de semiconductores, según la Perspectiva de la Industria de Semiconductores 2026 de Deloitte.
- La directora ejecutiva de AMD, Lisa Su, ha elevado su proyección del mercado total direccionable de chips aceleradores de IA para centros de datos a $1 billón de dólares para 2030, según lo citado en la Perspectiva de la Industria de Semiconductores 2026 de Deloitte.
- Se pronostica que los sistemas ASIC personalizados representen el 27.8 por ciento de los envíos de servidores de IA en 2026, frente al 69.7 por ciento de los sistemas basados en GPU, según el pronóstico de envíos de servidores de IA de enero de 2026 de TrendForce.
- El chip H200 de Nvidia, aproximadamente seis veces más potente que el H20 previamente permitido, se volvió elegible para exportación a China bajo una regla del Departamento de Comercio aclarada el 1 de junio de 2026, mientras que las GPU de la generación Blackwell siguen prohibidas en ese mercado, según la cobertura de Al Jazeera sobre la guía del Departamento de Comercio.
Por Qué los Chips de IA Importan para los Líderes Empresariales
La mayoría de los ejecutivos nunca comprarán un chip directamente. Comprarán una suscripción de IA en la nube, una herramienta SaaS con funciones de IA integradas, o una API de un proveedor de foundation models. Pero la capa de chips sigue apareciendo en la factura de tres maneras concretas.
Costo. La escasez y la demanda de chips determinan lo que le cobran los proveedores de IA. Cuando la capacidad de entrenamiento e inferencia está ajustada, los precios de las API y los costos de IA en la nube suben con ella. Entender esta capa ayuda a explicar por qué algunas funciones de IA son costosas y otras no, y es un insumo clave en cualquier análisis de costo total de propiedad de IA.
Disponibilidad. Los controles de exportación, los límites de capacidad de las fundiciones y la escasez de chips de los hyperscalers pueden determinar qué proveedores de IA realmente pueden entregar a la escala y confiabilidad que usted necesita, en particular para industrias reguladas u operaciones globales que abarcan mercados restringidos.
Rendimiento y latencia. El chip sobre el que un proveedor ejecuta la inferencia afecta qué tan rápido responde su función de IA. Un clúster de GPU lento y sobrecargado detrás de un chatbot produce el mismo retraso frustrante que siente un cliente, sin importar qué tan bueno sea el modelo subyacente.
Usted no necesita convertirse en un experto en semiconductores para gestionar bien las iniciativas de IA. Pero cuando cambian los precios de un proveedor, se retrasa un despliegue o de repente se vuelve disponible una nueva función, la capa de chips, y las empresas que fabrican, manufacturan y exportan esos chips, es muy a menudo la razón.
Conceptos de IA Relacionados
- Inferencia de IA - La fase de producción donde los chips de IA realmente generan valor empresarial
- Edge AI - Ejecutar IA de forma local en NPU en lugar de GPU en la nube
- Optimización de Inferencia - Técnicas que hacen que los chips de IA ejecuten modelos más rápido y a menor costo
- Cuantización - Reducir un modelo para que se ejecute de forma eficiente en chips más pequeños
- Compresión de Modelos - Reducir el tamaño del modelo para un rendimiento de chip más económico y rápido
- Large Language Models - Los modelos que los chips de IA se construyen con mayor frecuencia para entrenar y ejecutar
- Foundation Models - Los modelos base a los que la mayoría de las empresas acceden mediante API impulsadas por chips
- Deep Learning - Las técnicas de redes neuronales que crearon la demanda de chips de IA especializados
- Neural Networks - La arquitectura subyacente que los chips de IA están optimizados para calcular
- MLOps - Gestionar los despliegues de modelos que se ejecutan sobre infraestructura de chips de IA
Recursos Externos
- Relaciones con Inversionistas de NVIDIA - Divulgaciones oficiales trimestrales de ingresos de centros de datos y chips de IA
- TrendForce - Investigación y pronósticos de mercado de semiconductores y servidores de IA
- Perspectiva de la Industria de Semiconductores 2026 de Deloitte - Análisis anual de la demanda de chips de IA y el tamaño del mercado de semiconductores
Preguntas Frecuentes sobre los Chips de IA
¿Qué es un chip de IA en términos simples?
Un chip de IA es un procesador construido específicamente para ejecutar cargas de trabajo de inteligencia artificial de forma eficiente. En lugar de ejecutar instrucciones una a la vez como una CPU, realiza miles de cálculos simples en paralelo, que es justo lo que requieren entrenar y ejecutar modelos de IA.
¿Cuál es la diferencia entre una GPU, una TPU, una NPU y un ASIC?
Una GPU es un chip de IA flexible y ampliamente usado, originalmente construido para gráficos. Una TPU es el chip de Google, diseñado a propósito para las matemáticas del deep learning. Una NPU es un chip pequeño y de bajo consumo integrado en teléfonos y laptops para IA en el dispositivo. Un ASIC personalizado se diseña desde cero para la carga de trabajo específica de una empresa, sacrificando flexibilidad por máxima eficiencia. Los cuatro son chips de IA; simplemente hacen compensaciones distintas.
¿Por qué un procesador de computadora convencional no puede ejecutar IA tan bien como un chip de IA?
Una CPU tiene un número pequeño de núcleos potentes construidos para tareas secuenciales. Las cargas de trabajo de IA necesitan la misma matemática simple repetida en millones de puntos de datos de forma simultánea, que es justo para lo que están construidos los miles de núcleos paralelos de un chip de IA. Una CPU puede ejecutar modelos de IA, solo que mucho más lento y a un costo por tarea mucho más alto.
¿Quiénes son los mayores fabricantes de chips de IA?
Nvidia lidera el mercado de GPU para entrenamiento e inferencia de IA. AMD es su principal competidor en GPU. Google construye TPU para sus propios productos de IA y para Google Cloud. Amazon, Microsoft, Meta y otros hyperscalers diseñan cada vez más ASIC personalizados para sus propios centros de datos. TSMC fabrica los chips físicos para casi todas estas empresas.
¿Cuál es la diferencia entre los chips de entrenamiento y los chips de inferencia?
Los chips de entrenamiento hacen el trabajo intensivo y único de enseñar a un modelo con conjuntos de datos masivos, tolerando mayor latencia a cambio de potencia de cómputo bruta. Los chips de inferencia ejecutan el modelo ya entrenado con entradas reales y en vivo, generalmente optimizados para velocidad, costo y eficiencia energética, ya que la inferencia ocurre de forma continua a escala de producción.
¿Por qué importan los controles de exportación de chips de IA para las empresas?
Los controles de exportación determinan qué chips de IA se pueden vender a qué países, lo cual afecta qué infraestructura de IA y capacidad de nube está realmente disponible en distintos mercados. Para las empresas que operan globalmente o que dependen de proveedores con centros de datos internacionales, estas reglas pueden afectar directamente la disponibilidad del servicio, los precios y qué capacidades de IA son accesibles y dónde.
¿Toda empresa necesita entender los chips de IA para usar IA?
No. La mayoría de las empresas interactúan con los chips de IA de forma indirecta, a través de suscripciones en la nube, herramientas SaaS o funciones de IA basadas en API. Pero el costo, la disponibilidad y el rendimiento de los chips determinan los precios de los proveedores, el momento del lanzamiento de funciones y la velocidad de respuesta, así que un entendimiento básico ayuda a los líderes a interpretar las decisiones de los proveedores de IA y los cambios de presupuesto.
¿Es Nvidia la única empresa que fabrica chips de IA?
No, aunque es el líder de mercado en GPU usadas para entrenamiento de IA e inferencia en centros de datos. Google, AMD, Amazon, Microsoft, Meta, Apple y Qualcomm diseñan todos sus propios chips de IA para distintos propósitos, desde entrenamiento a escala de nube hasta inferencia en el dispositivo en teléfonos y laptops.

Co-Founder, Rework.com
On this page
- Por Qué las CPU Convencionales No Están Diseñadas para Esto
- Los Principales Tipos de Chips de IA
- Chips de Entrenamiento vs. Chips de Inferencia
- Quién Fabrica los Chips de IA: Los Actores Clave
- El Mercado de Chips de IA en 2026 y los Controles de Exportación
- Datos Clave
- Por Qué los Chips de IA Importan para los Líderes Empresariales
- Conceptos de IA Relacionados
- Recursos Externos