AI Agentのコスト最適化: キャッシュ、モデルルーティング、予算上限
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI agentのコスト最適化とは、agentのトークンと計算の支出を、それが生み出す価値に見合う水準に保つための一連の手法です。すでに処理したコンテキストに再び料金を払わないためのキャッシュ、簡単なステップは安価なモデルで、難しいステップは高価なモデルで実行するためのモデルルーティング、そして人に引き継ぐ前に1つのタスクが使える金額に上限を設ける予算上限の3つです。agentがパイロット段階を出た後は、どれも省くことはできません。ループを回し、ツールを呼び出し、1周ごとにコンテキストを読み直すagentは、数セントで済んでいたデモを、数ドルかかる本番タスクに変えてしまうことがあります。その差は、ほぼ必ずこの3つの手段のどれかにあり、モデルそのものにあるのではありません。
Agentのコスト曲線がモデルのコスト曲線と異なる理由
単一のモデル呼び出しなら、入力は1つ、出力は1つ、価格も1つです。AI agentの仕組みでは、agentを代わりにループとして説明しています。知覚、推論、行動、観察を繰り返し、このループの1周ごとに、それぞれモデル呼び出しやツール呼び出しが発生しえます。簡単なケースなら1回の呼び出しで済むタスクも、難しいケースでは5回、10回、あるいはそれ以上になりえます。しかも、その呼び出しのたびに一定量のコンテキストを再送するため、単一の呼び出しにはない形で、反復回数とともにコストが積み上がります。
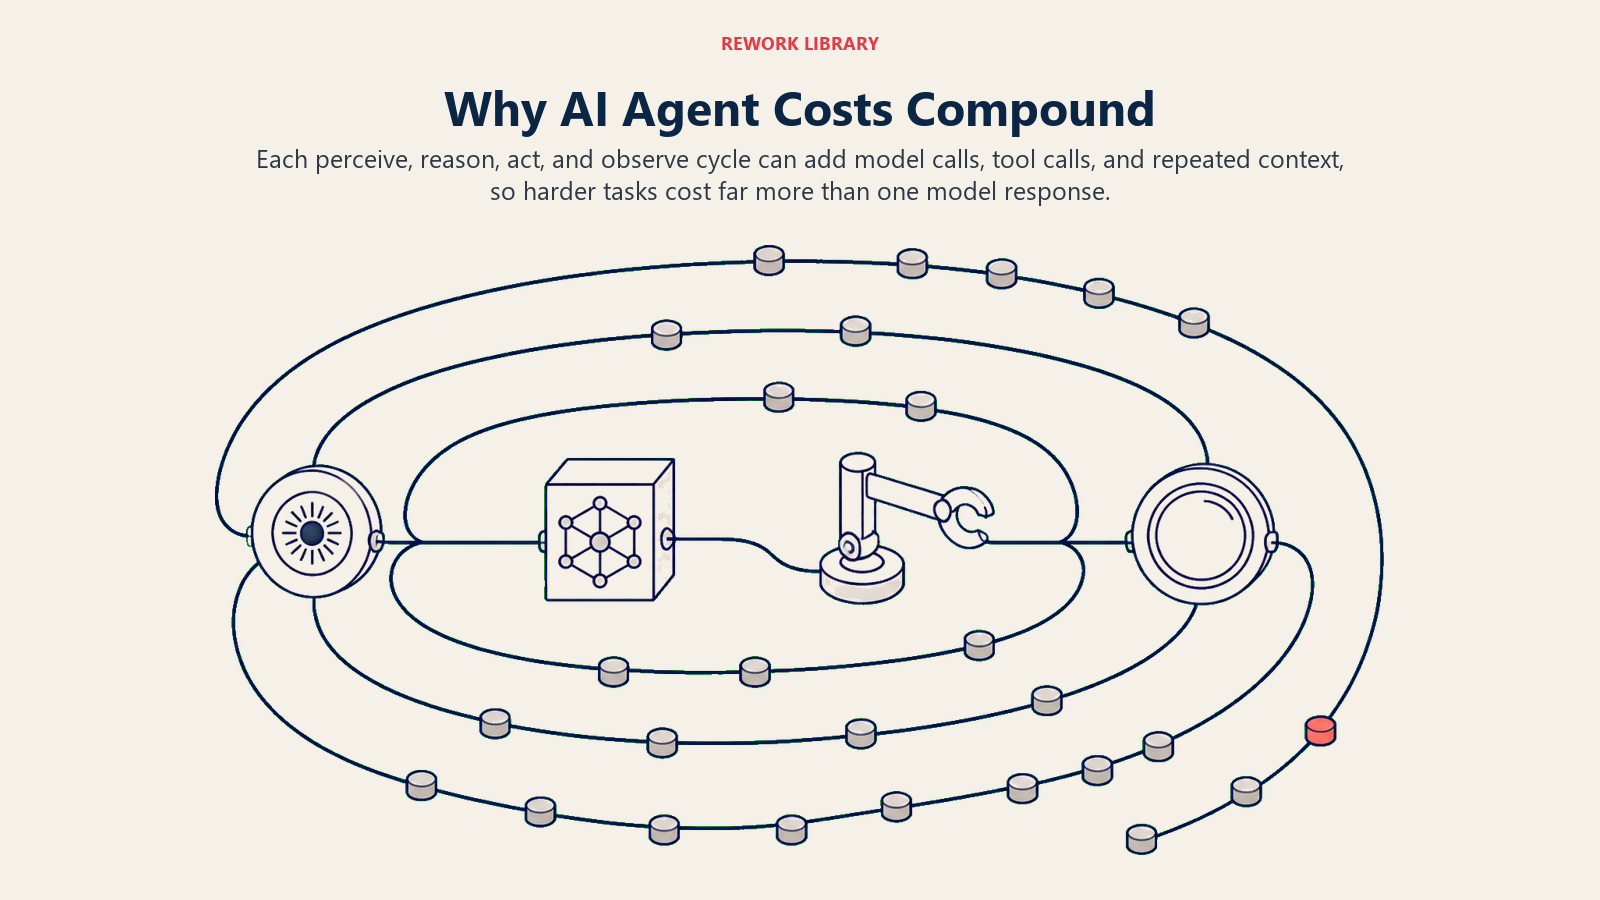
だからこそ、コストはagentic型プロジェクトが停滞する理由として頻繁に挙がります。Gartnerは、agentic AIプロジェクトの40%超が2027年末までに中止されると予測しており、主な原因として、コストの増大、不明確なビジネス価値、不十分なリスク管理を挙げています。コストの増大は、スケールする前にモデル化しておけば、めったに不意打ちにはなりません。AIパターンが大規模運用で高コストになるときでは、統制のないAutonomous Agentが、パイロットで想定していた2、3回ではなく、1件のサポートチケットを25回のモデル呼び出しに膨らませた経緯を解説しています。以下の3つの手段は、それを自社で起こさないための方法です。
手段1: キャッシュで、同じコンテキストに二重に支払わない
agentの実行では毎回、呼び出しごとにほとんど変わらないコンテキストのまとまりを再送します。システムプロンプト、ツールスキーマ、長いナレッジベースの抜粋、ここまでの会話です。キャッシュとは、モデルプロバイダーがそのまとまりを記憶しておき、ゼロから再処理するのではなく、再利用する分を割安な料金で請求する仕組みです。
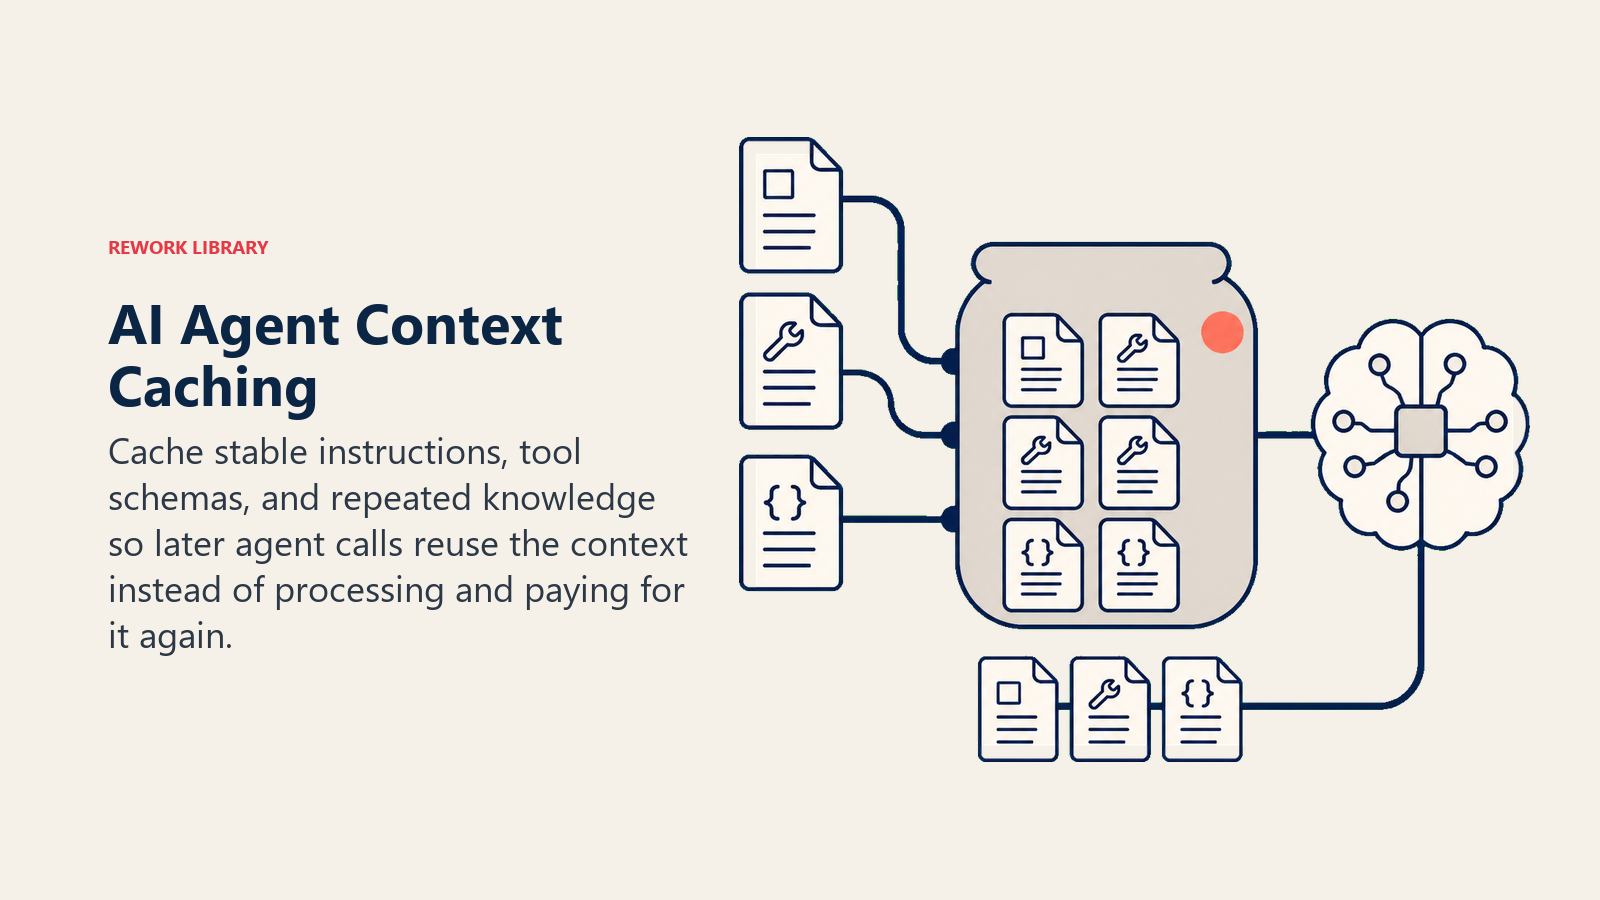
この割引は本物であり、大きなものです。Anthropic自身の料金設定では、キャッシュされた入力トークンの料金は基本入力料金の10%、つまり90%の削減になります。ただし、キャッシュに新しい内容を書き込むコストは通常の呼び出しより25%高くなります。そのため、プロンプトが2、3回を超えて再利用されれば、キャッシュは元が取れます。OpenAIをはじめとする主要プロバイダーも、それぞれキャッシュトークンの割引を提供しています。仕組みの詳細はベンダーごとに異なりますが、経済性はどこも同じです。即時の返信を必要としない業務(夜間のCRMのクレンジング、ドキュメントの一括分類、夜間のレポート生成)については、AnthropicのBatch APIが別途割引を上乗せします。ライブの応答の代わりに非同期処理とすることで、標準料金の50%オフになります。
最初の日からagentに組み込む価値のあるキャッシュのパターンは2つあります。
- コンテキストキャッシュ: システムプロンプト、ツール定義、大きな静的参照ドキュメント(ポリシーファイルや製品カタログ)をキャッシュし、呼び出しの間で実際に変わる部分だけを全額で課金されるようにします。
- レスポンスキャッシュ: 本当に繰り返される質問(同じFAQ、ほぼ同一の入力に対する同じ分類)については、モデル呼び出しを完全にスキップし、保存済みの回答を返します。毎回再生成せず、スケジュールに沿って更新します。
手段2: モデルルーティングで、簡単なステップが最先端モデルの料金を払わないようにする
agentのループの全ステップが、最も高性能で最も高価なモデルを必要とするわけではありません。チケットの分類、フォームからのフィールド抽出、案件が既知のシナリオに合致するかの確認は、細やかな顧客向け返信の作成や、曖昧な例外の推論とは別の仕事です。そして、主要プロバイダー全体で公開されているAPI料金には、小型で高速なモデルと最先端のフラッグシップモデルとの間に、桁違いの差が、多くは10倍以上あることが示されています。
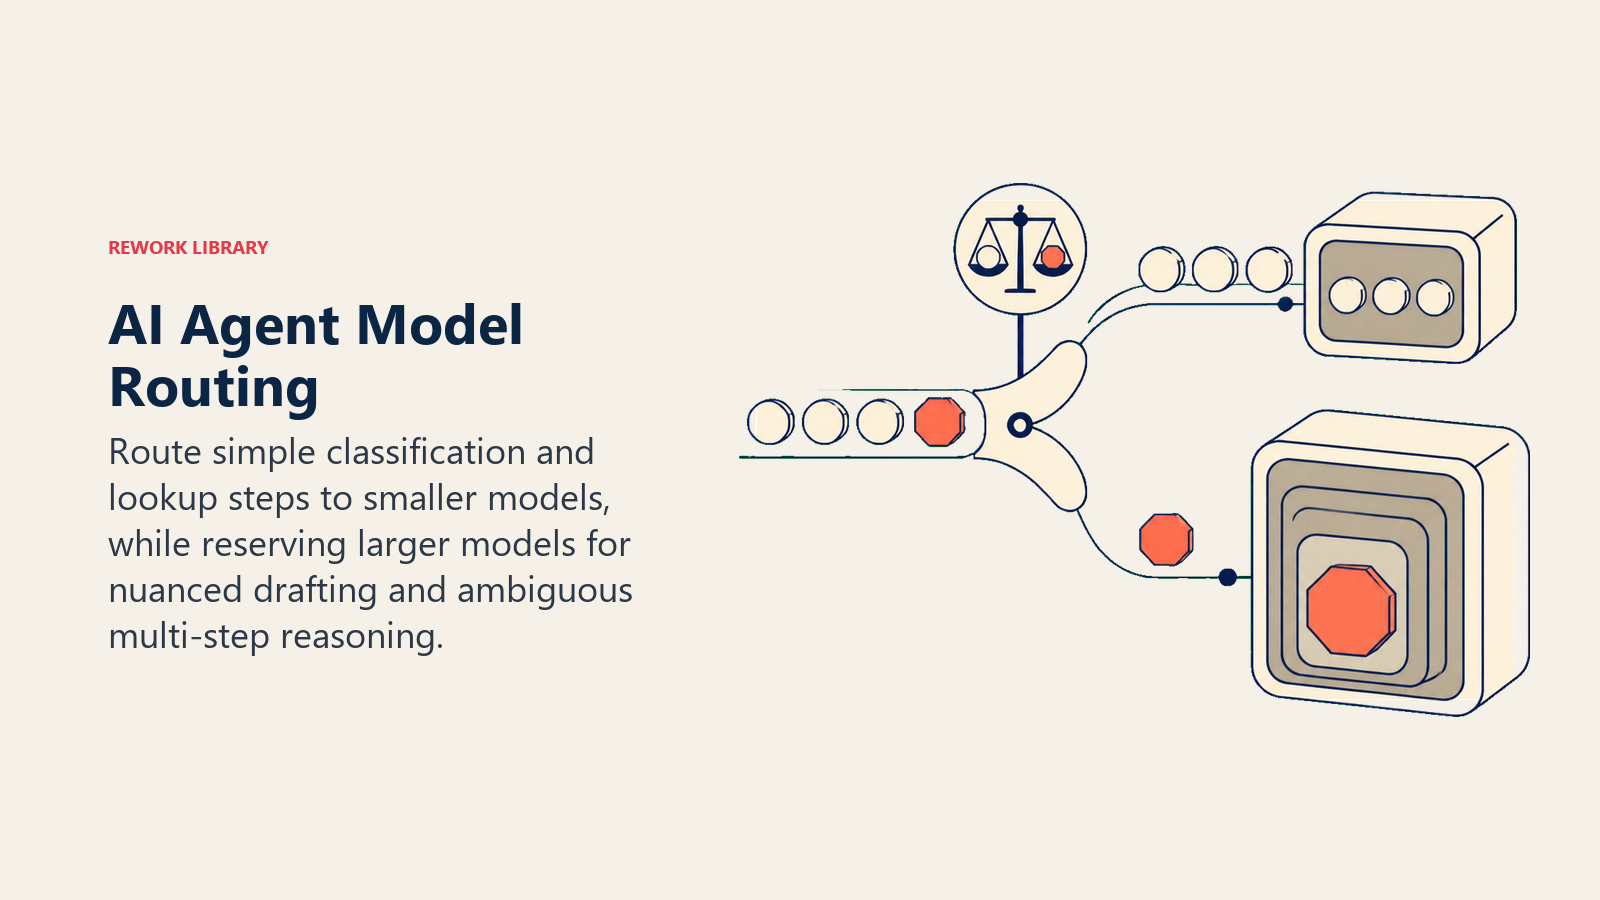
モデルルーティングとは、agent全体をデフォルトで1つの階層で動かす代わりに、ステップに合わせてモデルを選ぶことです。AIパターンが大規模運用で高コストになるときの、Workflow Copilotのコストに関するセクションでも同じ考え方が紹介されています。単純なサジェストのリクエストは安価なモデルにルーティングし、プレミアムな推論は、本当に必要なリクエストのために取っておくというものです。典型的なagentのためのシンプルなルーティング表は次のとおりです。
| ステップの種類 | 例 | モデルの階層 |
|---|---|---|
| 分類、抽出、ルーティングの判断 | このチケットはどのキューに属しますか。 | 小型、高速、低コスト |
| 構造化された照会とルールの照合 | この請求書は承認済みの発注書と一致しますか。 | 小型から中型 |
| 顧客向けテキストの作成 | この具体的なケースへの返信を書く | 中型から大型 |
| 曖昧な例外とマルチステップの推論 | このケースはどのプレイブックのシナリオにも当てはまらない | 利用可能な最大のもの |
agentが、行動するか、確認するか、引き継ぐかを決める意思決定ロジックの構成要素は、モデルルーティングを置くべき場所と同じです。すでにケースの種類ごとにロジックを分岐させているのですから、モデルの選択を別の判断として扱うのではなく、同じ分岐に通してください。
手段3: 予算上限で、暴走したタスクが請求額を膨らませないようにする
キャッシュとルーティングは、呼び出しあたりの価格を下げます。予算上限は、1つのタスクが行える呼び出しの回数を制限します。実際のコスト急増は、呼び出しあたりの価格から生じることはほとんどないため、これが重要です。コストの急増は、誰も計画していなかった回数を大きく超えてモデルを呼び出し続けるタスクから生じます。
AIパターンが大規模運用で高コストになるときは、率直に述べています。反復回数の厳格な上限もタスクごとのトークン予算もないAutonomous Agentは、生産性を高めるツールではなく、財務上の負債です。対策は2つの設定で、言葉にするのは簡単ですが、省略もしやすいものです。1つはタスクあたりのモデル呼び出しの最大回数、もう1つはタスクがその上限に達したときに、支出を続けるのではなく、人間へ自動的に引き継ぐことです。どちらも、最初に高額な月を経験した後に足す、あると望ましいものではありません。agentに必要なほかのあらゆるハードリミットと同列に置くべきものです。AI agentのガードレールでは、出力とツール呼び出しのガードレールを詳しく取り上げており、予算上限はまさにその種のガードレールです。あと1回呼び出せば仕事が終わるとagentがどれだけ確信していても、変わらず守られるルールです。
実際のAgentでの現れ方
これらの手段は抽象的なものではありません。このライブラリの中で、正しく行うか誤るかによって請求額に大きな影響が出る場所をいくつか挙げます。
- AI Research Agent: コストは、1つのブリーフあたりにコンテキストへ取り込む出典の数にほぼ比例します。出典の数を絞り、統合のステップを利用可能な最大のモデルではなく中位のモデルにルーティングすることが、2ドルのブリーフと20ドルのブリーフの分かれ目になることも少なくありません。
- AI Knowledge Base Agent: 同じポリシードキュメントやFAQの抜粋が、何百もの似た質問にわたって取得されます。そのため、クエリのたびに取得した同じチャンクを再送するのではなく、コンテキストをキャッシュするうえで、最も効果の高い場所の1つです。
- AI Support Triage Agent: 呼び出し量が多いため、1回あたりのわずかな節約でも急速に積み上がります。最初の分類のステップを小型モデルにルーティングし、実際の返信の作成には大型のモデルを取っておくことで、ボリュームが予算のすべてになるのを防げます。
パイロットを超えてスケールする前の、シンプルなコストモデル
agentを小規模なパイロットから本格的なボリュームへ移す前に、4つの項目におおよその数値を当ててください。呼び出しあたりの平均トークン数(推測ではなく計測します)、本番規模で想定される呼び出し量、キャッシュヒット率の想定、モデル階層間のルーティングの配分です。パイロットのボリュームだけでなく、パイロットの2倍と5倍のボリュームでも掛け算してください。パイロットは最も簡単で代表的なケースで動きますが、本番はそうではないからです。AIパターンが大規模運用で高コストになるときでは、まさにこの理由から、サンプルから導かれる数値に50〜100%のバッファを加えることを推奨しています。
早い段階でモデル化する価値のあるもう1つの数値は、活動量に対するコストではなく、成果に対するコストです。AIパターンのROI測定では、この考え方をさらに掘り下げています。タスクの半分で失敗する安価なagentは、後始末に費やす人の時間まで数えれば、実際には安くありません。さらに視野を広げると、agentの推論は、人材、連携、ガバナンスも含む、より広いAIの総保有コストの中の1つの項目にすぎません。この1つの手段を正しく行ったからといって、AI予算の残りが自然にうまくいくわけではありません。
出荷後のコストを監視する
ローンチ時の最適化は、ローンチ後に監視しなければ時間とともにずれていきます。AI agentのオブザーバビリティでは、ここで最も重要な指標をすでに挙げています。実行あたりのコストではなく、完了したタスクあたりのコストです。失敗した実行もトークンを消費しており、成功するまでに2回失敗する安価な実行は、実際には安くないからです。この数値を、キャッシュヒット率およびモデル階層の分布と並べて追跡し、3つのいずれかがずれたときに注意を払ってください。完了したタスクあたりのコストの上昇、キャッシュヒット率の低下、以前は安価にルーティングされていたステップの種類での高価な階層へのシフトです。この3つのどれもが、通常、請求書が知らせてくれるよりずっと前に、agentの入力や動作の何かが変わったことを示す最も早いサインです。
agentを構築または運用するプラットフォームを比較している場合は、ベンダー間で似たようなものだと決めつけず、コストの予測可能性を明示的に評価する価値があります。当社のAIツール比較は、機能一覧にとどまらないプラットフォームの評価を行っています。また、SaaSベンダー評価スコアカードは、選択肢を採点する際に、コストの予測可能性を機能性と対等に扱うための、重み付きのテンプレートを提供します。
Key Facts
- Anthropicのモデルでは、キャッシュされた入力トークンは標準の入力料金より90%安く(キャッシュからの読み取りは基本料金の10%)、キャッシュへの新規書き込みは25%高いため、1、2回を超えて再利用されるものであればキャッシュは元が取れます。
- リアルタイムではないagent業務のバッチ処理では、標準のAPI料金にさらに50%の割引が加わります。
- Gartnerは、agentic AIプロジェクトの40%超が2027年末までに中止されると予測しており、主な原因の1つとしてコストの増大が挙げられています。
- 主要プロバイダー全体で公開されているモデル料金では、通常、小型で高速なモデルと最先端のフラッグシップモデルとの間に桁違いの差があります。これが、タスクの難易度に応じたルーティングを、多くのチームがまだ活用していない最もレバレッジの高い手段にしています。
- ループを回すagentにとって最も重要な財務上の統制は、呼び出しあたりの価格を下げることではなく、タスクあたりのモデル呼び出しに上限を設け、それに達したら自動的に引き継ぐことです。
AI Agentのコスト最適化に関するよくある質問
AI agentのコスト最適化とは何ですか。
agentのトークンと計算の支出を、成果に見合う水準に保つための一連の手法です。繰り返されるコンテキストをキャッシュして再処理の料金を払わないこと、簡単なステップは安価なモデルに、難しいステップは高性能なモデルにルーティングすること、そして人に引き継ぐ前に1つのタスクが使える金額に上限を設けることが含まれます。
AI agentの運用コストが、単一のモデル呼び出しより高くなるのはなぜですか。
agentは、知覚、推論、行動、観察を繰り返すループを回し、1周ごとにそれぞれモデル呼び出しやツール呼び出しが発生しえます。簡単なケースなら1回の呼び出しで済むタスクも、難しいケースではずっと多くなりえるため、単一のモデル呼び出しにはない形で、反復回数とともにコストが積み上がります。
キャッシュとモデルルーティングの違いは何ですか。
キャッシュは、すでにモデルへ送ったコンテキストを再利用するコストを下げ、キャッシュされた部分では多くの場合90%以上の削減になります。モデルルーティングは、すべてのステップをデフォルトで最も高価なモデルで動かす代わりに、各ステップを、それをうまくこなせる最も安価なモデルに合わせることでコストを下げます。両者は補完関係にあり、どちらか一方を選ぶものではありません。
これらの手法で、実際にどれくらい節約できますか。
繰り返されるコンテキスト、呼び出し量、タスクの複雑さの組み合わせによって異なりますが、もとになる割引は大きなものです。キャッシュされた入力トークンは90%オフ、バッチ処理は50%オフ、そして最先端の推論を必要としないステップについては、小型モデルと最先端モデルの間に通常、桁違いの価格差があります。
agentのタスクに設ける予算上限は、どのくらいが妥当ですか。
タスクの複雑さによって変わるため、万能な数字はありませんが、原則は共通です。タスクごとに呼び出しの最大回数を設定し、その上限に達したら自動的に人間にルーティングします。agentに際限なく試行させ続けてはいけません。提案ではなく、ガードレールとして扱ってください。
次に読むもの
キャッシュ、ルーティング、予算上限は、agentのコストを制御します。AI agentのオブザーバビリティは、ローンチ後もそれらの統制が機能し続けているかを確認する方法です。完了したタスクあたりのコストは、ずれを示す最も明確な早期シグナルの1つだからです。大規模運用でなぜコストが膨らむのかをまだモデル化していない場合は、AIパターンが大規模運用で高コストになるときがより深い読み物になります。AI agentの構築方法では、agentのほかのガードレールの中で、予算上限がどこに位置づくかを解説しています。
