AI agentの評価とテストの方法
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI agentの評価とは、agentが実際のタスクを正しく、安全に、一貫して完了できるかを体系的にテストする取り組みです。顧客に届く前に行い、届いた後も継続的に行います。現実的なタスクのテストセット、単一の正解チェックではなくタスク成功指標、そして本番で失敗が積み重なる前に見つけ出す採点方法(ルール、人間によるレビュー、または審査役として動く2つ目のモデル)を組み合わせます。このステップを省略すれば、agentを運用しているのではなく、自社のビジネスで制御されていない実験をしていることになります。
AI agentとは実際に何かと、その背景にある限定された自律性の考え方をまだ整理できていない場合は、先にそちらから始めてください。このページは、その段階を終え、実際のボリュームを任せられるほどagentが信頼できるかを問う段階にいることを前提にしています。
agentのテストが通常のソフトウェアのテストと違う理由
従来のソフトウェアQAは、固定された入力を固定された期待出力と照合します。このボタンをクリックして、あの画面が出ることを期待する、という具合です。AI agentは、3つの点でこのモデルを崩します。同じ入力が複数の有効な出力を生み得ること、1つのタスクがagentの見つけたものに応じて5ステップにも15ステップにもなり得ること、そしてモデル自体の確率的な性質により、まったく同じことを2回するとは限らないことです。
| 従来のソフトウェアテスト | AI agentのテスト | |
|---|---|---|
| 入力から出力 | 正しい出力は1つ | 複数の有効な出力があり得る |
| 経路 | 固定されたステップの順序 | ケース、使うツール、順序によって経路が変わる |
| 再現性 | 同じ入力なら毎回同じ結果 | 同じ入力でも、有効ではあるが異なる経路になり得る |
| 合否 | 二値 | ルーブリックに対する段階的なスコアであることが多い |
| 壊れる原因 | コードの変更 | プロンプトの変更、モデルの更新、データのドリフト、ツールのAPIの変更 |
だからといってテストを省略してよいわけではありません。テストのやり方を変えるべきだということです。省略した場合のコストも現実のものです。Gartnerは予測しています。agentic AIプロジェクトの40%超が2027年末までに中止され、その主な原因は、技術の失敗ではなく、コストの増大、不明確なビジネス価値、不十分なリスク管理だといいます。厳格な評価の実践こそが、「このagentは機能していると思う」を、予算の責任者に説明できる数字に変えるものです。
中核となる指標:精度ではなく、タスク成功
テストケースを書く前に定義しておくべき最も重要なことは、この特定のagentにとって「成功」が何を意味するかです。途中で生成する言葉ではなく、生み出す成果の観点で定義します。
AI Lead Scoring Agentにとっての成功は、個々のスコアが人間の推測と一致するかどうかではありません。「hot」とスコアしたリードが、その後の数週間で、「cold」とスコアしたリードよりも意味のある高さで成約するかどうかです。AI Support Triage Agentにとっての成功は、チケットが適切なコンテキストとともに適切なキューに届くかどうかであり、分類の言い回しが人間の表現と完全に一致するかどうかではありません。
指標は2種類に分けます。
- アウトカム指標は、目標が実際に達成されたかを測ります。予約された会議、解決されたチケット、正しく抽出された請求書のフィールド、正確にフラグが付けられた取引などです。
- プロセス指標は、agentがどのようにそこに至ったかを測ります。どのツールを呼び出したか、何ステップかかったか、トークンやAPI呼び出しでいくらかかったか、どれくらい時間がかかったかです。
両方が必要です。不要な20ステップを踏み、タスクあたりの想定コストの10倍を使ってアウトカム指標を達成したagentは、実際には成功していません。良い成績表をまとった問題です。
出荷する前にテストセットを作る
定義していないものは評価できません。agentを本番稼働させる前に、実際に直面する現実的なタスクのセットを、次の3つの情報源から集めます。
- 過去の実際のケース。 過去のチケット、リード、取引を、必要に応じて匿名化して使います。すでに起きたことで、正しい結果が何だったかを把握している、または判断できるため、手元にある最も正解に近いものです。
- 合成したエッジケース。 いずれ起きると分かっているが、過去の例がまだ十分にない状況です。発売したばかりの製品について尋ねる顧客、通常のICPの範囲外のリード、不正検知のしきい値をわずかに下回る取引などです。
- 敵対的なケース。 agentを意図的に壊すよう設計された入力です。ルールを無視するよう説得しようとするメッセージ、ナレッジベースに適切な答えがない質問、明らかにスコープ外のリクエストなどです。
実践的な出発点は、agentのシナリオプレイブックの各行につき1つのテストケースを作ることです。これは、すべてのReworkブループリントが定義する6つの構成要素の一部です。そこに、少数の敵対的なケースを重ねます。最初は数百ではなく数十件が目安です。規模よりも重要な習慣は、本番で実際に起きた失敗を、修正した後にすべてテストセットへ戻して追加し、同じバグが二度出荷されないようにすることです。
オフライン評価とオンライン評価
両方を実施し、それぞれが実際に何のためにあるのかを理解しておきます。
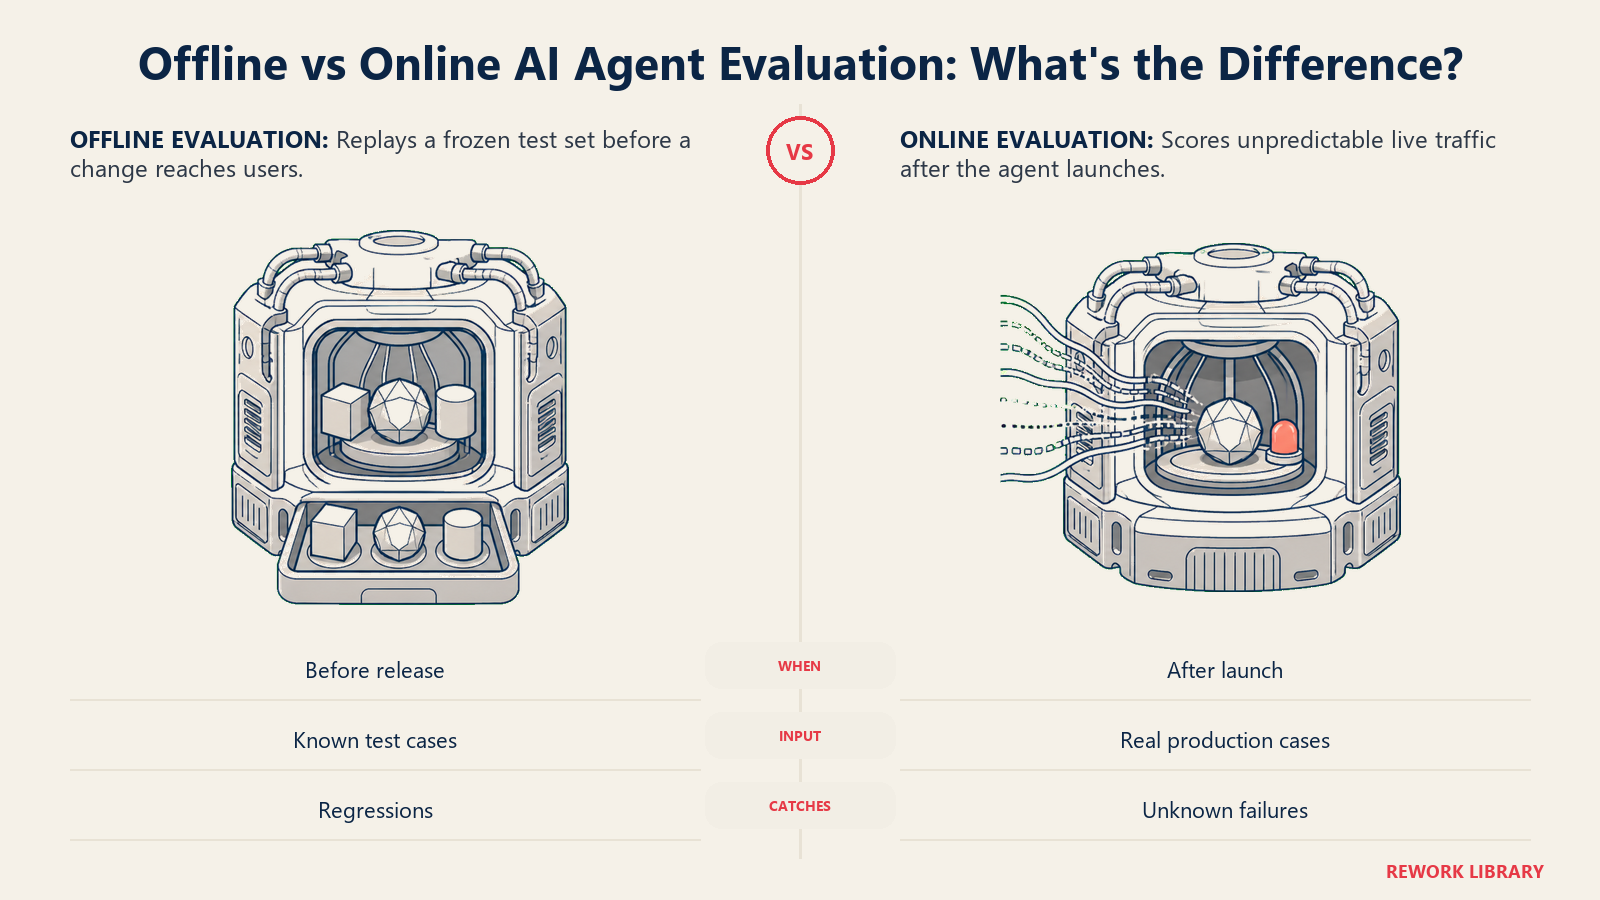
| オフライン評価 | オンライン評価 | |
|---|---|---|
| 実行するタイミング | 変更を出荷する前 | agentが稼働した後 |
| テストの対象 | 固定された既知のテストセット | 実際の予測不能な本番トラフィック |
| 実行コスト | 安価で再現でき、変更のたびに安全に実行できる | モニタリング基盤と実際の利用が必要 |
| 検出できるもの | リグレッション:以前は動いていたものがこの変更で壊れていないか | 未知のもの:テストを書こうと考えもしなかったケース |
| 一般的な頻度 | プロンプト、モデル、ツールを変更するたび | 継続的 |
オフライン評価はシートベルトです。プロンプトに手を入れ、モデルを入れ替え、ツールを追加するたびに、デプロイ前にテストセット全体を再実行します。以前は通っていたケースでタスク成功率が下がれば、顧客より先にリグレッションを見つけたことになります。
オンライン評価は、現実世界が返事をする場です。よくあるパターンはシャドーモードです。新しいバージョンのagentを、すでに本番にあるバージョンと並べて、同じライブの入力で動かしますが、新しいバージョンには実際に行動させません。トラフィックを切り替える前に、2つの出力を比較します。ここは、稼働後にagentを継続的に監視するログ、トレース、メトリクス、自動評価を含む本番モニタリングが引き継ぐ領域でもあります。この分野には独自の深さがあります。問題が数週間ではなく数分で見えるようにagentを計装する方法は、AI Agentのオブザーバビリティをご覧ください。
agentの出力をどう採点するか
テストセットができたら、各結果を採点する方法が必要です。3つのアプローチがあり、単独よりも組み合わせて使うことのほうが多くなります。
ルールベースのチェック。 速くて安価です。agentが正しいツールを呼び出したか、出力が期待する形式に一致したか、必須の引用を含めたかを確認します。ルールは機械的に確認できる振る舞いにしか使えないため、人々が想像するよりも全体像のカバー範囲は狭くなります。OpenAIのagent構築ガイドは、これを多層防御として位置付けています。1つのチェックですべてを捉えることはできないからです。
人間によるレビュー。 トーン、判断の分かれる場面、主観的なことすべてについて最も信頼できる審査員ですが、最も遅く、最もコストがかかります。すべての会話を手作業で確認する人はいません。サンプリングします。稼働中のagentなら、週に20〜50件のトランスクリプトで、誰かの仕事の全部にならずにドリフトを捉えるのに十分です。
LLM-as-judge。 2つ目のモデルを使って、agentのアウトプットを書面のルーブリックに照らして採点します。人間のレビューが数十件を扱う時間で、数千件にスケールします。そのため、実際のボリュームでagentを評価する標準的なパターンになりました。ただし、LLM審査員が信頼できるのは、キャリブレーションを行った後です。同じサンプルを人間と審査員モデルの両方で定期的に採点し、頻繁に食い違うなら、直すのはモデルではなくルーブリックです。プロンプトの改良のような並べての比較では、審査員に絶対的なスコアを求めるより、2つの出力のうち良いほうを選ばせるほうがうまくいく傾向があります。
最終的な答えだけでなく、ステップを評価する
最終的な答えは、誤った理由で正しく見えることがあります。agentが、誤ったナレッジベースの記事を確認した後で、たまたま正しいチケットカテゴリにたどり着くことがあります。あるいは、気づくべきだったスケジュールの衝突を無視して、正しい会議枠を予約することもあります。これは、合格点をまとったバグであり、運の良い経路が使えなくなった次のときに再び表面化します。
トレースレベルのレビューとは、agentの実際のシーケンスをたどることです。どのツールを、どのパラメータで、どの順序で呼び出したか、そして先に進む前に不正な結果や空の結果をきちんと処理したかを見ます。agentがより長く、より自律的なタスクを担うほど、これは重要になります。METRは、最先端のAIモデルを現実的な仕事でベンチマークし、agentが確実に完了できるタスクの長さ、つまり「タイムホライズン」が、6年連続でおよそ7か月ごとに倍増していることを明らかにしました。現在のモデルは、人間の専門家が数分で終えるタスクではほぼ完璧ですが、約4時間かかるタスクでは10%未満しか成功しません。このギャップこそ、軌跡レベルの評価が真価を発揮するところです。最終的な答えを確認するだけでは、長いステップの連鎖のどこで逸れ始めたのかは分かりません。
見出しの数字よりトレースが重要な理由を、2つの例で示します。
- AI Support Triage Agentでは、チケットの最終的なタグだけでなく、ルーティングの判断の全体を確認する必要があります。顧客の元のリクエストは保持されたでしょうか。それとも、キューの変更によってコンテキストが消え、人間の担当者が改めて尋ね直すことになったでしょうか。
- AI Fraud Detection Agentでは、適合率と再現率を1つの数字に混ぜず、2つの別々の数字として追跡する必要があります。偽陽性は、正当な顧客のアカウントを凍結します。偽陰性は、本物の不正を通してしまいます。この2つの失敗は、ビジネスにまったく異なる形でコストを生じさせます。
このトレースレビューを、プロダクトに直接組み込むチームもあります。AI Chatbot QA Agentは、評価を独立したagentとしてパッケージ化したものです。稼働中のボットの会話を読み、正確さ、トーン、解決度を採点し、ハルシネーションやデッドエンドループにフラグを立てて人間が修正できるようにします。この記事で説明している規律と同じことを、一度きりの公開前のパスではなく、継続的に実行します。
稼働後に追跡するもの
agentが稼働したら、短い数字のリストで、本来の仕事をまだ果たしているかが分かります。
- タスク成功率の推移。 下降傾向にあれば、何かがずれています。モデルの更新、古くなったデータソース、入ってくるケースの種類の変化などです。
- エスカレーションと引き継ぎの率。 低すぎると、agentが権限を越えている可能性があります。高すぎると、ルールが保守的すぎて役に立たない可能性があります。
- 人間による上書きの率。 人がagentの判断を覆したり修正したりする頻度はどれくらいでしょうか。上書き率の上昇は、タスク成功率が目に見えて下がるずっと前に出る早期警告です。
- 完了したタスクあたりのコスト。 成果を改善しないままトークン使用量を静かに倍増させるモデルの入れ替えやプロンプトの変更は、誰も見ていない場所に隠れた予算の問題です。
- リグレッション率。 新たな失敗のうち、一度修正したバグの再発はどれくらいの割合か。テストセットが成熟するにつれ、ゼロに近づくはずです。
agent構築プラットフォームを比較していて、こうしたトレースと評価のツールを、手作業で組み立てるのではなく最初から組み込みたい場合は、AIチャットボットプラットフォームの選び方ガイドで何を見るべきかを、自動化ツールの一覧で、2026年に利用できるものを探す出発点を確認できます。
Key Facts
- AI agentの評価は、現実的なテストセット、タスク成功指標、採点方法(ルール、人間によるレビュー、LLM-as-judge)を組み合わせ、変更のたびにオフラインで、稼働後は継続的にオンラインで実施します。
- Gartnerは、agentic AIプロジェクトの40%超が2027年末までに中止されると予測しています。原因は不明確なビジネス価値と不十分なリスク管理で、まさに実際の評価の実践が早期に捉えるために作られているものです。
- METRの研究によれば、AI agentが確実にこなせるタスクの長さはおよそ7か月ごとに倍増しており、agentがより長く自律的な仕事を担うほど、トレースレベルのステップごとの評価が重要になります。
- LLM-as-judgeを信頼するのは、同じサンプルのケースで人間の評価と照らしてキャリブレーションした後に限ります。
AI agentの評価とテストの方法に関するよくある質問
AI agentの評価とは何ですか。
AI agentの評価とは、AI agentが実際のタスクを正しく、安全に、一貫して完了できるかをテストする取り組みです。現実的なケースのテストセット、単一の正解ではなく成果を測るタスク成功指標、ルール、人間によるレビュー、審査役の2つ目のモデルといった採点方法を使い、公開前と公開後の継続的な運用の両方で実施します。
オフライン評価とオンライン評価の違いは何ですか。
オフライン評価は、出荷する前の変更のたびに、固定したテストセットを実行し、リグレッションを安価かつ再現可能な形で捉えます。オンライン評価は、公開後に実際の本番トラフィックを監視し、テストを書こうと考えなかった予測不能なケースを捉えます。成熟したagentのプログラムは、どちらか一方ではなく両方を実施します。
LLMは本当に別のAI agentの仕事を採点できますか。
できます。人間によるレビューだけでは週に数十件までしか対応できないため、実際のボリュームでagentを評価する標準的な方法です。注意点はキャリブレーションです。同じサンプルでLLM審査員のスコアと人間の評価を定期的に比較し、頻繁に食い違うなら、審査員のスコアを大規模に信頼する前に、ルーブリックを直してください。
agentを公開する前に、いくつのテストケースが必要ですか。
agentのシナリオプレイブックの各行につき1つのテストケースに、少数のエッジケースと敵対的な入力を加えて始めます。通常は数百ではなく数十件です。本番で実際に起きた失敗を、修正した後にすべて追加してテストセットを育てれば、同じバグが二度出荷されることはありません。
追跡すべき最も重要な指標は何ですか。
タスク成功率です。個々のステップの精度ではなく、そのagentが生み出すために存在する実際のビジネス成果に照らして測ります。完了したタスクあたりのコストのようなプロセス指標と組み合わせてください。高コストや遠回りの経路で正しい成果に到達するagentにも、現実の問題が残っているからです。
次に読むもの
しっかりした評価の実践こそが、実際のボリュームを任せられるagentと、たまたま試したケースでしか動かないデモを分けるものです。テストセットと採点方法が整ったら、最初のバージョンをまだ出荷していない場合はAI agentの作り方が次の一歩になります。agentが実際のデータに基づいて回答する仕組みはAI agentのためのRAGで、長いタスクの間にコンテキストを保つ仕組みはAI Agentのメモリで確認できます。どちらも、評価で何を捉えられるかに直接影響します。
