Otimização de Custos de AI Agents: Cache, Roteamento de Modelos e Orçamentos
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
A otimização de custos de AI agents é o conjunto de técnicas que mantém o gasto de tokens e de computação de um agent proporcional ao valor que ele entrega: cache, para que o agent não pague de novo por um contexto que já processou; roteamento de modelos, para que os passos fáceis rodem em modelos baratos e os difíceis em modelos caros; e orçamentos rígidos, que limitam quanto uma única tarefa pode gastar antes de passar para uma pessoa. Nada disso é opcional depois que um agent sai da fase piloto. Um agent que faz loop, chama ferramentas e relê o contexto a cada passagem pode transformar uma demo que custava centavos em uma tarefa de produção que custa dólares, e a diferença quase sempre está em uma dessas três alavancas, e não no modelo em si.
Por que a Curva de Custo de um Agent Não É a de um Modelo
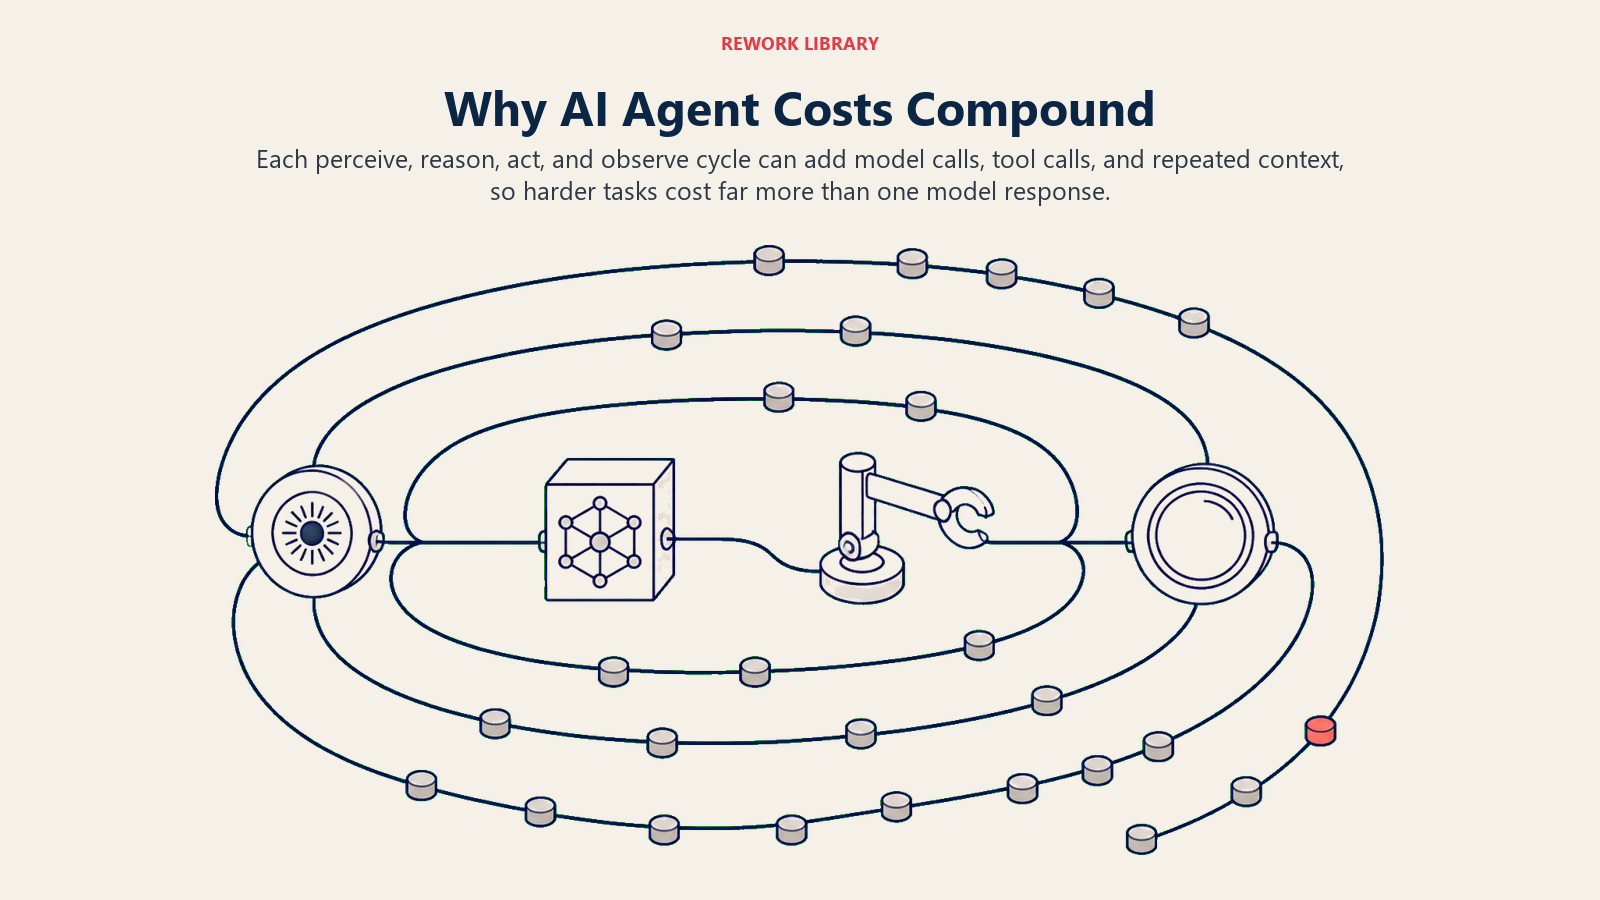
Uma única chamada de modelo tem uma entrada, uma saída, um preço. Como os AI agents funcionam descreve um agent como um loop: perceber, raciocinar, agir, observar e repetir, e cada passagem por esse loop pode disparar a própria chamada de modelo ou de ferramenta. Uma tarefa que exige uma chamada em um caso simples pode exigir cinco, dez ou mais em um caso mais difícil, e cada uma dessas chamadas reenvia certa quantidade de contexto, de modo que o custo se acumula com as iterações de uma forma que uma única chamada nunca faz.
É exatamente por isso que o custo aparece com tanta frequência como motivo para projetos agênticos travarem. A Gartner prevê que mais de 40% dos projetos de agentic AI serão cancelados até o fim de 2027, citando custos crescentes, valor de negócio pouco claro e controles de risco inadequados como as principais causas. Custo crescente raramente é surpresa se você o modelar antes de escalar. Quando os padrões de IA ficam caros em escala mostra como um Autonomous Agent sem controles transformou um único ticket de suporte em 25 chamadas de modelo, em vez das duas ou três que o piloto presumia. As três alavancas abaixo são a forma de impedir que isso aconteça com você.
Alavanca 1: Cache, para Não Pagar Duas Vezes pelo Mesmo Contexto
Cada execução de agent reenvia um bloco de contexto que quase não muda de uma chamada para a outra: o system prompt, os schemas das ferramentas, um longo trecho da base de conhecimento, a conversa até aquele ponto. Cache significa que o provedor do modelo se lembra desse bloco e cobra uma fração do preço para reutilizá-lo, em vez de reprocessá-lo do zero.
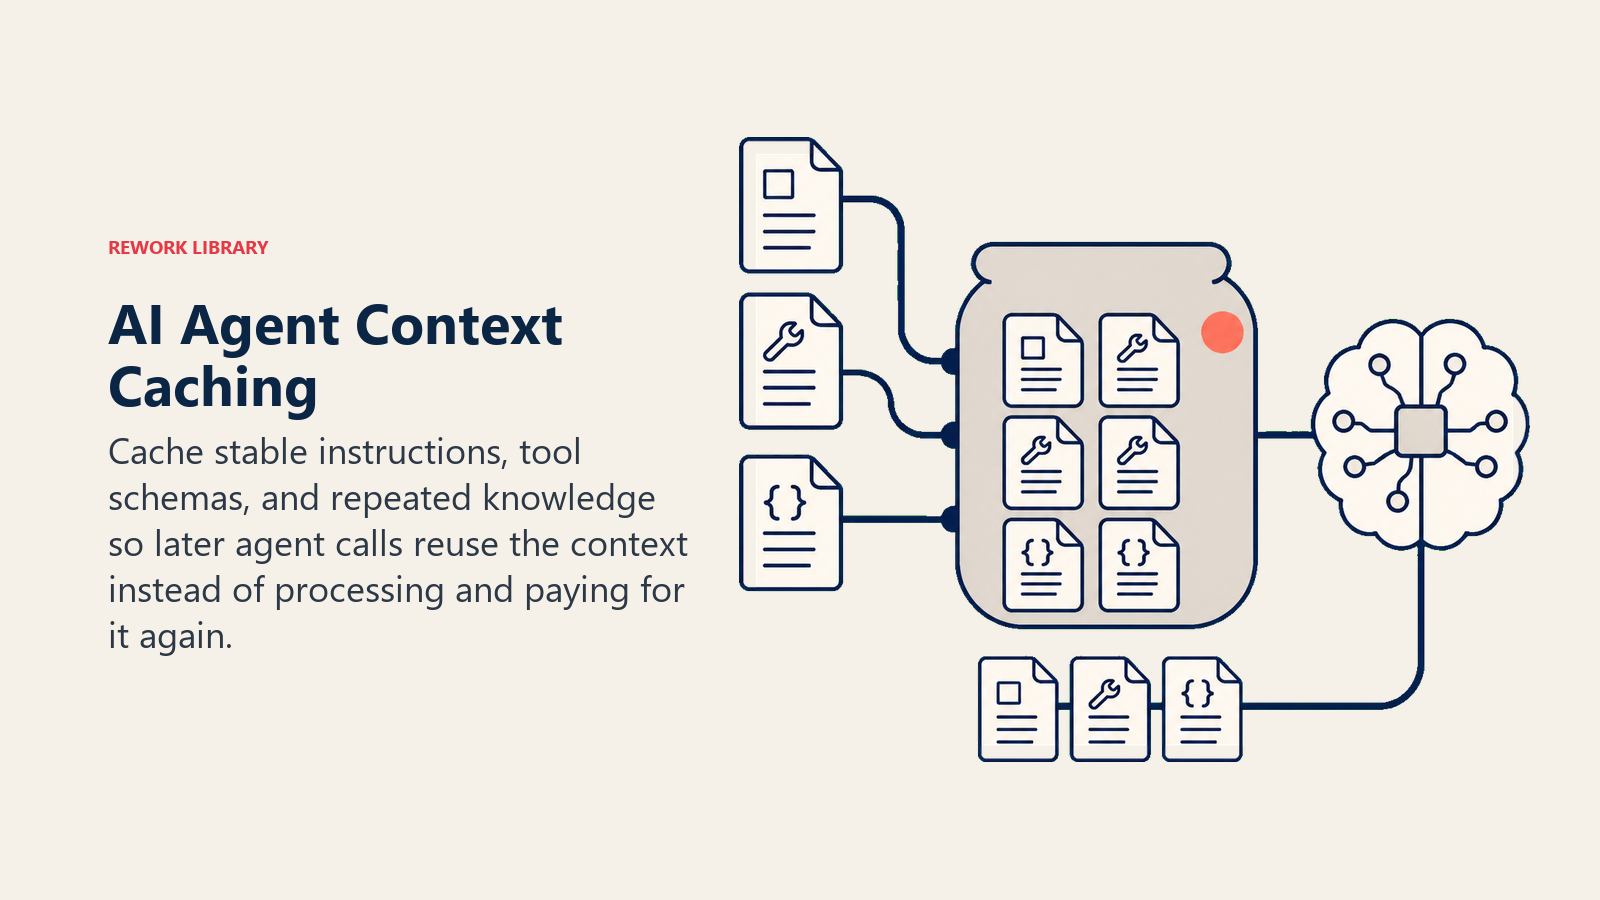
O desconto é real e é grande. A própria tabela de preços da Anthropic mostra que os tokens de entrada em cache custam 10% do preço base de entrada, uma redução de 90%, embora gravar conteúdo novo no cache custe 25% a mais do que uma chamada normal, então o cache compensa quando um prompt é reutilizado mais do que duas vezes. A OpenAI e outros grandes provedores oferecem a sua própria versão de descontos para tokens em cache; o mecanismo exato varia conforme o fornecedor, mas a economia é a mesma em todos eles. Para trabalhos que não precisam de resposta imediata (varreduras noturnas de higiene do CRM, classificação de documentos em lote, geração de relatórios durante a madrugada), a Batch API da Anthropic acrescenta um desconto separado: 50% abaixo do preço padrão em troca de processamento assíncrono em vez de resposta ao vivo.
Dois padrões de cache valem ser incorporados a um agent desde o primeiro dia:
- Cache de contexto: armazene em cache o system prompt, as definições de ferramentas e qualquer documento de referência estático grande (um arquivo de políticas, um catálogo de produtos), para que apenas as partes que realmente mudam entre as chamadas sejam cobradas a preço cheio.
- Cache de respostas: para perguntas realmente repetidas (o mesmo FAQ, a mesma classificação em entradas quase idênticas), pule a chamada de modelo por completo e entregue uma resposta armazenada, atualizada em um cronograma em vez de regenerada a cada vez.
Alavanca 2: Roteamento de Modelos, para que Passos Fáceis Não Paguem Preço de Ponta
Nem todo passo do loop de um agent precisa do seu modelo mais capaz e mais caro. Classificar um ticket, extrair um campo de um formulário ou verificar se um caso corresponde a um cenário conhecido é um trabalho diferente de redigir uma resposta sofisticada ao cliente ou raciocinar sobre uma exceção ambígua, e os preços publicados de API em todos os grandes provedores mostram uma diferença de ordem de grandeza, muitas vezes de 10x ou mais, entre um modelo pequeno e rápido e um modelo de ponta.
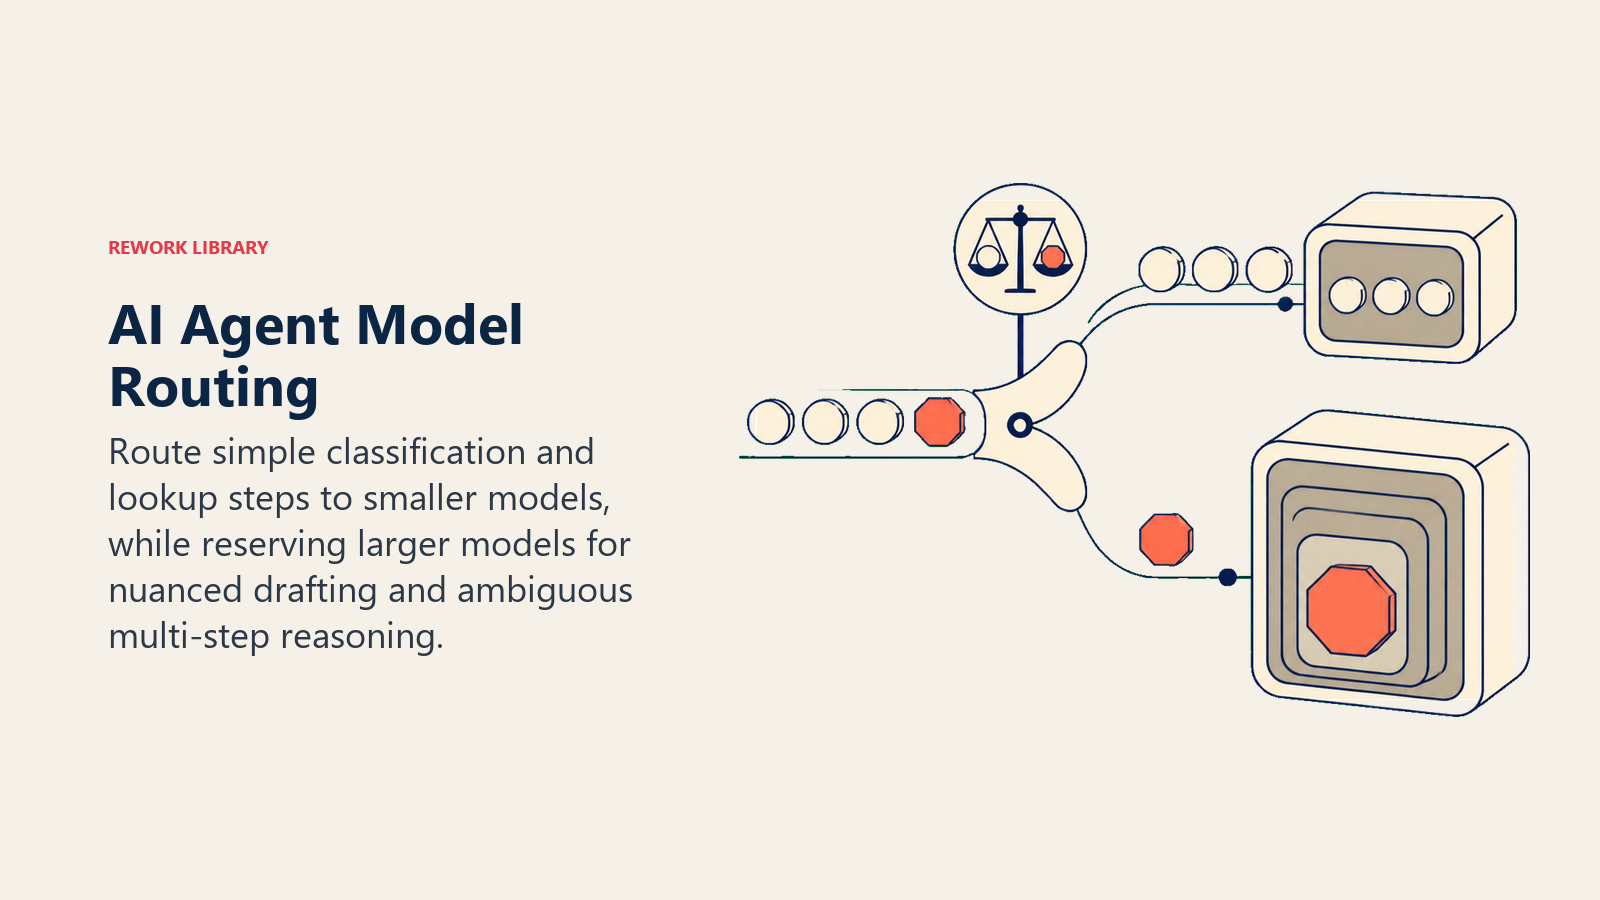
Roteamento de modelos significa combinar o passo com o modelo, em vez de rodar o agent inteiro em uma única faixa por padrão. Quando os padrões de IA ficam caros em escala documenta essa mesma ideia em sua seção de custos do Workflow Copilot: encaminhar solicitações de sugestão mais simples para modelos mais baratos e reservar a inferência premium para as solicitações que realmente precisam dela. Uma tabela de roteamento simples para um agent típico:
| Tipo de passo | Exemplo | Faixa de modelo |
|---|---|---|
| Classificação, extração, decisões de roteamento | Em qual fila este ticket se encaixa? | Pequeno, rápido, barato |
| Consultas estruturadas e correspondência de regras | Esta fatura corresponde a um pedido de compra aprovado? | Pequeno a médio |
| Redação de texto voltado ao cliente | Escreva a resposta para este caso específico | Médio a grande |
| Exceções ambíguas e raciocínio em várias etapas | Este caso não corresponde a nenhum cenário do playbook | O maior disponível |
O bloco de construção de lógica de decisão, que decide se um agent age, pergunta ou transfere, é o mesmo lugar a que pertence o roteamento de modelos. Você já está ramificando a lógica por tipo de caso. Encaminhe a escolha do modelo por esse mesmo ramo, em vez de tratá-la como uma decisão separada.
Alavanca 3: Orçamentos Rígidos, para que uma Tarefa Descontrolada Não Estoure a Conta
Cache e roteamento reduzem o preço por chamada. Os orçamentos limitam quantas chamadas uma única tarefa pode fazer, e isso importa porque os grandes estouros de custo raramente vêm do preço por chamada. Vêm de uma tarefa que continua chamando o modelo muito mais vezes do que alguém planejou.
Quando os padrões de IA ficam caros em escala diz isso sem rodeios: um Autonomous Agent sem limites rígidos de iteração e sem orçamentos de tokens por tarefa é um passivo financeiro, e não uma ferramenta de produtividade. A solução são duas configurações, ambas simples de enunciar e fáceis de pular: um número máximo de chamadas de modelo por tarefa e uma transferência automática para um humano quando a tarefa atinge esse limite, em vez de continuar gastando. Nenhuma das duas é algo desejável que você acrescenta depois do primeiro mês caro. Elas pertencem ao lado de todos os outros limites rígidos de que um agent precisa. Os guardrails de AI agents tratam em profundidade dos guardrails de saída e de chamadas de ferramentas, e um limite de orçamento é exatamente esse tipo de guardrail: uma regra que vale independentemente de quão confiante o agent esteja de que mais uma chamada vai concluir o trabalho.
Onde Isso Aparece em Agents Reais
Essas alavancas não são abstratas. Alguns lugares desta biblioteca em que acertar, ou errar, tem um efeito desproporcional na conta:
- AI Research Agent: o custo escala diretamente com quantas fontes ele traz para o contexto por briefing. Delimitar o número de fontes e encaminhar a etapa de síntese para um modelo de faixa intermediária, em vez do maior disponível, costuma ser a diferença entre um briefing de US$ 2 e um de US$ 20.
- AI Knowledge Base Agent: os mesmos documentos de políticas e trechos de FAQ são recuperados em centenas de perguntas semelhantes, o que o torna um dos lugares de maior retorno para armazenar contexto em cache, em vez de reenviar os mesmos trechos recuperados a cada consulta.
- AI Support Triage Agent: o alto volume de chamadas faz com que até uma pequena economia por chamada se multiplique rápido. Encaminhar a etapa inicial de classificação para um modelo pequeno e reservar um maior para redigir a resposta evita que o volume se torne o orçamento inteiro.
Um Modelo de Custo Simples Antes de Escalar Além do Piloto
Antes de levar um agent de um piloto pequeno ao volume real, coloque números aproximados em quatro itens: média de tokens por chamada (meça, não adivinhe), volume esperado de chamadas em escala de produção, a premissa de taxa de acerto do cache e a divisão do roteamento entre as faixas de modelo. Multiplique tudo em 2x e 5x o volume do piloto, e não apenas no volume do piloto, porque os pilotos rodam nos casos mais fáceis e representativos e a produção não. Quando os padrões de IA ficam caros em escala recomenda acrescentar uma margem de 50% a 100% ao que suas amostras sugerirem, exatamente por esse motivo.
O outro número que vale modelar cedo é o custo em relação ao resultado, e não em relação à atividade. Medindo o ROI de padrões de IA aprofunda esse enquadramento: um agent mais barato que falha em metade das tarefas não é de fato mais barato quando você conta o tempo humano gasto limpando a bagunça que ele deixa. E amplie a visão mais um nível: a inferência do agent é um item de linha dentro do quadro mais amplo do custo total de propriedade de IA, que também inclui talentos, integração e governança, então acertar essa alavanca não significa que o restante do orçamento de IA se resolve sozinho.
Acompanhando o Custo Depois do Lançamento
A otimização no lançamento se desvia sem monitoramento depois dele. A observabilidade de AI agents já indica a métrica que mais importa aqui: custo por tarefa concluída, e não custo por execução, porque uma execução que falha também gastou tokens, e uma execução barata que falha duas vezes antes de ter sucesso não é de fato barata. Acompanhe esse número junto com a taxa de acerto do cache e a distribuição por faixa de modelo, e preste atenção quando qualquer um dos três se desviar: custo por tarefa concluída em alta, taxa de acerto do cache em queda ou uma migração para a faixa cara em tipos de passo que antes eram roteados para a barata. Qualquer um dos três costuma ser o sinal mais precoce de que algo nas entradas ou no comportamento do agent mudou, bem antes de a fatura avisar.
Se você está comparando plataformas para construir ou executar agents, vale pontuar explicitamente a previsibilidade de custo em vez de presumir que ela é semelhante entre os fornecedores. Nossas comparações de ferramentas de IA avaliam as plataformas além das listas de recursos, e o scorecard de avaliação de fornecedores SaaS oferece um modelo ponderado para colocar a previsibilidade de custo em pé de igualdade com a capacidade ao pontuar as opções.
Key Facts
- Os tokens de entrada em cache custam 90% menos do que o preço padrão de entrada nos modelos da Anthropic (10% do preço base para ler do cache), enquanto gravar conteúdo novo no cache custa 25% a mais, então o cache compensa em tudo que for reutilizado mais de uma ou duas vezes.
- O processamento em lote para trabalho de agent que não é em tempo real acrescenta um desconto separado de 50% sobre o preço padrão da API.
- A Gartner prevê que mais de 40% dos projetos de agentic AI serão cancelados até o fim de 2027, com custos crescentes entre as principais causas citadas.
- Os preços publicados de modelos nos grandes provedores costumam mostrar uma diferença de ordem de grandeza entre modelos pequenos e rápidos e modelos de ponta, o que faz do roteamento por dificuldade da tarefa a alavanca de maior impacto que a maioria das equipes ainda não usou.
- O controle financeiro que mais importa para um agent em loop é um limite rígido de chamadas de modelo por tarefa com transferência automática quando ele é atingido, e não um preço menor por chamada.
Perguntas Frequentes sobre a Otimização de Custos de AI Agents
O que é a otimização de custos de AI agents?
É o conjunto de técnicas que mantém o gasto de tokens e de computação de um agent proporcional ao que ele entrega: armazenar em cache o contexto repetido para não pagar para reprocessá-lo, encaminhar os passos fáceis para modelos mais baratos e os difíceis para modelos mais capazes, e limitar quanto uma única tarefa pode gastar antes de passar para uma pessoa.
Por que os AI agents custam mais para operar do que uma única chamada de modelo?
Um agent executa um loop, perceber, raciocinar, agir, observar e repetir, e cada passagem pode disparar a própria chamada de modelo ou de ferramenta. Uma tarefa que exige uma chamada em um caso simples pode exigir muitas mais em um caso mais difícil, então o custo se acumula com o número de iterações de uma forma que uma única chamada de modelo nunca faz.
Qual é a diferença entre cache e roteamento de modelos?
O cache reduz o custo de reutilizar um contexto que você já enviou ao modelo, muitas vezes em 90% ou mais na parte armazenada. O roteamento de modelos reduz o custo ao combinar cada passo com o modelo mais barato capaz de executá-lo bem, em vez de rodar todos os passos no seu modelo mais caro por padrão. São complementares, não alternativas.
Quanto essas técnicas realmente podem economizar?
Depende da sua combinação de contexto repetido, volume de chamadas e complexidade das tarefas, mas os descontos de base são substanciais: 90% de desconto nos tokens de entrada em cache, 50% no processamento em lote e, em geral, uma diferença de preço de ordem de grandeza entre modelos pequenos e de ponta nos passos que não exigem raciocínio de ponta.
Qual é um limite de orçamento razoável para uma tarefa de agent?
Não existe um número universal, pois depende da complexidade da tarefa, mas o princípio é universal: defina um número máximo de chamadas por tarefa e transfira automaticamente para um humano quando ele for atingido, em vez de deixar o agent continuar tentando indefinidamente. Trate-o como um guardrail, e não como uma sugestão.
Para Onde Ir Agora
Cache, roteamento e orçamentos controlam quanto um agent custa. A observabilidade de AI agents é como você confirma que esses controles continuam funcionando depois do lançamento, já que o custo por tarefa concluída é um dos sinais mais claros e precoces de desvio. Se você ainda não modelou por que os custos escalam em grande escala, quando os padrões de IA ficam caros em escala é a leitura mais aprofundada, e como construir um AI agent mostra onde os limites de orçamento se encaixam entre os demais guardrails de um agent.

On this page
- Por que a Curva de Custo de um Agent Não É a de um Modelo
- Alavanca 1: Cache, para Não Pagar Duas Vezes pelo Mesmo Contexto
- Alavanca 2: Roteamento de Modelos, para que Passos Fáceis Não Paguem Preço de Ponta
- Alavanca 3: Orçamentos Rígidos, para que uma Tarefa Descontrolada Não Estoure a Conta
- Onde Isso Aparece em Agents Reais
- Um Modelo de Custo Simples Antes de Escalar Além do Piloto
- Acompanhando o Custo Depois do Lançamento
- Key Facts
- Para Onde Ir Agora