AIエージェントをいつ使うべきか(そして、いつ使うべきでないか)
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
ほとんどのAIエージェントプロジェクトが失敗するのは、モデルが弱いからではありません。初日からそのプロセスとの相性が悪かったから失敗するのです。誰かが人間の判断を必要とする作業にエージェントを当てはめたり、どのシステムも実際には読み取れないデータの上で走らせたり、一度の誤った行動が1年分の節約分よりも高くつくステップを自動化したりしています。技術はきちんと機能していました。そこでそれを使うという判断こそが間違いだったのです。
このページは売り込みではなく、準備度を測るフレームワークです。「はい、ここにはエージェントが合う」というシグナル、「いいえ、これは人間に任せておくべき」というシグナル、10分で実行できるチェックリスト、そしてリターンが本物かどうかを見積もるシンプルな方法を示します。何かを構築する前に使ってください。
一行で分かる適合基準
AIエージェントがプロセスに適しているのは、そのプロセスが繰り返し可能で、ルールに基づいており、たまに間違えても安価で済む場合です。この3つすべてが真であれば、エージェントはおそらくそれを担えます。どれか一つでも偽であれば、それが真になるまで範囲を絞り込むか、人間を担当のままにしておくかのどちらかです。
以下のすべては、この一文をより丁寧に言い換えたものにすぎません。
適合シグナル(青信号)
コミットする前に、これらを探してください。チェックが多いほど、その根拠は強くなります。
- 繰り返しの量。 同じ種類のタスクが週に何十件、何百件と発生する。同じ5つのインバウンドの質問に答える担当者、同じ請求書項目を入力するAP事務員、「注文はどこですか」であふれたサポートキュー。量こそが、タスク一件あたりのわずかな節約を本物の数字に変えるものです。
- 明確な成文化されたルール。 よくあるケースをどう処理すべきか平易な言葉で説明でき、二人の人間が同じように対応できる。そのルールが一人のベテランの頭の中にしかないなら、まずそれを書き出してから判断してください。
- 構造化された、あるいはアクセス可能なデータ。 エージェントが必要とする事実が、CRMのフィールド、注文レコード、ナレッジベース、整理されたドキュメントなど、エージェントが読み取れる場所にある。エージェントは、自分が見られるものの範囲でしか優秀になれません。
- 許容できる誤りのコスト。 一つ間違えたとしても、大惨事にならずに気づいて直せる。タグ付けを間違えたチケットは安く済みます。誤った送金は違います。
- きれいな人間への引き継ぎ経路。 エージェントが自信がないときにルーティングする明確な人間かキューがあり、彼らは素早く行動できるだけの十分なコンテキストを得られる。うまく引き継げないエージェントは、単独で運用する準備ができていません。
不適合シグナル(赤信号)
これらのうちどれか一つでも当てはまれば、そこで立ち止まるべきです。あるいは、そのシグナルが消えるまでエージェントの担当範囲を縮小すべきです。
- すべてのケースに判断が必要。 「よくあるケース」が存在せず、それぞれが人間による状況判断を必要とする一つずつ異なる事例の連続しかない場合、エージェントには標準化できるものが何もありません。推測に頼ることになり、その推測こそが失敗のパターンです。
- まだ成文化されたルールがない。 仕事をどう進めるべきか誰も言えないなら、エージェントにもできません。ルールの欠如はAIの問題ではなく、プロセスの問題です。まずそれを直してください。
- 重大で取り返しのつかない行動。 送金する、契約に署名する、レコードを削除する、取り消せないものを送信するなど。エージェントが下書きを作る場合であっても、これらは人間の承認ゲートの背後に置くべきです。下書きすることと実行することの境界線こそが、すべての鍵を握っています。この違いがなぜそれほど重要なのかは、生成と実行の境界線の解説で扱っています。
- 雑然とした、あるいは欠落したデータ。 レコードが重複していたり、古かったり、半分空だったり、エージェントが手を伸ばせない場所にしまい込まれていたりすると、エージェントはそれらの問題をすべて引き継いでしまいます。データの準備状況は、たいてい本当の最初のステップであり、「ツールを選ぶ」ことではありません。
- 所有者が不明確。 成果を所有する人間が誰もおらず、エージェントが間違えたときに責任を負う人もいないなら、それは出荷すべきではありません。所有者のいない自律性は、小さなミスが静かに積み重なっていく原因になります。
適合と不適合をひと目で見比べる
エージェントに向いている作業は繰り返し可能でルールに基づき、データにアクセスでき、取り消しが可能です。不向きな作業は一つ限りで、判断を要し、不透明で、取り消しがききません。
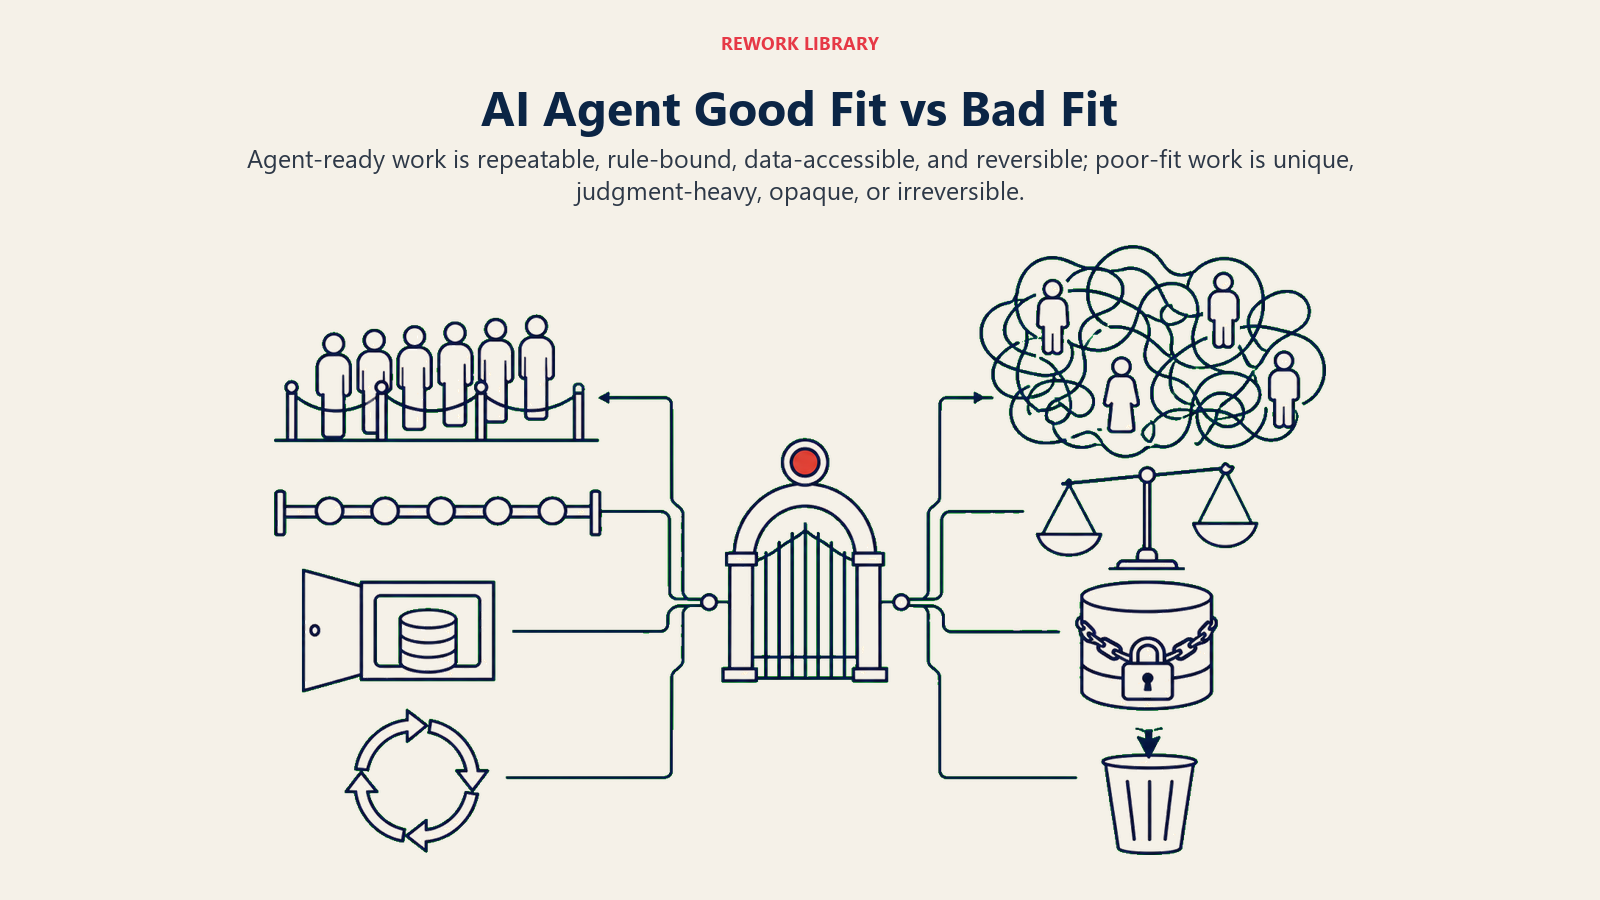
| 観点 | エージェントに適合 | 不適合、人間に任せる |
|---|---|---|
| タスクの形 | 頻繁に繰り返され、同じパターン | 一度限りで、それぞれのケースが固有 |
| ルール | 成文化されており、人によって一貫している | 誰かの頭の中にしかない、または存在しない |
| データ | 構造化されており、エージェントが読み取れるシステムにある | 雑然としている、サイロ化している、または欠落している |
| 誤りのコスト | 気づいて直すのに安価 | 高くつく、または取り返しがつかない |
| 判断 | まれにしか必要なく、境界線上でのみ | ほぼすべてのケースで必要 |
| 引き継ぎ | 明確な所有者と、引き継ぎ時の十分なコンテキストがある | 明確な所有者がいない、責任の所在がない |
あなたのプロセスがおおむね左の列に収まるなら、構築してください。両方にまたがるなら、範囲を絞り込んでください。繰り返し可能な部分をエージェントに任せ、判断が必要なケースは人に回します。そのハイブリッドが、たいてい正しい答えであり、完全な自律性でもゼロでもありません。
準備度チェックリスト
構築範囲を決める前にこれを実行してください。「はい」の答えが多いことを目指します。「いいえ」の一つひとつが、待つべき理由か、先にやっておくべき宿題です。
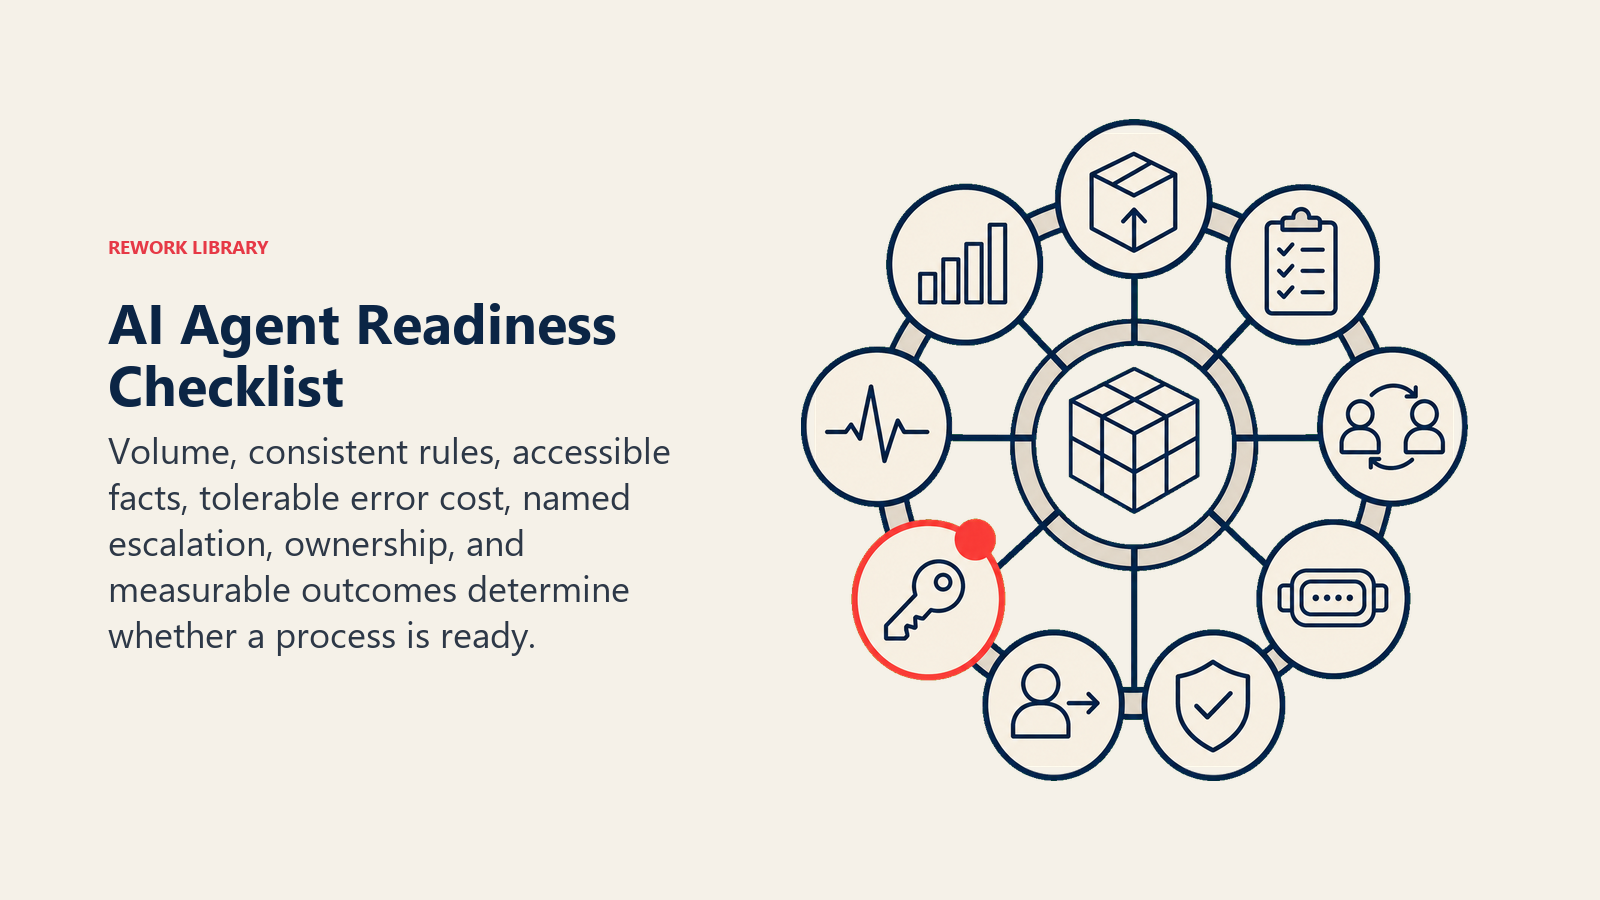
- このタスクは少なくとも週に20回発生していますか?(意味を持つだけの量があるか)
- よくあるケースのルールを1ページ以内で書けますか?
- 経験豊富な2人が、よくあるケースを同じように処理していますか?
- エージェントは、人の記憶ではなくシステムから必要な事実をすべて読み取れますか?
- 一度の誤った行動のコストは低いか、人間の承認によってゲートされていますか?
- 引き継ぎ先として名前のある人間かキューがあり、行動できるだけのコンテキストがありますか?
- 誰かがその成果を所有し、それで評価されていますか?
- すでに追跡している(あるいは追跡を始められる)数値で成功を測れますか?
「はい」が6つ以上:構築範囲を決める準備ができています。3つから5つ:「いいえ」だった項目を先に直してください。そうしないとプロジェクトを沈めます。2つ以下:これはまだエージェントの問題ではありません。AIの衣をまとった、プロセスかデータの問題です。
シンプルなROIの枠組み
12個のタブがあるスプレッドシートは必要ありません。必要なのは3つの数字と一つの正直な推測です。
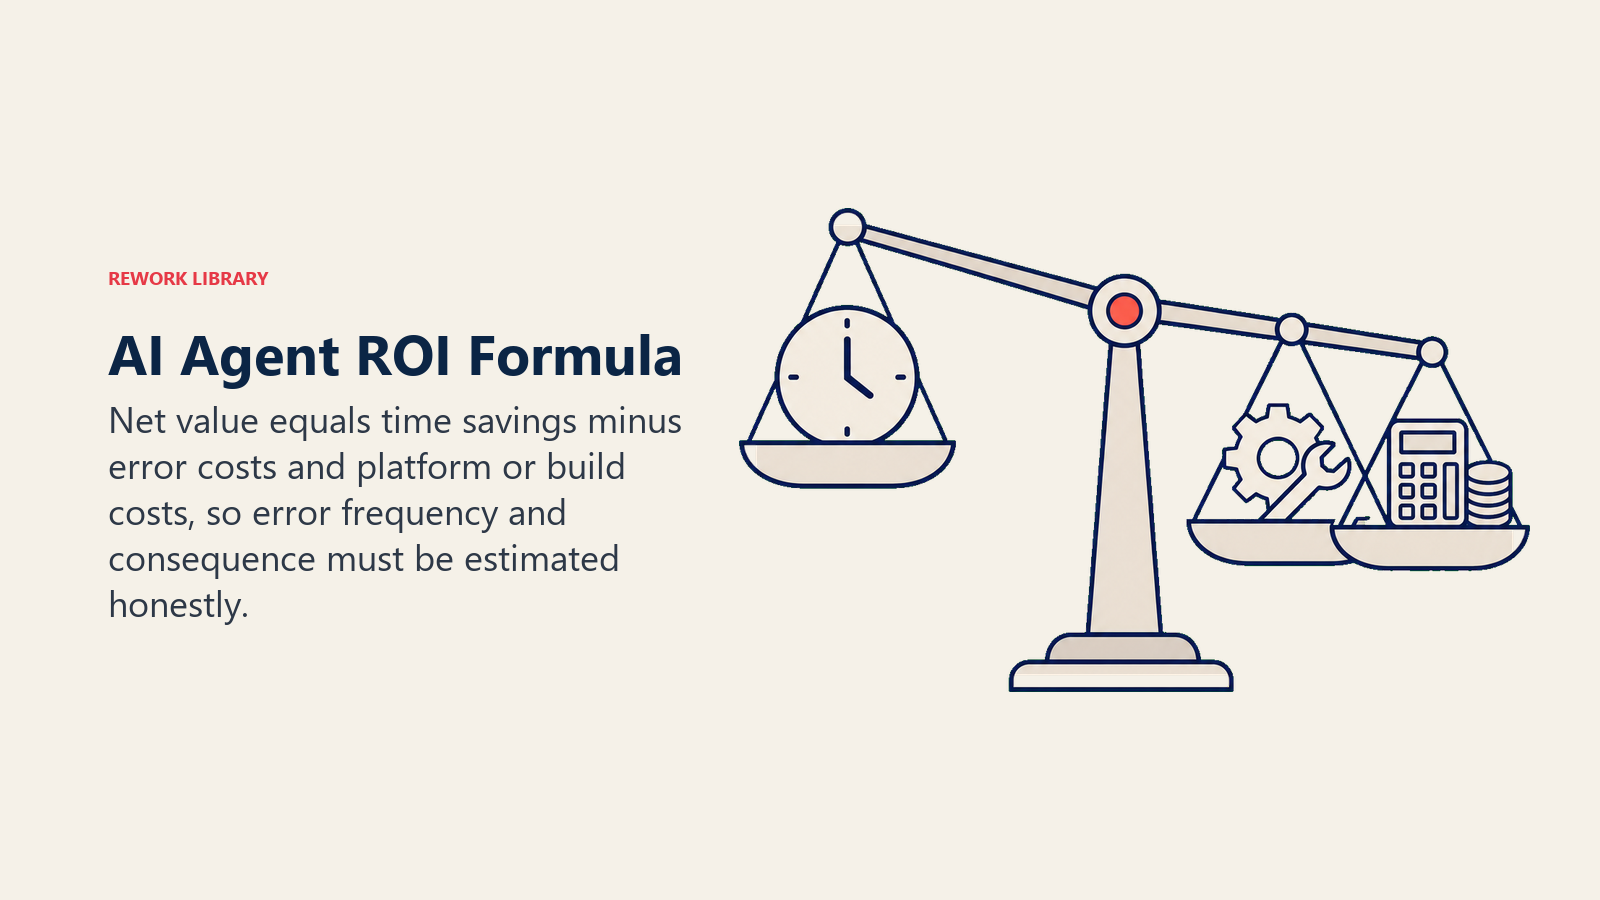
年間の総節約額 = 件数 × タスクあたりの節約時間 × フルコストベースの時給
年間のタスク件数に、エージェントが一件あたり削減する分数を掛け、時間に換算し、その人の時間が実際にいくらかかっているか(諸経費込みの給与で、基本給だけではない)を掛けます。それが上限です。
そこから、誤りのコストを差し引きます。
正味の価値 = 総節約額 − (エラー率 × 件数 × エラー一件あたりのコスト) − プラットフォームおよび構築コスト
エラー項目は人々が見落としがちなものであり、それこそが見た目の良いプロジェクトを不採算のものへとひっくり返す項目です。1万件のタスクで一件あたり5分節約するエージェントは、素晴らしく見えます。しかし、それぞれの誤りの後始末に1時間かかり、4%の確率で間違えると分かるまでの話です。それは400件のエラーと400時間の手戻りを意味し、節約分をまるごと消し去りかねません。
大まかな数字での試算例です。
| 項目 | 値 |
|---|---|
| 年間のタスク件数 | 26,000件(週500件) |
| タスクあたりの節約時間 | 4分 |
| フルコストベースの時給 | $45 |
| 年間の総節約額 | 約$78,000 |
| エラー率 | 3% |
| エラー一件あたりのコスト(手戻り) | $30 |
| 年間のエラーコスト | 約$23,400 |
| プラットフォームおよび構築費(初年度) | $25,000 |
| 初年度の正味価値 | 約$29,600 |
大事なのは正確な数字そのものではありません。エラー率とエラー一件あたりのコストが、そのプロジェクトをやる価値があるかどうかを決めるということです。だからこそ、構築した後ではなく前に、正直にそれらを見積もってください。エラーのコストが許容できないなら、それは人間の承認ゲートを加えるべきだという赤信号であり、それは節約時間の数値も変えます。数学と適合シグナルは、同じ話をしているのです。
一つのタスクだけでなく、複数のケイパビリティにまたがってリターンを測るより広い視点については、AIトランスフォーメーション戦略の姉妹コレクションで、ポートフォリオレベルのROIをさらに掘り下げています。
ベンチマークが実際に語っていること
期待値を設定するときに覚えておく価値のある数字が2つあります。
Gartner(2025年3月)は、2029年までにagentic AIが一般的なカスタマーサービス案件の80%を人間の介入なしに自律的に解決し、運用コストを30%削減すると予測しています。ここは注意して読んでください。「一般的な」案件と書かれています。この80%とは繰り返し可能でルールに基づく部分のことであり、これはまさにこのページが説明している適合ゾーンです。残りの20%は、人間に任せておくべき判断が必要な作業です。
プラス面では、マッキンゼーは、成熟した導入においてマーケティングと営業のAIがリードを50%以上押し上げ、プロスペクティングのコストを最大60%削減できると報告しています。「成熟した」という言葉に注目してください。これらの数字は、適合とデータが整った後に現れるものであり、初日から出るものではありません。導入初期はベンチマークをかなり下回るところから始まり、調整を重ねるにつれてその差を縮めていきます。
どちらの統計も同じ方向を指しています。エージェントはプロセスの繰り返し可能な中核部分で成果を上げ、適合度が高まるほどリターンも大きくなります。どちらも「すべてを自動化せよ」とは言っていません。
構築するか、買うか
プロセスが準備度テストに合格した後も、そのエージェントをどう手に入れるかを決める必要があります。速さの順に、おおよそ3つの道があります。
- 構築済みのツールを買う。 ベンダーがすでにあなたの業務にぴったり合うものを提供している場合(サポートトリアージ、会議メモ、AP自動化など)、最速で価値にたどり着けます。柔軟性の一部と引き換えに、走り出す速さを手に入れます。プロセスが企業間で標準化されている場合に最適です。
- プラットフォーム上で組み立てる。 ローコードのエージェントビルダーや業務フローツールを使って、CRM、受信箱、データソースを、あなたが設定するエージェントへとつなぎ込みます。中間の道であり、パッケージ化されたツールよりも制御が効き、コードを書くよりはるかに手間がかかりません。ルールは独自だが、配管部分は共通というときに最適です。
- カスタムで構築する。 エージェントが本物の競争優位であり、既製のものが何も合わない場合は、自分で連携の仕組み全体を設計します。上限は最も高く、コストも最も高く、メンテナンスをずっと自分で背負うことになります。正当化されるのはまれで、たいていはエージェント自体が製品そのものである場合だけです。
デフォルトは買うか組み立てるかです。多くのチームは「構築する」に早すぎるタイミングで手を伸ばし、本番環境でエージェントを所有し続ける継続コストを過小評価しています。このライブラリの姉妹ブループリントのうち2つがすでにあなたの機能を説明しているなら、たとえばAI SDRエージェントやAI Reply Agentのように、白紙のファイルからではなく、それらのいずれかの設定済みバージョンから始めてください。
まずは小さく、それから広げる
最も安全な展開方法は「エージェントがプロセス全体を運用する」ではありません。段階を踏んだ立ち上げです。
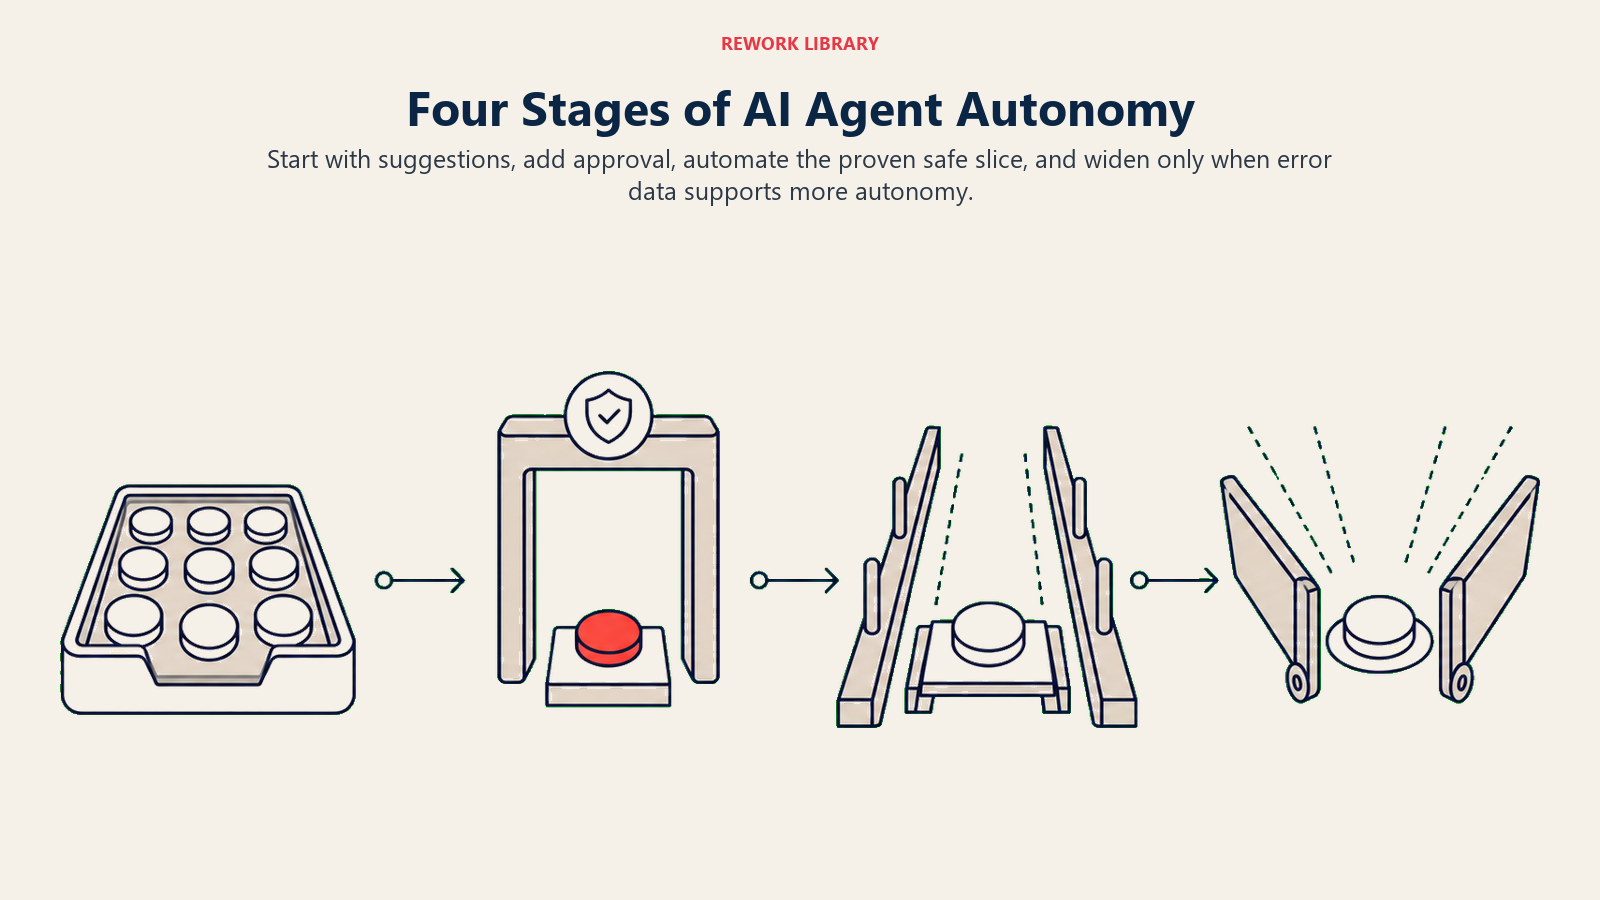
- 提案する。 エージェントが下書きを作り、人間が送信します。リスクゼロで、どこが正しく、どこがずれるのかを学べます。
- 承認付きで行動する。 エージェントが作業を行いますが、外部に触れるものについては、人間によるワンクリックの承認を待ちます。
- 安全な範囲で行動する。 うまくいくと確認できたケースでは無人で走らせ、それ以外については承認ゲートを維持します。
- 範囲を広げる。 数字が裏付けられるにつれて、「承認」から「自動」へ移すシナリオを増やしていきます。エラーデータが正当化する以上の速さで範囲を広げないでください。
このランプは、不適合の判断に対するヘッジにもなります。ステップ1でエージェントがつまずいても、そのプロセスが準備できていなかったと学ぶために費やしたコストはほぼゼロです。それは、フル展開後にそれを発見するよりもはるかに安く間違える方法です。このパターンの最も自律性が高いバージョンとそのリスクについては、自律型エージェントパターンをご覧ください。
AIエージェントをいつ使うべきかに関するよくある質問
AIエージェントを使うべきでないのはどんなときですか?
ほぼすべてのケースで人間の判断が必要なとき、従うべき成文化されたルールがまだないとき、データが雑然としすぎているか、エージェントが読み取れない場所にしまい込まれているとき、あるいは一度の誤った行動のコストが高く、取り消せないときです。これらのうちどれか一つでも当てはまれば、人間をループの中に残すか、そのシグナルが消えるまでエージェントの担当範囲を縮小する理由になります。
エージェントを正当化するにはどれくらいの量が必要ですか?
厳密な下限はありませんが、目安として週あたり少なくとも20件の似たようなタスクという基準が有用です。それを下回ると、多くの場合セットアップと保守のコストが節約時間を上回ってしまい、軽量な自動化やテンプレートの方が、フルスペックのエージェントよりも役に立つかもしれません。
適合するプロセスと不適合なプロセスの違いは何ですか?
適合するプロセスは繰り返し可能で、明確なルールがあり、エージェントが読み取れるデータの上で動き、たまに間違えても安価です。不適合なプロセスは、すべてのケースで判断が必要か、成文化されたルールがないか、雑然としたデータの上で動くか、重大で取り返しのつかない行動を伴います。ほとんどの現実のプロセスは混合しているため、適合部分をエージェントに任せ、残りを人に回すのが正しい動きです。
自分でエージェントを構築すべきですか、それとも買うべきですか?
ほぼすべての標準的な機能については、プラットフォーム上で買うか組み立ててください。その方が速く、運用コストも安く済みます。カスタム構築は、エージェントが本物の競争優位であり、既製のものが何も合わない場合に限ります。多くのチームは「構築する」に早すぎるタイミングで手を伸ばし、本番環境でエージェントを所有するコストを過小評価しています。
構築前にROIをどう見積もればよいですか?
件数にタスクあたりの節約時間とフルコストベースの時給を掛けて総節約額を出し、そこからエラーコスト(エラー率×件数×エラー一件あたりのコスト)とプラットフォームおよび構築コストを差し引きます。エラー項目はほとんどの人が見落とすものであり、たいていそれがそのプロジェクトをやる価値があるかどうかを決めます。

Co-Founder, Rework.com