AI agentのファインチューニングとプロンプティング:使い分けの考え方
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
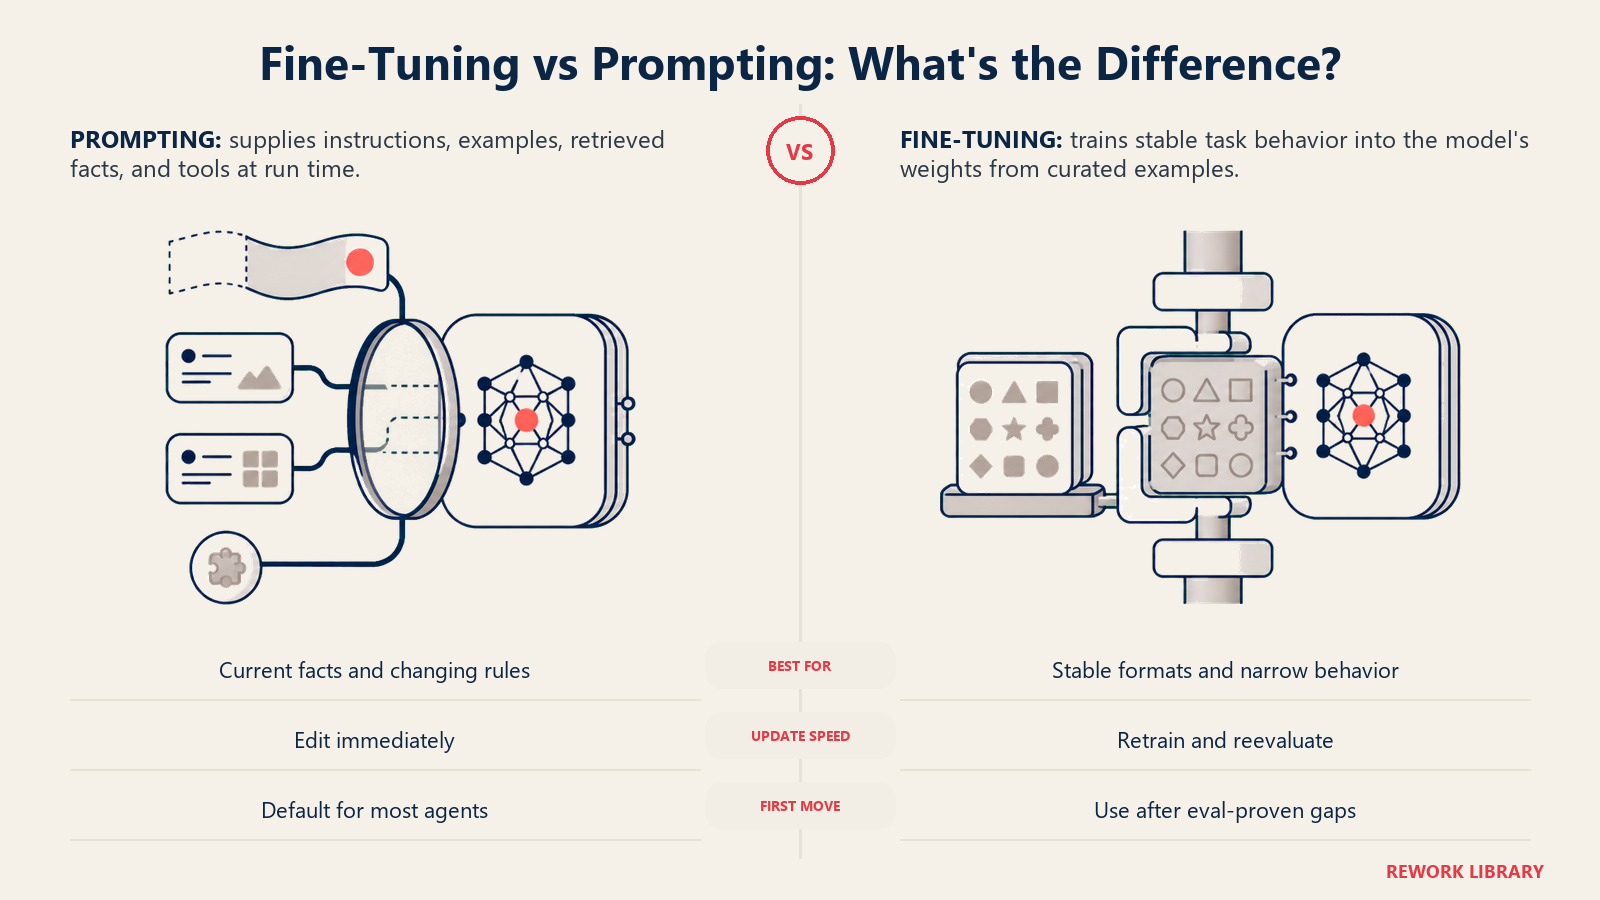
ファインチューニングとプロンプティングは、AIモデルを自社のビジネスに必要な振る舞いに近づけるという同じ課題を、まったく異なる仕組みで解決します。プロンプティング(RAGやツール利用を含む)は、指示、例、取得したコンテキストを通じて、モデルが動作する瞬間に振る舞いを形作ります。変更も展開も速いのが特長です。ファインチューニングは、追加の学習によって振る舞いをモデル自身の重みに組み込みます。変更には時間がかかりますが、特定のスキルや出力形式を、プロンプトよりも確実に定着させられます。ほとんどのAI agentでは、プロンプティングが適切な出発点であり、ファインチューニングは、プロンプティングでは本当に埋められない特定のギャップに対する限定的な手段です。
まず、それぞれが実際に何をするのかを整理する
ここでいう広義のプロンプティングとは、モデルを再学習させずに変更できるものすべてを指します。システムプロンプトとルール、few-shotの例、社内ドキュメントを取り込むretrieval-augmented generation、agentがライブのデータを確認するためのツール呼び出しです。プロンプトエンジニアリングは、その指示を上手に書く技術を扱い、retrieval-augmented generationは、agentが推測に頼らず自社の実データに基づいて回答する仕組みを扱います。どちらも推論時に、呼び出しのたびに、汎用のベースモデルを使って動作します。Anthropicのエンジニアリングチームは、この実践の現代版をコンテキストエンジニアリングと位置付けています。実際の複数ステップの仕事をこなせるagentを構築するうえで、プロンプトエンジニアリングが自然に進化した形であり、その理由は、どれも再学習を必要としないからだと説明しています。
ファインチューニングは、性質がまったく異なります。事前学習済みのモデルを、自社の例でさらに学習させ、モデルの重みを調整します。その結果、プロンプトで毎回お願いしなくても、ある振る舞いがほぼ自動的に現れるようになります。特定の種類の課題には強力ですが、それ以外の課題にはほとんど関係がありません。だからこそ、どちらを選ぶかの判断が重要になります。
基本方針:まずプロンプト、RAG、ツールから
OpenAIのファインチューニングに関するガイダンスは、進め方の順序について明快です。まず評価(evals)を整え、それが本当に役立っているかを測る手段を確立してから、ファインチューニングに投資するというものです。これは保険のための言い回しではなく、戦略そのものです。evalsがなければ、ファインチューニングしたモデルがよく書かれたプロンプトより優れているのかどうか判断できず、手間をかけて推測しているにすぎません。
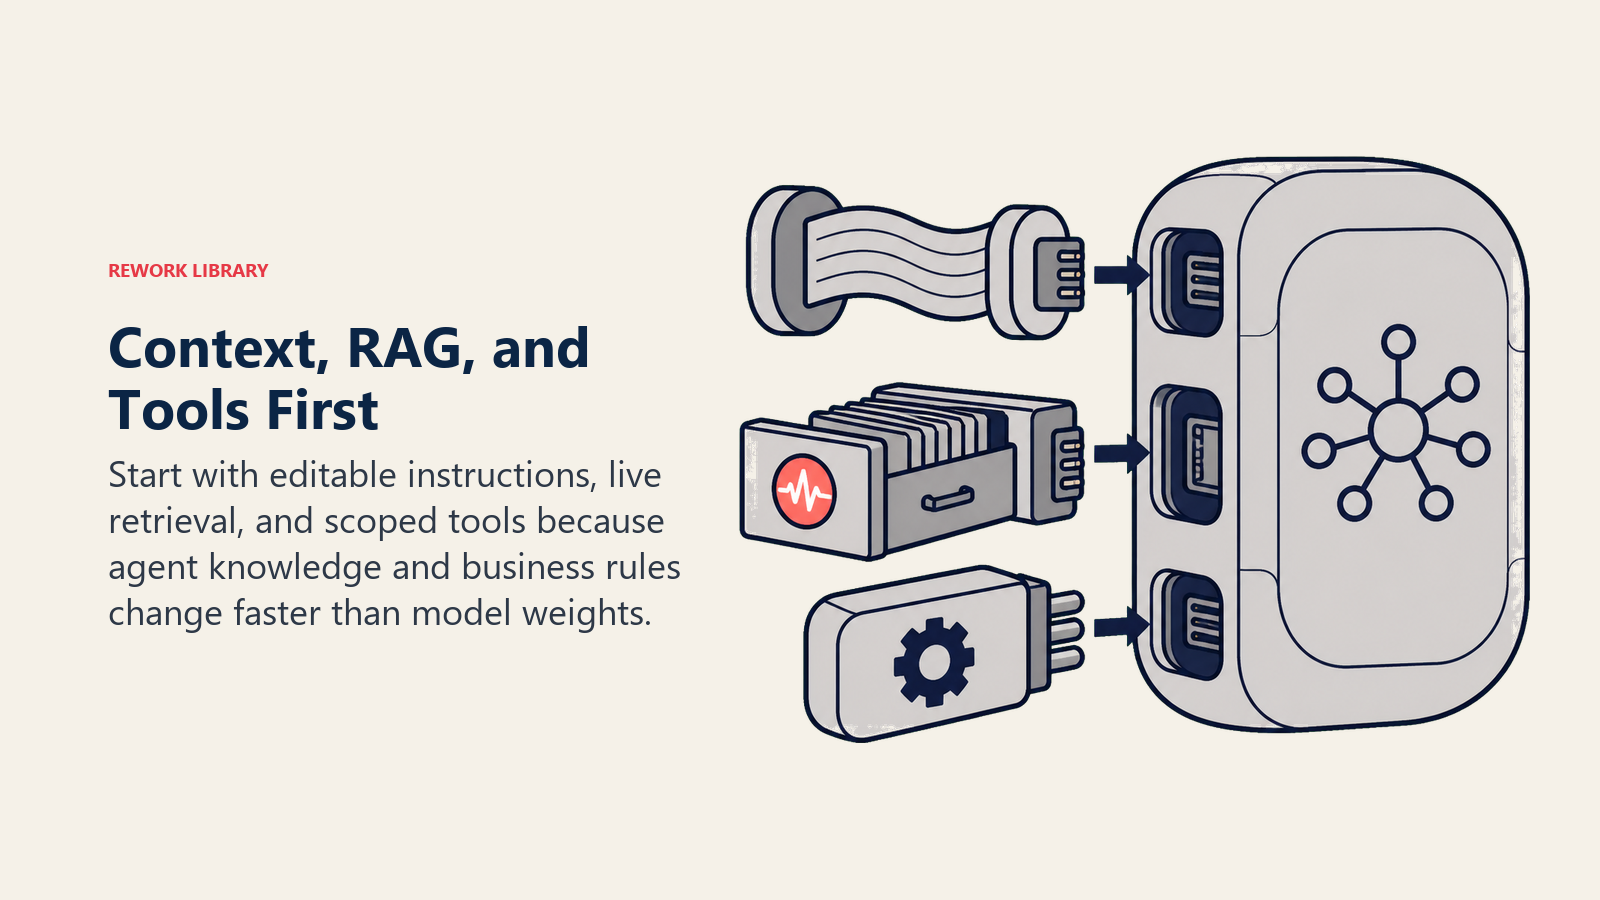
agentでプロンプティングを最初に選ぶ現実的な理由は、agentが正しく扱うべき内容の大半が、重みに焼き込むには変わる頻度が高すぎることです。ビジネスルールは更新されます。ポリシーは変わります。商品カタログは毎週のように入れ替わります。AI agentのためのRAGでもこの点を取り上げています。検索は質問が来た瞬間に情報源から読み取るため、次に誰かが質問したときには更新が反映されます。前四半期のポリシーを記憶したファインチューニング済みモデルは、ポリシーが変わった日に古くなります。しかも、ドキュメントやプロンプトを編集するのとは違い、再学習は当日中に済む対応ではありません。1回検索して回答するだけのモデルについては、RAG Assistantパターンで取り上げています。agentには通常、同じグラウンディングに加えて、見つけた情報に基づいて行動する能力が必要です。
ファインチューニングが本当に役立つ場面
ファインチューニングは時代遅れになったわけではなく、多くのチームが最初に手を伸ばすときに想定するよりも、狙う対象が狭いだけです。OpenAIのドキュメントは、一貫して効果があるケースとして、分類タスク、ニュアンスを要する翻訳、非常に特定の形式でのコンテンツ生成、そして、より良いプロンプトでも直らなかったモデルの指示追従の失敗の修正を挙げています。このリストに、一般知識や頻繁に変わる事実が入っていないことに注目してください。まさにプロンプティングとRAGのほうが得意な領域です。
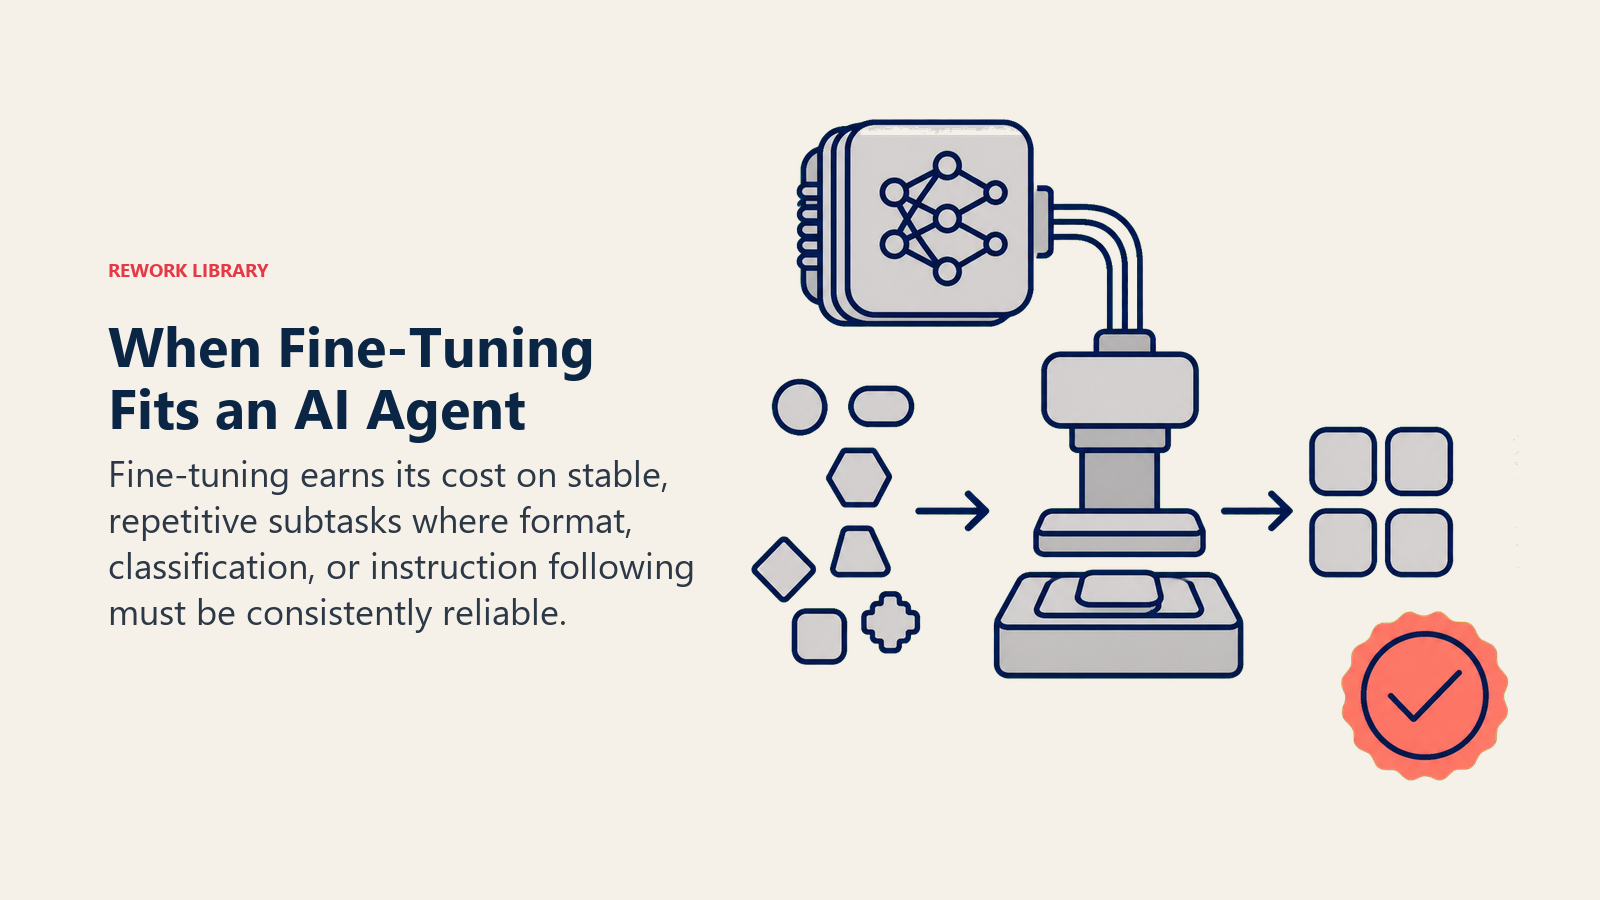
両者を分ける見方として、ファインチューニングはモデルに「どのように」応答するか(形式、トーン、限定的な分類の振る舞い、珍しい指示パターンを確実に守ること)を教えるのが得意です。一方、プロンプティングと検索は、「何を」応答するか(最新の事実、自社固有のポリシー、この顧客のアカウント履歴)を教えるのが得意です。agentの仕事は、文体として独特なテキストを生み出すことよりも、最新の情報に基づいて正しく行動することが中心なので、ほとんどの場合、前者より後者のほうが多く必要になります。
大きなagentの内部でも、ファインチューニングの最も一般的な正当な使い道は、agentの主要な推論ステップではありません。agent全体の頭脳ではなく、より大きなループの一部として動く、限定的で大量の処理を伴うサブタスクです。受信したチケットを適切なキューに分類するAI Support Triage Agentは、まさにそうした、一貫性があり、反復的で、大量に発生する分類業務です。同じ限定的なタスクを毎回プロンプトで処理する大規模な汎用モデルよりも、小さなファインチューニング済みモデルのほうが優れた成果を出せる場合があります。乱雑で書式が一定でないドキュメントから構造化されたフィールドを抽出するAI Document Processing Agentも同様です。どちらも知識の問題というより形式とパターンの問題であり、まさにファインチューニングの得意分野です。
判断フレームワーク
| 質問 | プロンプティング/RAG/ツールを示す場合 | ファインチューニングを示す場合 |
|---|---|---|
| 基盤となる知識は毎週または毎月変わるか | はい、検索が有利 | めったに変わらず、本当に安定している場合のみ |
| ギャップは不足している事実か、それとも誤った形式、トーン、振る舞いか | 不足している事実 | 誤った形式または振る舞い |
| 回答の出どころを引用または説明する必要があるか | はい、検索は追跡可能 | 重みは同じようには検証できない |
| 限定的で、大量かつ反復的なサブタスクか | 必ずしもそうではない | 多くの場合、最適 |
| よく書かれたプロンプトと適切な例をすでに試したか | 結果にかかわらず、まずこれを試す | これが本当に失敗した後に限る |
| 効果を測るevalsが整っているか | どちらの場合も整備する | 開始前に必須 |
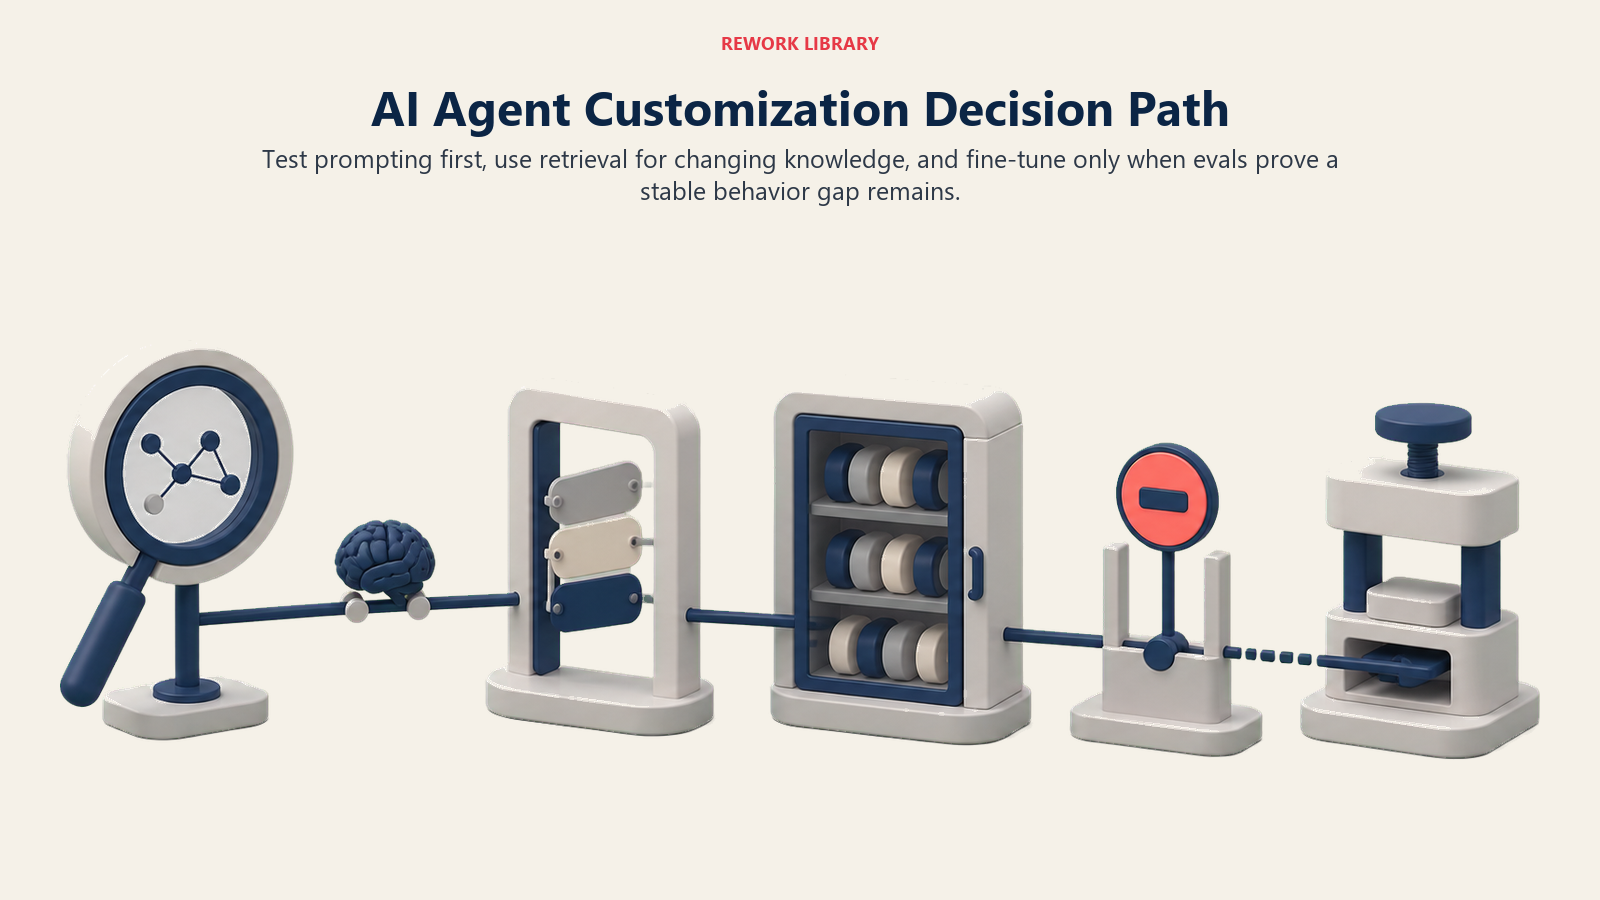
ほとんどの行は、ほとんどのagentで同じ方向を指しています。まずプロンプティングから始め、最新または自社固有の知識が必要なものには検索を加え、ファインチューニングは、実際にそれが最適な特定の行にだけ取っておきます。標準的なアップグレード経路として使うものではありません。
判断のコスト面
ファインチューニングは単なる技術的な選択ではなく、インフラへのコミットメントです。学習パイプライン、ビジネスの変化に合わせて維持が必要なラベル付きデータセット、ファインチューニング版が本当に優れているかを確認する評価、そして対象タスクがずれたときの再学習サイクルが必要になります。どれも無料ではなく、プロンプトの編集とは違って、最初の学習を終えたら消えてなくなるものでもありません。
このコミットメントは、agentic AIプロジェクトがモデル自体の性能とは無関係の理由で頓挫する頻度と照らして考える価値があります。Gartnerは、agentic AIプロジェクトの40%超が2027年末までに中止されると予測しており、主な原因として、コストの増大と不明確なビジネス価値を挙げています。より安価で速い方法でユースケースを実証する前にファインチューニングのパイプラインを構築することは、うまくいくかどうかも分からないプロジェクトに、コストと複雑さを上乗せする確実な方法です。この観点でプラットフォームを比較する場合、AIツールの比較ではモデルの素の品質だけでなくベンダーを評価しており、AIチャットボットプラットフォームの選び方ガイドでは、このプロンプティングとカスタマイズのトレードオフを購入者の立場から整理しています。
答えが本当に「両方」になるとき
ファインチューニングとプロンプティングは、agentシステム全体で排他的という意味ではありません。多くの種類のステップを扱う大規模なagentでは、限定的で反復的な分類ステップにはファインチューニング済みの小さなモデルを使い、最新の知識と判断が必要な推論や下書きのステップには、プロンプトとRAGで裏付けたフロンティアモデルを使うことが十分にあり得ます。AI agentの作り方では、あらゆるagentに必要な6つの構成要素を取り上げています。ファインチューニングとプロンプティングの選択は、一度だけ下す判断ではなく、そのステップが実際に何を必要とするかに基づいて、ステップごとに下す判断です。
Key Facts
- OpenAI自身のファインチューニングガイダンスは、「まず良いevalsを」から始まります。ファインチューニングが役立ったかを測る手段は、投資の後ではなく前に確立します。
- ファインチューニングは、分類、ニュアンスを要する翻訳、特定の出力形式、指示追従の失敗の修正に最も適しており、新しい知識や頻繁に変わる事実を教えるのには向いていません。
- 検索は質問の瞬間に情報源から読み取るため、更新がすぐに反映されます。ファインチューニング済みモデルは、最後の学習実行の時点までしか最新ではありません。
- agent内でのファインチューニングの最も一般的な正当な使い道は、チケット分類やドキュメントのフィールド抽出のような、限定的で大量のサブタスクであり、agentの推論プロセス全体ではなく、1つのステップとして動かします。
- Gartnerは、2027年までのagentic AIプロジェクト中止見込みの40%超の理由の一部を、コストの増大に求めています。ユースケースが実証される前にファインチューニングのパイプラインを構築すると、このリスクが現実になります。
AI agentのファインチューニングとプロンプティングに関するよくある質問
AI agentはファインチューニングすべきですか、それともプロンプトで対応すべきですか。
ほぼすべてのagentのユースケースで、まずプロンプティング、検索、ツールから始めてください。ファインチューニングを検討する価値があるのは、よく書かれたプロンプトと適切な例では、出力形式が安定しない、プロンプトでは何度やっても間違える分類タスクがある、といった限定的な問題が本当に解決しなかった後に限ります。
ファインチューニングとプロンプティングの主な違いは何ですか。
プロンプティングは、指示、例、取得したコンテキストを通じて、汎用モデルの振る舞いを動作する瞬間に形作るもので、変更が速いのが特長です。ファインチューニングは、自社のデータでモデルをさらに学習させ、重みを調整して振る舞いをほぼ自動化するものですが、更新に時間がかかり、継続的な学習と評価のパイプラインが必要です。
ファインチューニングでRAGの代わりにagentを最新に保てますか。
できません。ファインチューニングは学習時点の知識をモデルの重みに焼き込むため、元のドキュメントが変わった時点で古くなります。RAGは質問の瞬間にライブの情報源から取得します。そのため、定期的に変わる知識には、ファインチューニングではなく検索が適切なツールです。
どのようなagentのタスクがファインチューニングに向いていますか。
入力と出力の形が一貫している、限定的で大量かつ反復的なサブタスクです。チケットをキューに分類する、乱雑なドキュメントから構造化フィールドを抽出する、非常に特定のトーンや形式を確実に再現する、といったものです。通常は、大きなagentの中の1つのステップであり、agentの推論プロセス全体ではありません。
agent向けにモデルをファインチューニングするには、機械学習の専門知識が必要ですか。
良いデータセットがあり、限定的なタスクであれば、想像より少なくて済みます。ただし、ファインチューニング版がよく書かれたプロンプト版を上回ることを確認する、実際の評価プロセスは必要です。evalsを省略することは、ファインチューニングしたモデルが実際には優れておらず、ただ違うだけになってしまう最も一般的な原因です。
次に読むもの
プロンプティングと検索がagentの適切な出発点であるなら、AI agentのためのRAGで自社データに基づく仕組みを、AI agentの作り方で、その判断がagentの他の構成要素の中でどこに位置付くかを確認できます。コストがファインチューニングへ傾く理由の一部であるなら、AI agentのコスト最適化で、キャッシュとモデルルーティングという、学習パイプラインなしで同じ課題を解決できることの多い2つの手段を取り上げています。
