Bahasa Indonesia
Optimasi Biaya AI Agent: Caching, Model Routing, dan Anggaran
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
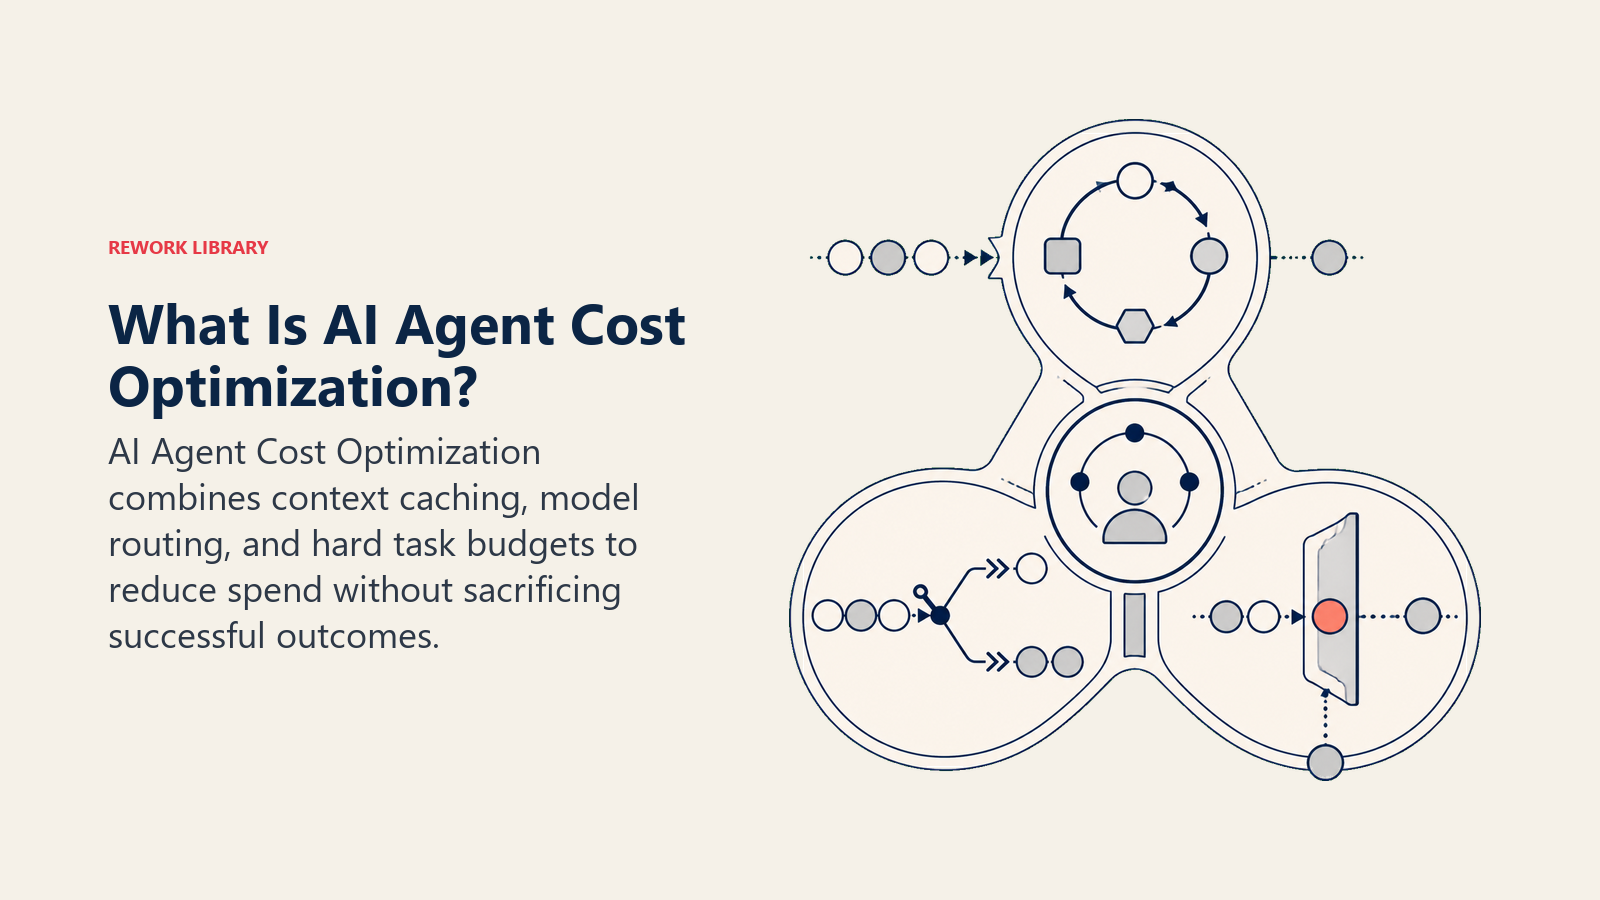
Optimasi biaya AI agent adalah serangkaian teknik yang menjaga pengeluaran token dan komputasi agent sebanding dengan nilai yang dihasilkannya: caching agar agent tidak membayar ulang untuk konteks yang sudah diproses, model routing agar langkah mudah berjalan di model murah dan langkah sulit di model mahal, serta batas anggaran tegas yang membatasi berapa banyak yang boleh dihabiskan satu tugas sebelum diserahkan ke manusia. Tidak satu pun dari ini opsional begitu agent keluar dari tahap pilot. Agent yang berputar dalam loop, memanggil tool, dan membaca ulang konteks di setiap putaran dapat mengubah demo yang berbiaya sen menjadi tugas produksi yang berbiaya dolar, dan selisihnya hampir selalu ada pada salah satu dari tiga tuas ini, bukan pada modelnya.
Mengapa Kurva Biaya Agent Tidak Sama dengan Kurva Biaya Model
Satu panggilan model punya satu input, satu output, satu harga. Cara kerja AI agent menggambarkan agent sebagai sebuah loop: mengamati, bernalar, bertindak, memeriksa hasil, ulangi, dan setiap putaran dapat memicu panggilan model atau panggilan tool tersendiri. Tugas yang butuh satu panggilan untuk kasus sederhana bisa butuh lima, sepuluh, atau lebih untuk kasus yang lebih sulit, dan setiap panggilan itu mengirim ulang sejumlah konteks, sehingga biaya berlipat seiring iterasi dengan cara yang tidak pernah terjadi pada satu panggilan.
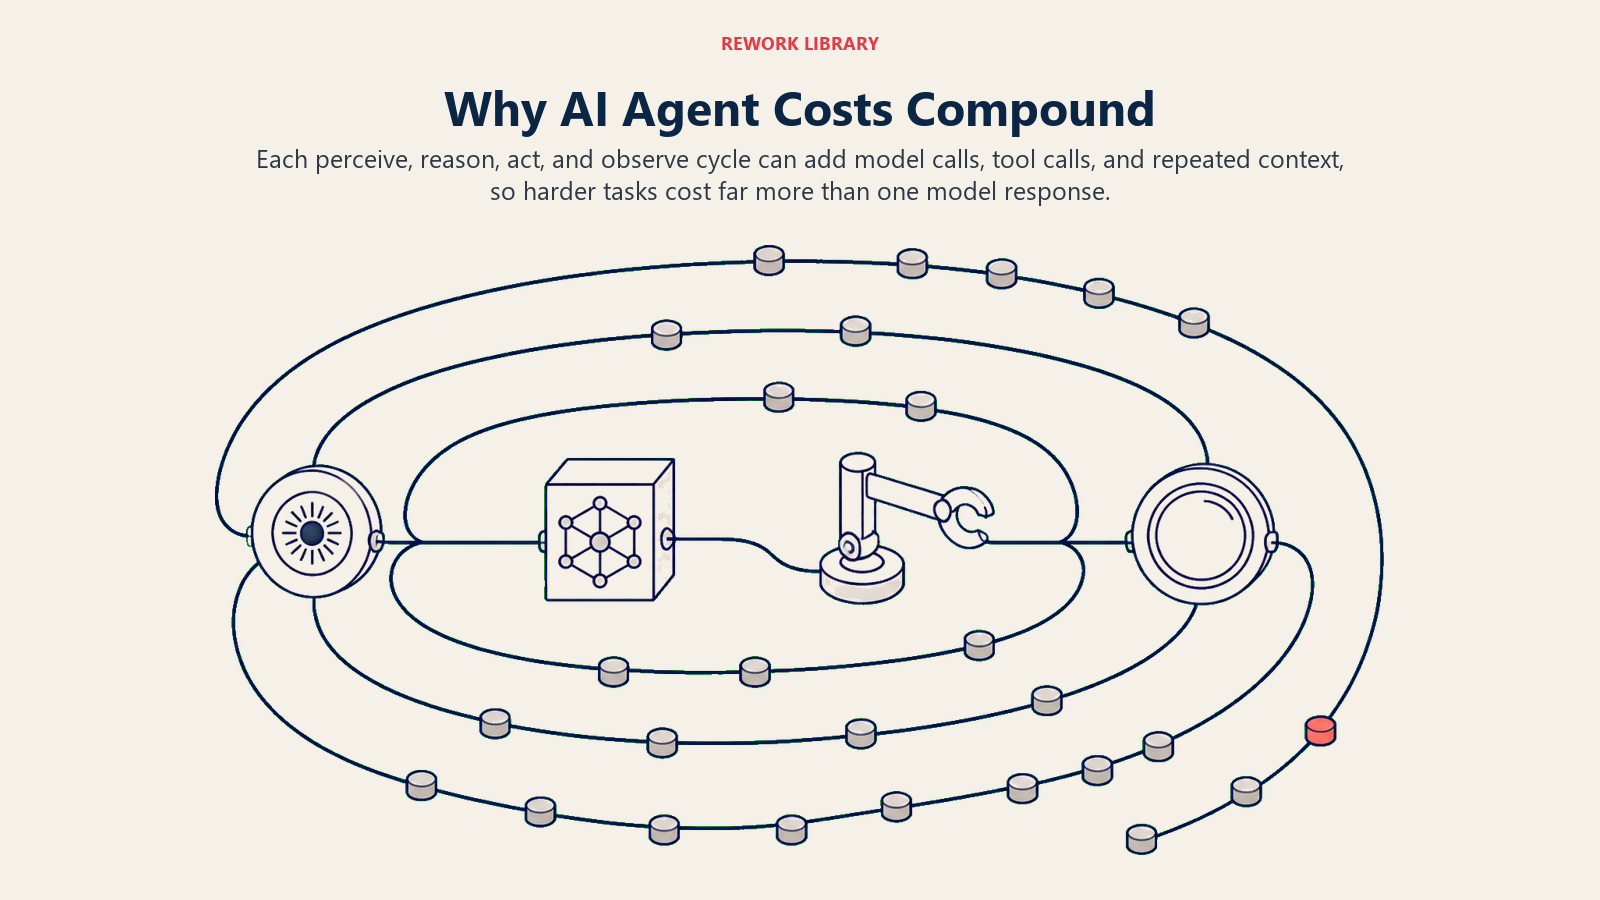
Inilah sebabnya biaya begitu sering menjadi alasan proyek agentic terhenti. Gartner memprediksi bahwa lebih dari 40% proyek agentic AI akan dibatalkan pada akhir 2027, dengan biaya yang membengkak, nilai bisnis yang tidak jelas, dan kontrol risiko yang tidak memadai sebagai penyebab utama. Biaya yang membengkak jarang mengejutkan bila Anda memodelkannya sebelum melakukan scale up. Ketika pola AI menjadi mahal pada skala besar menguraikan bagaimana Autonomous Agent tanpa kontrol mengubah satu tiket support menjadi 25 panggilan model, bukan dua atau tiga yang diasumsikan pilot. Tiga tuas di bawah ini adalah cara mencegah hal itu terjadi pada Anda.
Tuas 1: Caching, Agar Tidak Membayar Konteks yang Sama Dua Kali
Setiap proses agent mengirim ulang sepotong konteks yang hampir tidak berubah dari panggilan ke panggilan: system prompt, skema tool, kutipan knowledge base yang panjang, percakapan sejauh ini. Caching berarti penyedia model mengingat potongan itu dan menagih sebagian kecil dari harga untuk memakainya kembali, alih-alih memprosesnya ulang dari awal.
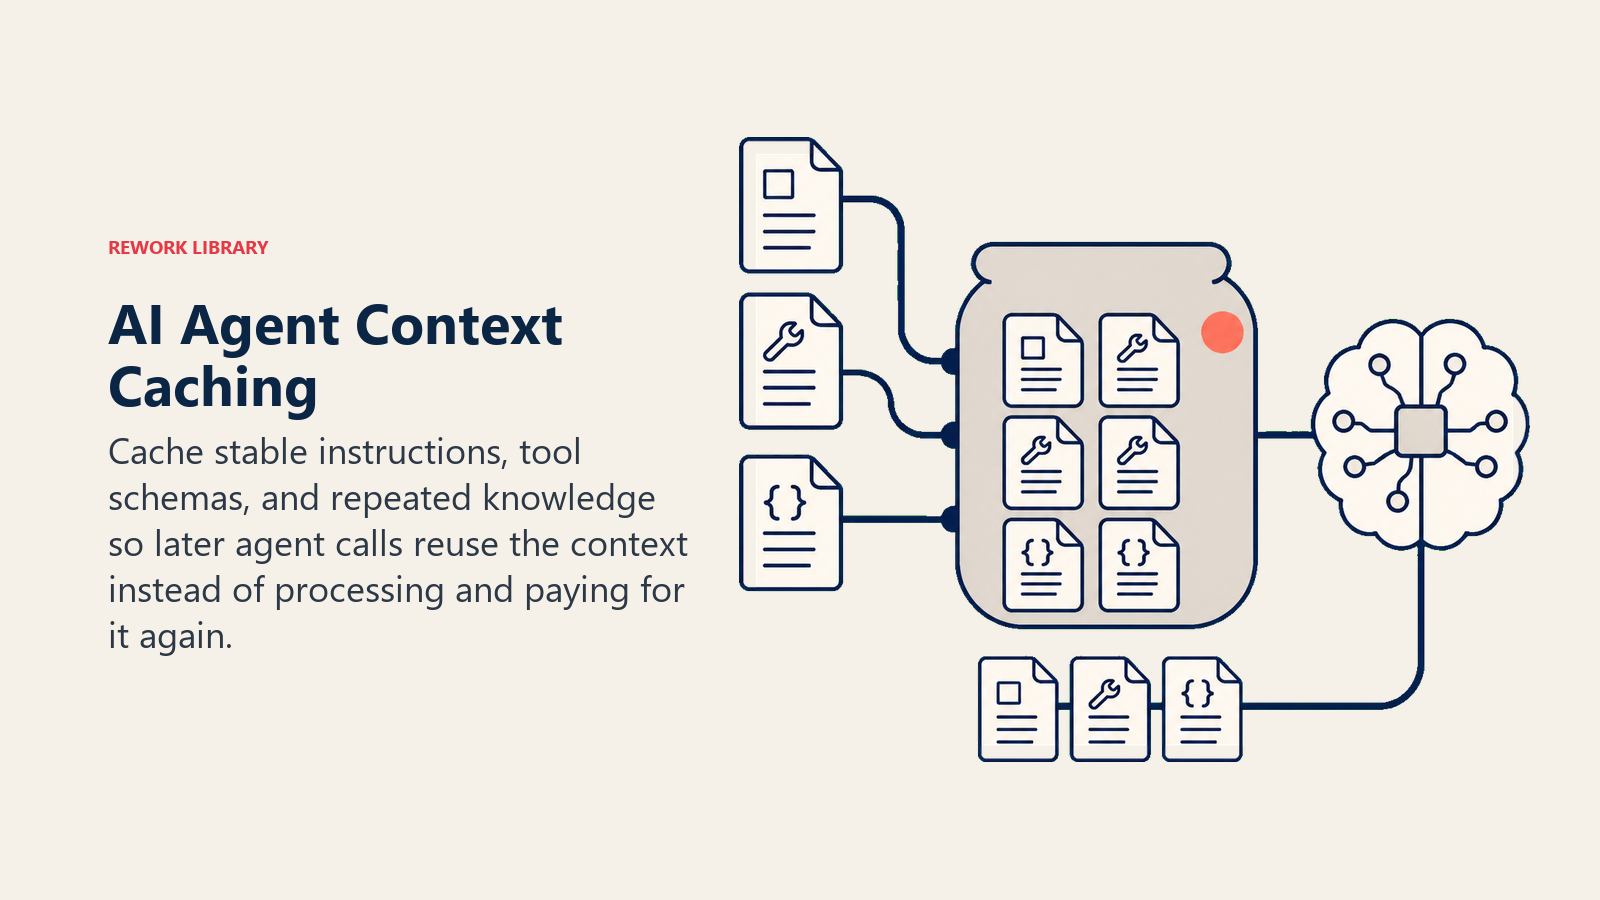
Diskonnya nyata dan besar. Harga resmi Anthropic menunjukkan bahwa token input yang di-cache berbiaya 10% dari harga input dasar, penurunan 90%, meski menulis konten baru ke cache berbiaya 25% lebih mahal daripada panggilan biasa, sehingga caching menguntungkan begitu sebuah prompt dipakai ulang lebih dari beberapa kali. OpenAI dan penyedia besar lainnya menawarkan versi diskon token cache masing-masing; mekanisme pastinya berbeda per vendor, tetapi ekonominya sama di semuanya. Untuk pekerjaan yang tidak butuh balasan instan (penyisiran kebersihan CRM malam hari, klasifikasi dokumen batch, pembuatan laporan semalam), Batch API Anthropic menambahkan diskon terpisah di atasnya: potongan 50% dari harga standar dengan imbalan pemrosesan asinkron alih-alih respons langsung.
Dua pola caching layak dibangun ke dalam agent sejak hari pertama:
- Context caching: cache system prompt, definisi tool, dan dokumen referensi statis yang besar (file kebijakan, katalog produk) sehingga hanya bagian yang benar-benar berubah antar panggilan yang ditagih dengan harga penuh.
- Response caching: untuk pertanyaan yang benar-benar berulang (FAQ yang sama, klasifikasi yang sama pada input yang hampir identik), lewati panggilan model sepenuhnya dan sajikan jawaban tersimpan, yang diperbarui berdasarkan jadwal, bukan dibuat ulang setiap kali.
Tuas 2: Model Routing, Agar Langkah Mudah Tidak Membayar Harga Frontier
Tidak setiap langkah dalam loop agent membutuhkan model Anda yang paling mampu dan paling mahal. Mengklasifikasikan tiket, mengekstrak field dari formulir, atau memeriksa apakah sebuah kasus cocok dengan skenario yang dikenal adalah pekerjaan yang berbeda dari menyusun balasan pelanggan yang bernuansa atau bernalar melalui pengecualian yang ambigu, dan harga API yang dipublikasikan di semua penyedia besar menunjukkan selisih satu orde besaran, sering 10x atau lebih, antara model kecil yang cepat dan model flagship frontier.
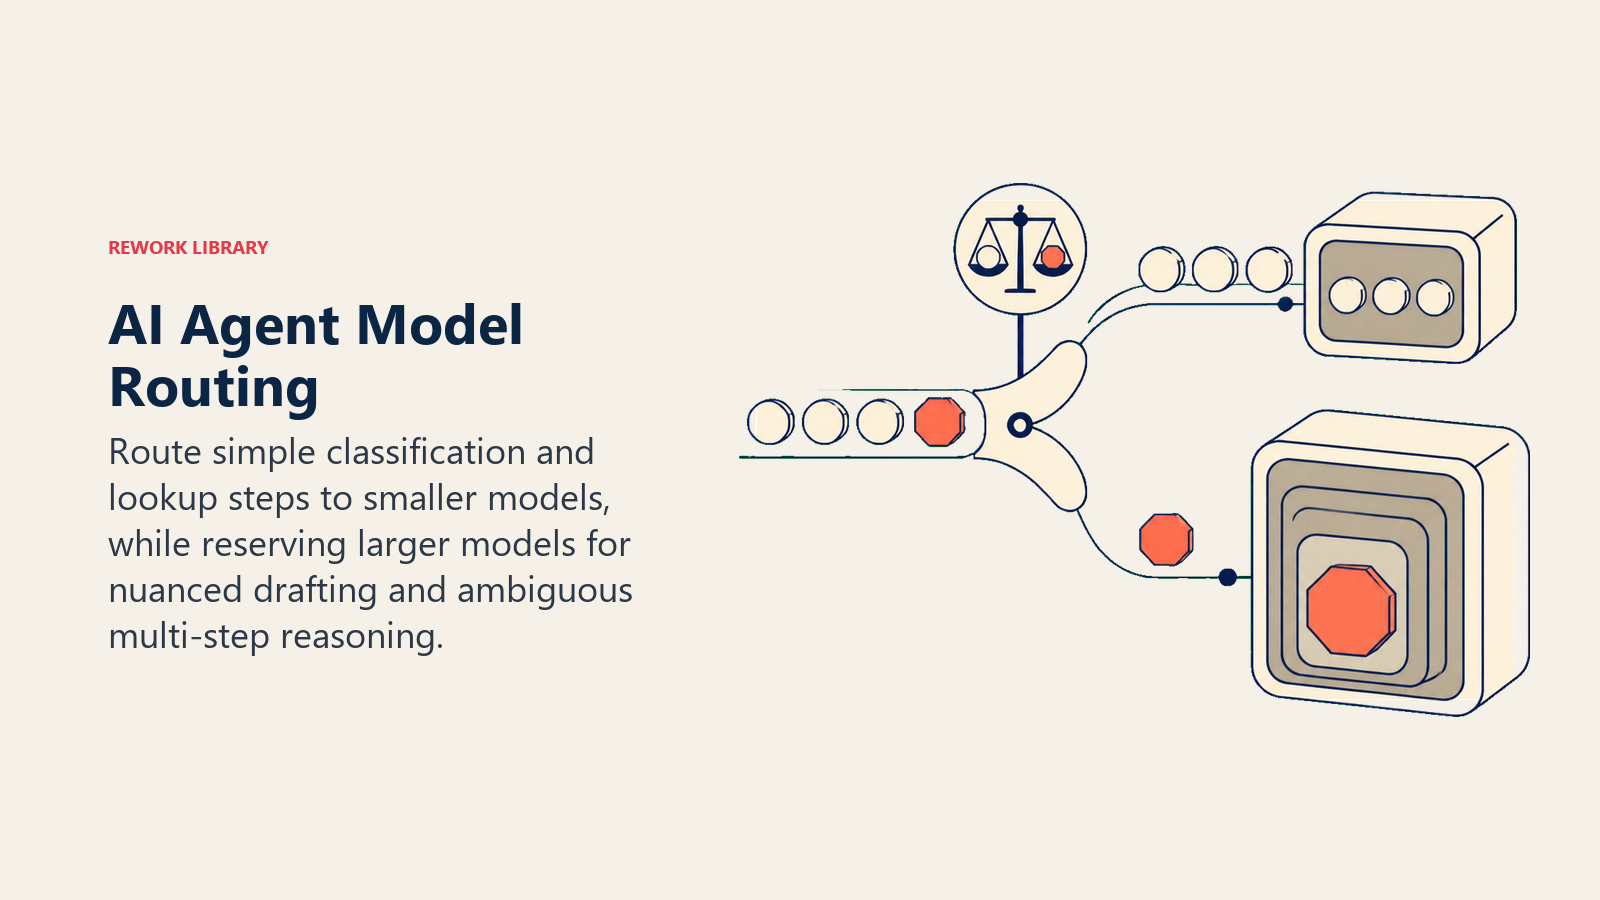
Model routing berarti mencocokkan langkah dengan model, bukan menjalankan seluruh agent pada satu tingkat secara default. Ketika pola AI menjadi mahal pada skala besar mendokumentasikan ide yang sama dalam bagian biaya Workflow Copilot: mengarahkan permintaan saran yang lebih sederhana ke model yang lebih murah sambil menyimpan inferensi premium untuk permintaan yang benar-benar membutuhkannya. Tabel routing sederhana untuk agent yang tipikal:
| Jenis langkah | Contoh | Tingkat model |
|---|---|---|
| Klasifikasi, ekstraksi, keputusan routing | Tiket ini masuk antrean mana? | Kecil, cepat, murah |
| Lookup terstruktur dan pencocokan aturan | Apakah invoice ini cocok dengan PO yang disetujui? | Kecil hingga menengah |
| Menyusun teks untuk pelanggan | Tulis balasan untuk kasus spesifik ini | Menengah hingga besar |
| Pengecualian ambigu dan penalaran multi-langkah | Kasus ini tidak cocok dengan skenario playbook mana pun | Terbesar yang tersedia |
Blok penyusun decision logic yang memutuskan apakah agent bertindak, bertanya, atau menyerahkan ke manusia adalah tempat yang sama untuk model routing. Anda sudah mencabangkan logika berdasarkan jenis kasus. Arahkan pilihan model melalui cabang yang sama, alih-alih memperlakukannya sebagai keputusan terpisah.
Tuas 3: Anggaran Tegas, Agar Tugas yang Lepas Kendali Tidak Menggelembungkan Tagihan
Caching dan routing menurunkan harga per panggilan. Anggaran membatasi berapa banyak panggilan yang boleh dibuat satu tugas, dan itu penting karena lonjakan biaya yang sebenarnya jarang datang dari harga per panggilan. Lonjakan itu datang dari tugas yang terus memanggil model jauh lebih sering daripada yang direncanakan siapa pun.
Ketika pola AI menjadi mahal pada skala besar menyatakannya terus terang: Autonomous Agent tanpa batas iterasi yang tegas dan anggaran token per tugas adalah beban finansial, bukan alat produktivitas. Solusinya adalah dua pengaturan, yang mudah dinyatakan dan mudah dilewatkan: jumlah maksimum panggilan model per tugas, dan serah terima otomatis ke manusia ketika tugas mencapai batas itu, alih-alih terus membelanjakan. Keduanya bukan pelengkap yang ditambahkan setelah bulan pertama yang mahal. Keduanya termasuk dalam setiap batas tegas lain yang dibutuhkan agent. Guardrail AI agent membahas guardrail output dan panggilan tool secara mendalam, dan batas anggaran adalah guardrail jenis itu: aturan yang tetap berlaku seberapa pun yakinnya agent bahwa satu panggilan lagi akan menyelesaikan pekerjaan.
Di Mana Hal Ini Muncul pada Agent Nyata
Tuas-tuas ini tidak abstrak. Beberapa tempat di library ini di mana benar atau salahnya penerapan berdampak besar pada tagihan:
- AI Research Agent: biaya berskala langsung dengan berapa banyak sumber yang ditarik ke konteks per brief. Membatasi jumlah sumber dan mengarahkan langkah sintesis ke model tingkat menengah, bukan yang terbesar, sering menjadi pembeda antara brief seharga $2 dan $20.
- AI Knowledge Base Agent: dokumen kebijakan dan kutipan FAQ yang sama diambil di ratusan pertanyaan serupa, menjadikannya salah satu tempat dengan imbal hasil tertinggi untuk meng-cache konteks, alih-alih mengirim ulang chunk hasil retrieval yang sama pada setiap query.
- AI Support Triage Agent: volume panggilan tinggi berarti penghematan kecil per panggilan pun berlipat cepat. Mengarahkan langkah klasifikasi awal ke model kecil sambil menyimpan model yang lebih besar untuk menyusun balasan sebenarnya mencegah volume menjadi seluruh anggaran.
Model Biaya Sederhana Sebelum Melampaui Pilot
Sebelum membawa agent dari pilot kecil ke volume nyata, tetapkan angka kasar untuk empat hal: rata-rata token per panggilan (ukur, jangan menebak), volume panggilan yang diharapkan pada skala produksi, asumsi cache hit rate, dan pembagian routing Anda di berbagai tingkat model. Kalikan pada 2x dan 5x volume pilot, bukan hanya pada volume pilot, karena pilot berjalan pada kasus yang paling mudah dan paling representatif sedangkan produksi tidak. Ketika pola AI menjadi mahal pada skala besar menyarankan menambahkan buffer 50-100% pada apa pun yang ditunjukkan sampel Anda, tepat karena alasan ini.
Angka lain yang layak dimodelkan sejak awal adalah biaya terhadap hasil, bukan biaya terhadap aktivitas. Mengukur ROI pola AI membahas kerangka itu lebih dalam: agent yang lebih murah tetapi gagal pada separuh tugasnya sebenarnya tidak lebih murah setelah Anda menghitung waktu manusia yang dihabiskan untuk membereskan sisanya. Dan lihat dari sudut yang lebih luas: inferensi agent hanyalah satu pos dalam gambaran total cost of ownership AI yang juga mencakup talenta, integrasi, dan tata kelola, sehingga menguasai satu tuas ini tidak berarti anggaran AI lainnya akan beres dengan sendirinya.
Memantau Biaya Setelah Rilis
Optimasi saat peluncuran akan menyimpang tanpa pemantauan setelahnya. Observabilitas AI agent sudah menyebutkan metrik yang paling penting di sini: biaya per tugas selesai, bukan biaya per proses, karena proses yang gagal tetap menghabiskan token dan proses murah yang gagal dua kali sebelum berhasil sebenarnya tidak murah. Lacak angka itu bersama cache hit rate dan distribusi tingkat model Anda, dan perhatikan ketika salah satu dari ketiganya menyimpang: biaya per tugas selesai yang naik, cache hit rate yang turun, atau pergeseran ke tingkat mahal pada jenis langkah yang dulu diarahkan ke tingkat murah. Salah satu dari ketiganya biasanya tanda paling awal bahwa sesuatu pada input atau perilaku agent berubah, jauh sebelum tagihan memberi tahu Anda.
Jika Anda membandingkan platform untuk membangun atau menjalankan agent, prediktabilitas biaya layak dinilai secara eksplisit, bukan diasumsikan serupa di semua vendor. Perbandingan tool AI kami mengevaluasi platform lebih dari sekadar daftar fitur, dan scorecard evaluasi vendor SaaS memberi Anda template berbobot untuk menempatkan prediktabilitas biaya setara dengan kapabilitas saat menilai pilihan.
Key Facts
- Token input yang di-cache berbiaya 90% lebih murah dari harga input standar pada model Anthropic (10% dari harga dasar untuk membaca dari cache), sedangkan menulis konten baru ke cache berbiaya 25% lebih mahal, sehingga caching menguntungkan untuk apa pun yang dipakai ulang lebih dari sekali atau dua kali.
- Pemrosesan batch untuk pekerjaan agent non-real-time menambahkan diskon 50% terpisah di atas harga API standar.
- Gartner memprediksi lebih dari 40% proyek agentic AI akan dibatalkan pada akhir 2027, dengan biaya yang membengkak termasuk penyebab utama yang dikutip.
- Harga model yang dipublikasikan di penyedia besar biasanya menunjukkan selisih satu orde besaran antara model kecil yang cepat dan model flagship frontier, yang menjadikan routing berdasarkan kesulitan tugas sebagai tuas berdampak tertinggi yang belum dipakai kebanyakan tim.
- Kontrol finansial terpenting untuk agent yang berputar dalam loop adalah batas tegas jumlah panggilan model per tugas dengan serah terima otomatis ketika batas tercapai, bukan harga per panggilan yang lebih rendah.
Pertanyaan yang Sering Diajukan tentang Optimasi Biaya AI Agent
Apa itu optimasi biaya AI agent?
Serangkaian teknik yang menjaga pengeluaran token dan komputasi agent sebanding dengan hasilnya: meng-cache konteks berulang agar Anda tidak membayar untuk memprosesnya ulang, mengarahkan langkah mudah ke model yang lebih murah dan langkah sulit ke model yang lebih mampu, serta membatasi berapa banyak yang boleh dihabiskan satu tugas sebelum diserahkan ke manusia.
Mengapa AI agent lebih mahal dijalankan daripada satu panggilan model?
Agent menjalankan loop: mengamati, bernalar, bertindak, memeriksa hasil, ulangi, dan setiap putaran dapat memicu panggilan model atau panggilan tool tersendiri. Tugas yang butuh satu panggilan untuk kasus sederhana bisa butuh jauh lebih banyak untuk kasus yang lebih sulit, sehingga biaya berlipat seiring jumlah iterasi dengan cara yang tidak pernah terjadi pada satu panggilan model.
Apa perbedaan antara caching dan model routing?
Caching menurunkan biaya memakai ulang konteks yang sudah Anda kirim ke model, sering 90% atau lebih pada bagian yang di-cache. Model routing menurunkan biaya dengan mencocokkan setiap langkah dengan model termurah yang mampu mengerjakannya dengan baik, alih-alih menjalankan setiap langkah pada model termahal secara default. Keduanya saling melengkapi, bukan alternatif.
Berapa banyak sebenarnya yang dapat dihemat teknik-teknik ini?
Tergantung pada campuran konteks berulang, volume panggilan, dan kompleksitas tugas Anda, tetapi diskon dasarnya besar: potongan 90% untuk token input yang di-cache, potongan 50% untuk pemrosesan batch, dan biasanya selisih harga satu orde besaran antara model kecil dan model frontier untuk langkah yang tidak membutuhkan penalaran frontier.
Berapa batas anggaran yang wajar untuk tugas agent?
Tidak ada angka universal, karena tergantung kompleksitas tugas, tetapi prinsipnya universal: tetapkan jumlah maksimum panggilan per tugas dan alihkan otomatis ke manusia ketika batas tercapai, alih-alih membiarkan agent terus mencoba tanpa batas. Perlakukan sebagai guardrail, bukan saran.
Langkah Selanjutnya
Caching, routing, dan anggaran mengendalikan biaya agent. Observabilitas AI agent adalah cara Anda memastikan kontrol itu masih berfungsi setelah peluncuran, karena biaya per tugas selesai adalah salah satu sinyal dini penyimpangan yang paling jelas. Jika Anda belum memodelkan mengapa biaya membengkak pada skala besar, ketika pola AI menjadi mahal pada skala besar adalah bacaan yang lebih mendalam, dan cara membangun AI agent membahas di mana batas anggaran berada di antara guardrail agent lainnya.

On this page
- Mengapa Kurva Biaya Agent Tidak Sama dengan Kurva Biaya Model
- Tuas 1: Caching, Agar Tidak Membayar Konteks yang Sama Dua Kali
- Tuas 2: Model Routing, Agar Langkah Mudah Tidak Membayar Harga Frontier
- Tuas 3: Anggaran Tegas, Agar Tugas yang Lepas Kendali Tidak Menggelembungkan Tagihan
- Di Mana Hal Ini Muncul pada Agent Nyata
- Model Biaya Sederhana Sebelum Melampaui Pilot
- Memantau Biaya Setelah Rilis
- Key Facts
- Langkah Selanjutnya