AI agentのためのRAG:自社データに根拠を置くagentの作り方
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
RAG(検索拡張生成)とは、AI agentが、モデルが学習中にたまたま身につけた知識から推測するのではなく、自社の実際の文書やデータを使って回答し、行動するための仕組みです。agentは質問やタスクを検索に変換し、ナレッジベースから最も関連性の高いチャンクを取得し、見つけた内容だけから次のステップを生成して、出典を示します。agentにとってRAGは後付けの機能ではありません。すべてのアクションを、実在し最新の情報に結びつけておく土台となる層です。
agentにとってのRAGを一言で言うと
核となる仕組みは、先に検索し、後から生成する。そして検索のステップを決して省かない、というものです。技術としての検索拡張生成は、Lewisらが2020年に提唱しました。検索のステップを言語モデルと組み合わせることで、出力が一般的な学習知識ではなく、特定の検証可能な情報源に基づくようにするものです。Gartnerも、これがエンタープライズAIにとっていかに中核的になったかを認識しており、2025年9月にEnterprise AI Searchに関する専用のMarket Guideを公開しました。そこでは、検索、RAG、agentic AIの融合が主要な市場の推進要因として挙げられています。
その用語集のページでは、ベクトル埋め込み、検索パイプライン、チャンク分割といった仕組みを詳しく扱っています。RAG Assistantパターンも、一度検索して回答するだけの単独のチャットボットという使い方を、独自のROIの数値や失敗モードの内訳とともに詳しく扱っています。このページが扱うのはもう少し絞った話題です。回答して終わるだけのQ&Aボットではなく、推論し、ツールを使い、行動もするagentの中に、検索がどう組み込まれるかを取り上げます。
agentに必要なのは、大きなプロンプトではなく検索
手っ取り早い近道は、検索を省いて、agentが必要としそうなものをすべてプロンプトに貼り付けてしまうことです。これは、3つの理由ですぐに行き詰まります。
第一に、学習知識は固定された日から古くなっていきます。数か月前に学習したモデルは、先週返品ポリシーが変わったことも、昨日ある顧客の契約が更新されたことも知りません。検索は最新の情報源から取得するので、回答が古くなるのは、最後に文書が更新された時点まで、ということになります。
第二に、コンテキストウィンドウが大きいからといって、無条件に通用するわけではありません。ナレッジベース全体を毎回のプロンプトに詰め込めば、呼び出しのたびにトークンとレイテンシのコストが増えます。長いコンテキストでの性能に関する研究でも、モデルが大きなコンテキストのすべてを均等に使うわけではないことが繰り返し示されています。関連情報は埋もれるほど見落とされやすく、特に長い入力の真ん中あたりで顕著です。検索は、持っているものすべてではなく、この特定の質問に実際に関連するいくつかのチャンクだけをモデルに渡すことで、この問題を解決します。AI Agentのメモリでは、このコンテキストウィンドウの制約を詳しく扱っています。検索の問題であると同時に、メモリの問題でもあるからです。
第三に、変化するものについては、検索のほうがファインチューニングより優れています。ファインチューニングは知識をモデルの重みに焼き込むので、やり直すには費用がかかり、元の文書が変わった瞬間にまた古くなります。検索は質問のその時点で情報源を読むので、次に誰かが質問するときには、すでに更新が反映されています。
agentのループの中での検索の位置づけ
agentは、最初に一度だけ検索して終わりではありません。検索は通常、agentが行動に必要なコンテキストを集める知覚(perceive)のステップで行われます。実際にはほかと同じツール呼び出しの1つで、「ナレッジベースを検索する」は、「CRMを確認する」や「ミーティングを予約する」と並んで、agentのツール一覧に入っています。
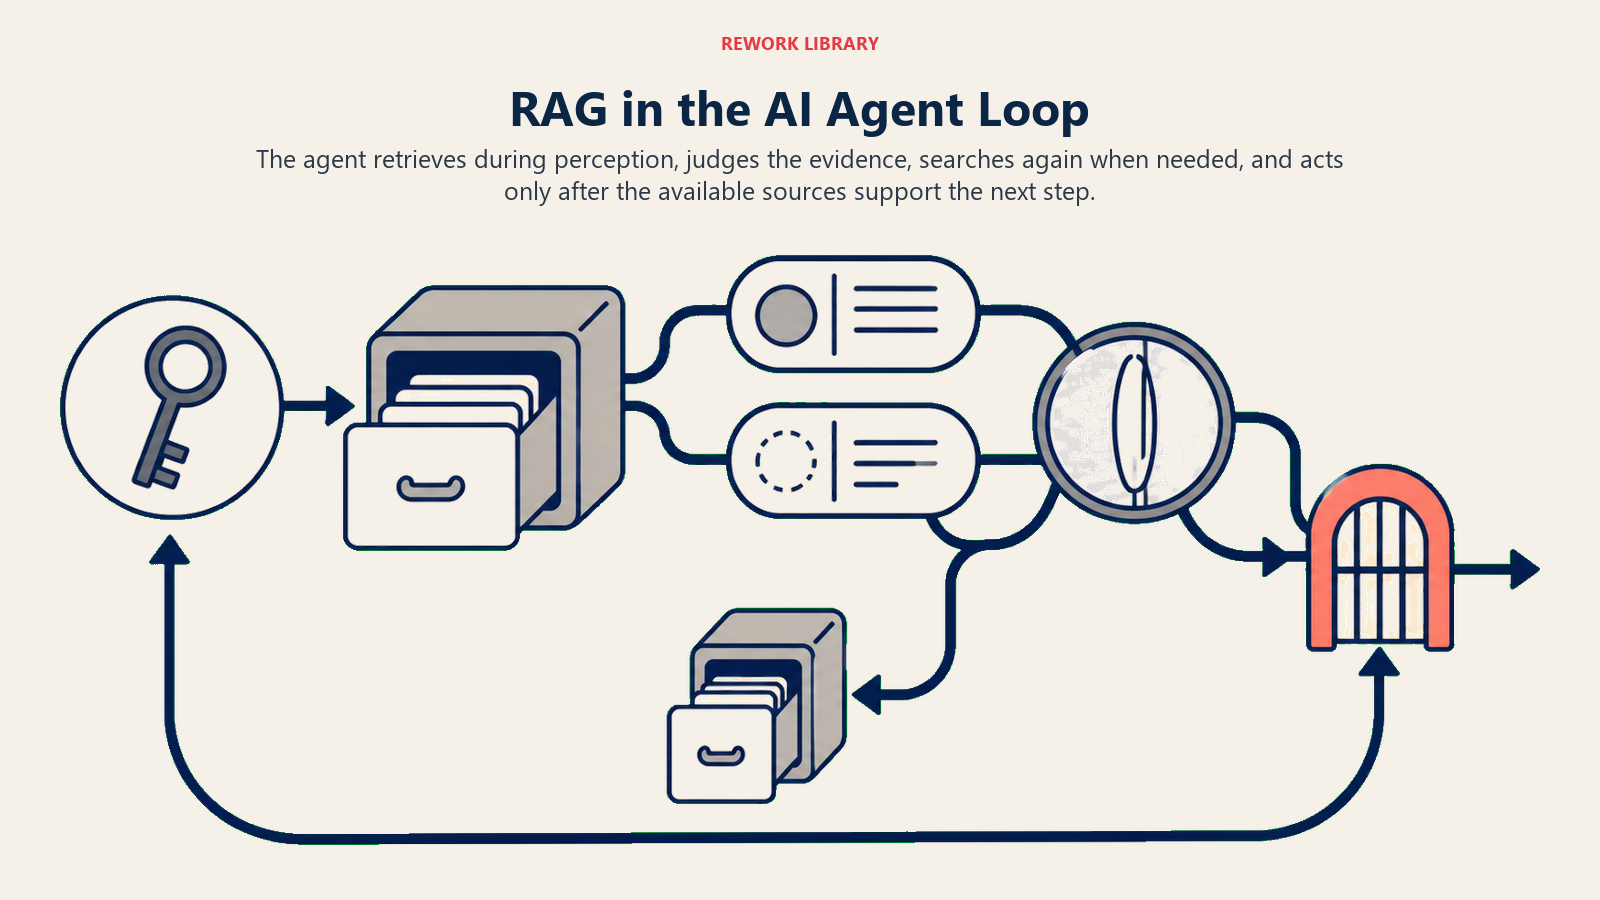
単独のRAGチャットボットと、RAGを使うagentの違いは、ここに現れます。単独のアシスタントは一度検索して回答します。agentは、返ってきた内容を見て、結果が不完全であったり矛盾していたりすることに気づき、より絞り込んだクエリで再度検索し、それから初めて何をするかを決められます。検索し、返ってきたものについて推論し、必要なら再び検索し、そして行動する。このループこそが、1回きりの検索ではなく、agent的な動きにしているものです。
RAG、ツール、メモリ:適切な根拠づけの選び方
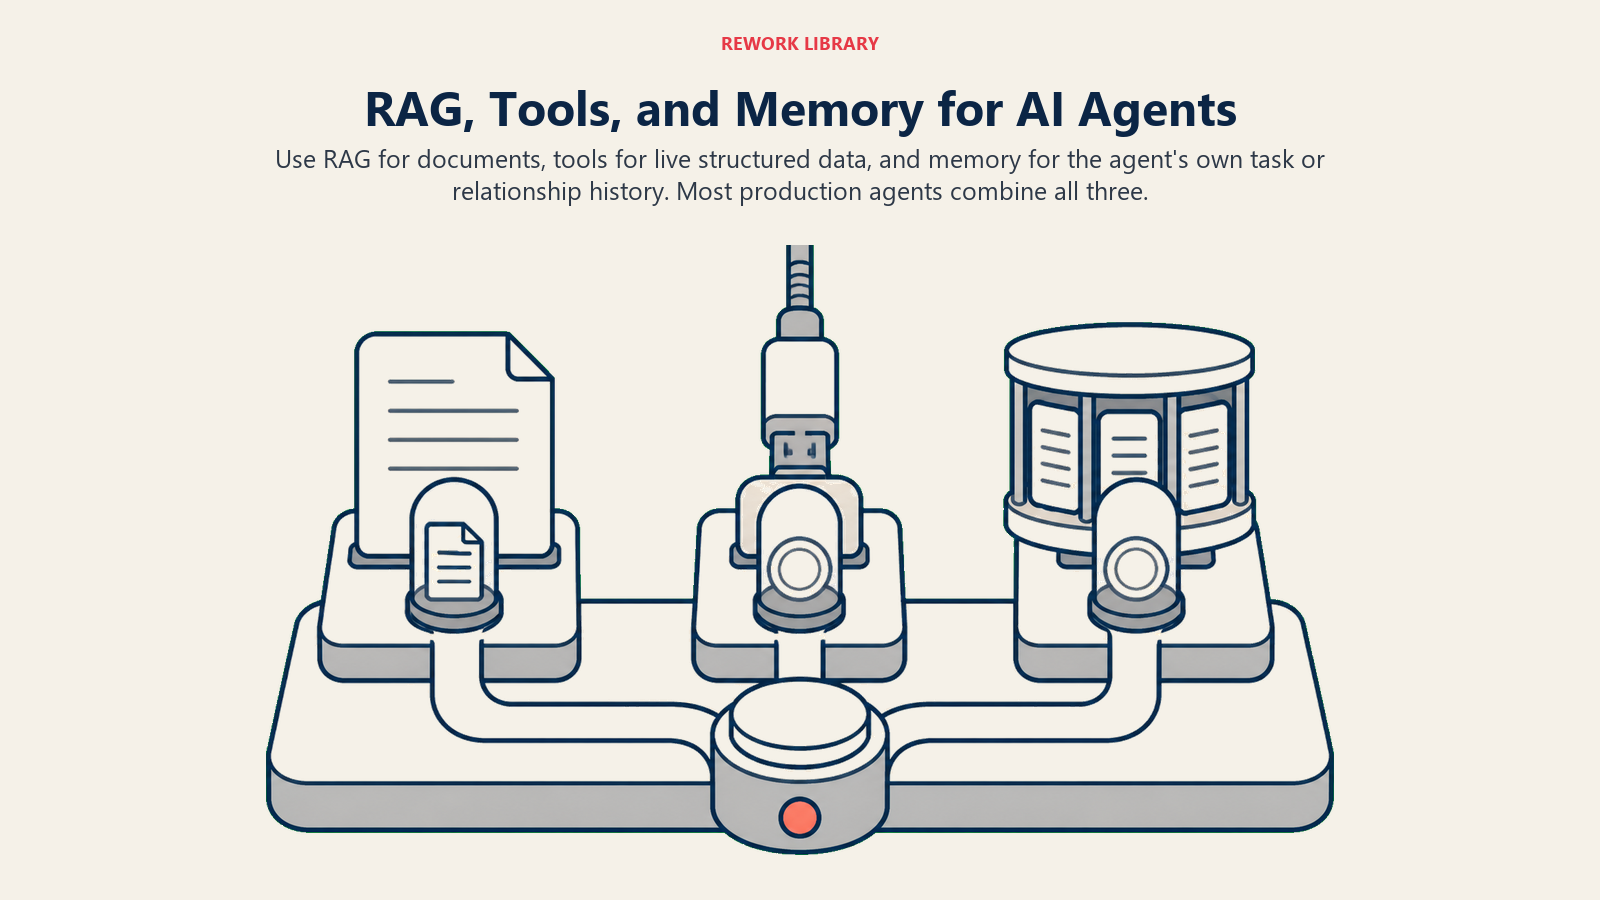
agentが必要とする事実のすべてが、文書の中にあるわけではありません。どの根拠づけの仕組みがどの種類の情報に合うかを知っておけば、間違ったものを作らずに済みます。
| 根拠づけの情報源 | 最適な用途 | 例 | 回答の鮮度 |
|---|---|---|---|
| RAG(検索) | 非構造化の知識:ポリシー、ウィキ、契約書、ドキュメント | 「育児休業のポリシーはどうなっていますか」 | 最後に文書が更新された時点まで |
| ツールとAPI | 構造化された、取引に関する、リアルタイムのデータ | 「この顧客のアカウントティアは何ですか」「木曜14時は空いていますか」 | 呼び出した瞬間のライブな情報 |
| メモリ | このタスクやユーザーに関する、agent自身の履歴 | 「この見込み客には、すでに日時を提案しましたか」 | この実行、またはこの関係に固有 |
本番稼働しているagentの多くは、このうち2つか3つを組み合わせて使っています。AI Knowledge Base Agentは、ヘルプセンターから情報を取得し(RAG)、CRMを通じて顧客のアカウントティアとバージョンを確認し(ツール呼び出し)、まったく同じ質問がこのセッションですでに出たかどうかを覚えている(メモリ)うえで、回答するか、質問するか、引き継ぐかを決めます。3列目にあたる短期と長期の側面については、AI Agentのメモリを参照してください。
RAGで根拠づけられたagentの実例
このパターンは、まったく異なるナレッジベースでも成り立ちます。このライブラリから、その形を示す3つの例を紹介します。
AI Knowledge Base Agentは、ヘルプセンターの記事や社内ウィキから情報を取得し、見つけた内容だけを使って回答し、すべての返信で出典の記事を名前で示します。そして重要なのは、検索結果が空だった場合に、その質問をコンテンツのギャップとしてフラグを立てることです。結果がゼロであることは、単に引き継ぎのトリガーになるだけではありません。コンテンツチームが次に何を書くべきかを、正確に教えてくれるシグナルでもあります。
AI Policy Q&A Agentは、同じ「取得してから引用する」パターンを、別のコーパスに対して実行します。サポートのヘルプセンターではなく、従業員ハンドブックです。HRやITのポリシーに関する質問に、書面に残っている内容だけから厳密に答え、引用したセクションがどれほど最近更新されたかを示し、ハンドブックがその質問をカバーしていない時点で、会社のポリシーを推測せずにHRにルーティングします。
AI Contract Review Agentは、検索を別の形で使います。質問に答えるのではなく、社内のプレイブック(許容できる支払条件、責任の上限、知的財産に関する立場)を取得し、受け取った契約書を条項ごとにそれと照合して、人間が判断すべきすべての相違点を示します。同じ「取得してから根拠づける」仕組みを、Q&Aではなく比較に適用したものです。
こうしたagentのいずれかを構築するためにプラットフォームを比較している場合は、ナレッジベースソフトウェアの選び方ガイドとサポートツールの比較記事で、検索に適した選択肢を取り上げています。
仕組みを簡単に
元の文書はチャンクに分割され、各チャンクは埋め込みモデルによってベクトルに変換され、高速な類似検索のために作られたベクトルデータベースに保存されます。質問も同じ方法でベクトルに変換され、システムはそのベクトルに最も近いチャンクを見つけます。ナレッジベース全体ではなく、そのチャンクが質問とともにモデルのコンテキストに入ります。チャンクのサイズ、メタデータによる絞り込み(部門、文書の日付、製品バージョン)、そしてインデックスを更新する頻度は、どのモデルで生成するかよりも、回答の品質に大きく影響します。埋め込みとベクトル検索の詳しい解説は、ベクトルデータベースとはを参照してください。
agentにとってRAGが破綻する場所
単独のRAGアシスタントを襲うのと同じ失敗モードは、agentをさらに強く襲います。agentは、不適切な検索結果をただ表示するのではなく、それに基づいて行動する可能性があるからです。
古くなったナレッジベースは最もよくある失敗であり、気づくのも最も難しいものです。agentは変わらず自信を持って回答するからです。ただし、その回答は前四半期のポリシーに基づいています。担当者のいないナレッジベースは徐々にずれていき、顧客が誤った情報に基づいて行動して初めて、誰かが気づきます。
ハルシネーションによる引用は最も危険な失敗です。成功のように見えるからです。出典が付いた自信のある回答が、よく見るとagentが主張した内容を実際には述べていません。これはまさに、OWASP Top 10 for LLM Applicationsが、誤情報と過信のリスクとして警告している種類の失敗です。ユーザーは、引用のない回答より、引用付きの回答を信頼します。そのため、誤った引用は、単に誤っているだけの回答よりも大きな被害をもたらします。
どちらの失敗も、同じ対処につながります。誰かがナレッジベースの責任者となり、定期的にレビューし、結果がゼロだった検索や信頼度の低い検索を、無視すべきノイズではなく、調べる価値のあるシグナルとして扱うことです。
RAGがその仕事に適さないとき
検索があらゆる根拠づけの問題を解決するわけではありません。情報が数分ごとに変わる場合(ライブの在庫、今日のカレンダー、この瞬間の口座残高)は、インデックスを作成した時点ですでに少し古くなっているコピーから検索するより、ライブシステムへのツール呼び出しのほうが優れています。また、ユーザーが適切な文書を問題なく見つけられるのに、本当の問題が誰もそれを読まないことにあるなら、解決策は、生成レイヤーを上に載せることではなく、より優れた検索やより短い文書かもしれません。
Anthropic自身のagent構築に関するガイダンスは、検索を3つの拡張のうちの1つとして位置づけています。ツールやメモリと並んで、素のモデルを実際に仕事ができる存在にするものです。この3つのうち、どれも他の2つの代わりにはなりません。検索だけのagentは質問に答えられますが、行動できません。ツールを呼び出すだけのagentは行動できますが、与えられていないポリシーを説明できません。うまく作られたagentの多くは、タスクの各部分が実際に必要とする大きさに合わせて、3つすべてを必要とします。
Key Facts
- RAGは、応答を生成する前に関連するチャンクを取得することで、AI agentの回答と行動を、モデルの固定された学習知識ではなく、実際の文書やデータに根拠づけます。
- agentの内部では、検索は通常、agentが知覚のステップで行うツール呼び出しです。有能なagentは、検索し、返ってきた内容を評価し、行動する前にもう一度検索できます。
- 文書の中の知識にはRAG、ライブの構造化データにはツールやAPIの呼び出し、agent自身のタスク履歴にはメモリが適しています。実際のagentの多くは、この3つをすべて組み合わせています。
- RAGで最も危険な失敗は、ハルシネーションによる引用です。出典が付いた自信のある回答が、主張を実際には裏付けていません。だからこそ、検索技術そのものと同じくらい、責任者を明確にすることとレビューの頻度が重要です。
AI agentのためのRAGに関するよくある質問
AI agentにおけるRAGとは何ですか。
RAG(検索拡張生成)とは、AI agentが回答と行動を、実際の文書やデータに根拠づける仕組みです。モデルが学習中に覚えたことに頼るのではなく、agentはナレッジベースを検索し、最も関連性の高い情報を取得し、その取得した内容から次のステップを生成して、出典を示します。
RAGとAI agentは同じものですか。
いいえ。RAGは根拠づけの技術であり、それ自体がagentではありません。単独のRAGアシスタントは、一度検索して質問に答えます。AI agentはRAGを複数のツールの1つとして使えます。検索し、見つけたものについて推論し、ときには再度検索し、それから行動します。これは、検索だけが扱うよりも広いループです。
agentが通常のツール呼び出しやAPIではなく、RAGを必要とするのはどんなときですか。
文書の中にある非構造化の知識(ポリシー、ウィキ、契約書、製品ドキュメント)にはRAGを使います。口座残高、カレンダーの空き枠、注文のステータスのような、構造化されたリアルタイムのデータには、ツールまたはAPIの呼び出しを使います。agentの多くは、異なる種類の情報に対して、その両方を必要とします。
agentのためのRAGは、RAG Assistantパターンとどう違いますか。
RAG Assistantパターンは、検索して回答するだけの、単独のチャットボットを指します。agentのためのRAGは、検索を、推論し、ほかのツールを呼び出し、過去のステップを記憶し、行動するという、より大きなループの中の入力の1つとして捉えます。検索の仕組みは同じです。それを取り巻くものが異なります。
自律型agentの中でRAGを使う最大のリスクは何ですか。
ハルシネーションによる引用です。agentが自信のある回答を生成し、実際にはその主張を含んでいない出典を引用して、それに基づいて行動します。agentは回答を表示するだけでなく、実際の行動を取れるため、この失敗モードによって、そもそも存在しなかった情報に基づいて行動してしまう可能性があります。ナレッジベースの責任者を明確にして定期的に抜き取りチェックを行えば、これが積み重なる前に見つけられます。
次に読むもの
検索は、ツールやメモリと並んで、agentが現実に根拠を置く3つの方法の1つです。agentの知識の問題が、実際には「文書を見つける」問題ではなく「すでに起きたことを覚えておく」問題なら、AI Agentのメモリがその側面を直接扱っています。そして検索を組み込んだ後は、AI agentの評価とテスト方法で、不適切な検索結果やハルシネーションによる引用が顧客に届く前に見つける方法を確認してください。
