Pengoptimuman Kos AI Agent: Caching, Penghalaan Model, dan Belanjawan
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
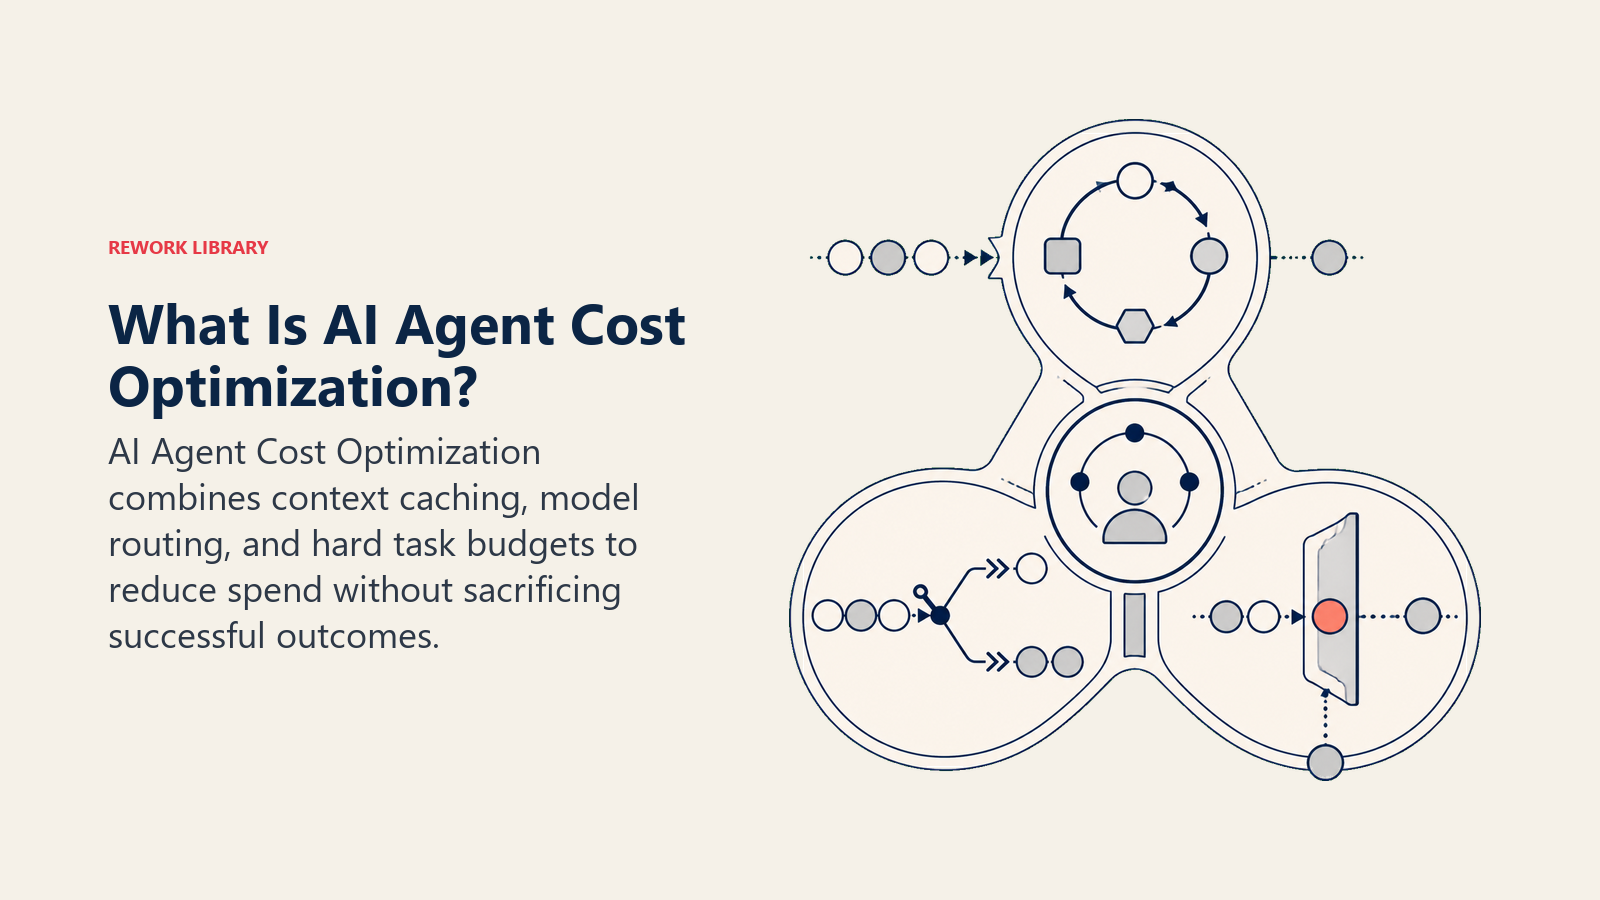
Pengoptimuman kos AI agent ialah set teknik yang memastikan perbelanjaan token dan pengkomputeran agent seiring dengan nilai yang disampaikannya: caching supaya agent tidak membayar semula untuk konteks yang sudah diprosesnya, penghalaan model supaya langkah mudah dijalankan pada model murah dan langkah sukar pada model mahal, serta belanjawan tegar yang menghadkan apa yang boleh dibelanjakan oleh satu tugas sebelum ia diserahkan kepada seseorang. Semua ini tidak lagi pilihan sebaik sahaja agent meninggalkan peringkat perintis. Agent yang berulang, memanggil alat, dan membaca semula konteks pada setiap pusingan boleh menukar demo yang berkos beberapa sen kepada tugas pengeluaran yang berkos beberapa dolar, dan jurang itu hampir selalu berpunca daripada salah satu daripada tiga tuas ini, bukan model itu sendiri.
Mengapa Lengkung Kos Agent Bukan Lengkung Kos Model
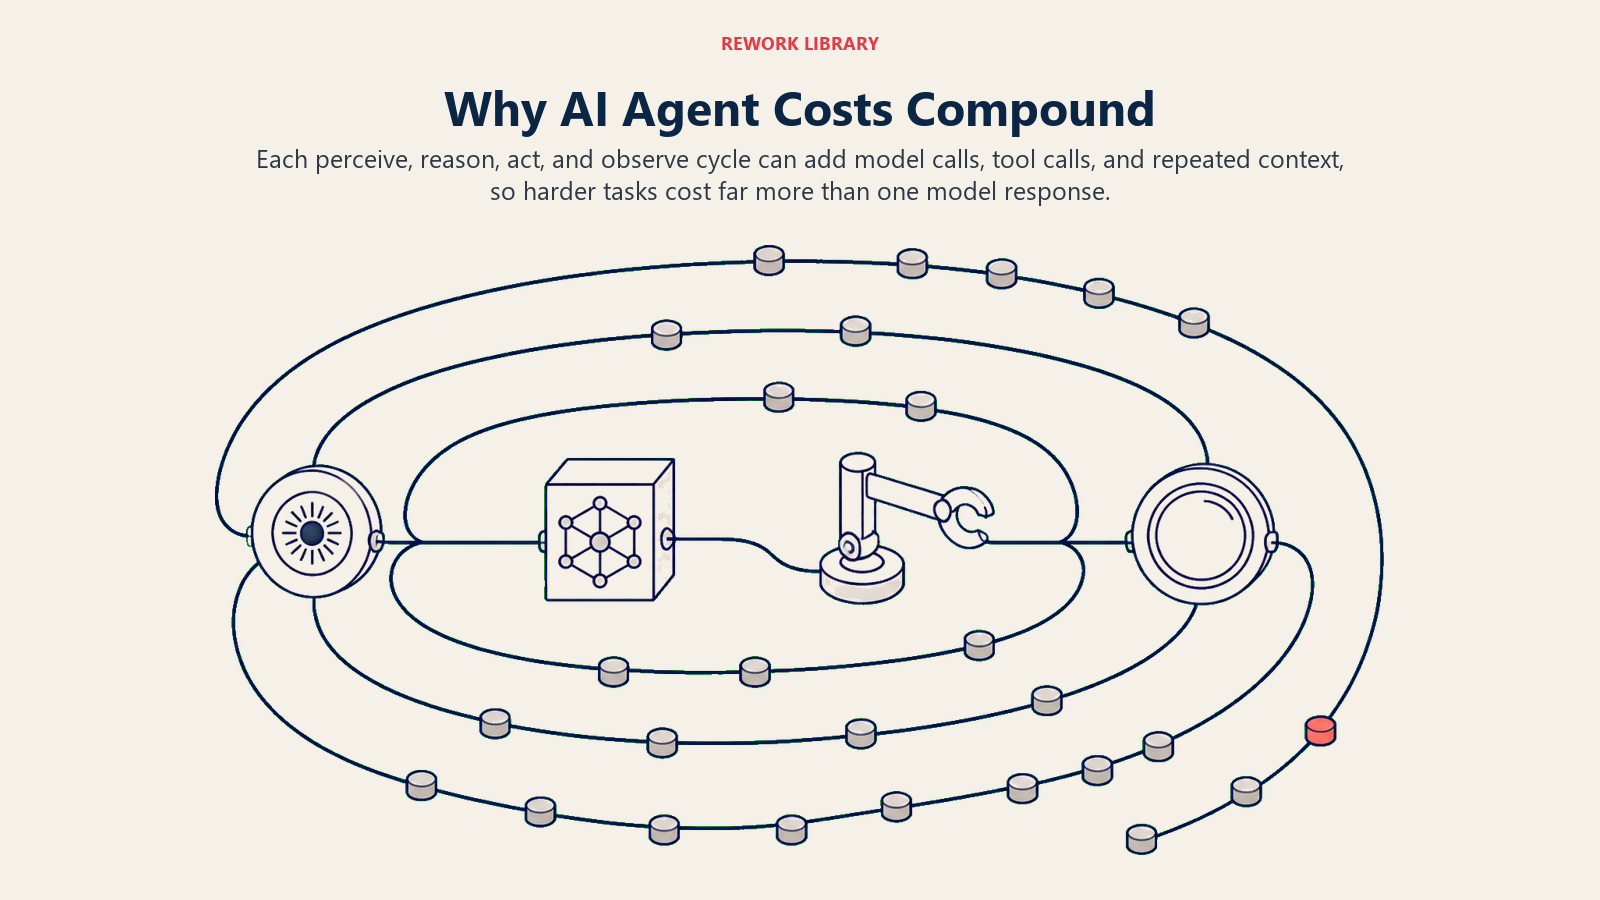
Satu panggilan model mempunyai satu input, satu output, satu harga. Cara AI agent berfungsi menghuraikan agent sebagai gelung: mengamati, menaakul, bertindak, memerhati, ulang, dan setiap pusingan melalui gelung itu boleh mencetuskan panggilan model atau panggilan alatnya sendiri. Tugas yang mengambil satu panggilan untuk kes mudah boleh mengambil lima, sepuluh, atau lebih untuk kes yang lebih sukar, dan setiap panggilan itu menghantar semula sejumlah konteks, jadi kos berkompaun dengan lelaran dengan cara yang tidak pernah berlaku pada satu panggilan.
Inilah sebabnya kos begitu kerap muncul sebagai alasan projek agentic terhenti. Gartner meramalkan bahawa lebih 40% projek agentic AI akan dibatalkan menjelang akhir 2027, dengan menyebut kos yang meningkat, nilai perniagaan yang tidak jelas, dan kawalan risiko yang tidak mencukupi sebagai punca utama. Kos yang meningkat jarang mengejutkan jika anda memodelkannya sebelum berkembang. Apabila corak AI menjadi mahal pada skala besar menghuraikan bagaimana Autonomous Agent tanpa kawalan menukar satu tiket sokongan kepada 25 panggilan model, bukannya dua atau tiga yang diandaikan oleh projek perintis. Tiga tuas di bawah ialah cara anda menghalang perkara itu daripada berlaku kepada anda.
Tuas 1: Caching, Supaya Anda Tidak Membayar untuk Konteks yang Sama Dua Kali
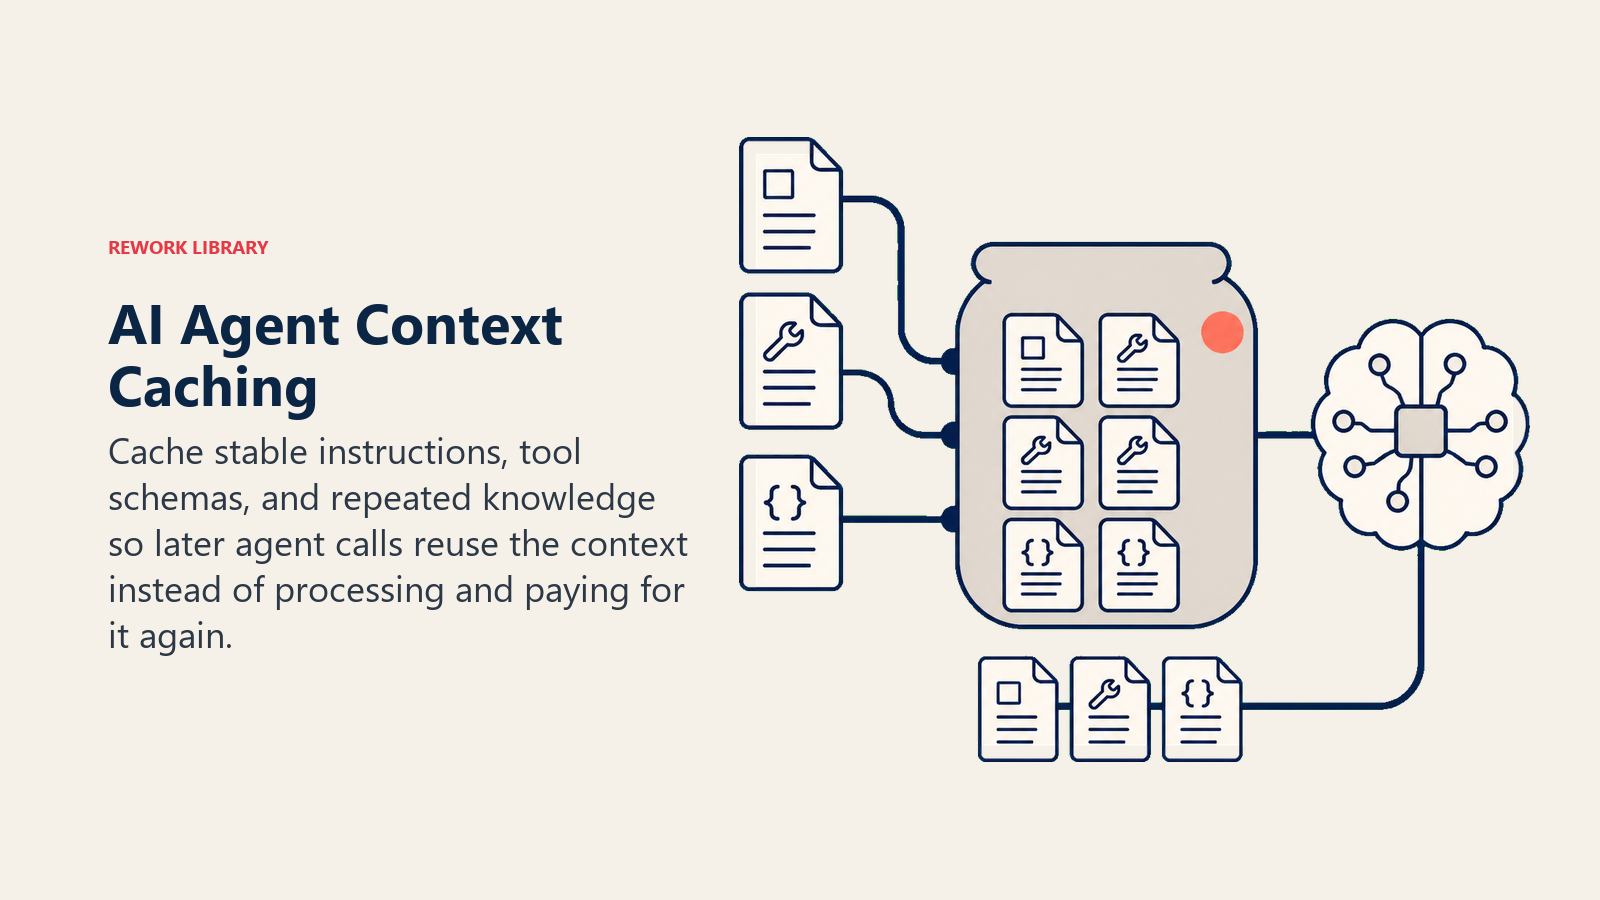
Setiap larian agent menghantar semula sebahagian konteks yang hampir tidak berubah dari satu panggilan ke satu panggilan: system prompt, skema alat, petikan pangkalan pengetahuan yang panjang, perbualan setakat ini. Caching bermaksud pembekal model mengingati bahagian itu dan mengenakan sebahagian kecil harga untuk menggunakannya semula dan bukan memprosesnya dari awal.
Diskaun itu nyata dan besar. Harga Anthropic sendiri menunjukkan token input yang dicache berharga 10% daripada harga input asas, pengurangan 90%, walaupun menulis kandungan baharu ke dalam cache berharga 25% lebih tinggi daripada panggilan biasa, jadi caching membawa pulangan sebaik sahaja prompt digunakan semula lebih daripada beberapa kali. OpenAI dan pembekal utama lain menawarkan versi diskaun token dicache masing-masing; mekanisme tepatnya berbeza mengikut vendor, tetapi ekonominya sama merentasi kesemuanya. Bagi kerja yang tidak memerlukan balasan segera (sapuan kebersihan CRM malam, pengelasan dokumen kelompok, penjanaan laporan semalaman), Batch API Anthropic menambah diskaun berasingan di atasnya: 50% daripada harga standard sebagai pertukaran untuk pemprosesan tak segerak dan bukan respons langsung.
Dua corak caching wajar dibina ke dalam agent sejak hari pertama:
- Caching konteks: cache system prompt, takrifan alat, dan sebarang dokumen rujukan statik yang besar (fail dasar, katalog produk) supaya hanya bahagian yang benar-benar berubah antara panggilan dikenakan harga penuh.
- Caching respons: bagi soalan yang benar-benar berulang (FAQ yang sama, pengelasan yang sama pada input yang hampir serupa), langkau panggilan model sepenuhnya dan hidangkan jawapan tersimpan, disegarkan mengikut jadual dan bukan dijana semula setiap kali.
Tuas 2: Penghalaan Model, Supaya Langkah Mudah Tidak Membayar Harga Frontier
Bukan setiap langkah dalam gelung agent memerlukan model anda yang paling berkebolehan dan paling mahal. Mengelaskan tiket, mengekstrak satu medan daripada borang, atau menyemak sama ada kes sepadan dengan senario yang diketahui ialah tugas berbeza daripada menulis balasan pelanggan yang bernuansa atau menaakul melalui pengecualian yang kabur, dan harga API yang diterbitkan merentasi setiap pembekal utama menunjukkan jurang satu magnitud, selalunya 10 kali ganda atau lebih, antara model kecil yang pantas dengan model utama frontier.
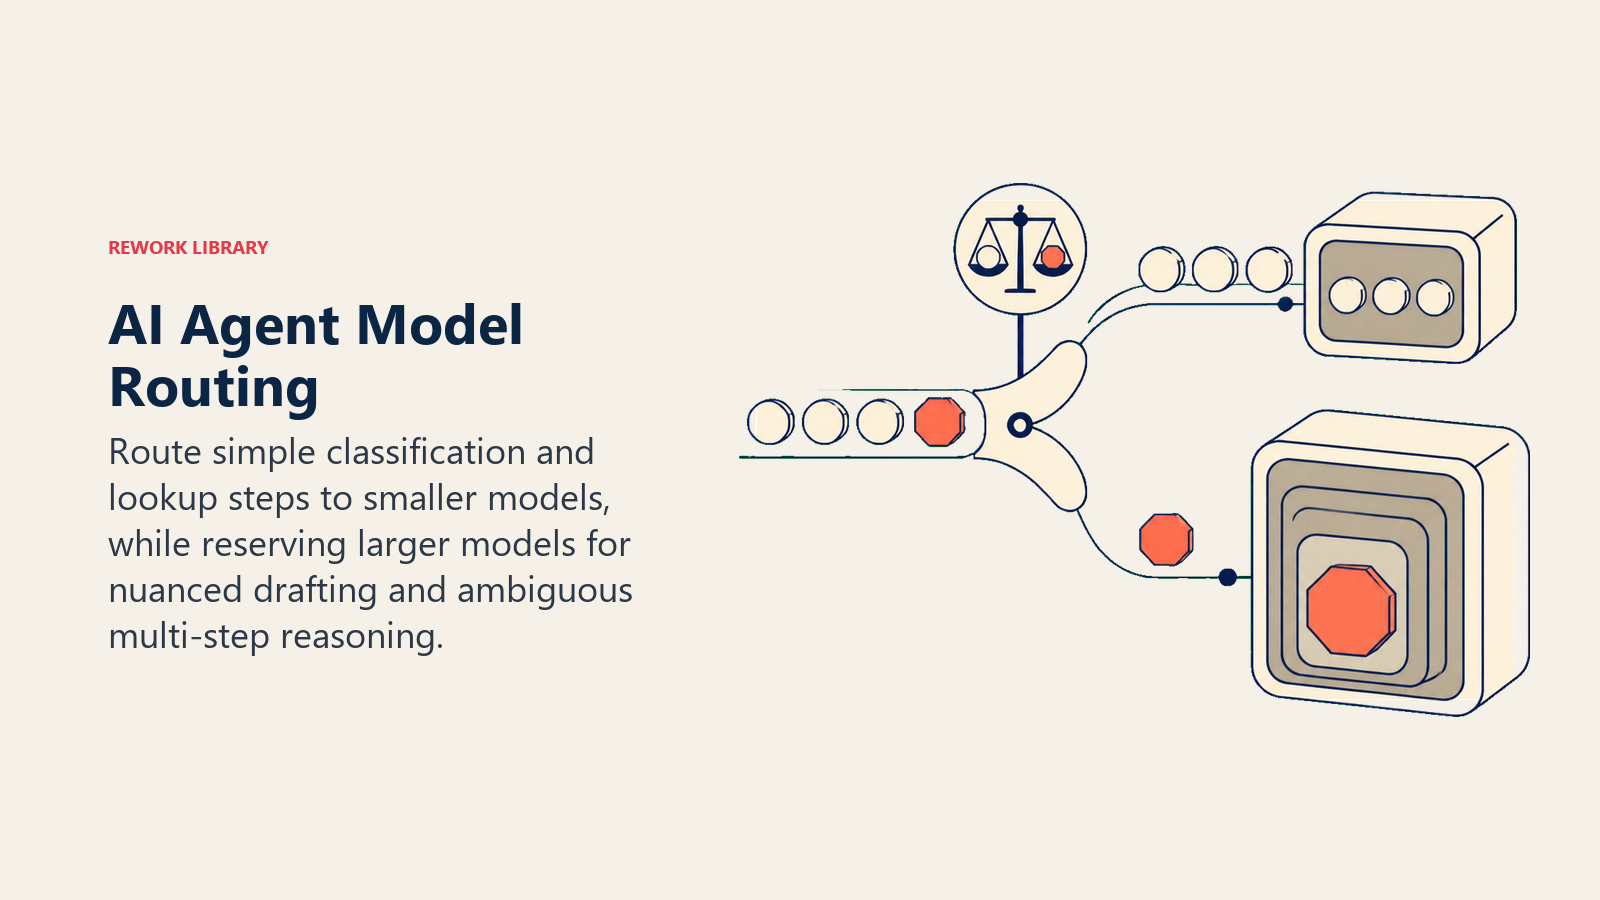
Penghalaan model bermaksud memadankan langkah dengan model dan bukan menjalankan seluruh agent pada satu peringkat secara lalai. Apabila corak AI menjadi mahal pada skala besar mendokumenkan idea yang sama dalam bahagian kos Workflow Copilot: menghalakan permintaan cadangan yang lebih mudah ke model yang lebih murah sambil menyimpan inferens premium untuk permintaan yang benar-benar memerlukannya. Jadual penghalaan ringkas untuk agent biasa:
| Jenis langkah | Contoh | Peringkat model |
|---|---|---|
| Pengelasan, pengekstrakan, keputusan penghalaan | Tiket ini tergolong dalam baris gilir yang mana? | Kecil, pantas, murah |
| Carian berstruktur dan pemadanan peraturan | Adakah invois ini sepadan dengan PO yang diluluskan? | Kecil hingga sederhana |
| Menulis teks yang berdepan pelanggan | Tulis balasan untuk kes khusus ini | Sederhana hingga besar |
| Pengecualian kabur dan penaakulan berbilang langkah | Kes ini tidak sepadan dengan mana-mana senario playbook | Terbesar yang ada |
Blok binaan logik keputusan yang memutuskan sama ada agent bertindak, bertanya, atau menyerahkan ialah tempat yang sama untuk penghalaan model. Anda sudah pun mencabangkan logik mengikut jenis kes. Halakan pilihan model melalui cabang yang sama dan bukan menganggapnya keputusan berasingan.
Tuas 3: Belanjawan Tegar, Supaya Tugas yang Tidak Terkawal Tidak Menaikkan Bil
Caching dan penghalaan merendahkan harga per panggilan. Belanjawan menghadkan berapa banyak panggilan yang dibenarkan untuk satu tugas, dan itu penting kerana lonjakan kos sebenar jarang datang daripada harga per panggilan. Ia datang daripada tugas yang terus memanggil model jauh lebih banyak kali daripada yang dirancang oleh sesiapa.
Apabila corak AI menjadi mahal pada skala besar menyatakannya dengan terus terang: Autonomous Agent tanpa had lelaran tegar dan belanjawan token per tugas ialah liabiliti kewangan, bukan alat produktiviti. Penyelesaiannya ialah dua tetapan, kedua-duanya mudah dinyatakan dan mudah dilangkau: bilangan maksimum panggilan model per tugas, dan penyerahan automatik kepada manusia apabila tugas mencapai had itu dan bukan terus membelanjakan. Kedua-duanya bukan sekadar tambahan yang baik untuk dibuat selepas bulan pertama yang mahal. Ia tergolong bersama setiap had tegar lain yang diperlukan agent. Guardrail AI agent membincangkan guardrail output dan panggilan alat dengan mendalam, dan had belanjawan ialah guardrail seperti itu: peraturan yang kekal berkuat kuasa tanpa mengira betapa yakinnya agent bahawa satu lagi panggilan akan menyiapkan tugas.
Di Mana Ini Muncul dalam Agent Sebenar
Tuas ini bukan abstrak. Beberapa tempat dalam pustaka ini yang melakukannya dengan betul, atau salah, memberi kesan luar biasa pada bil:
- AI Research Agent: kos meningkat terus mengikut berapa banyak sumber yang ditarik ke dalam konteks per ringkasan. Mengehadkan bilangan sumber dan menghalakan langkah sintesis ke model peringkat sederhana dan bukan yang terbesar yang ada selalunya menjadi beza antara ringkasan $2 dengan $20.
- AI Knowledge Base Agent: dokumen dasar dan petikan FAQ yang sama diambil semula merentasi ratusan soalan serupa, menjadikannya salah satu tempat dengan pulangan tertinggi untuk mencache konteks dan bukan menghantar semula serpihan yang sama pada setiap pertanyaan.
- AI Support Triage Agent: volum panggilan yang tinggi bermakna penjimatan kecil per panggilan pun berganda dengan pantas. Menghalakan langkah pengelasan awal ke model kecil sambil menyimpan model lebih besar untuk menulis balasan sebenar menghalang volum daripada menjadi keseluruhan belanjawan.
Model Kos Ringkas Sebelum Anda Berkembang Melepasi Projek Perintis
Sebelum membawa agent daripada projek perintis kecil kepada volum sebenar, letakkan angka kasar pada empat perkara: purata token per panggilan (ukurlah, jangan teka), jangkaan volum panggilan pada skala pengeluaran, andaian kadar cache hit anda, dan pecahan penghalaan anda merentasi peringkat model. Darabkan pada 2 kali dan 5 kali volum projek perintis, bukan hanya pada volum projek perintis, kerana projek perintis berjalan pada kes yang paling mudah dan paling mewakili, manakala pengeluaran tidak begitu. Apabila corak AI menjadi mahal pada skala besar mengesyorkan menambah penimbal 50-100% pada apa sahaja yang dicadangkan oleh sampel anda, atas sebab yang sama.
Nombor lain yang wajar dimodelkan awal ialah kos berbanding hasil, bukan kos berbanding aktiviti. Mengukur ROI corak AI membincangkan pembingkaian itu dengan lebih mendalam: agent yang lebih murah tetapi gagal separuh daripada tugasnya sebenarnya tidak lebih murah apabila anda mengira masa manusia yang dihabiskan membersihkan selepasnya. Dan pandang satu peringkat lebih luas: inferens agent hanyalah satu item baris dalam gambaran jumlah kos pemilikan AI yang lebih luas yang turut merangkumi bakat, integrasi, dan tadbir urus, jadi menguasai satu tuas ini tidak bermakna selebihnya belanjawan AI akan terurus dengan sendirinya.
Memantau Kos Selepas Pelancaran
Pengoptimuman semasa pelancaran akan hanyut tanpa pemantauan selepas pelancaran. Kebolehperhatian AI agent sudah menamakan metrik yang paling penting di sini: kos per tugas selesai, bukan kos per larian, kerana larian yang gagal tetap menggunakan token dan larian murah yang gagal dua kali sebelum berjaya sebenarnya tidak murah. Jejaki nombor itu bersama kadar cache hit dan taburan peringkat model anda, dan beri perhatian apabila mana-mana satu daripada ketiga-tiganya hanyut: kos per tugas selesai yang meningkat, kadar cache hit yang menurun, atau peralihan ke peringkat mahal pada jenis langkah yang dahulunya dihalakan ke peringkat murah. Mana-mana daripada tiga itu biasanya tanda paling awal bahawa sesuatu dalam input atau tingkah laku agent telah berubah, jauh sebelum bil memberitahu anda.
Jika anda membandingkan platform untuk membina atau menjalankan agent, kebolehramalan kos wajar dinilai secara eksplisit dan bukan diandaikan serupa merentasi vendor. Perbandingan alat AI kami menilai platform melebihi senarai ciri, dan kad skor penilaian vendor SaaS memberi anda templat berpemberat untuk meletakkan kebolehramalan kos setaraf dengan keupayaan semasa menilai pilihan.
Fakta Utama
- Token input yang dicache berharga 90% lebih rendah daripada harga input standard pada model Anthropic (10% daripada harga asas untuk dibaca dari cache), manakala menulis kandungan baharu ke dalam cache berharga 25% lebih tinggi, jadi caching membawa pulangan pada apa sahaja yang digunakan semula lebih daripada sekali atau dua kali.
- Pemprosesan kelompok untuk kerja agent bukan masa nyata menambah diskaun 50% berasingan di atas harga API standard.
- Gartner meramalkan lebih 40% projek agentic AI akan dibatalkan menjelang akhir 2027, dengan kos yang meningkat antara punca utama yang disebut.
- Harga model yang diterbitkan merentasi pembekal utama lazimnya menunjukkan jurang satu magnitud antara model kecil yang pantas dengan model utama frontier, yang menjadikan penghalaan mengikut kesukaran tugas tuas dengan leverage tertinggi yang belum digunakan oleh kebanyakan pasukan.
- Kawalan kewangan yang paling penting bagi agent yang berulang ialah had tegar pada panggilan model per tugas dengan penyerahan automatik apabila ia dicapai, bukan harga per panggilan yang lebih rendah.
Soalan Lazim tentang Pengoptimuman Kos AI Agent
Apakah pengoptimuman kos AI agent?
Ia set teknik yang memastikan perbelanjaan token dan pengkomputeran agent seiring dengan apa yang disampaikannya: mencache konteks berulang supaya anda tidak membayar untuk memprosesnya semula, menghalakan langkah mudah ke model lebih murah dan langkah sukar ke model lebih berkebolehan, dan menghadkan berapa banyak yang boleh dibelanjakan oleh satu tugas sebelum ia diserahkan kepada seseorang.
Mengapakah AI agent lebih mahal dijalankan berbanding satu panggilan model?
Agent menjalankan gelung, mengamati, menaakul, bertindak, memerhati, ulang, dan setiap pusingan boleh mencetuskan panggilan model atau panggilan alatnya sendiri. Tugas yang mengambil satu panggilan untuk kes mudah boleh mengambil jauh lebih banyak untuk kes yang lebih sukar, jadi kos berkompaun dengan bilangan lelaran dengan cara yang tidak pernah berlaku pada satu panggilan model.
Apakah perbezaan antara caching dan penghalaan model?
Caching merendahkan kos menggunakan semula konteks yang sudah dihantar kepada model, selalunya sebanyak 90% atau lebih pada bahagian yang dicache. Penghalaan model merendahkan kos dengan memadankan setiap langkah dengan model termurah yang mampu melakukannya dengan baik, dan bukan menjalankan setiap langkah pada model termahal anda secara lalai. Keduanya saling melengkapi, bukan alternatif.
Berapa banyak yang boleh dijimatkan oleh teknik ini?
Ia bergantung pada gabungan konteks berulang, volum panggilan, dan kerumitan tugas anda, tetapi diskaun asasnya besar: 90% diskaun pada token input yang dicache, 50% diskaun pada pemprosesan kelompok, dan lazimnya jurang harga satu magnitud antara model kecil dengan model frontier untuk langkah yang tidak memerlukan penaakulan frontier.
Apakah had belanjawan yang munasabah untuk tugas agent?
Tiada nombor universal, kerana ia bergantung pada kerumitan tugas, tetapi prinsipnya universal: tetapkan bilangan panggilan maksimum per tugas dan halakan kepada manusia secara automatik apabila ia dicapai, dan bukan membiarkan agent terus mencuba tanpa had. Anggaplah ia guardrail, bukan cadangan.
Langkah Seterusnya
Caching, penghalaan, dan belanjawan mengawal kos agent. Kebolehperhatian AI agent ialah cara anda mengesahkan kawalan itu masih berfungsi selepas pelancaran, kerana kos per tugas selesai ialah salah satu isyarat awal hanyutan yang paling jelas. Jika anda belum memodelkan mengapa kos meningkat pada skala besar, apabila corak AI menjadi mahal pada skala besar ialah bacaan yang lebih mendalam, dan cara membina AI agent menerangkan di mana had belanjawan sesuai dalam guardrail agent yang lain.

On this page
- Mengapa Lengkung Kos Agent Bukan Lengkung Kos Model
- Tuas 1: Caching, Supaya Anda Tidak Membayar untuk Konteks yang Sama Dua Kali
- Tuas 2: Penghalaan Model, Supaya Langkah Mudah Tidak Membayar Harga Frontier
- Tuas 3: Belanjawan Tegar, Supaya Tugas yang Tidak Terkawal Tidak Menaikkan Bil
- Di Mana Ini Muncul dalam Agent Sebenar
- Model Kos Ringkas Sebelum Anda Berkembang Melepasi Projek Perintis
- Memantau Kos Selepas Pelancaran
- Fakta Utama
- Langkah Seterusnya