CrewAIでAIエージェントを構築する:ステップバイステップのチュートリアル
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
CrewAIは、マルチエージェントのAIシステムを構築するためのオープンソースのPythonフレームワークです。役割とツールのセットを持つ個々のagentを定義し、タスクを与え、ひとつの成果に向けて協働する「crew」としてまとめて実行します。Lindyやn8nのようなビジュアルなno-codeビルダーに対する、コードファーストの代替手段であり、agentの推論、作業の引き継ぎ、ツール呼び出しの方法を直接コントロールしたいチーム向けに作られています。このガイドでは、インストール、動作するマルチエージェントcrewの構築、そして自社チームに適したプラットフォームかどうかの判断までを解説します。
CrewAIとは何か
CrewAIは、LangChainの上に構築されたレイヤーではなく、独立したPythonフレームワークです。agent、タスク、crew、オーケストレーションのための独自のプリミティブを備え、OpenAI、Anthropic、Ollama経由のローカルモデル、その他の主要なLLMプロバイダーの大半に対応します。コアフレームワークはMITライセンスのオープンソースです。別途、商用レイヤーのCrewAI Enterprise(AMPとも呼ばれます)があり、crewの運用や監視を自社で行いたくない組織向けに、ホスト型デプロイ、オブザーバビリティダッシュボード、チーム管理を提供します。
もはや趣味のプロジェクトの領域ではありません。Gartnerは、2026年末までにエンタープライズアプリケーションの40%にタスク特化型AIエージェントが搭載されると予測しています(2025年は5%未満)。またCrewAI自身のサイトでは、毎月4億5,000万件を超えるagenticワークフローがこのフレームワーク経由で実行されていると報告されており、DocuSign、Experian、PepsiCo、IBMなどの企業が導入しています。
マルチエージェントシステム専用に作られたコードフレームワークのひとつで、LangGraph、MicrosoftのAutoGen、OpenAI Agents SDKなどと並ぶ選択肢です。客観的に「最良」のものはありません。CrewAI独自の売りは、読みやすい役割ベースのAPIです。役割、目標、そしてトーンと判断を形づくるバックストーリーを使って、チームを説明するのと同じようにagentを記述します。そのため、グラフ中心のフレームワークと比べて、1年後に見返したときにcrewのロジックを理解しやすくなります。
Gartnerは別途、2024年第1四半期から2025年第2四半期にかけて、マルチエージェントシステムに関する顧客からの問い合わせが1,445%急増したことを追跡しています。CrewAIのようなフレームワークは、この需要に直接応えるものです。マルチエージェントシステムで解説しているオーケストレーター・ワーカーやピア間の引き継ぎのパターンを、調整ロジックをゼロから書かずに構築できます。
CrewAIの用語と6つの構成要素の対応
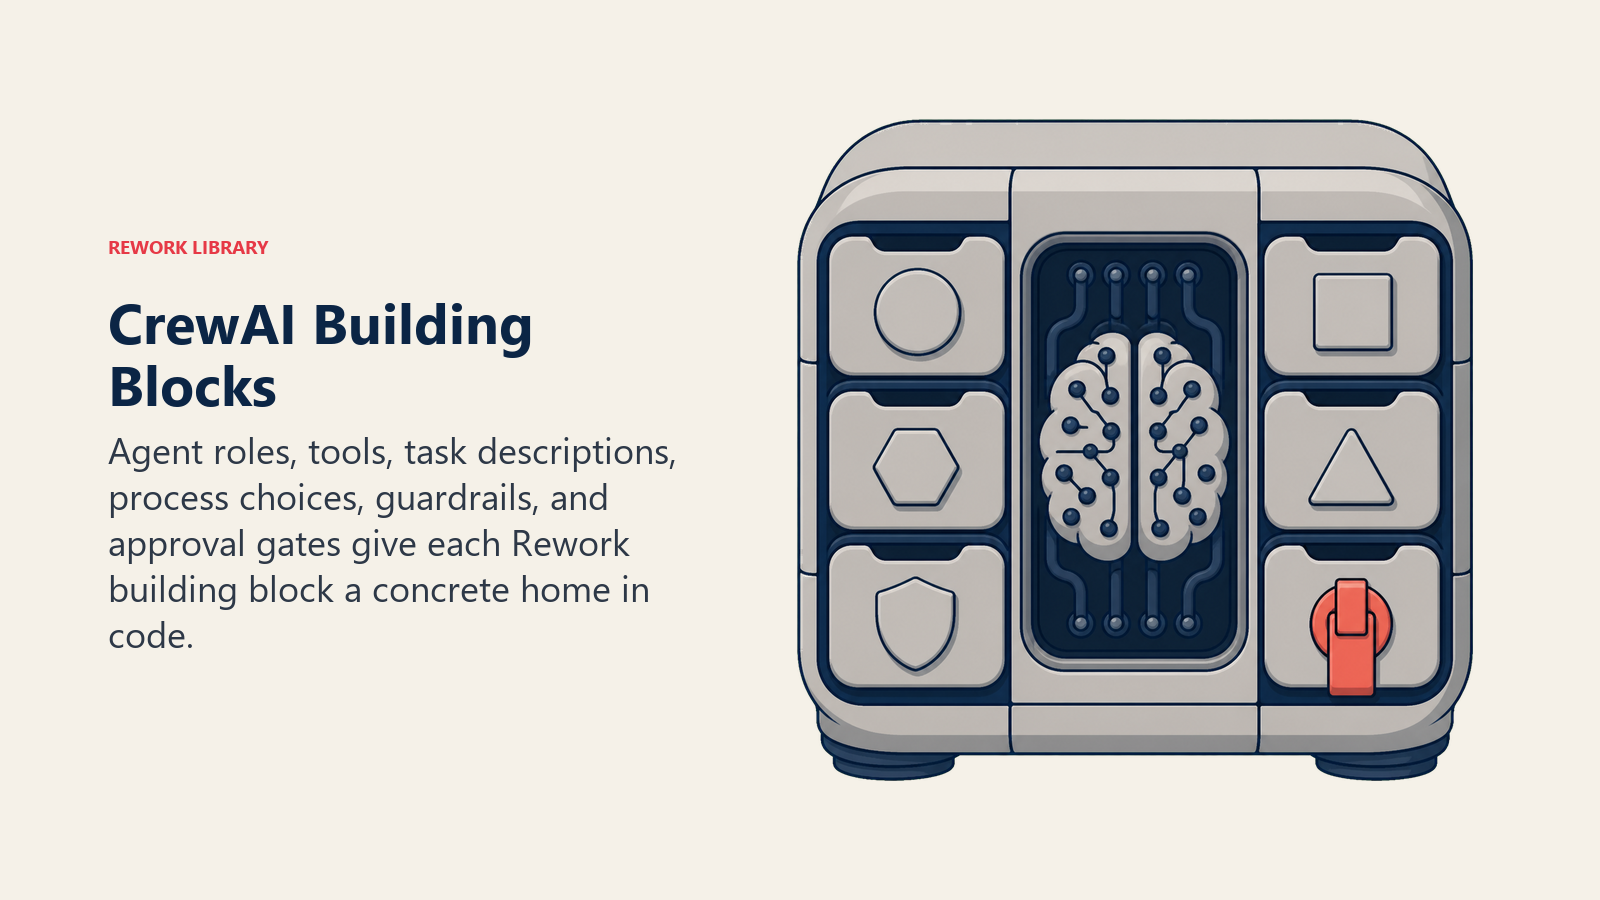
AIエージェントの構築方法をお読みであれば、すべてのagentに必要な6つの構成要素はすでにご存じのはずです。役割、ツール、ルール、シナリオプレイブック、意思決定ロジック、ガードレールです。CrewAIでは、それぞれがコード上に具体的な居場所を持っています。
| Reworkの構成要素 | CrewAIの概念 |
|---|---|
| 役割 | Agent(role=..., goal=..., backstory=...) |
| ツール | Agent(tools=[...])、組み込みまたはカスタムのToolオブジェクト |
| ルール | agentのバックストーリーとタスクの説明に埋め込まれた指示 |
| シナリオプレイブック | 説明と期待される出力を持つ個々のTaskオブジェクト |
| 意思決定ロジック | Process.sequentialまたはProcess.hierarchical、およびタスク内の条件ロジック |
| ガードレール | タスクレベルのguardrail関数と、human_input=Trueによる承認ゲート |
ここに概念的にCrewAI固有のものはありません。プラットフォームごとに違うのは、これをどれだけコードで書き、どれだけビジュアルに設定するかです。まさにこの問いに答えるために作られたのが、no-codeとコードのAIエージェントです。
CrewAIのインストール
CrewAIは、他のPythonパッケージと同じようにインストールできます。
pip install crewai
pip install 'crewai[tools]'
toolsエクストラを入れると、Web検索ツールやファイル操作ツールを含むCrewAI組み込みのツールライブラリが追加されるため、すべての連携を自分で書く必要がありません。使用するLLMプロバイダー(OpenAI、Anthropic、Ollama経由のローカルモデル)のAPIキーを環境変数に設定すれば、最初のcrewを定義する準備は完了です。
実例:3つのagentによるリサーチcrew
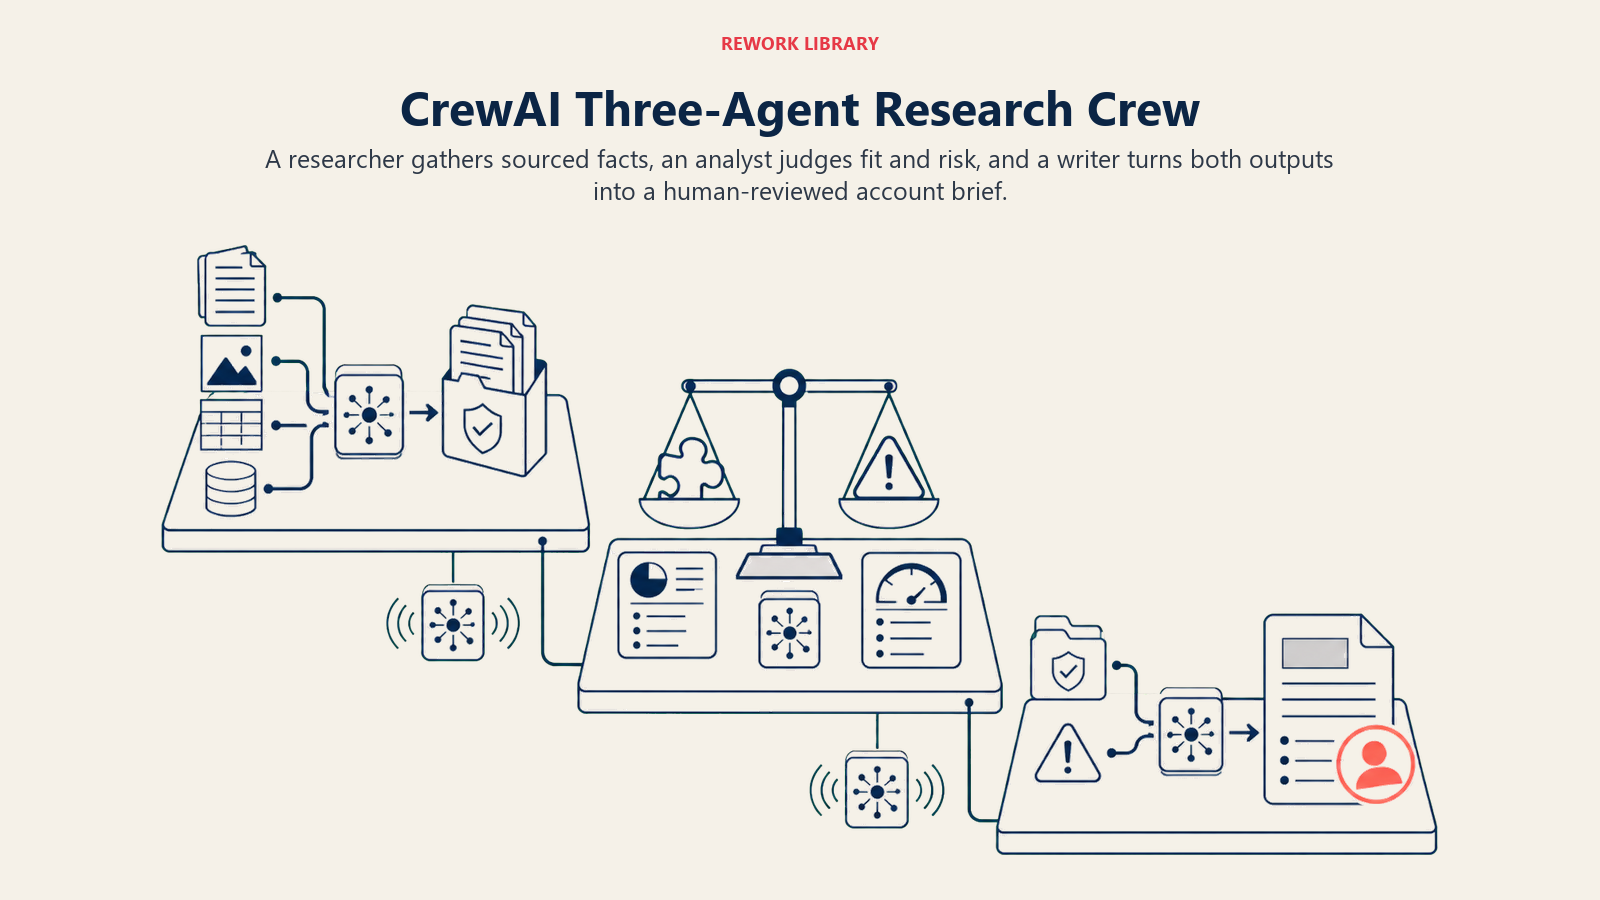
ここでは、3つのagentによる最小限のcrewを紹介します。Reworkの複数のブループリントが個別に担当している業務、つまりターゲットアカウントの調査、調査結果の分析、アウトプットの作成を再現したものです。AIアカウントリサーチエージェント、AI競合インテリジェンスエージェント、AIコンテンツドラフトエージェントが、3つの別々のツールではなく、ひとつの連携したcrewとして動くイメージです。
from crewai import Agent, Task, Crew, Process

researcher = Agent(
    role="Account Researcher",
    goal="Gather accurate, current facts about a target company",
    backstory="You research companies for a B2B sales team and never state a fact you can't source.",
    tools=[search_tool],
)

analyst = Agent(
    role="Competitive Analyst",
    goal="Turn raw research into a clear point of view on fit and risk",
    backstory="You've reviewed hundreds of accounts and know what actually predicts a good fit.",
)

writer = Agent(
    role="Brief Writer",
    goal="Draft a one-page account brief a rep can read in two minutes",
    backstory="You write tight, scannable briefs, never a wall of text.",
)

research_task = Task(
    description="Research {company}: recent news, tech stack, and org changes.",
    expected_output="A bulleted list of sourced facts.",
    agent=researcher,
)

analysis_task = Task(
    description="Assess fit and flag risks based on the research.",
    expected_output="A short fit score with reasoning.",
    agent=analyst,
    context=[research_task],
)

brief_task = Task(
    description="Draft a one-page brief combining the research and analysis.",
    expected_output="A one-page account brief.",
    agent=writer,
    context=[research_task, analysis_task],
    human_input=True,
)

crew = Crew(
    agents=[researcher, analyst, writer],
    tasks=[research_task, analysis_task, brief_task],
    process=Process.sequential,
)

result = crew.kickoff(inputs={"company": "Acme Corp"})
analysis_taskとbrief_taskのcontextパラメータが引き継ぎの役割を果たします。どの先行タスクの出力を次へ渡すかをCrewAIに伝えるもので、マルチエージェントシステムが、機能するチェーンと、気づかないうちに失敗するチェーンを分ける違いとして説明している構造化された引き継ぎそのものです。最後のタスクにhuman_input=Trueを設定すると、人間がブリーフをレビューしてから出荷されます。これは、AIエージェントのヒューマンインザループで解説しているゲートの簡易版です。
SequentialとHierarchicalのプロセス
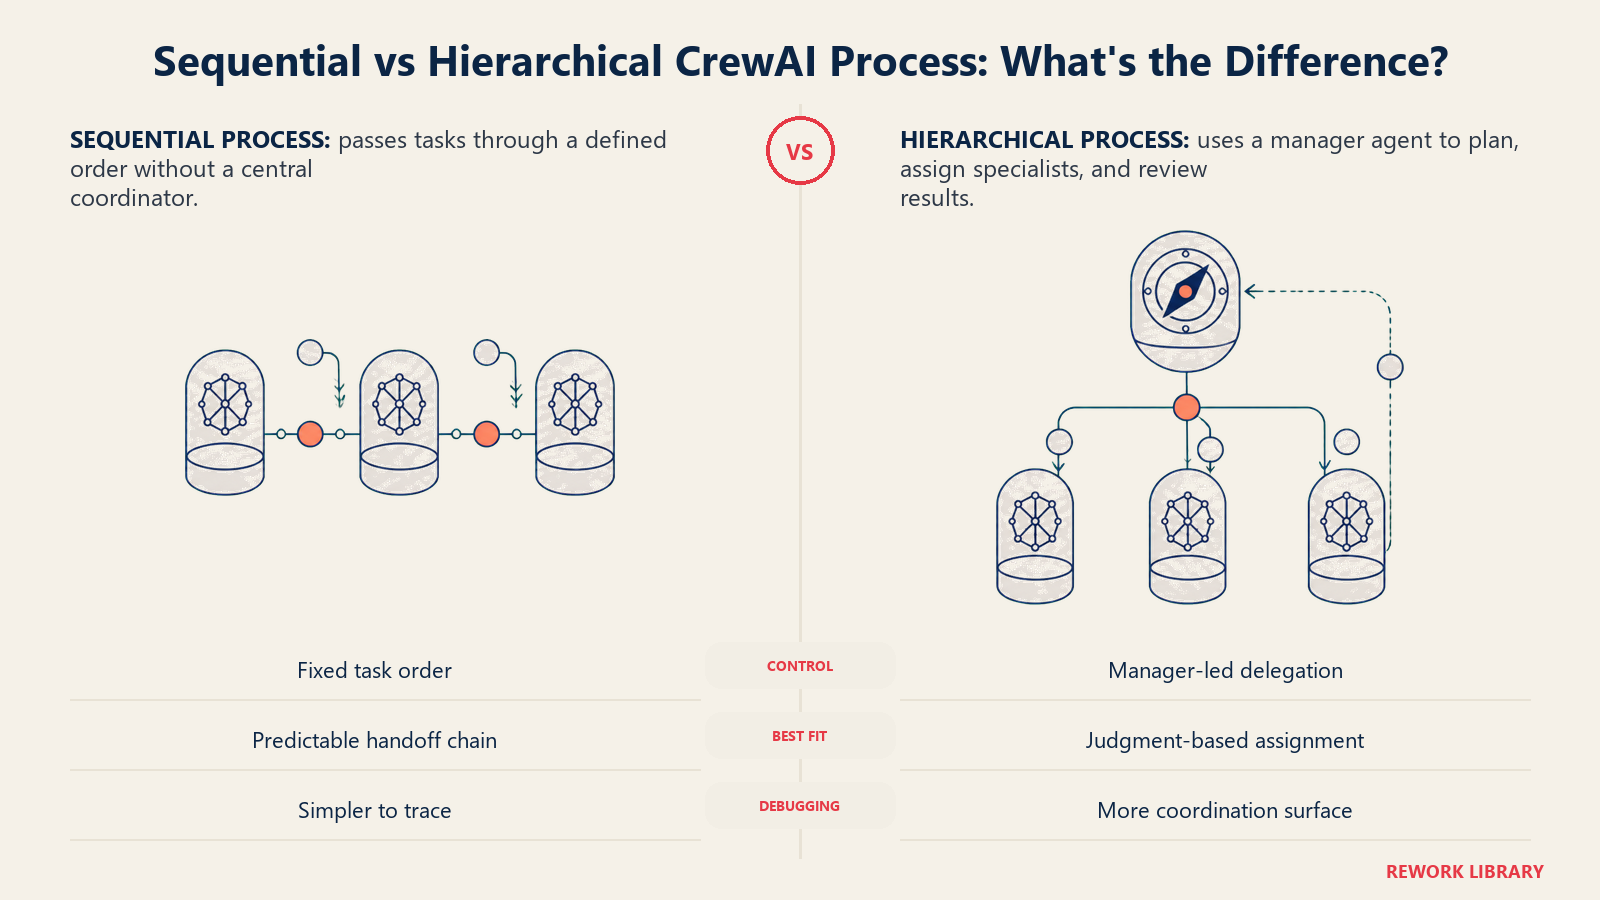
CrewAIには、crewを実行する方法が2つあり、マルチエージェントシステムで解説している2つの調整パターンにそのまま対応します。
| プロセス | 実行方法 | 対応するパターン |
|---|---|---|
Process.sequential |
タスクを記載した順に実行し、各タスクは必要に応じて先行タスクの出力を参照する | ピア間の引き継ぎ:定義済みのチェーンで、中央のコーディネーターはいない |
Process.hierarchical |
CrewAIがマネージャーagentを割り当て、計画を立て、適切なagentにタスクを委任し、結果をレビューする | オーケストレーター・ワーカー:中央のagentがスペシャリストを呼び出す |
まずsequentialから始めてください。実行順序が書いたとおりになるため、考えやすく、デバッグも容易です。hierarchicalに移るのは、次に何をすべきかが、単に「タスク1の後にタスク2を実行する」ではなく、本当に判断に依存するようになってからにしましょう。
ツール、メモリ、RAG
ツールのないagentは話すことしかできません。CrewAIのagentは、どのagentとも同じ方法でツールを呼び出します。詳しくはAIエージェントはどのようにツールを使うかで解説していますが、名前、説明、そしてモデルが埋めるスキーマで構成されます。CrewAIには、検索ツール、ファイルとディレクトリのツール、コードインタープリタが最初から備わっており、それ以外はPythonのカスタム関数をそのままツールとして受け付けます。
メモリは3つのレベルで機能します。ひとつのcrew実行の一貫性を保つ短期メモリ、実行をまたいで事実を保持する長期メモリ、そしてcrewがこれまでに遭遇した特定の人物、企業、レコードを追跡するエンティティメモリです。AIエージェントのメモリでは、この一般的な内容と、プラットフォームを問わず当てはまる落とし穴を解説しています。たとえば、メモリストアが古くなる、agentが古いコンテキストを実際より新しいものとして扱うといった問題です。
モデルの一般知識ではなく、自社のドキュメントにcrewをグラウンディングしたい場合、CrewAIはagentまたはcrewに紐づけられるナレッジソースに対応しています。これは、AIエージェントのためのRAGで解説している検索パターンのCrewAI版です。
公開前のガードレールとテスト
CrewAIでガードレールの役割を主に担うのは、2つの機能です。タスクレベルのguardrail関数は、agentの出力が受け入れられる前に検証し、「ブリーフには少なくとも1つの出典を明記する」といった自分で定義したチェックに通らなければ、却下または再試行させます。human_input=Trueフラグは、crewが先へ進む前に、人間が出力をレビューまたは編集できるようタスクを一時停止させます。どちらも、AIエージェントのガードレールで解説している、agentが自分では決して越えてはならない一線という考え方に対応します。
1つの入力でテストが成功しただけで、そのままcrewを出荷しないでください。AIエージェントの評価とテスト方法では、CrewAIで構築したものかどうかを問わず、agentが本番の処理量に触れる前に、過去のケースから実際のテストセットを作る方法を解説しています。
コストと制限
フレームワーク自体の実行にはコストがかかりません。支払うのはLLMのAPI利用料で、マルチエージェントのcrewは、同じ業務をこなす単一のagentよりも速くトークンを消費します。すべてのagentの推論と引き継ぎごとに、それぞれ呼び出しが発生するためです。3つのagentによるsequentialのcrewにhierarchicalのマネージャーを加えると、適切にスコープされた単一のagentなら1〜2回で済むタスクに、モデル呼び出しが4〜6回かかることも珍しくありません。これは、マルチエージェントシステムでより詳しく解説しているレイテンシとコストのトレードオフと同じです。agentが増えるほど調整の面が広がり、調整の面が広がるほど、実行にもデバッグにもコストがかかります。
レート制限はCrewAIではなく、LLMプロバイダーによるものです。hierarchicalのcrewや、複数のagent呼び出しを並列に実行する場合、フレームワーク自体の制限に達するよりもずっと前に、プロバイダーのレート制限に達します。CrewAI Enterpriseには利用状況ダッシュボードがあり、crewごとにこのコストを可視化できます。本番環境で複数のcrewを運用するようになり、どれが高コストなのかを把握する必要が出てきた段階で役立ちます。
CrewAIと代替ツールの選び方
| こんな場合は… | 検討すべきもの |
|---|---|
| コードを書かずに構築したいビジネスチーム | no-codeプラットフォーム。no-codeとコードのAIエージェントを参照 |
| マルチエージェントの業務向けの、読みやすい役割ベースのAPI | CrewAI |
| グラフとして、状態や分岐ロジックを細かくコントロールしたい | LangGraph |
| 既存のLangChainパイプラインとの緊密な統合 | LangGraphまたはLangChainネイティブのagent |
| マルチエージェントではなく、適切にスコープされた単一のagent | マルチエージェントフレームワークは見送り、AIエージェントの構築方法を参照 |
Key Facts
- CrewAIは、マルチエージェントシステムを構築するための、独立したオープンソースのPythonフレームワーク(MITライセンス)です。ホスト型デプロイとオブザーバビリティのための商用レイヤー、CrewAI Enterpriseも提供されています。
- 4つのコアコンセプトであるAgent、Task、Crew、Processは、Reworkが提唱するあらゆるagentの6つの構成要素(役割、ツール、ルール、プレイブック、意思決定ロジック、ガードレール)に直接対応します。
Process.sequentialはピア間の引き継ぎの調整パターンに、Process.hierarchicalはオーケストレーター・ワーカーに対応し、CrewAIが委任を行うマネージャーagentを自動で割り当てます。- Gartnerは、2024年第1四半期から2025年第2四半期にかけて、マルチエージェントシステムに関する顧客からの問い合わせが1,445%急増したと記録しており、CrewAIのようなフレームワークはこの需要曲線に応えるために作られています。
- マルチエージェントのcrewは、同じ業務をこなす適切にスコープされた単一のagentよりも、トークンとレイテンシのコストが高くなります。すべてのagentと引き継ぎごとに、モデル呼び出しが発生するためです。
次のステップ
CrewAIは、マルチエージェントシステムへの道のひとつであり、唯一のものではありません。コードとno-codeプラットフォームのどちらがチームに合うかをまだ決めかねているなら、no-codeとコードのAIエージェントで、その判断をそのまま解説しています。crewがテストで安定して動くようになったら、AIエージェントの本番デプロイで、実際の処理量を任せる前のロールアウト、モニタリング、ロールバックの計画を解説しています。また、日常的にPythonで作業することをチームが望まない場合は、開発ツールのまとめとAIコーディングアシスタントの購入ガイドが、コードそのものをより速く書き、保守するための次の参考になります。
