AI Agent Cost Optimization: Caching, Model Routing und Budgets
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI Agent Cost Optimization ist die Gesamtheit der Techniken, die die Token- und Rechenkosten eines Agents im Verhältnis zu dem Wert halten, den er liefert: Caching, damit der Agent nicht erneut für Kontext zahlt, den er bereits verarbeitet hat; Model Routing, damit einfache Schritte auf günstigen und schwierige Schritte auf teuren Modellen laufen; und harte Budgets, die begrenzen, wie viel eine einzelne Aufgabe ausgeben darf, bevor sie an einen Menschen übergibt. Nichts davon ist optional, sobald ein Agent die Pilotphase verlässt. Ein Agent, der in Schleifen läuft, Tools aufruft und bei jedem Durchlauf Kontext neu liest, kann aus einer Demo, die Cent kostete, eine Produktivaufgabe machen, die Dollar kostet, und die Lücke geht fast immer auf einen dieser drei Hebel zurück, nicht auf das Modell selbst.
Warum die Kostenkurve eines Agents nicht die Kostenkurve eines Modells ist
Ein einzelner Modellaufruf hat eine Eingabe, eine Ausgabe, einen Preis. Wie AI Agents funktionieren beschreibt einen Agent stattdessen als Schleife: wahrnehmen, schlussfolgern, handeln, beobachten, wiederholen, und jeder Durchlauf kann einen eigenen Modell- oder Tool-Aufruf auslösen. Eine Aufgabe, die im einfachen Fall einen Aufruf braucht, kann im schwierigeren Fall fünf, zehn oder mehr brauchen, und jeder dieser Aufrufe sendet erneut eine gewisse Menge Kontext mit, sodass die Kosten mit den Iterationen zusammengesetzt wachsen, wie es bei einem einzelnen Aufruf nie der Fall ist.
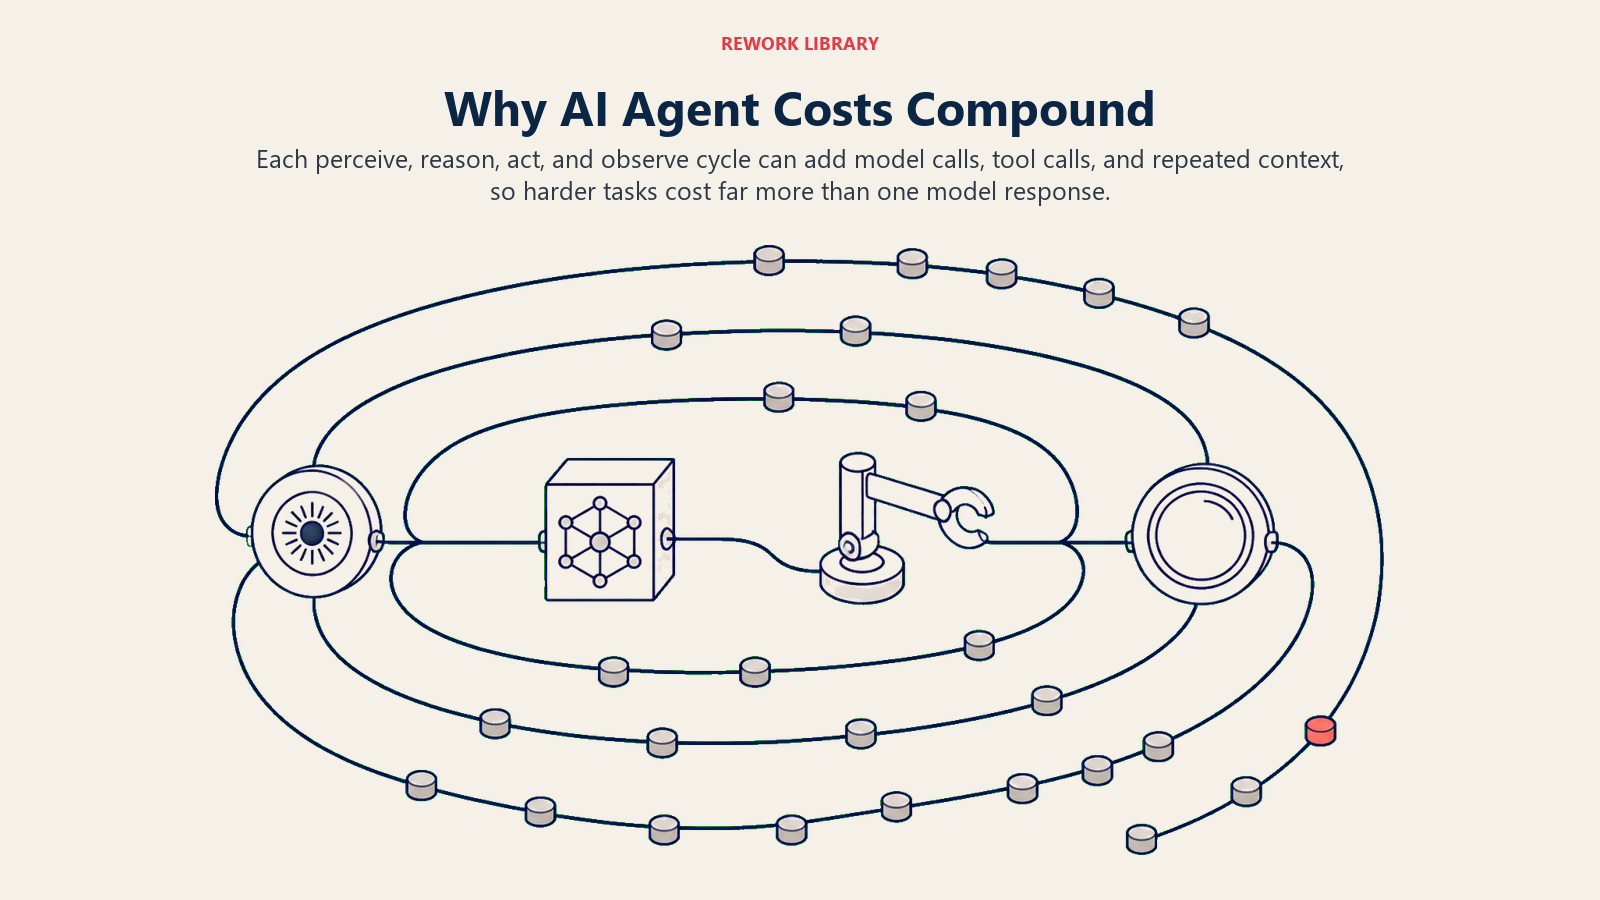
Genau deshalb tauchen Kosten so oft als Grund auf, warum Agentic-Projekte ins Stocken geraten. Gartner prognostiziert, dass über 40 % der Agentic-AI-Projekte bis Ende 2027 eingestellt werden, und nennt als Hauptursachen steigende Kosten, unklaren Geschäftsnutzen und unzureichende Risikokontrollen. Steigende Kosten sind selten eine Überraschung, wenn Sie sie vor der Skalierung modellieren. Wenn AI Patterns im großen Maßstab teuer werden zeigt, wie ein Autonomous Agent ohne Kontrollen aus einem einzigen Support-Ticket 25 Modellaufrufe machte statt der zwei oder drei, die ein Pilot angenommen hatte. Die drei folgenden Hebel verhindern, dass Ihnen das passiert.
Hebel 1: Caching, damit Sie nicht zweimal für denselben Kontext zahlen
Jeder Agent-Lauf sendet einen Block Kontext erneut mit, der sich von Aufruf zu Aufruf kaum ändert: den System Prompt, die Tool-Schemas, einen langen Auszug aus der Wissensbasis, die bisherige Konversation. Caching bedeutet, dass sich der Modellanbieter diesen Block merkt und für seine Wiederverwendung nur einen Bruchteil des Preises berechnet, statt ihn von Grund auf neu zu verarbeiten.
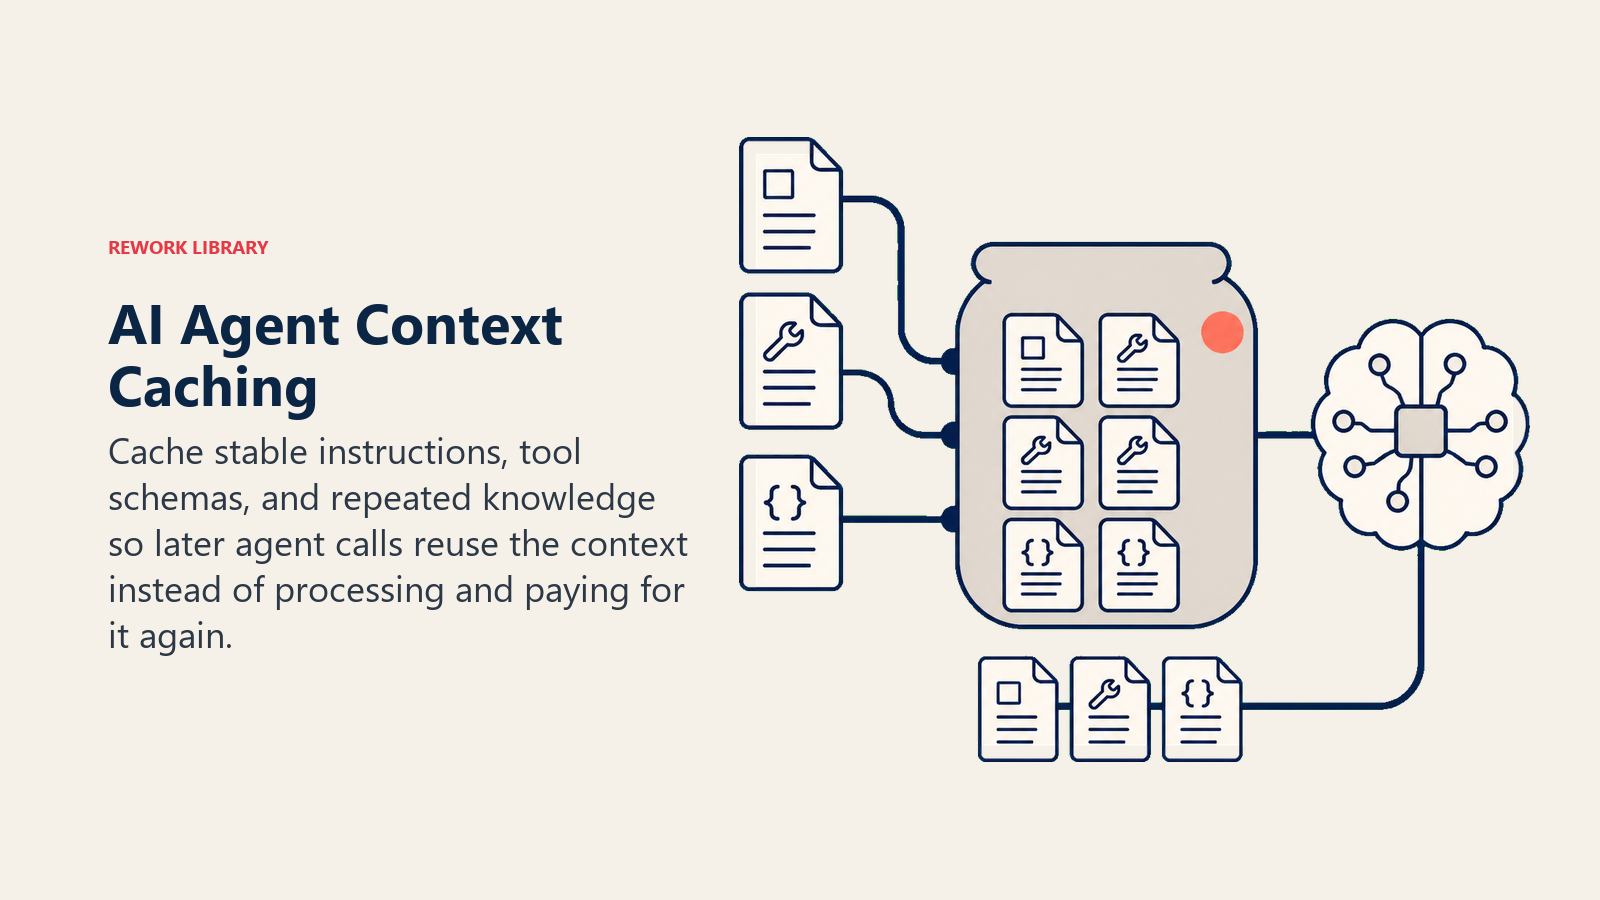
Der Rabatt ist real und groß. Die eigene Preisgestaltung von Anthropic zeigt, dass gecachte Eingabe-Tokens 10 % des Basis-Eingabepreises kosten, also 90 % weniger, wobei das Schreiben neuer Inhalte in den Cache 25 % mehr kostet als ein normaler Aufruf. Caching lohnt sich also, sobald ein Prompt mehr als ein paar Mal wiederverwendet wird. OpenAI und andere große Anbieter bieten ihre eigene Variante von Rabatten auf gecachte Tokens an; der genaue Mechanismus unterscheidet sich je nach Anbieter, die Wirtschaftlichkeit ist aber bei allen dieselbe. Für Arbeit, die keine sofortige Antwort braucht (nächtliche CRM-Datenpflege, Batch-Klassifizierung von Dokumenten, Berichtserstellung über Nacht), legt die Batch API von Anthropic einen separaten Rabatt obendrauf: 50 % Nachlass auf den Standardpreis im Gegenzug für asynchrone Verarbeitung statt einer Live-Antwort.
Zwei Caching-Muster sollten Sie von Anfang an in einen Agent einbauen:
- Context Caching: Cachen Sie den System Prompt, die Tool-Definitionen und jedes große statische Referenzdokument (eine Richtliniendatei, einen Produktkatalog), damit nur die Teile, die sich zwischen Aufrufen tatsächlich ändern, zum vollen Preis berechnet werden.
- Response Caching: Bei wirklich wiederholten Fragen (dieselbe FAQ, dieselbe Klassifizierung bei nahezu identischen Eingaben) überspringen Sie den Modellaufruf ganz und liefern eine gespeicherte Antwort aus, die planmäßig aktualisiert wird, statt jedes Mal neu generiert zu werden.
Hebel 2: Model Routing, damit einfache Schritte keine Spitzenpreise zahlen
Nicht jeder Schritt in der Schleife eines Agents braucht Ihr leistungsfähigstes, teuerstes Modell. Ein Ticket zu klassifizieren, ein Feld aus einem Formular zu extrahieren oder zu prüfen, ob ein Fall zu einem bekannten Szenario passt, ist eine andere Aufgabe als eine nuancierte Kundenantwort zu formulieren oder eine mehrdeutige Ausnahme durchzudenken, und die veröffentlichten API-Preise aller großen Anbieter zeigen eine Größenordnung Unterschied, oft 10x oder mehr, zwischen einem kleinen schnellen Modell und einem Frontier-Flaggschiffmodell.
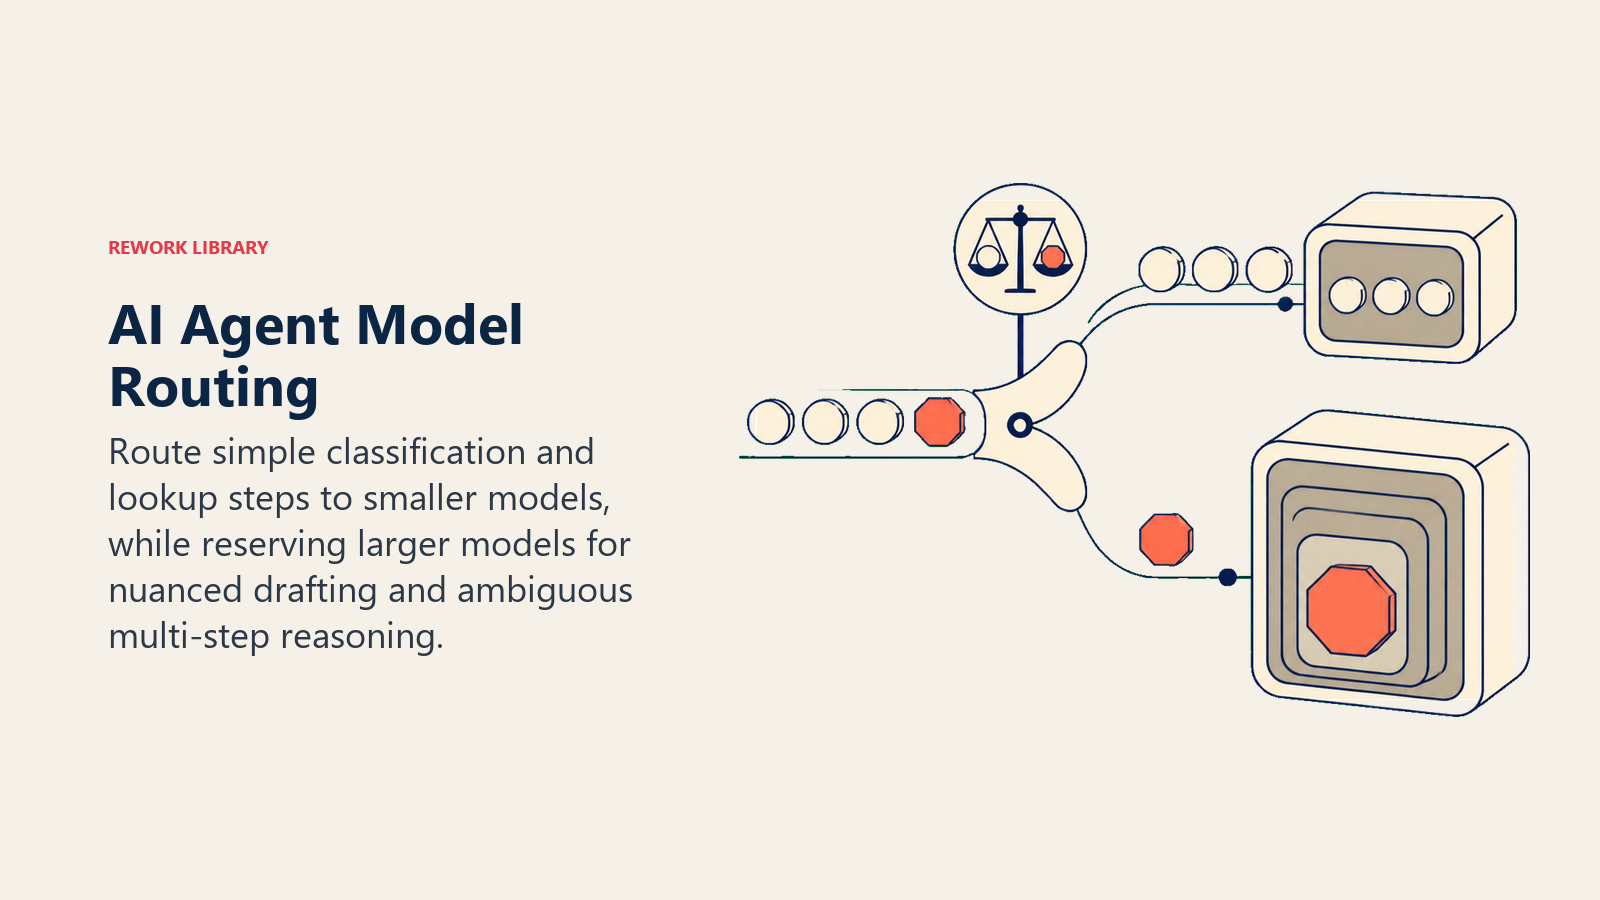
Model Routing bedeutet, den Schritt zum Modell passend zuzuordnen, statt den ganzen Agent standardmäßig auf einer einzigen Stufe laufen zu lassen. Wenn AI Patterns im großen Maßstab teuer werden dokumentiert dieselbe Idee in seinem Abschnitt zu den Kosten des Workflow Copilot: einfachere Vorschlagsanfragen an günstigere Modelle zu leiten und Premium-Inferenz für die Anfragen aufzuheben, die sie wirklich brauchen. Eine einfache Routing-Tabelle für einen typischen Agent:
| Schritttyp | Beispiel | Modellstufe |
|---|---|---|
| Klassifizierung, Extraktion, Routing-Entscheidungen | In welche Queue gehört dieses Ticket? | Klein, schnell, günstig |
| Strukturierte Lookups und Regelabgleich | Passt diese Rechnung zu einer freigegebenen Bestellung? | Klein bis mittel |
| Formulieren von kundenorientiertem Text | Schreibe die Antwort für diesen konkreten Fall | Mittel bis groß |
| Mehrdeutige Ausnahmen und mehrstufiges Schlussfolgern | Dieser Fall passt zu keinem Szenario des Playbooks | Größtes verfügbares Modell |
Der Baustein Entscheidungslogik, der festlegt, ob ein Agent handelt, nachfragt oder übergibt, ist genau die Stelle, an die Model Routing gehört. Sie verzweigen die Logik ohnehin schon nach Falltyp. Leiten Sie die Modellwahl über dieselbe Verzweigung, statt sie als separate Entscheidung zu behandeln.
Hebel 3: Harte Budgets, damit eine ausufernde Aufgabe die Rechnung nicht hochtreibt
Caching und Routing senken den Preis pro Aufruf. Budgets begrenzen, wie viele Aufrufe eine einzelne Aufgabe machen darf, und das ist wichtig, denn die echten Kostenexplosionen entstehen selten durch den Preis pro Aufruf. Sie entstehen durch eine Aufgabe, die das Modell weit öfter aufruft, als irgendjemand geplant hat.
Wenn AI Patterns im großen Maßstab teuer werden bringt es unverblümt auf den Punkt: Ein Autonomous Agent ohne harte Iterationsgrenzen und Token-Budgets pro Aufgabe ist ein finanzielles Risiko, kein Produktivitätswerkzeug. Die Lösung besteht aus zwei Einstellungen, beide einfach zu formulieren und leicht zu überspringen: eine maximale Anzahl von Modellaufrufen pro Aufgabe und eine automatische Übergabe an einen Menschen, wenn die Aufgabe diese Grenze erreicht, statt weiter Geld auszugeben. Beides ist kein Nice-to-have, das Sie nach dem ersten teuren Monat nachrüsten. Es gehört zu jeder anderen harten Grenze, die ein Agent braucht. AI Agent Guardrails behandelt Ausgabe- und Tool-Aufruf-Leitplanken ausführlich, und eine Budgetgrenze ist genau eine solche Leitplanke: eine Regel, die gilt, unabhängig davon, wie sicher der Agent ist, dass ein weiterer Aufruf die Aufgabe abschließt.
Wo sich das in echten Agents zeigt
Diese Hebel sind nicht abstrakt. Einige Stellen in dieser Bibliothek, an denen es einen überproportionalen Effekt auf die Rechnung hat, ob man sie richtig oder falsch einsetzt:
- AI Research Agent: Die Kosten skalieren direkt damit, wie viele Quellen er pro Briefing in den Kontext zieht. Die Quellenzahl zu begrenzen und den Syntheseschritt an ein mittleres Modell statt an das größte verfügbare zu leiten, ist oft der Unterschied zwischen einem Briefing für 2 \(und einem für 20\).
- AI Knowledge Base Agent: Dieselben Richtliniendokumente und FAQ-Auszüge werden bei Hunderten ähnlicher Fragen abgerufen. Damit ist er einer der Orte mit dem höchsten Nutzen für das Caching von Kontext, statt bei jeder Anfrage dieselben abgerufenen Abschnitte erneut zu senden.
- AI Support Triage Agent: Das hohe Aufrufvolumen bedeutet, dass sich selbst eine kleine Einsparung pro Aufruf schnell vervielfacht. Den ersten Klassifizierungsschritt an ein kleines Modell zu leiten und ein größeres für das Formulieren der eigentlichen Antwort aufzuheben, verhindert, dass das Volumen zum gesamten Budget wird.
Ein einfaches Kostenmodell, bevor Sie über den Pilot hinaus skalieren
Bevor Sie einen Agent von einem kleinen Pilot auf echtes Volumen bringen, hinterlegen Sie grobe Zahlen für vier Dinge: durchschnittliche Tokens pro Aufruf (messen Sie es, raten Sie nicht), erwartetes Aufrufvolumen im Produktivmaßstab, Ihre Annahme zur Cache-Trefferquote und Ihre Routing-Aufteilung auf die Modellstufen. Rechnen Sie das bei 2x und 5x Pilotvolumen durch, nicht nur beim Pilotvolumen, denn Piloten laufen mit den einfachsten, repräsentativsten Fällen und die Produktion nicht. Wenn AI Patterns im großen Maßstab teuer werden empfiehlt genau aus diesem Grund, auf das, was Ihre Stichproben nahelegen, einen Puffer von 50 bis 100 % aufzuschlagen.
Die andere Zahl, die sich früh zu modellieren lohnt, sind die Kosten im Verhältnis zum Ergebnis, nicht zur Aktivität. AI Pattern ROI messen geht tiefer auf diese Betrachtung ein: Ein günstigerer Agent, der die Hälfte seiner Aufgaben nicht schafft, ist nicht wirklich günstiger, wenn Sie die menschliche Zeit für das Aufräumen danach einrechnen. Und eine Ebene weiter gedacht: Agent-Inferenz ist ein Posten innerhalb des umfassenderen Bildes der Gesamtbetriebskosten von AI, zu dem auch Talent, Integration und Governance gehören. Diesen einen Hebel richtig zu setzen heißt also nicht, dass sich der Rest des AI-Budgets von selbst erledigt.
Kosten nach dem Go-live beobachten
Die Optimierung zum Start driftet ohne Überwachung nach dem Start. AI Agent Observability nennt bereits die wichtigste Kennzahl dafür: Kosten pro abgeschlossener Aufgabe, nicht Kosten pro Lauf, denn ein Lauf, der scheitert, hat trotzdem Tokens verbraucht, und ein günstiger Lauf, der zweimal scheitert, bevor er gelingt, ist nicht wirklich günstig. Verfolgen Sie diese Zahl zusammen mit der Cache-Trefferquote und Ihrer Verteilung auf die Modellstufen, und achten Sie darauf, wenn eine der drei driftet: steigende Kosten pro abgeschlossener Aufgabe, fallende Cache-Trefferquote oder eine Verschiebung zur teuren Stufe bei Schritttypen, die früher günstig geroutet wurden. Jedes dieser drei Signale ist meist das früheste Zeichen dafür, dass sich etwas an den Eingaben oder dem Verhalten des Agents geändert hat, lange bevor die Rechnung es Ihnen sagt.
Wenn Sie Plattformen vergleichen, auf denen Sie Agents bauen oder betreiben wollen, lohnt es sich, die Kostenplanbarkeit ausdrücklich zu bewerten, statt anzunehmen, sie sei bei allen Anbietern ähnlich. Unsere Vergleiche von AI-Tools bewerten Plattformen nach mehr als Funktionslisten, und die Bewertungsmatrix für SaaS-Anbieter liefert Ihnen eine gewichtete Vorlage, um Kostenplanbarkeit bei der Bewertung von Optionen gleichrangig neben die Leistungsfähigkeit zu stellen.
Key Facts
- Gecachte Eingabe-Tokens kosten bei den Modellen von Anthropic 90 % weniger als der Standard-Eingabepreis (10 % des Basispreises für das Lesen aus dem Cache), während das Schreiben neuer Inhalte in den Cache 25 % mehr kostet. Caching lohnt sich also bei allem, was mehr als ein- oder zweimal wiederverwendet wird.
- Batch-Verarbeitung für Agent-Arbeit ohne Echtzeitbedarf bringt einen separaten Rabatt von 50 % auf den Standard-API-Preis obendrauf.
- Gartner prognostiziert, dass über 40 % der Agentic-AI-Projekte bis Ende 2027 eingestellt werden, wobei steigende Kosten zu den am häufigsten genannten Ursachen zählen.
- Veröffentlichte Modellpreise der großen Anbieter zeigen typischerweise eine Größenordnung Unterschied zwischen kleinen, schnellen Modellen und Frontier-Flaggschiffmodellen. Deshalb ist Routing nach Aufgabenschwierigkeit der Hebel mit der größten Wirkung, den die meisten Teams noch nicht nutzen.
- Die wichtigste Finanzkontrolle für einen Agent in einer Schleife ist eine harte Obergrenze für Modellaufrufe pro Aufgabe mit automatischer Übergabe bei Erreichen, nicht ein niedrigerer Preis pro Aufruf.
Häufig gestellte Fragen zu AI Agent Cost Optimization
Was ist AI Agent Cost Optimization?
Es ist die Gesamtheit der Techniken, die die Token- und Rechenkosten eines Agents im Verhältnis zu seinem Nutzen halten: wiederholten Kontext cachen, damit Sie nicht für seine erneute Verarbeitung zahlen, einfache Schritte an günstigere und schwierige Schritte an leistungsfähigere Modelle leiten und begrenzen, wie viel eine einzelne Aufgabe ausgeben darf, bevor sie an einen Menschen übergibt.
Warum kostet der Betrieb von AI Agents mehr als ein einzelner Modellaufruf?
Ein Agent durchläuft eine Schleife aus wahrnehmen, schlussfolgern, handeln, beobachten und wiederholen, und jeder Durchlauf kann einen eigenen Modell- oder Tool-Aufruf auslösen. Eine Aufgabe, die im einfachen Fall einen Aufruf braucht, kann im schwierigeren Fall deutlich mehr brauchen, sodass die Kosten mit der Zahl der Iterationen zusammengesetzt wachsen, wie es bei einem einzelnen Modellaufruf nie der Fall ist.
Was ist der Unterschied zwischen Caching und Model Routing?
Caching senkt die Kosten für die Wiederverwendung von Kontext, den Sie bereits an das Modell gesendet haben, beim gecachten Teil oft um 90 % oder mehr. Model Routing senkt die Kosten, indem es jeden Schritt dem günstigsten Modell zuordnet, das ihn gut erledigen kann, statt jeden Schritt standardmäßig auf Ihrem teuersten Modell laufen zu lassen. Beides ergänzt sich, es sind keine Alternativen.
Wie viel können diese Techniken tatsächlich einsparen?
Das hängt von Ihrem Mix aus wiederholtem Kontext, Aufrufvolumen und Aufgabenkomplexität ab, doch die zugrunde liegenden Rabatte sind erheblich: 90 % Nachlass auf gecachte Eingabe-Tokens, 50 % auf Batch-Verarbeitung und typischerweise eine Größenordnung Preisunterschied zwischen kleinen und Frontier-Modellen bei den Schritten, die kein Frontier-Schlussfolgern brauchen.
Was ist eine angemessene Budgetgrenze für eine Agent-Aufgabe?
Es gibt keine allgemeingültige Zahl, da sie von der Aufgabenkomplexität abhängt, aber das Prinzip gilt immer: Legen Sie eine maximale Aufrufzahl pro Aufgabe fest und leiten Sie automatisch an einen Menschen weiter, wenn sie erreicht ist, statt den Agent unbegrenzt weiterprobieren zu lassen. Behandeln Sie sie als Leitplanke, nicht als Empfehlung.
Wie es weitergeht
Caching, Routing und Budgets steuern, was ein Agent kostet. AI Agent Observability ist der Weg, um nach dem Start zu bestätigen, dass diese Kontrollen noch wirken, denn die Kosten pro abgeschlossener Aufgabe sind eines der klarsten frühen Signale für Drift. Wenn Sie noch nicht modelliert haben, warum Kosten im großen Maßstab eskalieren, ist wenn AI Patterns im großen Maßstab teuer werden die tiefere Lektüre, und Wie Sie einen AI Agent bauen zeigt, wo Budgetgrenzen unter den übrigen Leitplanken eines Agents ihren Platz haben.

On this page
- Warum die Kostenkurve eines Agents nicht die Kostenkurve eines Modells ist
- Hebel 1: Caching, damit Sie nicht zweimal für denselben Kontext zahlen
- Hebel 2: Model Routing, damit einfache Schritte keine Spitzenpreise zahlen
- Hebel 3: Harte Budgets, damit eine ausufernde Aufgabe die Rechnung nicht hochtreibt
- Wo sich das in echten Agents zeigt
- Ein einfaches Kostenmodell, bevor Sie über den Pilot hinaus skalieren
- Kosten nach dem Go-live beobachten
- Key Facts
- Wie es weitergeht