AI Agentのメモリ:短期記憶、長期記憶、ベクトルストア
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI agentのメモリとは、agentがすでに起きたことを把握し続ける仕組みです。1つのタスクの内側でも、同じアカウントやユーザーとのこの先のあらゆるやり取りをまたいでも機能します。短期記憶(ワーキングメモリ)は現在の実行を保持し、agentが同じことを繰り返したり、話の筋を見失ったりしないようにします。長期記憶(永続メモリ)は、多くの場合、agentが検索できるデータベースやベクトルストアに保存され、事実や履歴をセッションをまたいで保持するため、agentが毎回ゼロから始めずに済みます。どちらかが欠けると、agentは直前にやったことを忘れるか、会話が終わった瞬間にあなたについて学んだことをすべて忘れてしまいます。
agentにメモリが必要な理由
メモリは、ソフトウェアを単なるチャットボットやスクリプトではなく、agentたらしめる5つの要素の1つです。ほかの要素は、知覚、推論、ツール、制限付きの自律性です。素の言語モデルには、デフォルトではメモリがありません。何かを尋ねれば答えますが、それまでの会話全体を貼り付け直さない限り、次の質問はまっさらな状態から始まります。1回きりの質問ならそれで問題ありません。しかし、タスクが2ステップ以上になった途端に破綻します。
営業のフォローアップシーケンスを実行するagentを想像してください。AI Follow-Up Agentが実例です。ステップ1が送信されます。3日経っても返信はありません。ステップ2は、ステップ1とは違う切り口で送る必要があります。同じ提案を繰り返せばスパムのように読まれ、営業担当者ならそんなことはしません。agentがメッセージを変えるべきだと分かる唯一の方法は、すでに何を、誰に送り、相手がどう反応したかを覚えていることです。これは、あれば便利という程度ではなく、メモリが実際に役割を果たしている場面です。
短期記憶:1回の実行の一貫性を保つもの
短期記憶、つまりワーキングメモリは、現在進行中のタスクに関係するすべてを保持します。ここまでの会話、すでに実行したステップ、実行の途中にある計画などです。通常はモデルのコンテキストウィンドウ、つまりモデルが一度に考慮できるテキストの量の内側に存在し、何かが意図的にそれをより永続的な場所に書き込まない限り、タスクが終わると消えます。
ここでの現実的な限界は、どれだけのテキストを収められるかだけではありません。コンテキストウィンドウは非常に大きくなり、最新のフロンティアモデルでは数十万トークンから100万トークン超のウィンドウを備えています。しかし、ウィンドウが大きいことは、その中のすべてを確実に使えることと同じではありません。Chromaの2025年のロングコンテキスト性能に関する調査は、主要な18のモデルをテストし、モデルの余裕がなくなるよりずっと前に精度が低下し始めることがあると報告しています。20万トークンのウィンドウで、5万トークンあたりから低下し始める場合もあり、100万トークンのウィンドウを持つモデルが、100万トークン全体を確実に推論できるわけではありません。研究者らは、200万トークンのモデルでも、高い精度が求められる作業で安全に使える範囲は、表示されている数字よりずっと小さい、15万から40万トークン前後にとどまる傾向があると指摘しています。関連して広く引用されている学術研究、Liuらの「Lost in the Middle」は、長いコンテキストの中で、先頭や末尾に置かれた情報は、中間に埋もれた情報よりも明らかによく使われることを示しました。長い入力を扱えるよう明示的に作られたモデルでも同じ傾向でした。
agentを構築する人にとっての教訓は、コンテキストウィンドウを無制限の作業スペースとして扱わないことです。念のためにと、過去のメッセージ、取得したドキュメント、ツールの結果をすべて詰め込むと、性能は向上せず、むしろ低下します。ワーキングメモリは現在のステップが実際に必要とするものに絞り、それ以外はagentが必要に応じて照会できる長期ストレージに移してください。
長期記憶:現在の実行より先まで残るもの
長期記憶は、アカウント、好み、履歴を毎回ゼロから学び直すのではなく、agentが1回のやり取りから次のやり取りまで一貫して振る舞えるようにするものです。モデルの外部にあり、通常はデータベース、CRM、または高速な類似度検索のために作られたベクトルデータベースに保存され、agentはほかのツールと同じように、それを照会します。
実際によく見られる長期記憶の形は3つあります。
- エピソード記憶。特定の過去の出来事の記録です。たとえば、顧客が前回何を尋ねたか、以前のミーティングで何が決まったかなどです。Meeting Notes Agentはその直接的な例です。決定事項とアクションアイテムを、構造化されたタイムスタンプ付きの記録として残します。まさに、将来「これはすでに約束したか」と尋ねたときに、肩をすくめられるのではなく、検索できる実際の答えがあるようにするためです。
- 意味記憶。時間をかけてパターンから学んだ、一般化された事実や好みです。特定のアカウントは常に300語以内のエグゼクティブサマリーを求める、あるいは、ある顧客セグメントはサポートへのエスカレーションの後に解約しやすい、といった知識です。
- 手続き的コンテキスト。複数のステップ、複数のセッションにまたがるプロセスが現在どこまで進んでいるかという状態です。AI Customer Onboarding Agentは、数週間続くこともあるプロセスの中で、アカウントがどのセットアップのマイルストーンをすでに完了したかを記憶している必要があります。そうすることで、すでに終わった手順を繰り返したり、さらに悪いことに、未完了の手順を飛ばしたりせずに、次の未完了のステップを促せます。
長期記憶は実際にどう保存され、検索されるのか
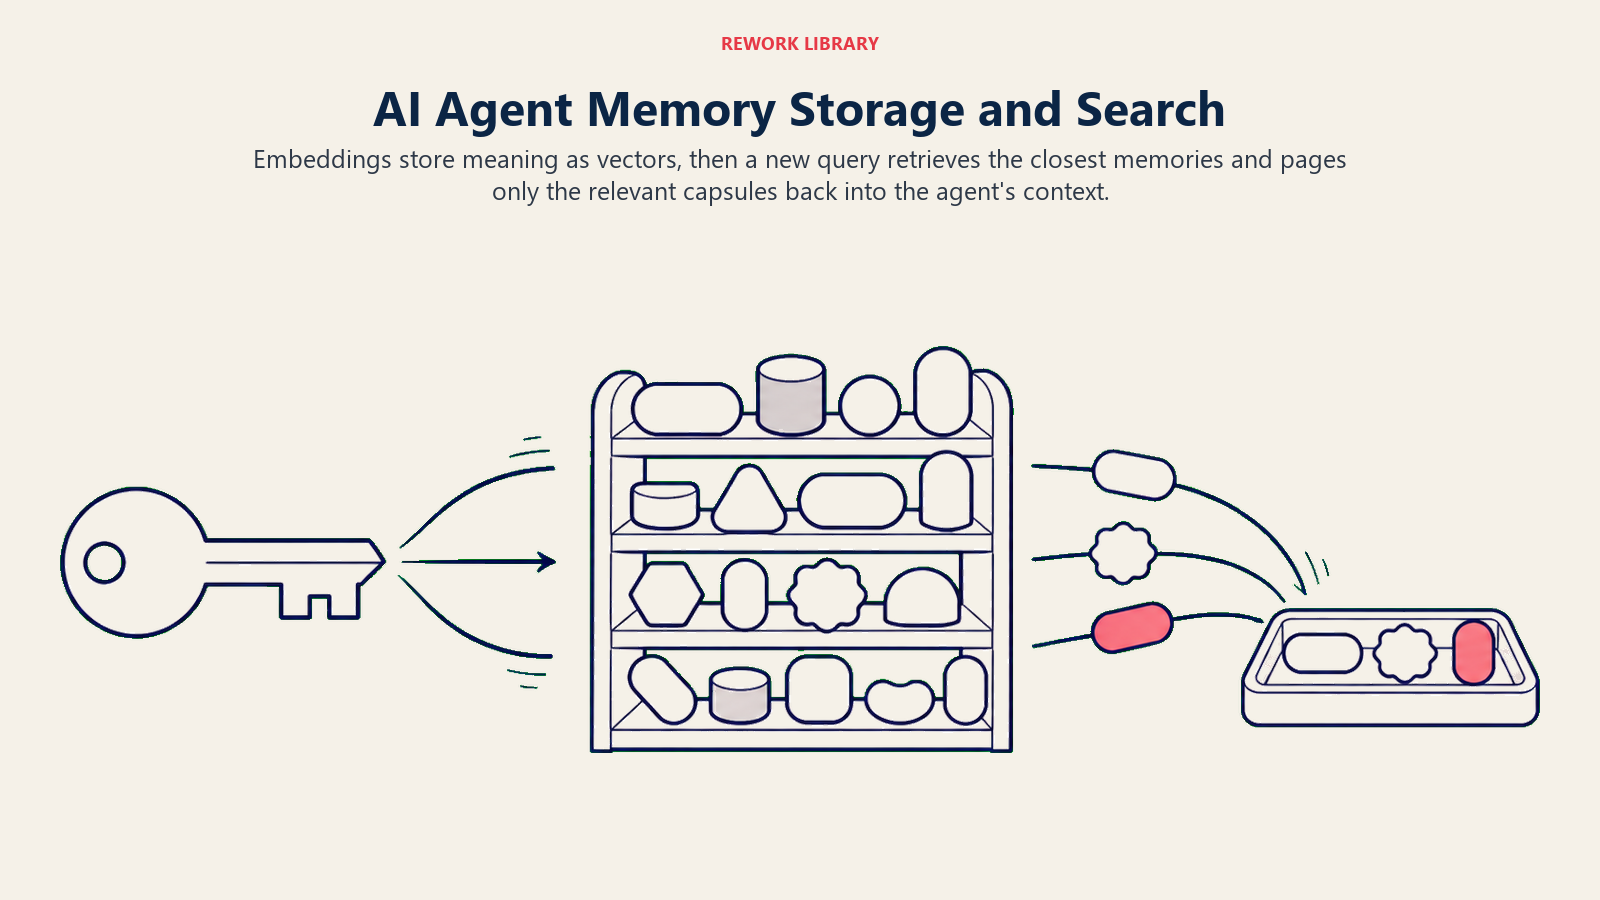
正確なIDで引くのではなく、意味で検索する必要がある長期記憶の多くは、最終的にベクトルデータベースに行き着きます。事実、過去の会話、ドキュメントのチャンクは、埋め込みモデルによって、その意味を表す数値表現であるベクトルに変換され、クエリも同じ方法で変換されます。システムは、クエリに最も近い保存済みのベクトルを探します。そのため、3か月前にまったく違う言い回しで記録された「クライアントのデータ保管場所に関する希望」であっても、agentは取り出せます。これは、AI agentのためのRAGで取り上げているのと同じ基本的な仕組みです。長期記憶と検索拡張生成(RAG)は、しばしば同一のインフラ上で動きます。違いは、取り出し方よりも、保存されているものにあります。agent自身が蓄積した履歴か、会社の参照ドキュメントかです。
影響力のあるアーキテクチャの提案であるMemGPTは、これをうまく言い表しています。オペレーティングシステムの階層型メモリの考え方を借りて、少量の「ホット」な情報だけをモデルの直近のコンテキストに置き、それ以外はより低速で大容量の外部ストレージに移し、実際に必要になったときだけ情報を呼び戻します。論文の実装に触れることがなくても、これは役に立つ考え方です。コンテキストウィンドウは、高速で高価で容量の限られたメモリとして扱い、それ以外は、agentがずっと抱え続けるのではなく、意図的に照会する、より大きくて安価なストアとして扱います。
実際に必要な長期記憶が、独自に構築したベクトルストアではなく、共有の顧客レコードであるなら、CRMツールの比較のほうがより直接的な出発点になります。また、ナレッジベースソフトウェアの購入ガイドは、同じ問題を組織全体のレベルで扱っています。
実際に問題になるメモリの落とし穴
**コンテキストウィンドウの拡大をメモリと混同すること。**長いチャットのスレッドは、長期記憶ではありません。セッションが終わった瞬間に消えます。また、前述のコンテキスト劣化の調査が示すとおり、セッションがまだ開いている間でさえ、モデルは詰め込まれたコンテキストを確実には使いこなせません。
**メモリを検証・修正する手段がないこと。**agentは、特に最初に保存されたときに誤っていた場合や、単に情報が古くなった場合に、誤って記憶していることがあります。人が誤ったメモリを修正または削除できる手段を用意してください。CRMレコードの誤ったフィールドを直すのと同じです。そうしないと、agentがそれを再利用するたびに、誤りが気づかないうちに積み重なります。
**プライバシーの境界がないメモリ。**顧客やアカウントをまたぐ長期記憶には、ほかの機密データストアと同じアクセス制御が必要です。技術的にほかの顧客の履歴を見られるagentには、それが話題に上らないだろうという思い込みではなく、それを表に出さないという明確なルールが必要です。こうした境界を設定するポリシー面は、AIガバナンスで取り上げています。
**剪定されないメモリ。**すべてを永遠に残す価値があるわけではありません。あらゆる詳細を無期限に蓄積するメモリストアは、検索が遅くなり、取り出す内容にもノイズが増えます。何を期限切れにするか、何を時間とともに要約していくか、何を本当に残す必要があるかを決めてください。
単一のagentの内側に限らず、AIシステム全般が、こうした永続的な理解をどのように構築し管理するのかをさらに深く知りたい場合は、AIメモリをご覧ください。メモリのアーキテクチャ(セッション単位、ユーザー単位、組織単位、ドメイン固有)と、そのすべてを取り巻くべきプライバシーのフレームワークを扱っています。このページでは、それがagent自身のループの中でどう機能するかに絞って解説しました。
Key Facts
- 短期記憶は1つのタスクの一貫性を保ち、通常はモデルのコンテキストウィンドウの中にあります。長期記憶はセッションをまたいで残り、通常は外部のデータベースやベクトルストアにあります。
- より大きなコンテキストウィンドウは、信頼できるメモリと同じではありません。Chromaの調査と学術研究の「Lost in the Middle」はいずれも、特に長い入力の中間に埋もれた情報について、表示されているコンテキストの上限に達するよりずっと前にモデルの精度が低下することを示しました。
- 長期記憶とRAGは、しばしば同じベクトルデータベースのインフラ上で動きます。違いは保存されているものです。agent自身の履歴か、組織の参照ドキュメントかです。
- 検証されていない、剪定されていない、あるいはアクセス制御のないメモリは、現実のリスクです。agentのメモリが複数の顧客やアカウントにまたがる前に、修正の手段、有効期限のポリシー、明確なプライバシーの境界を整えてください。
AI Agentのメモリに関するよくある質問
AI agentのメモリとは何ですか。
AI agentのメモリとは、agentがすでに起きたことを把握する仕組みです。1つのタスクの内側(短期記憶、またはワーキングメモリ)でも、同じアカウントやユーザーとのこの先のあらゆるやり取りをまたいで(長期記憶、または永続メモリ)も機能します。短期記憶は通常、モデルのコンテキストウィンドウの中にあります。長期記憶は、agentが照会する外部のデータベースやベクトルストアにあります。
agentの短期記憶と長期記憶の違いは何ですか。
短期記憶は現在のタスクを保持します。ここまでの会話、すでに実行したステップ、進行中の計画などです。実行が終わると消えます。長期記憶は、セッションをまたいで残す必要がある事実、過去のやり取り、状態を保持します。モデルの外部のデータベースやベクトルストアに保存され、agentが1回のやり取りから次のやり取りまで一貫して振る舞えるようにするものです。
コンテキストウィンドウが大きくなれば、メモリの問題は解決しますか。
それだけでは解決しません。主要な18のモデルをテストした調査では、コンテキストウィンドウがいっぱいになるよりずっと前に精度が低下することがあり、モデルは長いコンテキストの先頭や末尾に置かれた情報を、中間に埋もれた情報よりもうまく扱うことが分かっています。コンテキストウィンドウは、高速で容量の限られた作業スペースとして扱い、残しておく必要があるものは、プロンプトを長くするのではなく、長期ストレージに移してください。
agentのメモリはRAGとどう違いますか。
両者は、意味によって情報を保存・検索するベクトルデータベースという、同じ基盤のインフラを共有することがよくあります。違いは、何をなぜ保存するかです。RAGは通常、回答の根拠を示すために、組織の参照ドキュメントから取得します。長期記憶は、特定のタスク、ユーザー、アカウントに関して、agent自身が蓄積した履歴を取得します。
AI agentのメモリは間違っていることがありますか。
あります。agentは最初から誤って保存することもあれば、状況の変化に伴って、保存された事実が単に古くなることもあります。本番のメモリシステムには、人が誤ったメモリをレビュー、修正、削除できる手段が必要です。ほかの記録システムに適用するのと同じ規律を当てはめてください。そうしないと、agentがそれを再利用するたびに、誤りが静かに積み重なります。
次に読むもの
メモリがあるからこそ、agentは毎回あなたのビジネスをゼロから学び直すのではなく、一貫して行動できます。AI agentのためのRAGと組み合わせれば、agentが暗記する必要のないドキュメントに根拠を置けます。また、AI agentの評価とテストの方法と組み合わせれば、古くなった事実や、精度を静かに損なっていくコンテキストの肥大化といったメモリのドリフトを、顧客に届く前に捕捉できます。メモリが組み込まれる、より広い構成要素については、AI agentの仕組みが、ループの全体像を扱っています。
