AI Agentのデータプライバシー: PIIの取り扱い、レジデンシー、最小化
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI agentのデータプライバシーとは、agentが自身のループを回す中で、どの個人データを読み取り、送信し、保存し、削除するかを管理する取り組みです。システムオブレコードからどのフィールドを取得するか、モデルやサードパーティのツールに何を渡すか、その後メモリに何を残すか、そしてそれらがどれだけの期間残り続けるかが対象になります。単一のモデル呼び出しのプライバシーより範囲が広いのは、agentのツール呼び出しが、1つのモデルプロバイダーだけでなく、実行のたびに複数のシステムへデータを拡散させるからです。負荷の大半は3つの実践にかかります。PIIを成り行きではなく意図的に扱うこと、agentが最初から触れる範囲を最小化すること、そしてデータが保存される場所だけでなく、実際に処理される場所を把握することです。
Agentのプライバシーの範囲がモデルより広い理由
モデルへの1回のプロンプトで問われるプライバシーの問題は1つです。何をそこに入れたか、です。agentでは多くなります。AI agentの仕組みでは、agentが回すループを、知覚、推論、行動、観察の繰り返しとして説明しており、知覚のステップだけでも、agentが1つも判断を下す前に、CRM、サポートシステム、ドキュメントストアからデータを取得することがあります。AI agentがツールを使う仕組みでは、その仕組みを解説しています。ツール呼び出しはすべてデータフローであり、パラメータを送り出し、結果を受け取ります。そのひとつひとつが、元の会話にはまったく関わっていなかったシステムへ、個人データが渡りうる場所です。
データプライバシーは、あらゆるAIシステムを規制や組織の期待に沿わせるための方針と監督である、より広いAIガバナンスの傘の下にあります。agentにとって専用の実践が必要になる理由は、この拡散です。AI agentのセキュリティが問うのは、agentが騙されて有害なことをしてしまわないかですが、データプライバシーが問うのは、もっと狭く、静かな問いで、誰かが何かを攻撃している必要はありません。すべてが設計どおりに機能している場合でも、誰のデータがどこへ渡ったのか、そしてそれは必要だったのか、という問いです。
PIIの取り扱い: 動かす前に把握する
個人データは、わかりやすいフィールドだけではありません。氏名とメールアドレスはPIIですが、IPアドレス、デバイスID、医療上の状況を自由記述したサポートチケット、従業員に紐づく人事評価のコメントも同様です。実際の顧客や従業員のレコードを持つシステムを読み取るagentは、誰かがそうラベル付けしたかどうかにかかわらず、PIIを扱っています。AI Benefits Enrollment Agentはわかりやすい例です。従業員の健康保険プラン選びを支援するには、健康に関わるデータや扶養家族の情報に触れることになり、これらは平均的なサポートチケットよりも高い水準の取り扱いを要します。agentの設計が、デフォルトでそのように扱っているかどうかにかかわらずです。
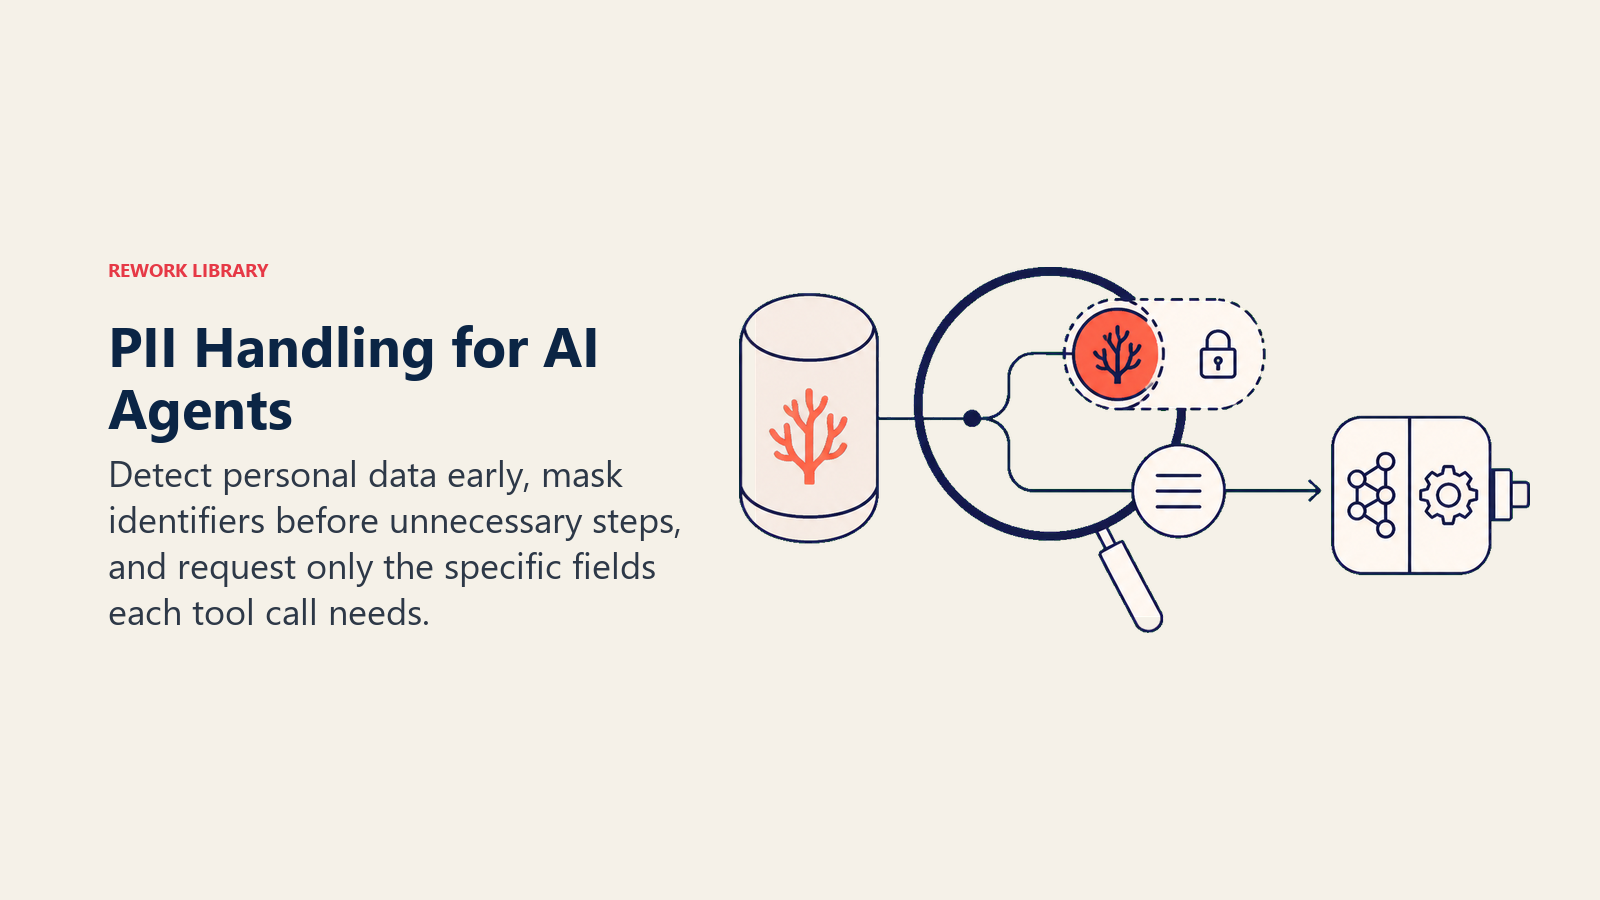
そのデータを意図的に扱うか、うっかり漏らしてしまうかの違いを生む習慣がいくつかあります。
- 生のPIIを、デバッグログや、上流でキャッシュまたは保持されるプロンプトに残さないでください。 ログは、安全な内部の空間と見なされがちです。たいていはそうではなく、特にログがサードパーティのオブザーバビリティツールや、外部のモデルプロバイダーのログ保持に送られる場合はなおさらです。
- 識別可能な情報を必要としないステップにデータが届く前に、削除またはマスクします。 サポートチケットのトピックを分類するステップが、それを行うのに顧客のフルネームやアカウント番号をコンテキストに必要とすることはありません。チケットIDで足りることが多いのです。
- ツール呼び出しは、レコード全体ではなく、特定のフィールドに絞ります。 最小権限のツール設計をプライバシーに当てはめると、ステップが実際に必要とするのがプランの階層だけなら、
get_full_customer_recordではなくcustomer.plan_tierを要求することになります。 - 新しいツール連携は、歓迎すべき新機能としてだけでなく、レビューすべき新しいデータフローとして扱います。 顧客の全購入履歴を技術的に返せるツールは、呼び出されるたびにプライバシー上の判断であり、エンジニアリング上の判断にとどまりません。
最小化: 最小権限と同じ規律を、データに適用する
AI agentのセキュリティでは、ツールアクセスにおける最小権限を提唱しています。agentには、実際の仕事に必要な権限だけを与え、それ以上は与えません。データの最小化は、権限ではなくデータに適用した同一の原則です。1回のAPI呼び出しでたまたま取得できたからといってレコード全体を取るのではなく、ステップが本当に必要とするフィールドだけを取得します。
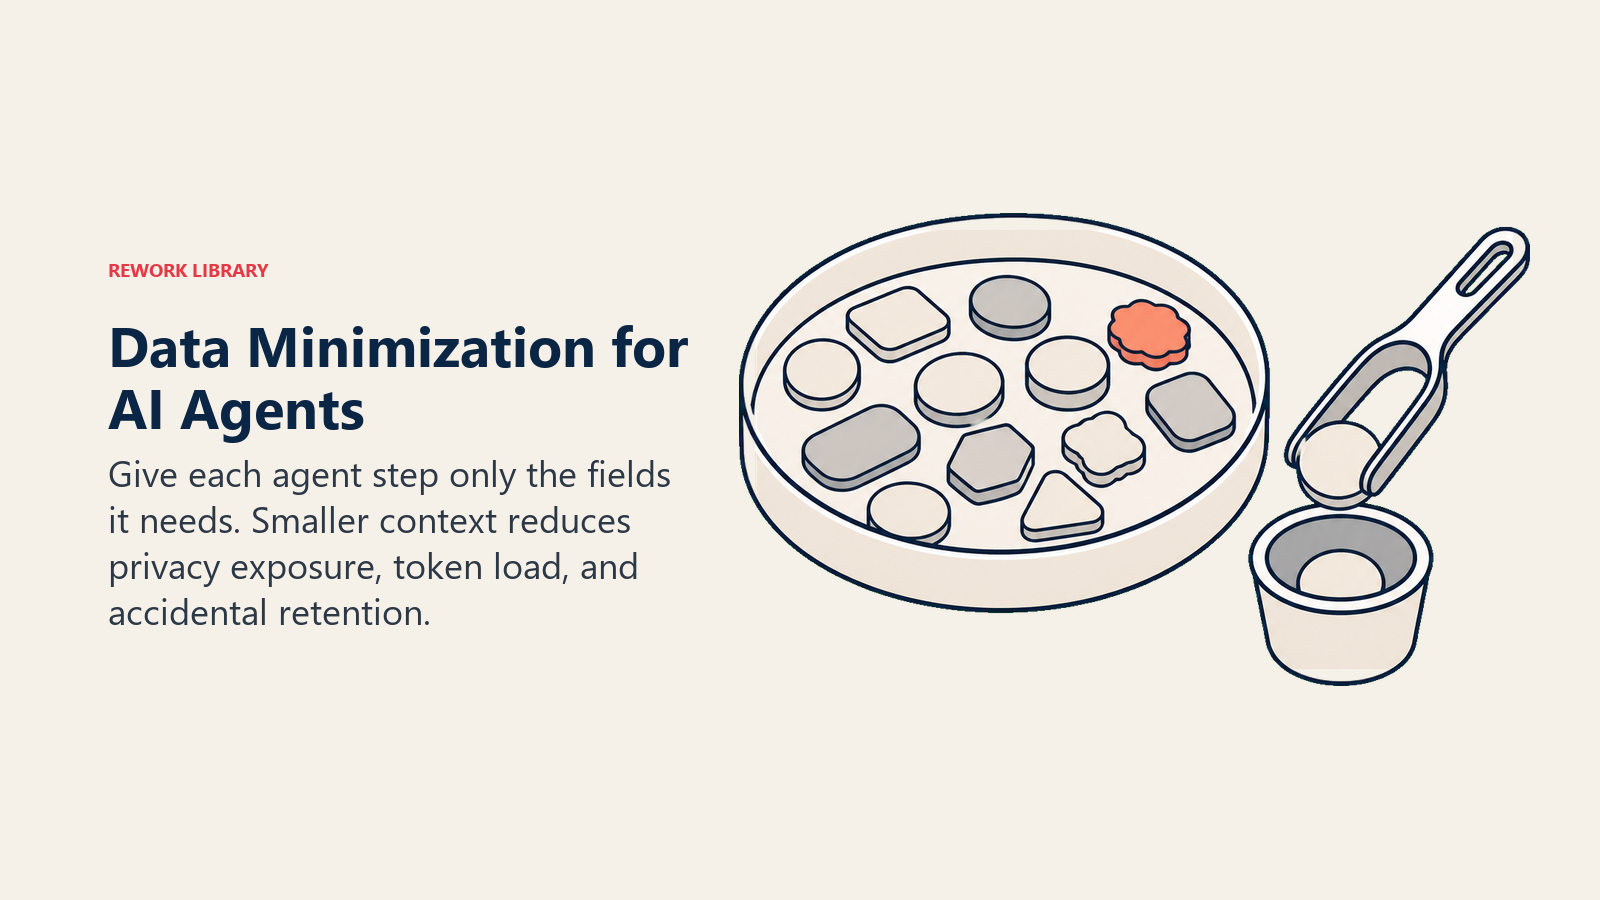
これは単なるコンプライアンス上の配慮ではありません。コンテキスト管理の問題でもあります。実際には必要のないフィールドをagentがコンテキストウィンドウに取り込むたびに、それはプライバシー上のリスクであると同時に、モデルがすべてのステップで処理しなければならない無駄な重荷になります。AI agentのコンテキスト管理では、同じ直感の予算配分の側面、つまり、ステップが必要とするものだけをコンテキストに残すことを、個人データに限らずトークン全般に当てはめて扱っています。この2つの規律は、同じ根本的な理由から同じ方向を向いています。念のために何でも取得するよりも、必要なものだけを正確に取得するほうが優れています。トークンコストを気にする場合でも、データ保護責任者の次の質問を気にする場合でも同じです。
メモリは、プライバシー上の負債が静かに溜まる場所
AI Agent Memoryでは、agentの長期メモリが、セッションをまたいで事実や履歴を保持する仕組みを取り上げています。通常は、agentが後からクエリできるデータベースやベクトルストアです。まさにそこが、プライバシー上の負債が気づかれないまま溜まりやすい場所です。agentが顧客について学んだあらゆる詳細を、有効期限も削除手段もなく無期限に保持するメモリストアは、ある日の様子に何ひとつ異常が見えなくても、増え続ける負債です。
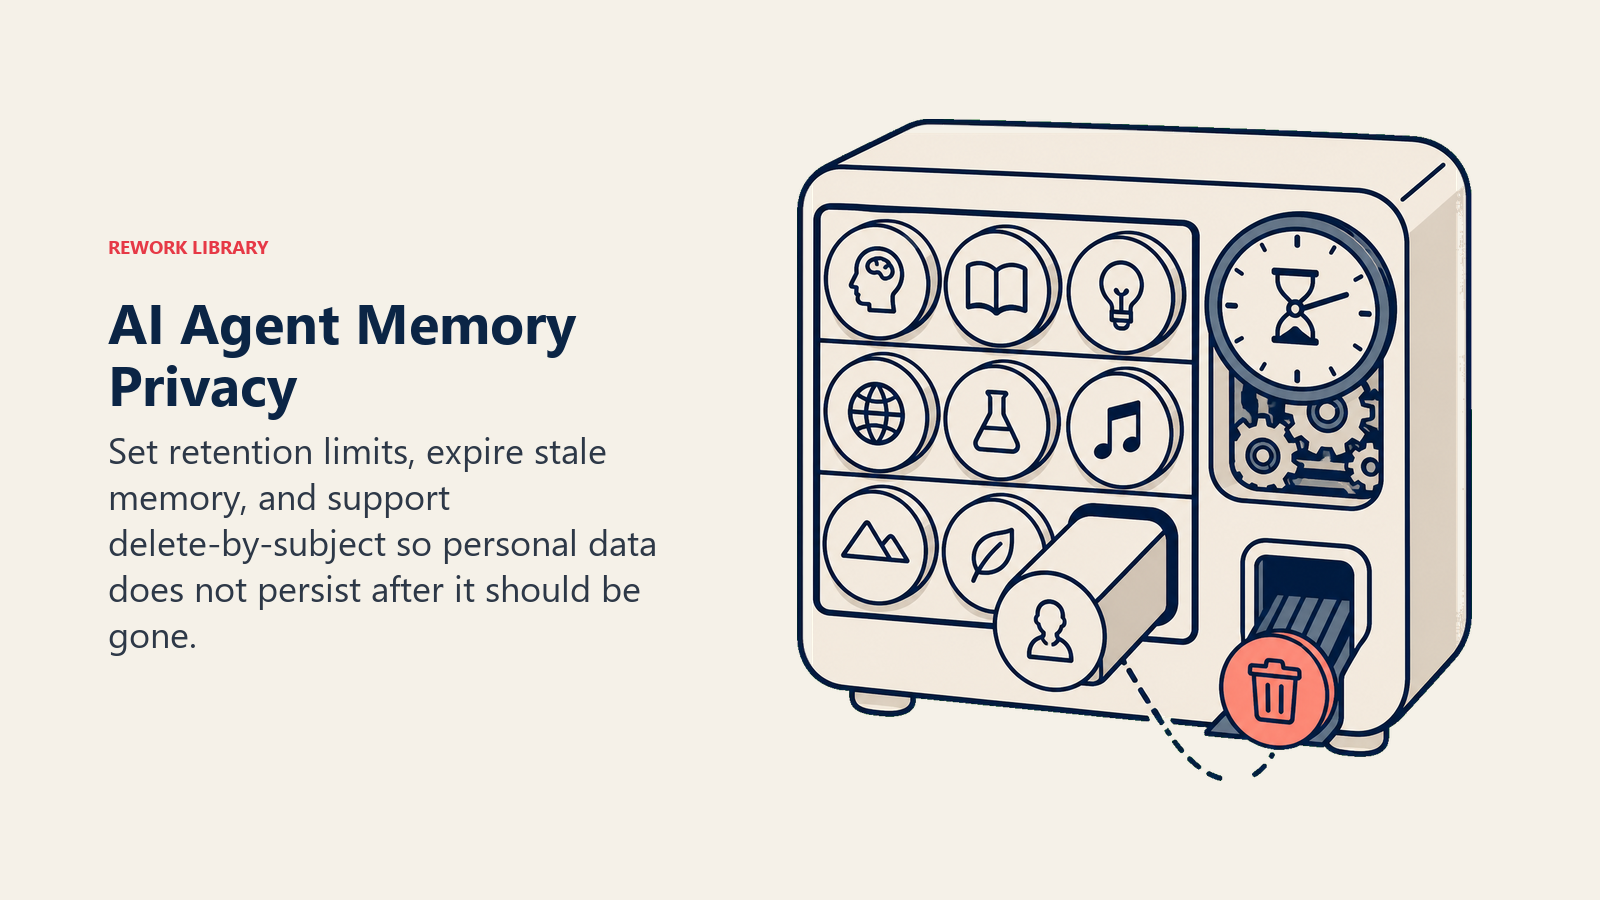
ここで特に重要になる能力が2つあり、いずれも単なる適切な衛生管理ではなく、プライバシー規制が理由です。1つ目は、保持と有効期限のポリシーです。メモリストアが何を、どれだけの期間保持してよいかを決め、デフォルトの永久保存に任せません。2つ目は見落とされがちですが、対象者ごとの削除(delete-by-subject)の能力です。GDPR型の消去権の下では、個人は自分のデータの削除を求めることができます。agentのメモリストアには、その人物に紐づくすべてを見つけて削除する本物の手段が必要です。主要データベースのレコードだけでなく、誰も確認を思い出さないベクトルインデックスにコピーが残ったままではいけません。
データレジデンシーを簡潔に: 保存場所だけが問題ではない
かつては、レコードがどこに保存されるかが、データレジデンシーの問題のほとんどを占めていました。agentはそこに、同じくらい重要な2つ目の場所を加えます。ツール呼び出しやリトリーバルのステップによってモデルの推論に取り込まれたとき、データがどこで処理されるかです。保存先とは別のリージョンで動くモデルに読み込まれた規制対象の個人データは、実装上の細部ではなく、独自のコンプライアンス上の性格を持つデータフローです。
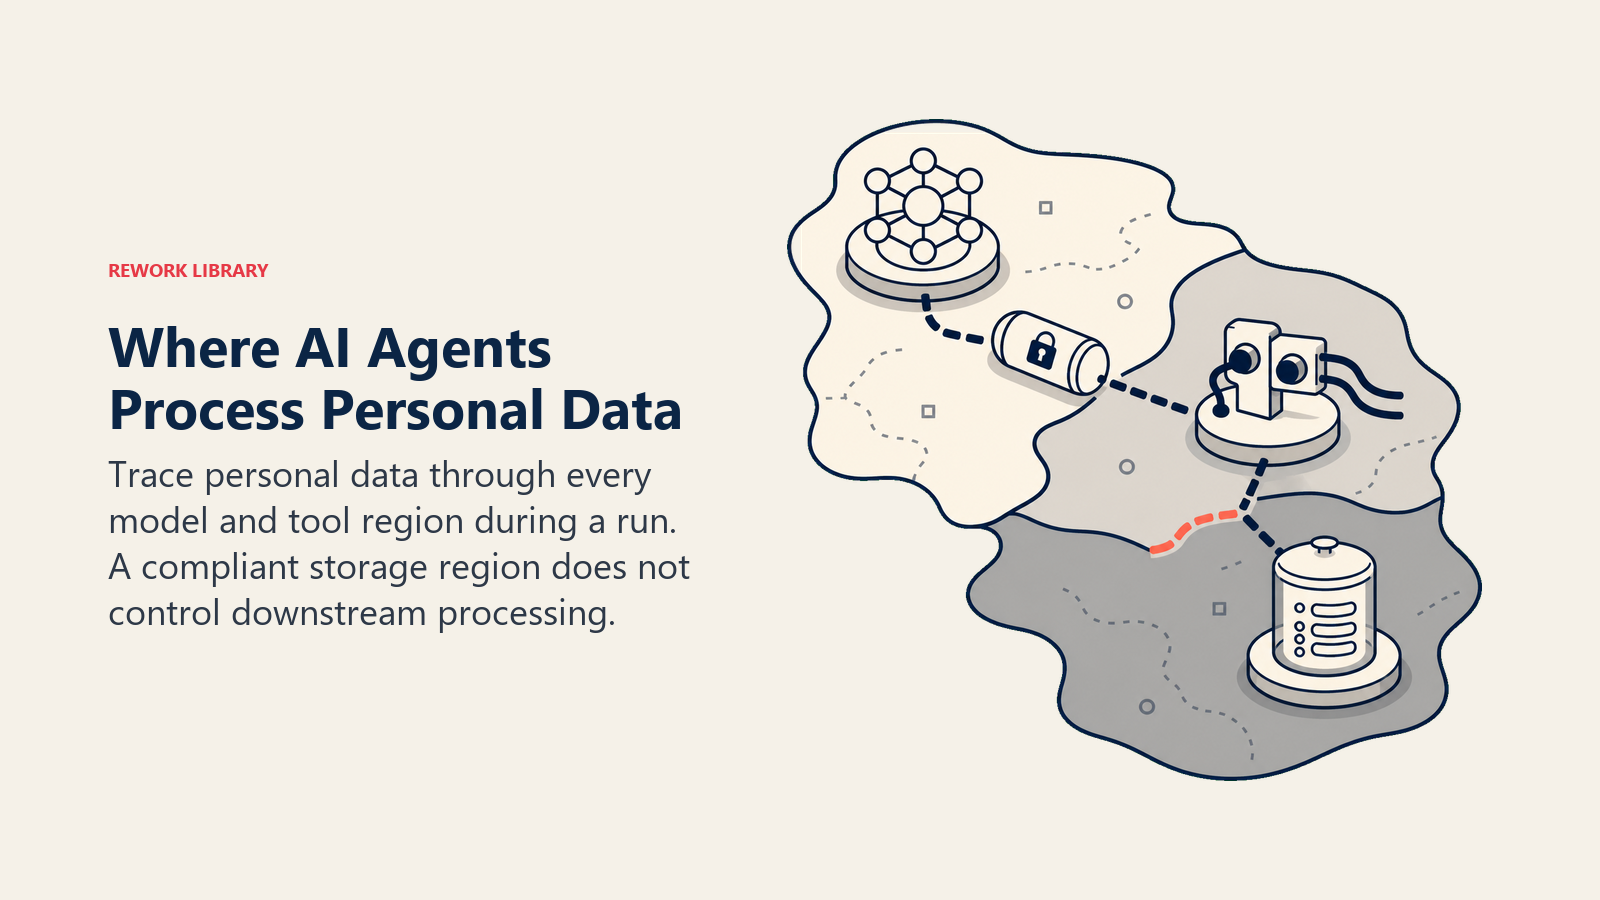
AI Agentのコンプライアンスでは、この領域を、EU AI Actへの照らし合わせ方や、監査証跡が捉えるべき内容を含め、深く取り上げており、規制への対応づけはそちらをご覧ください。プライバシーに特化した要点はもっとシンプルです。ツールごとに、触れるデータを、元のシステムがどこに保存するかだけでなく、実際にどこで処理するのかを把握してください。そして、規制対象の個人データを推論に使うagentは、新しい委託先(サブプロセッサー)と同じ精査に値するベンダー関係として扱ってください。実際にそうだからです。
これは、チームが優先度を下げてよい仮定上の懸念ではありません。5,200人超のプライバシーおよびセキュリティの専門家を対象としたCiscoの2026年Data and Privacy Benchmark Studyでは、81%の組織がデータローカライゼーションへの需要の高まりに直面し、85%がそれは国境を越えたサービス提供に実際のコスト、複雑さ、リスクを加えると答えています。同じ調査では、AIガバナンスの専任組織を持つ組織は現在75%に上る一方、それが実際に成熟していると答えたのは12%にとどまりました。多くの企業は体制づくりを始めています。それを完成させた企業は、ごくわずかです。
データ衛生が弱いことの実際のコスト
これを誤ったときのコストは、抽象的なものではありません。IBMの2026年Cost of a Data Breach Reportでは、保存時と転送時の両方で機密データを暗号化している組織はわずか37%でした。つまり、侵害を受けた組織の多くは、agentやモデルが関わるはるか前から、基本的な統制を欠いていたことになります。同じレポートでは、20%超の組織がAIモデルやアプリケーションを直接標的とした侵害を報告しており、侵害されたAPI、アプリケーション、プラグインが27%で最大の根本原因として並びました。これはまさに、agentのツール呼び出しが生み出す領域です。これとは別に、OWASPのTop 10 for LLM Applicationsは、Sensitive Information DisclosureをLLM02に位置づけています。前版では6位でした。個人データを抽象的に論じるだけでなく、実際に取得して行動に移せるシステムが増えるにつれ、このリスクがいかに急速に順位を上げたかを示しています。
個人データに触れる新しいAIプラットフォームやagentベンダーを導入する場合、当社のAIツール比較は、評価の一環としてデータの取り扱いを重視しています。また、SaaSベンダー評価スコアカードは、実際の顧客や従業員のデータに触れるものと接続する前に、新しいツールのプライバシーとセキュリティの姿勢を採点するための、重み付きのテンプレートを提供します。
実践的なスタート用チェックリスト
個人データを保持するシステムにagentがアクセスする前に、答えておくべき5つの質問です。
| 質問 | 見つけられること |
|---|---|
| このagentが仕事をするために、実際に見る必要のあるPIIは何ですか。 | ツールアクセスを、レコード全体ではなくフィールド単位に絞る |
| 生のPIIは、ログ、プロンプト、キャッシュのどこに現れていますか。 | 誰も意図して設計していない、偶発的な漏えいを見つける |
| agentが記憶するものは、実際にどれだけの期間保持する必要がありますか。 | 無期限というデフォルトの代わりに、保持ポリシーを定めさせる |
| 求められたら、1人の人物に紐づくすべてを見つけて削除できますか。 | 消去権が実質的なものか、理論上のものかを試す |
| 各ツール呼び出しは、触れるデータを実際にどこで処理していますか。 | 保存場所だけでは見えない、国境を越えた処理を浮かび上がらせる |
Key Facts
- agentのプライバシーの範囲は、単一のモデル呼び出しより広くなります。ツール呼び出しのひとつひとつが独自のデータフローであり、1回の実行で個人データを複数のシステムへ拡散させるためです。
- agentにおけるデータの最小化は、最小権限のツールアクセスと同じ原則をデータに適用したものです。レコード全体ではなく、ステップが必要とするフィールドだけを取得します。
- agentの長期メモリは、プライバシー上の負債が静かに溜まる場所です。保持と有効期限のポリシーに加え、消去要求に対応する本物の対象者ごとの削除(delete-by-subject)の能力が必要です。
- Ciscoの2026年Data and Privacy Benchmark Studyでは、81%の組織がデータローカライゼーションへの需要の高まりに直面しており、AIガバナンスの体制を整えている組織が75%ある一方で、それが成熟していると答えたのは12%のみでした。
- IBMの2026年Cost of a Data Breach Reportでは、保存時と転送時に機密データを暗号化している組織はわずか37%で、AIモデルやアプリケーションを標的とした侵害では、侵害されたAPI、アプリケーション、プラグインが最大の根本原因(27%)として並びました。
AI Agentのデータプライバシーに関するよくある質問
AI agentのデータプライバシーとは何ですか。
agentがループを回す中で、どの個人データを読み取り、モデルやツールへ送信し、保存し、最終的に削除するかを管理する取り組みです。PIIを意図的に扱うこと、agentがアクセスする範囲を最小化すること、そしてデータが保存される場所だけでなく、実際に処理される場所を把握することが含まれます。
AI agentにとって、データプライバシーはデータセキュリティとどう違いますか。
セキュリティが問うのは、攻撃者へのデータ漏えいなど、agentが操られて有害なことをしてしまわないかです。プライバシーが問うのは、何も攻撃されていない場合にも当てはまる、より狭い問いです。通常の、正しく機能している実行の間に、誰のデータがどこへ渡ったのか、そもそもそこへ渡る必要があったのか、という問いです。
AI agentにおけるデータ最小化とは何ですか。
APIの呼び出し1回でレコード全体が取得できるからといってそれを取るのではなく、タスクが必要とする特定のフィールドだけを取得する実践です。これは最小権限のツールアクセスと同じ論理を、権限ではなくデータに適用したもので、プライバシー上の露出と不要なコンテキストの両方を減らします。
AI agentのメモリは、忘れられる権利を侵害することがありますか。
はい、あります。メモリストアに、特定の人物に紐づくすべてを、求めに応じて見つけて削除する手段がない場合です。AI Agent Memoryで取り上げた長期メモリは、セッションをまたいで事実を保持するため、保持ポリシーと本物の対象者ごとの削除(delete-by-subject)の能力がなければ、本人がデータの削除を求める権利を持つ時期をはるかに過ぎても、データを保持し続けることがあります。
適切なリージョンにデータを保存すれば、AI agentのデータレジデンシーは解決しますか。
それだけでは解決しません。agentは、準拠したリージョンに保存されたデータを、実行中に、まったく別の場所で処理するモデルやツールに取り込むことがあります。agentにとってのデータレジデンシーとは、元のレコードがどこにあるかだけでなく、各ツールとモデルが、触れるデータを実際にどこで処理しているかを確認することを意味します。
次に読むもの
agentのデータプライバシーは、このライブラリの別の場所で扱っている2つの規律と密接に結びついています。AI agentのセキュリティでは、agentが操られて意図的にデータを漏らしてしまうのを防ぐ、脅威モデルの側面を取り上げています。AI Agentのコンプライアンスでは、規制への対応づけ、監査証跡、EU AI Actの側面を深く取り上げています。プライバシーは、単独ではなく、この両方と併せて読んでください。きちんとガバナンスされたagentには、この3つが連携して機能することが必要だからです。
