AIエージェントのセキュリティ: 実践ガイド
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI agentのセキュリティとは、自律型のagentが騙されたり、過剰な権限を与えられたり、攻撃者の道具にされたりしないようにするための取り組みです。agentが到達できる範囲の脅威モデリング、保有するすべてのツールへの最小権限の徹底、触れてよい範囲のサンドボックス化、そしてagentに出入りするデータの検証が含まれます。一般的なAIセキュリティよりも重要になるのは、agentが単にリスクのあるテキストを生成するだけでなく、実際に行動を起こすからです。騙されたモデルが生み出すのは、不適切な一文です。騙されたagentは、たいていその時点ですでに行動してしまっています。
agentの保護がモデルの保護より大きな課題である理由
AI securityは、あらゆるAIシステムに当てはまる脅威のカテゴリを扱います。モデルを誤った出力へ誘導する敵対的入力、学習を汚染するデータポイズニング、指示を乗っ取るprompt injection、モデルの窃取、モデルインバージョンです。agentは内部にモデルを土台として持つため、これらはすべてagentにもそのまま当てはまります。変わるのは、モデルが騙された後に何が起きるかです。
ReworkのACE Frameworkは、2つのケイパビリティであるGenerate(生成)とExecute(実行)の間に明確な線を引いています。返信の下書きを生成することはリスクが低く、不適切な下書きは誰かの目に触れる前に削除されるだけです。その行動を実行すること、つまり実際に送信する、レコードを更新する、返金を実行するといった行為にこそ、結果が伴います。通常のチャットボットは、おおむねこの線のGenerate側にとどまります。一方でagentは、その定義上、この線を越えます。how AI agents workにあるToolsとGuardrailsという構成要素が存在するのは、まさにそのためです。Toolsはagentにできることの上限を定め、Guardrailsは何を指示されてもagentが絶対にしてはならないことを定めます。セキュリティは、誰かが本気でそれらを破ろうとしたときに、この両方が機能し続けるようにするためのものです。
agentの脅威モデル: 攻撃が着弾する3つの場所
agentのセキュリティインシデントの大半は、3つの攻撃面のいずれかに行き着きます。
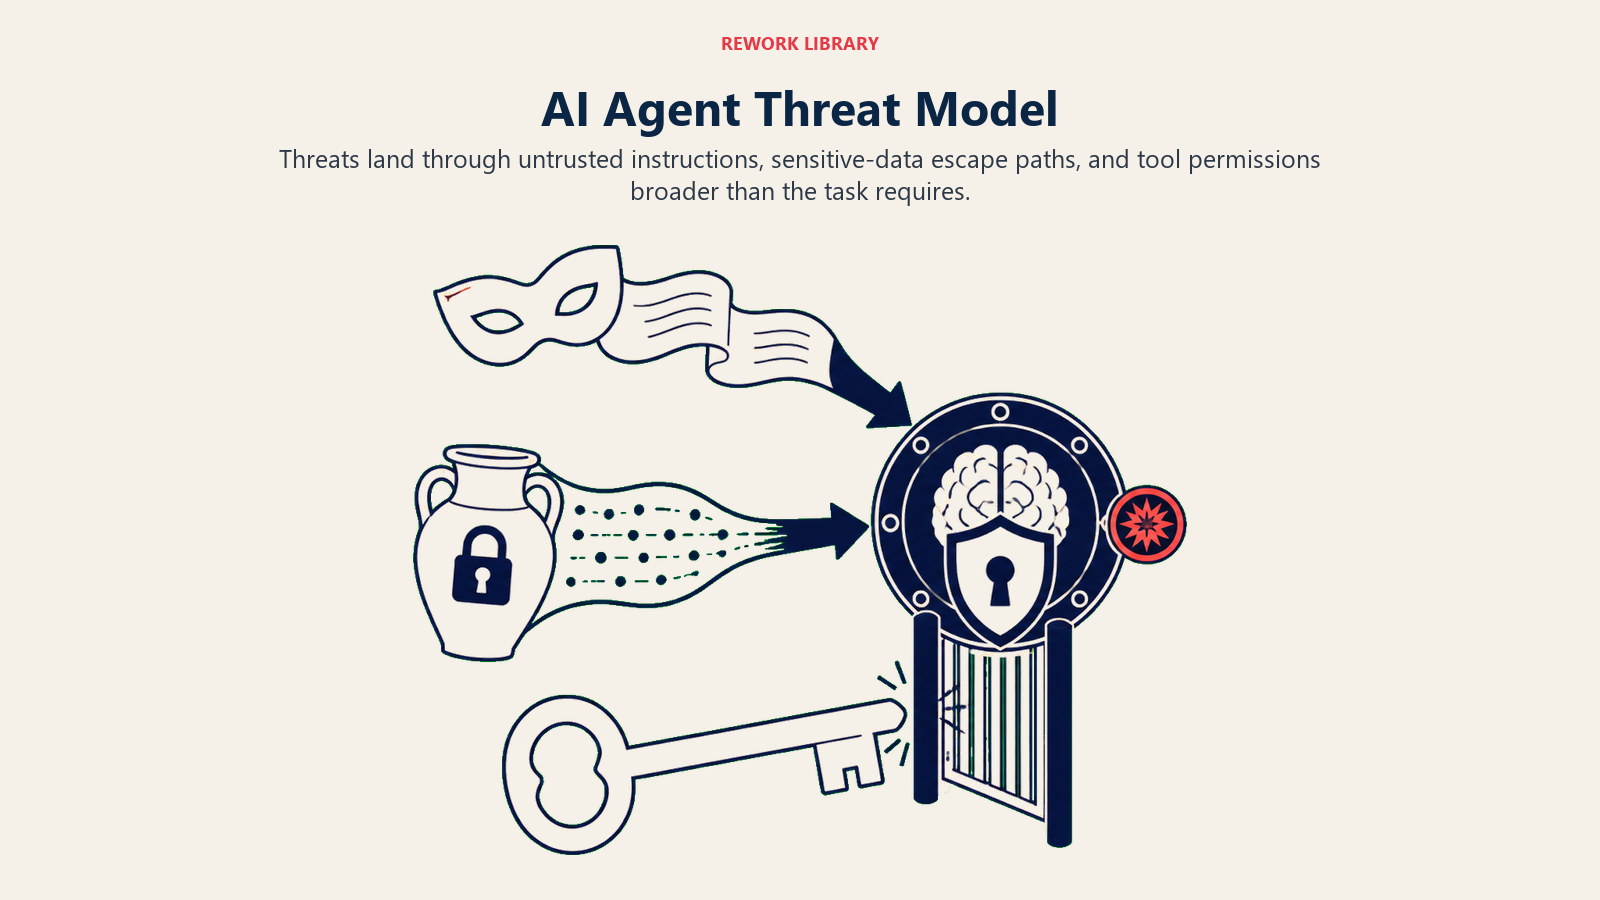
| 攻撃面 | 何が起きるか | agentが狙われやすい理由 |
|---|---|---|
| Prompt injection | agentが読み込むコンテンツに隠された指示が、本来のタスクを上書きする | agentは設計上、信頼できないコンテンツを読み込む。メール、チケット、ドキュメント、Webページ、スクレイピングしたデータなど |
| データ流出 | agentが操られ、機密データを出力、ツール呼び出し、外部へのメッセージに含めてしまう | agentは業務のために、CRM、サポート、財務システムへの広い読み取り権限を持つことが多い |
| 過剰な権限のツール | agentのツールアクセスが実際のタスクに必要な範囲より広いため、1回の操作成功が連鎖的に被害を広げる | タスクごとにアクセスを絞らず、広範な連携用の認証情報を1つだけ付与してしまうチームが多い |
最も真剣に受け止めるべきなのがprompt injectionです。OWASP Top 10 for LLM Applicationsの首位であるLLM01に、2版連続で挙げられています。試みるのが安価で、完全に塞ぐのが難しいためです。直接的なインジェクションとは、ユーザーがsystem promptを上書きするための指示を入力することです。agentにとってより厄介なのが間接的なインジェクションです。agentに処理を依頼するドキュメント、メール、チケット、Webページに指示が隠されているため、攻撃者はagentと直接やり取りする必要がまったくありません。
最小権限: 業務に必要なツールだけをagentに与える
最も効果の高いセキュリティ上の判断は、最も地味なものでもあります。すべてのツールを、agentが実際の業務をこなせる最も狭いアクセスに絞り、それ以上は与えないことです。
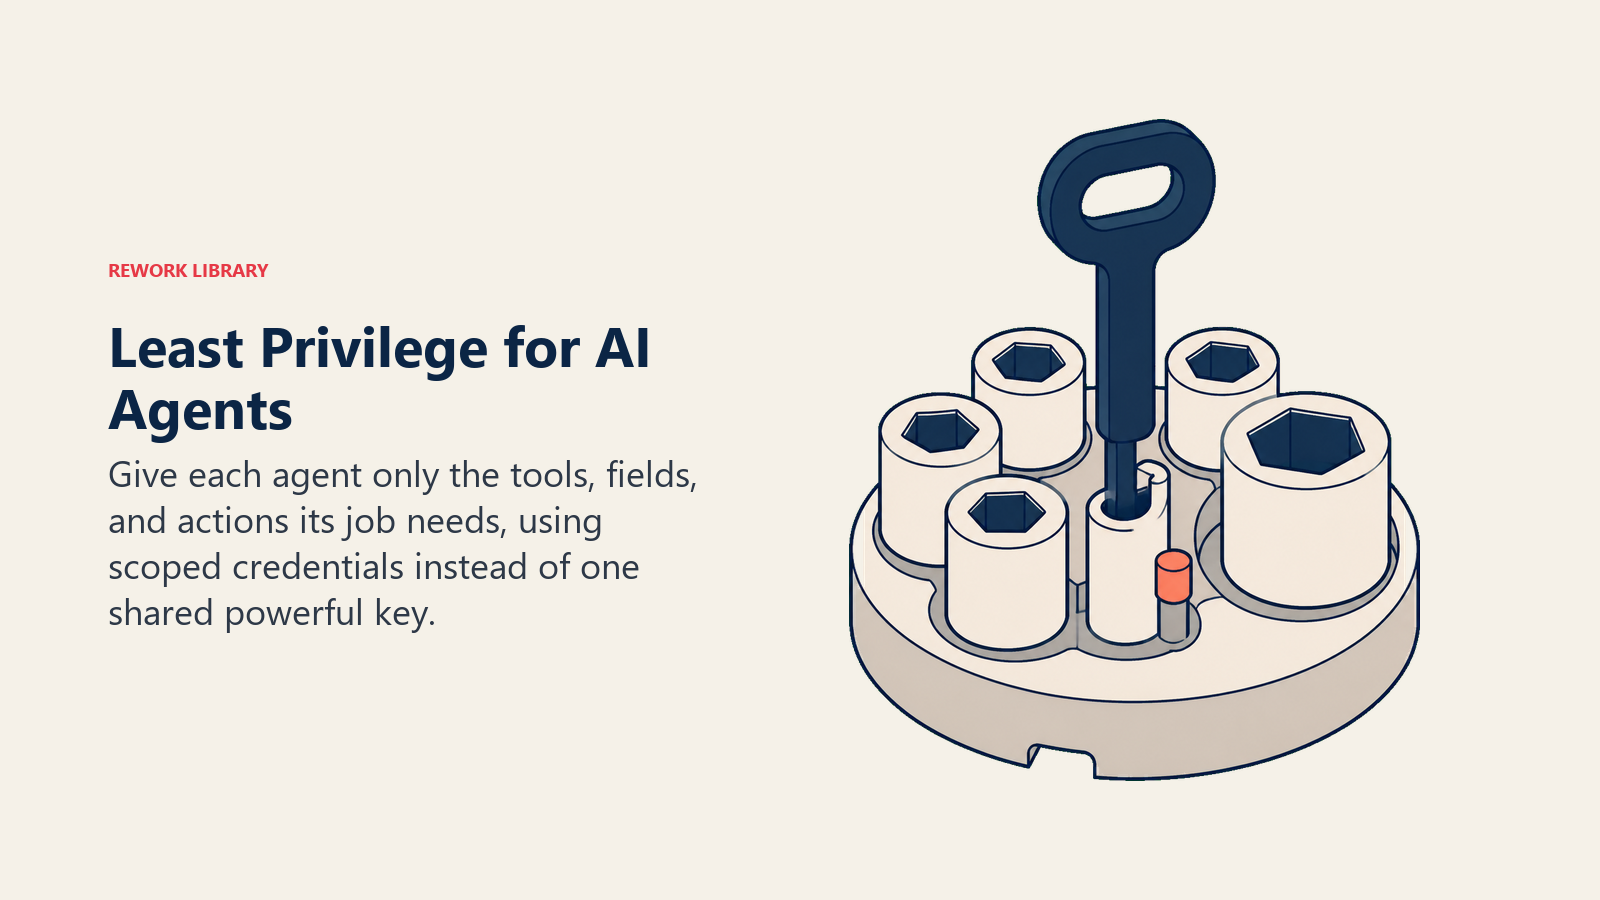
実際には、次のようになります。サポートのトリアージagentには、チケットへの読み取り権限と、チケットのステータスを更新するための限定的な書き込み経路を与えます。ヘルプデスクの管理画面全体への常設の認証情報は与えません。CRMの整備agentには特定のフィールドを編集する権限を与えますが、レコードの削除はさせません。すべてのツール呼び出しは、スタック内のすべてのagentが使い回す強力な共有APIキーではなく、それぞれ個別にスコープを絞ったトークンで実行します。共有キーがあると、1つのagentの侵害がすべての侵害につながってしまうからです。
これは、AI Access Provisioning Agentのブループリントの背景にある考え方と同じです。このagentは、すべてのアクセス申請をポリシーに照らしてチェックし、権限昇格と思われるものにフラグを立てるために存在しており、デフォルトで付与することはありません。同じ基準を、agentが他人のために管理する権限だけでなく、agent自身の権限にも適用してください。新入社員に初日からすべてへの常設アクセスを与えないのであれば、agentにも与えるべきではありません。
サンドボックス化: agentが触れる範囲を封じ込める
最小権限は、agentが到達できる範囲を制限します。サンドボックス化は、それでも誤ったものに到達してしまった場合に何が起きるかを制限します。
取り入れる価値のある実践的なパターンをいくつか紹介します。
- 書き込み権限を与える前にステージングする。 新しいagentは、アクションを提案し、人が承認するモードで動かします。その後、リスクの低い特定のアクションの種類から、安定して正しく実行できることを確認したうえで、自律実行へ段階的に移行します。
- アクションの種類ごとに支出とレートの上限を設ける。 暴走したループや操られたagentも、レート制限と1回の実行あたりのコスト上限があれば、大きな被害は出せません。
- 信頼できないコンテンツ用に環境を分ける。 受信メールを要約するagentを、給与システムへの書き込み権限を持つのと同じコンテキストで動かしてはいけません。
- 元に戻せないアクションには人間の確認を必須にする。 外部へのコミュニケーションの送信、送金、レコードの削除は、まさに誤検知のコスト(人に不必要に確認を求めること)が、見逃しのコスト(操られた指示に従って行動してしまうこと)よりはるかに低いケースです。
これは、Governance Requirements by AI Patternが説明する内容の実践面にあたります。ガバナンスの要件はリスクに応じて決めるべきであり、リスクはExecuteのステップに集中します。下書きしかできないagentは、送信も支払いも削除もできるagentに比べて、はるかに小さなサンドボックスで済みます。
prompt injectionへの具体的な防御
prompt injectionは最上位のリスクであるため、最小権限とサンドボックス化に加えて、独自の防御が必要です。
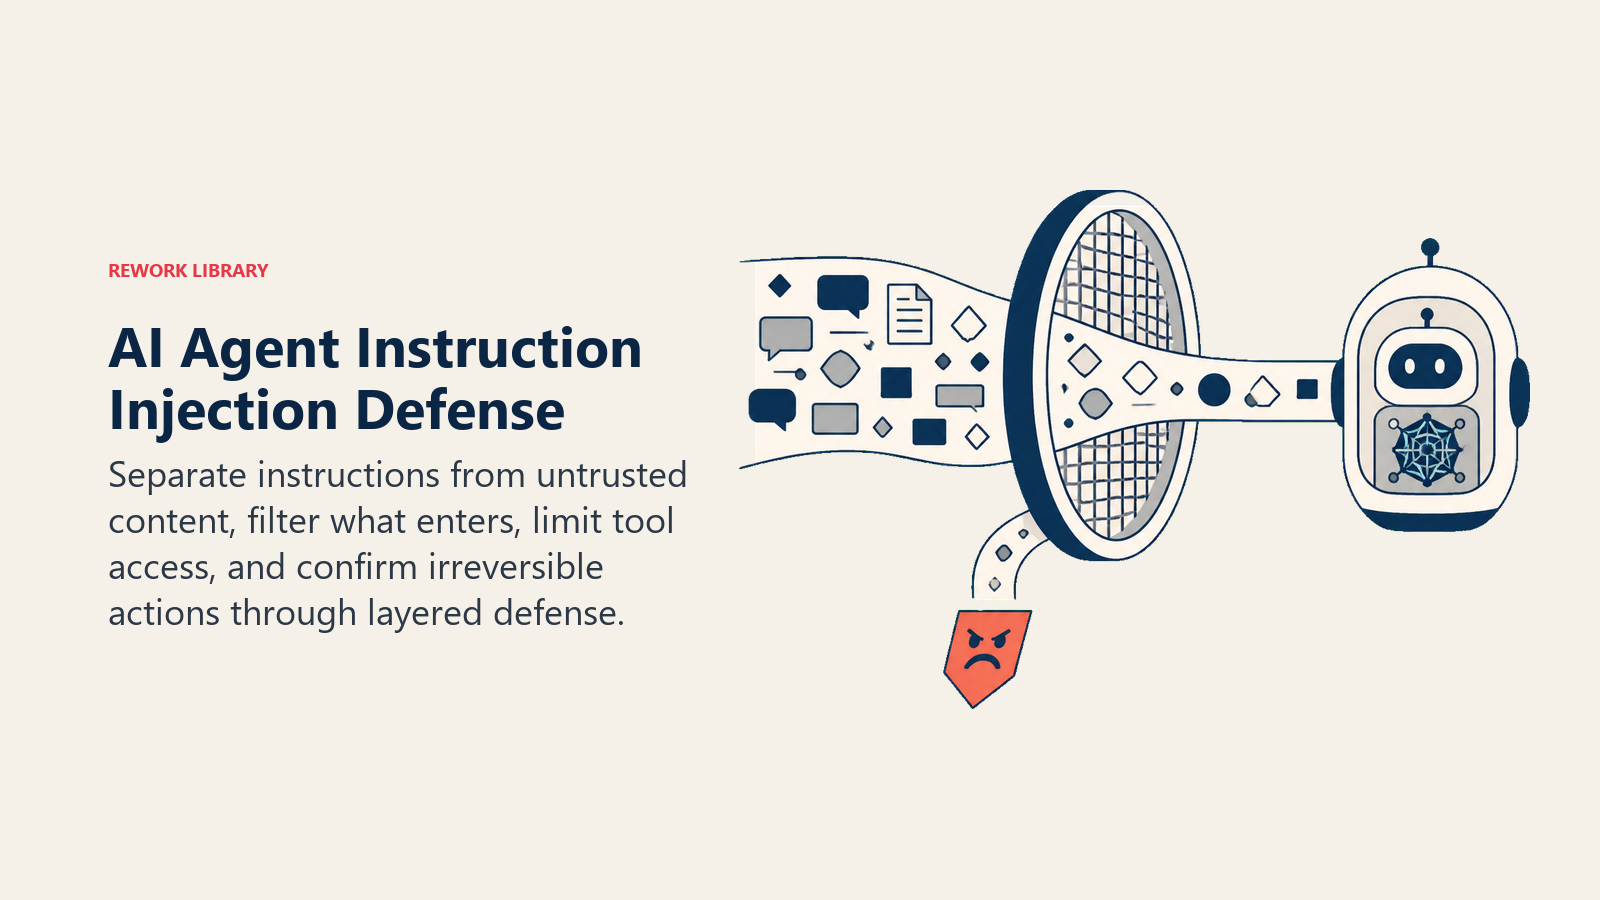
プラットフォームが対応していれば、指示のチャネルとコンテンツのチャネルを分離してください。ドキュメントやメールから取り込んだテキストは、従うべきコマンドではなく、評価すべきデータとして構造的に区別されるようにします。組織の外から取得したものは、スクレイピングしたページ、受信メッセージ、アップロードされたファイルを含め、Webアプリケーションがユーザー入力を扱うのと同じように、デフォルトで信頼できないものとして扱います。モデルに届く前に入力をフィルタリングして検査しますが、断固とした攻撃者のあらゆる試みをすべて捕捉できるフィルターは存在しないことを理解しておく必要があります。だからこそ、これは防御の全体ではなく、複数ある層の1つです。そして、インジェクションが成功した場合に実害が出る特定のアクションの種類には、人間を関与させ続けます。すべてではなく、元に戻せないものや価値の高いケースに絞ります。
ここで挙げた対策は、どれか1つだけでは十分ではありません。それが要点です。多層防御、つまり1つの強力な対策ではなく複数の弱い対策を重ねる方法が、広く受け入れられたアプローチです。agentのセキュリティ障害は、一度に1つの層だけをすり抜ける傾向があるからです。
「十分に安全」とはどういう状態か
NIST AI Risk Management Frameworkは、AIリスクへの取り組みを4つの機能で整理しています。GOVERN、MAP、MEASURE、MANAGEです。agentに当てはめると、短く具体的なチェックリストになります。agentへの新しいツールアクセスを誰が承認できるかを統治(govern)する。汎用的なAIポリシー1つに頼らず、運用する各agentの実際の脅威の範囲をマッピング(map)する。その脅威モデルに照らして、agentの動きを継続的に測定(measure)する。そして、顧客から知らされるのではなく、実効性のある対応計画に基づいてインシデントを管理(manage)する。
この緊急性は、仮定の話ではありません。Gartnerは、2028年までに企業における情報漏えいの25%がAI agentの悪用に起因すると予測しており、外部の攻撃者と悪意ある内部関係者の双方が原因になるとしています。別の予測として、Gartnerは2028年までに企業の生成AIアプリケーションの25%が年に5件以上の軽微なセキュリティインシデントを経験するとしています。2025年の9%から上昇する見込みです。どちらの数字も同じ方向を指しています。agentがより多くのツールアクセスとより高い自律性を得るにつれて、インシデントもそれに比例して増えるということです。技術が悪化しているからではなく、攻撃対象領域の拡大が、多くのチームの対策の整備を上回って進んでいるからです。
Key Facts
- agentのセキュリティがモデルのセキュリティより大きな課題なのは、agentが生成するだけでなく行動するからです。騙されたモデルは不適切なテキストを生み、騙されたagentは不適切な行動を生みます。
- 主な攻撃面は、prompt injection、データ流出、過剰な権限のツールの3つです。prompt injection(OWASP LLM01)は、2版連続でLLMリスクの首位にランクされています。
- 最小権限とは、すべてのツールを、agentの実際の業務に必要な最も狭いアクセスに絞り、共有の万能な認証情報ではなく、agent専用のトークンを使うことを意味します。
- サンドボックス化とは、書き込み権限のステージング、支出とレートの上限設定、元に戻せないアクションへの人間の確認の必須化を意味します。
- Gartnerは、2028年までに企業の情報漏えいの25%がAI agentの悪用に起因し、企業の生成AIアプリケーションの25%が年に5件以上の軽微なセキュリティインシデントを経験すると予測しています(2025年は9%)。
AI Agentのセキュリティに関するよくある質問
AI agentのセキュリティとは何ですか。
自律型のagentが操られたり、過剰な権限を与えられたり、悪用されて有害な行動を取ったりしないようにするための取り組みの総称です。agentのツールアクセスの脅威モデリング、最小権限の徹底、触れられる範囲のサンドボックス化、そしてprompt injectionへの防御が含まれます。
AI agentにとって最大のセキュリティリスクは何ですか。
prompt injectionです。agentが処理するコンテンツに隠された指示が、本来のタスクを上書きしてしまいます。OWASP Top 10 for LLM Applicationsで2版連続の第1位(LLM01)となっており、特にagentにとって危険なのは、インジェクションが成功すると、不適切な応答だけでなく、実際の行動が引き起こされうるためです。
AI agentにとっての最小権限とは何を意味しますか。
agentに、その特定の業務に必要なツールアクセスだけを、可能な限り狭いスコープで与えることです。共有された強力なAPIキーではなく、agent専用の認証情報を使います。チケットのステータスを更新できるサポートagentが、ヘルプデスク全体の削除権限まで持つべきではありません。
AI agentのサンドボックス化とは何ですか。
他の対策をかいくぐってagentが操られた場合の被害を限定する仕組みです。書き込み権限は、自律的に付与する前に、人の承認を挟んでステージングします。アクションの種類ごとに支出と呼び出しレートの上限を設けます。外部へのコミュニケーションの送信やレコードの削除など、元に戻せないアクションの前には確認を求めます。
prompt injectionにはどう防御すればよいですか。
単独で十分な防御はありません。指示と信頼できないコンテンツの分離、取得したコンテンツや受信コンテンツをコマンドではなくデータとして扱うこと、入力フィルタリング、最小権限のツールアクセス、結果が重大なアクションへの人間の確認を組み合わせます。多層防御は、1つの層が見逃したものを他の層が捕捉します。
次に読むもの
セキュリティは、agentが簡単には騙されて誤った行動を取らないようにするためのものです。それでも誤った動きをしていないかどうかは、AI agent observabilityでわかります。十分にセキュリティが確保されたagentでも、挙動がドリフトすることはあり、それを見えるようにしておく必要があるからです。これらの対策が実際の設計にどう現れるかを具体的に知るには、AI Security Monitoring AgentとAI Access Provisioning Agentのブループリントをご覧ください。どちらも、ローンチ後に後付けするのではなく、最小権限と人間による承認のロジックを設計の中核に組み込んでいます。
