AI Agentのコンテキスト管理: 予算配分、コンパクション、リトリーバル
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI agentのコンテキスト管理とは、実行の各ステップで、モデルのコンテキストウィンドウに何を入れるかを決める取り組みです。どの指示、どのツール結果、どの取得ドキュメント、どの過去のやり取りが本当に場所を得るにふさわしいのか、そして何を要約し、削除し、あるいは後で取得するのかを見極めます。これが重要なのは、agentがプロンプトを一度きりで済ませず、ループを回すからです。ループを1周するたびに、同じ限られた、しだいに混み合う空間を奪い合うことになります。コンテキストを自由に使えるメモ用紙のように扱うと、タスクが長引くほどagentは遅く、高価に、そして不正確になります。予算として扱えば、鋭さを保てます。
これはチャットの問題ではなく、Agentの問題である理由
チャットボットへの1回の質問が占めるコンテキストウィンドウは、小さく予測しやすい一部分です。システムプロンプト、質問、回答で済みます。agentは違います。AI agentの仕組みでは、agentが回すループを、知覚、推論、行動、観察の繰り返しとして説明しています。この1周ごとに、モデルが頭に置いておくべき内容が増えていきます。10ステップかかるタスクでは、終わるころには10回分のツール出力を読み、10回の判断を下し、場合によっては複数のドキュメントを取得しています。これらは自動的には消えません。意図的に管理しない限り、コンテキストウィンドウの中に残り続けます。
Anthropicのエンジニアリングチームは、AI agent向けコンテキストエンジニアリングのガイドで、この根本的な問題をうまく整理しています。コンテキストは有限のリソースであり、限界収益は逓減します。ステップが実際に必要とする分を超えたトークンは、コストがかかるだけでなく、性能を実際に損なうおそれがあります。Transformerのアテンションはウィンドウ内のすべてに分散されなければならず、ウィンドウが埋まるほど薄く広がるためです。これは容量を使い切るのとは別の失敗モードです。まだ余裕があるうちに、静かに劣化していくのです。この現象はChromaの長文コンテキスト性能に関する研究が直接検証しており、主要な18モデルをテストして、ウィンドウが技術的に満杯になるはるか前から精度が落ち始めうることを明らかにしました。AI Agent Memoryではこの研究をストレージの側面からより詳しく取り上げています。本記事は、その続きとして、実際に何をすべきかを扱います。
Agentのコンテキストを実際に埋めているもの
コンテキストウィンドウに予算を配分するには、その中で何が場所を奪い合っているのかを把握する必要があります。典型的なagentの実行では、5つのカテゴリーが同じトークンを奪い合います。
| コンテキストの内容 | 用途 | 増える理由 |
|---|---|---|
| システムプロンプトとルール | agentの役割、トーン、常時有効な動作 | 書いた後はほとんど増えないが、時間とともにエッジケースが書き足されがち |
| ツールスキーマ | agentが呼び出せるすべてのツールの定義 | agentのツールキットにツールを追加するたびに増える |
| ツール呼び出しの結果 | これまでのすべてのAPI呼び出し、検索、照会の生の出力 | 最も速く増える。特に冗長なAPIレスポンスで顕著 |
| 会話とステップの履歴 | この実行でこれまでに尋ねられ、判断され、行われたこと | マルチステップのタスクではステップごとに増える |
| 取得したドキュメントやメモリ | 回答や判断のために呼び込んだ知識 | リトリーバルの範囲を絞らないと増える |
実際には、ツール呼び出しの結果が最大の原因になることがほとんどです。AI agentがツールを使う仕組みでは、ツール呼び出しがモデルに読ませる生の結果を返し、モデルがそれを見て次の一手を決める流れを解説しています。多くのAPIは、agentが必要とする以上のものを返します。1つのフィールドで足りるのに顧客レコード全体を、上位3件で足りるのに検索レスポンス全体を返すといった具合です。AI Research Agentは、管理しないとどうなるかを示しています。絞り込んだ3つの抜粋ではなく、10本の出典の全文をコンテキストに取り込むブリーフは、生成が遅くなるだけではありません。最終的な統合にはほとんど使われない素材に、モデルのアテンションを分散させてしまいます。
予算配分: 満杯になる前に、何を入れるかを決める
コンテキスト予算は単純な考え方ですが、成り行きではなく意図的に適用します。実行を始める前に、上記の各カテゴリーがウィンドウのどれくらいを使ってよいかをおおまかに決め、実行中にそれを守らせます。これに対するAnthropicの考え方は、関連しそうなものを最大限集めるのではなく、モデルを正しい結果へ導く、シグナルの高いトークンの最小限のセットを探すことです。
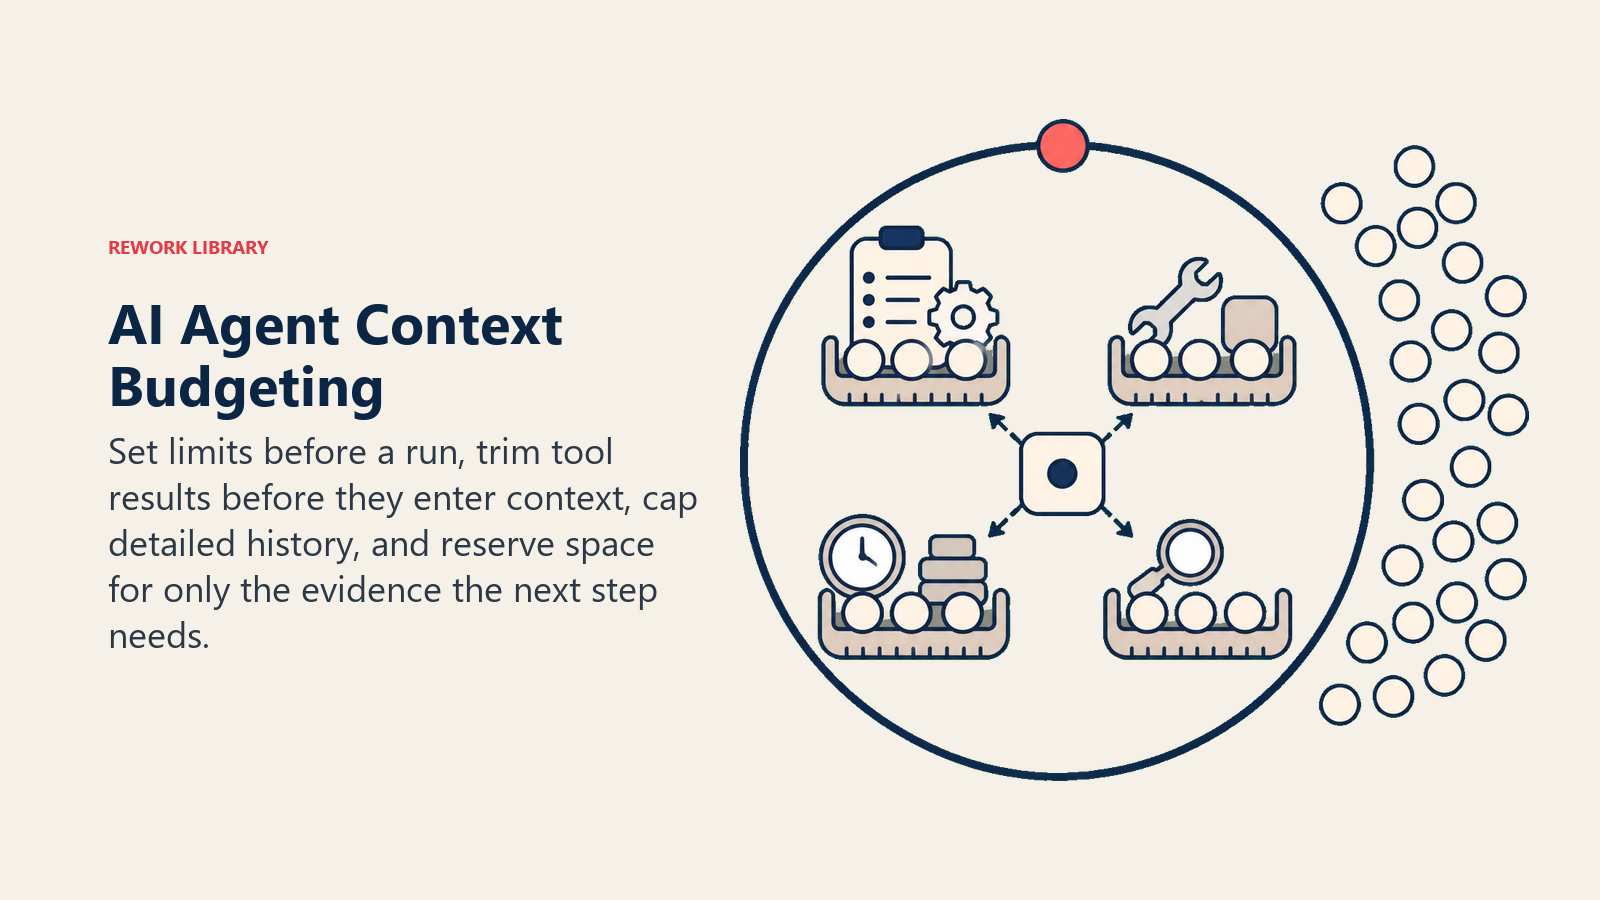
実践では、次のような具体的な習慣になります。
- ツール結果は、コンテキストに入る前に絞り込みます。 入ってからではありません。APIレスポンス全体を次へ渡すのではなく、ステップが実際に必要とする2、3のフィールドだけを抽出します。
- システムプロンプトを簡潔に保ちます。 誰かが遭遇したあらゆるエッジケースを詰め込んだシステムプロンプトは、そのエッジケースが現れるかどうかにかかわらず、すべての実行に永続的にかかる税金です。
- 履歴に上限を設け、際限なく伸ばさないようにします。 長時間のタスクについて、過去のステップのうちどれだけを詳細のまま残し、どれだけをコンパクションするかを決めます(詳しくは後述します)。
- リトリーバルの範囲を絞ります。 ドキュメント全体ではなく、質問が実際に必要とするチャンクを少数だけ取得します。これはAI agent向けRAGがグラウンディングの側面から扱っている教訓ですが、精度だけでなく、コンテキスト予算の判断でもあります。
コンパクション: あふれた後ではなく、あふれる前に要約する
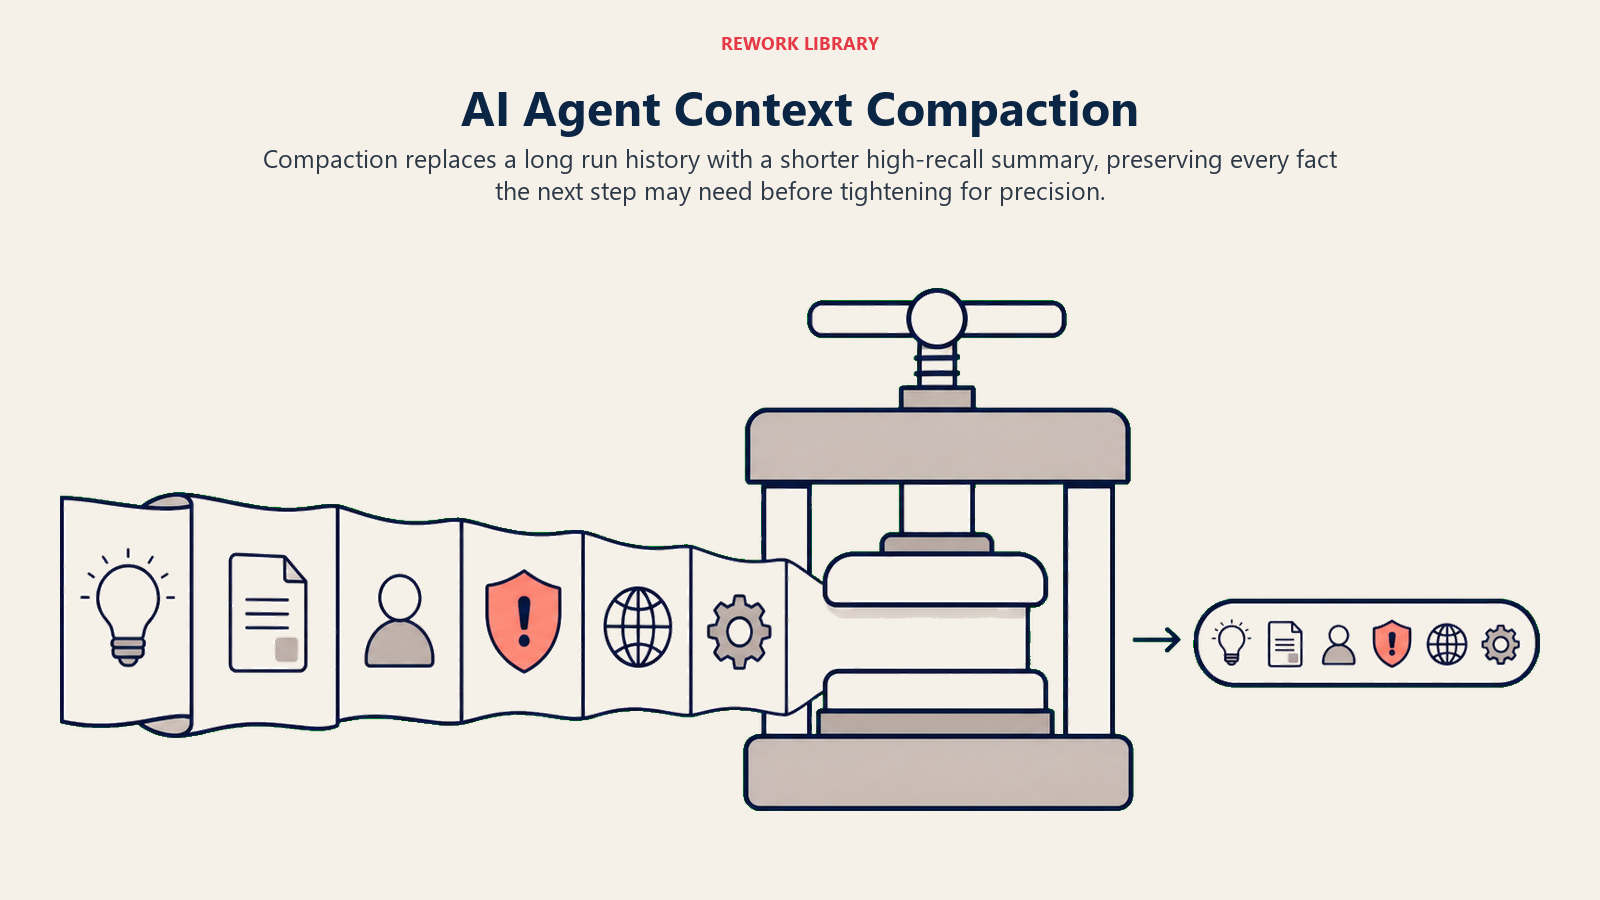
コンパクションとは、実行中に、全文のまま保持する必要以上の履歴が溜まったときに行う処理です。ここまでの経緯を圧縮した形に要約し、トランスクリプト全体ではなくその要約からタスクを続けます。これをうまく行う方法について、Anthropicのガイダンスは具体的です。最初に高い再現率(recall)を目指し、コンパクションの段階で次のステップが実際に必要としうる情報をすべて捉えていることを確認します。その後、重要なものが落ちていないと確かめてから、精度(precision)を高めるために絞り込みます。この順序を逆にして、完全であると確認する前に短い要約を最適化すると、コンパクション後のagentは重要だったことを静かに忘れはじめます。
知っておく価値のある、より古い関連アイデアがMemGPTです。これはオペレーティングシステムの階層型メモリを借用した提案で、モデルの直近のコンテキストには少量の「ホット」な情報だけを保持し、それ以外はより低速で大容量のストレージにページアウトして、ステップが実際に必要としたときだけ呼び戻します。コンパクションと、次に説明するジャストインタイムのリトリーバルは、いずれもこの同じページングの考え方を実用化したものです。
ジャストインタイムのリトリーバルは、すべてを先に詰め込むより優れている
agentがある情報を必要とするかもしれないとき、念のためあらかじめコンテキストに読み込んでおきたくなるのが本能です。より優れたパターンであり、Anthropicのガイダンスが強く推すのが、ジャストインタイムのリトリーバルです。ファイルパス、レコードID、検索ツールといった軽量な参照だけをagentに渡し、実際の内容は必要になったステップで初めて取得させます。これは人がタスクをこなす方法と同じです。育児休暇に関する質問に答えるために、社内規程集をすべて暗記する人はいません。質問が来たときに、該当する箇所を調べます。
これはまさに、AI agent向けRAGが説明している仕組みです。agent内でのリトリーバルは、実際にはほかと同じツール呼び出しであり、ループの知覚ステップに位置します。開始時に丸ごと読み込むのではなく、特定のステップが特定の情報を必要としたときに起動されます。コンテキスト管理としての効果は、グラウンディングとしての効果とは別物です。モデルが知識ベース全体をウィンドウに収められたとしても、そうすることは正しい選択ではありません。現在のステップが必要とする分を超えたトークンは、今まさに重要なトークンへのモデルのアテンションを薄めてしまうからです。
サブAgentへのオフロード: 集中した仕事のための、クリーンなウィンドウ
大きなタスクの中の1つのステップが、狭い目的を果たすために大量の読み込み、調査、探索を必要とする場合、最も効果的なコンテキスト管理の一手の1つは、そのステップをインラインで行わず、別のサブagentに任せることです。サブagentは独自のクリーンなコンテキストウィンドウを持ち、そこで重い作業を行い、作業の過程すべてを引きずって戻るのではなく、凝縮した結果をメインのagentに返します。Anthropic自身の例では、その量は多くの場合1,000〜2,000トークン程度です。
マルチagentシステムでは、このパターンのオーケストレーションの側面を詳しく扱っています。仕事をagent間で分割することが複雑さに見合うのはどんなときか、単一のagentで対応できる仕事に対する過剰設計になるのはどんなときかを解説しています。純粋にコンテキスト管理の観点から見ると、サブagentを使う理由はもっと狭く、機械的です。メインのagentのウィンドウを、引き継ぐ必要のない探索的な詳細で埋めてしまうようなステップは、切り離して要約し、結果だけを返す格好の候補です。
出荷後のコンテキストの健全性を監視する
テストでうまく機能したコンテキスト戦略でも、実際のトラフィックに晒されるとずれていくことがあります。APIの更新後にツールの出力が冗長になる、ナレッジベースが成長する、エッジケースがシステムプロンプトにハードコードされたまま削除されない、といった具合です。AI agentのオブザーバビリティでは、ここで追跡する価値のある指標をすでに挙げています。実行あたりのループ反復回数の増加と、完了したタスクあたりのコストの増加は、どちらもコンテキストが静かに肥大化している初期のサインであり、多くの場合、精度が目に見えて落ちるより前に現れます。AI agentのコスト最適化では、同じ問題の裏側にあたるキャッシュの側面を扱っています。再利用するコンテキストを再送するコストを大幅に下げる手法で、コンパクションの代わりにではなく、併用してこそ意味があります。十分にキャッシュされたコンテキストでも、呼び出しのたびにアテンションを向ける必要があるからです。
大規模なコードベースや長時間のセッションをうまく扱えるプラットフォームを評価している場合は、開発者ツールの比較とAIコーディングアシスタントの選び方ガイドのどちらも、コンテキストウィンドウの扱いを、付け足しではなく本物の差別化要素として取り上げています。大規模なプロジェクトで、コーディングアシスタントの品質が最もはっきり表れる点の1つだからです。
Key Facts
- Anthropicは、コンテキストを限界収益が逓減する有限のリソースとして捉えています。ステップが必要とする分を超えたトークンは、コストが増えるだけでなく、本当に重要なものへのモデルのアテンションを薄めるおそれがあります。
- agentのコンテキストで最も速く増えるのは、通常、会話履歴ではなくツール呼び出しの結果です。多くのAPIが、1つのステップが必要とする以上のものを返すためです。
- コンパクションは、まず再現率(重要になりうるものをすべて捉える)を、次に精度(要約を絞り込む)を最適化すべきで、その逆ではありません。
- 狭く、探索の多いステップを担当するサブagentは、通常、作業中のコンテキスト全体を引き継ぐ代わりに、おおよそ1,000〜2,000トークンの凝縮した結果をメインのagentに返します。
- ループ反復回数の増加と、完了したタスクあたりのコストの増加は、コンテキスト肥大化の早期警告サインであり、多くの場合、精度が落ちるより前に見えます。
次に読むもの
コンテキスト管理は、タスクが長くなってもagentを高速、正確、低コストに保つための日々の規律です。AI Agent Memoryではストレージの側面をより詳しく、AI agent向けRAGではグラウンディング手法としてのリトリーバルに絞って、AI agentのオブザーバビリティではコストの急増や精度の静かな低下として表れる前に、ローンチ後のコンテキスト肥大化を見つける方法を解説しています。
