AI Agentのガードレール:agentを安全かつポリシー準拠に保つ方法
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI agentのガードレールとは、会話の内容やデータ、巧妙なプロンプトがどのような働きかけをしても、agentが決して破ってはならない絶対的なルールのことです。agentの通常の指示とは別物です。指示は「agentが普段どう振る舞うべきか」を定め、ガードレールは「何かに説得されたとしても、決してやってはならないこと」を定めます。よく設計されたagentには、ツール呼び出しへの入力と、その出力の両方にガードレールがあります。しかも、書面に残して祈るだけでなく、セキュリティチームが行うのと同じ方法でテストされています。
このページは、一般的なAIガードレールとは何かを、agent固有の観点から掘り下げたものです。広い概念にはコンテンツモデレーションやチャットボットの安全性も含まれますが、ここで扱うのは、ツールを呼び出して実際のアクションを実行できるagentの具体的な仕組みです。ガードレールが働かなければ、不適切な文章が出るだけでは済みません。不適切な返金、不適切なメール、不適切なレコードが生まれます。
ガードレールとルールの違い
AI agentの仕組みでは、すべてのagentに必要な6つの構成要素を定義しています。そのうち2つはよく混同されます。ルールとガードレールです。ルールは、agentが通常どう振る舞うかを形づくる常時有効な動作です。ブランドボイス、どんな事実を述べるか、断るときの言い回しなどが該当します。ガードレールは、程度ではなく種類が異なります。ルールなら通してしまう場面でも守られる絶対的な制限です。価格を勝手に作らない、ある顧客のデータを別の顧客と共有しない、読み込んでいるコンテンツの中に埋め込まれた、本来の設定を上書きしようとする指示には従わない、といったものです。
両者を分ける基準は次のとおりです。ルールは通常の振る舞いを形づくります。ガードレールは、異常が起きているときに作動するものです。エッジケース、攻撃、agentに不正なデータを渡しているパイプライン上流のバグなどです。ルールが破られた場合、agentは少しブランドから外れた振る舞いをしただけです。ガードレールが破られた場合、agentは「絶対にやらないよう作られていたこと」をやってしまったことになります。agentは制限付きの自律性で動きます。制限の内側では自由に行動でき、その境界では必ず止まる必要があります。ガードレールは、この「制限付き」の半分を実際に強制する仕組みです。
すべてのagentに必要な2つの層:入力と出力
実用的なガードレールの仕組みは、agentを2回チェックします。入ってくるときと、出ていくときです。
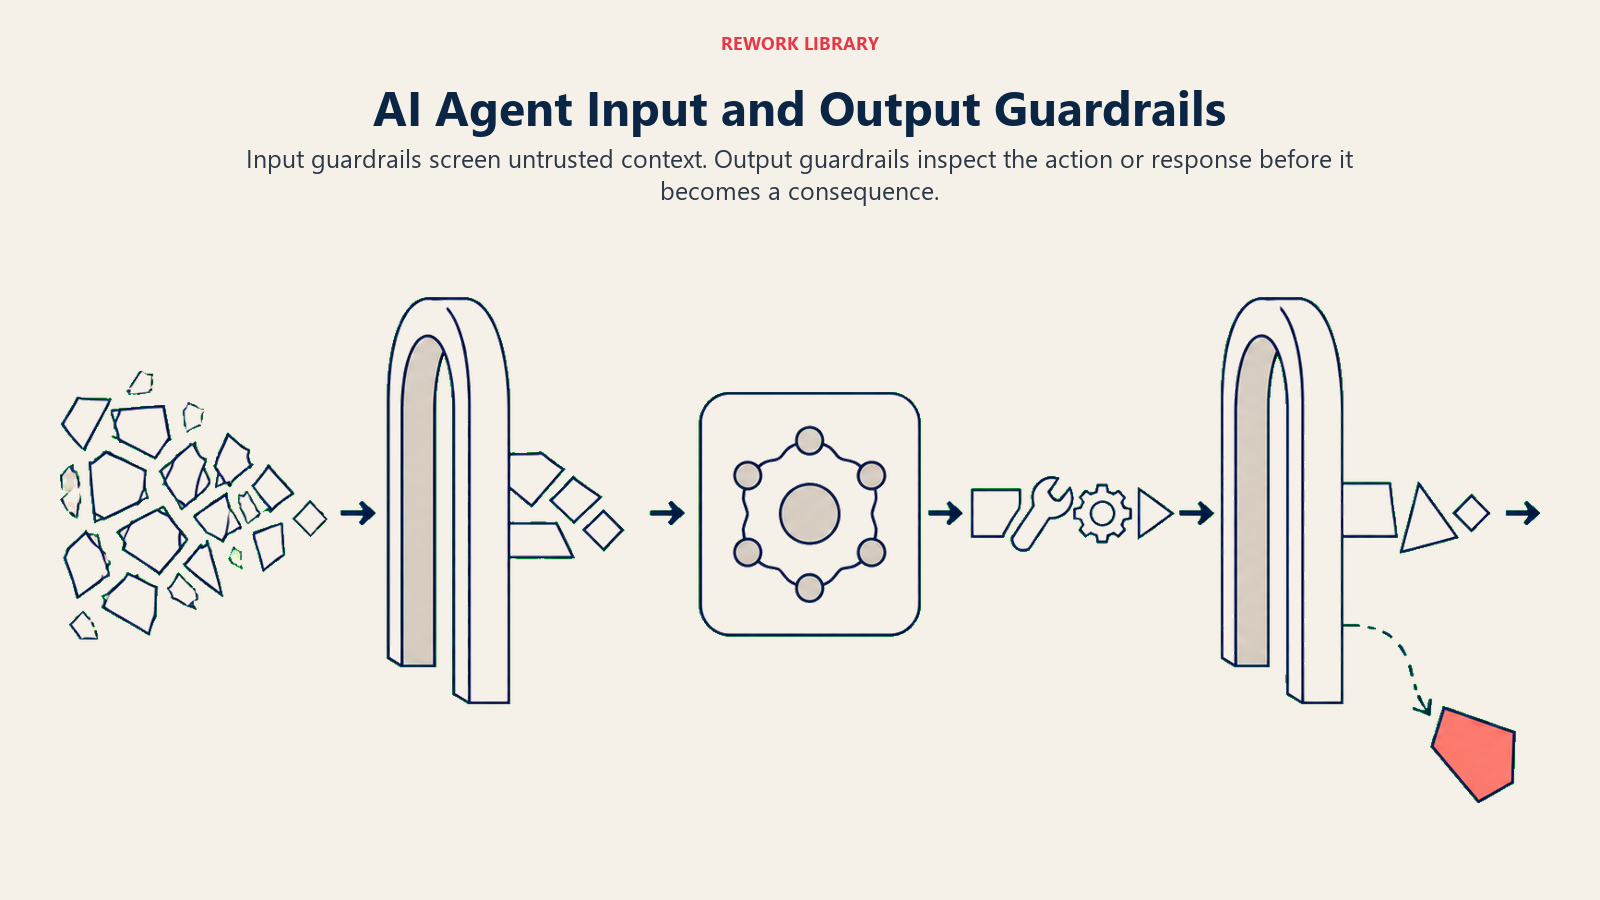
入力ガードレールは、agentに届く内容を、信頼できるコンテキストとして扱われる前にふるいにかけます。agentがこれから読む文書に隠されたプロンプトインジェクションの試みや、agentが実際に依頼された内容と一致しないツール呼び出しのリクエストを捕捉するのがこの層です。AIセキュリティをagentに特化して適用するうえで、最も鋭い部分です。パターンベースのフィルターは既知の攻撃テンプレートを捕捉し、分類モデルは新しい攻撃を捕捉します。
出力ガードレールは、agentが行動または発言を確定する前に、その内容をふるいにかけます。別の顧客のデータを漏らす返信の下書き、想定範囲外のツール呼び出しパラメータ(ポリシー上、自動返金は500ドルが上限なのに5万ドルの返金を行おうとする場合など)、上流では何も問題が検知されなかったのに規定のポリシーに違反している回答を捕捉するのがこの層です。
どちらか一方では不十分です。OWASPのガイダンスは明快です。多層防御を採ること。どれほど優れた単一のフィルターでも、いずれは何か新しい手口に突破されるからです。2つの層を独立して動かせば、一方で見逃しても、もう一方で捕捉できます。
agentのツールには、拒否リストより許可リスト
最もよくあるガードレールの失敗は、agentがやってはいけないことをすべて列挙しようとすることです。そのリストは無限になります。実行可能な方法はその逆です。agentに許可することを正確に列挙し、それ以外はデフォルトでブロックします。
これは、OWASPがExcessive Agency(過剰な権限)と呼ぶものです。Top 10 for LLM ApplicationsのLLM06にあたり、仕事に実際に必要な範囲を超えた機能、権限、自律性がシステムに与えられている状態を指します。返金の提案を下書きするために作られたagentに、返金を実行するツールは必要ありません。アカウントのリサーチを行うagentに、メールクライアントの送信権限は必要ありません。agentが呼び出せるツールは、それぞれがガードレールに関する判断そのものです。ツールを与えれば権限を与えたことになり、そのツールが使われうるあらゆる状況に対してそれを意図していたかどうかは関係ありません。
Autonomous Agentパターンでは、これをスコープ制限と呼んでいます。agentがアクセスできるツールの明示的な許可リストを、デプロイ前にレビューし、実行時には拡張しません。タスクの途中でagentが新しい機能を必要とした場合、それは人間が設定を判断すべきサインであり、agentが自分に権限を与えてよいという意味ではありません。
agentループのどこにガードレールを置くか
知覚、推論、実行、観察のループに当てはめると、ガードレールはagentの周囲を漠然と取り巻くのではなく、特定の3か所に置くべきです。
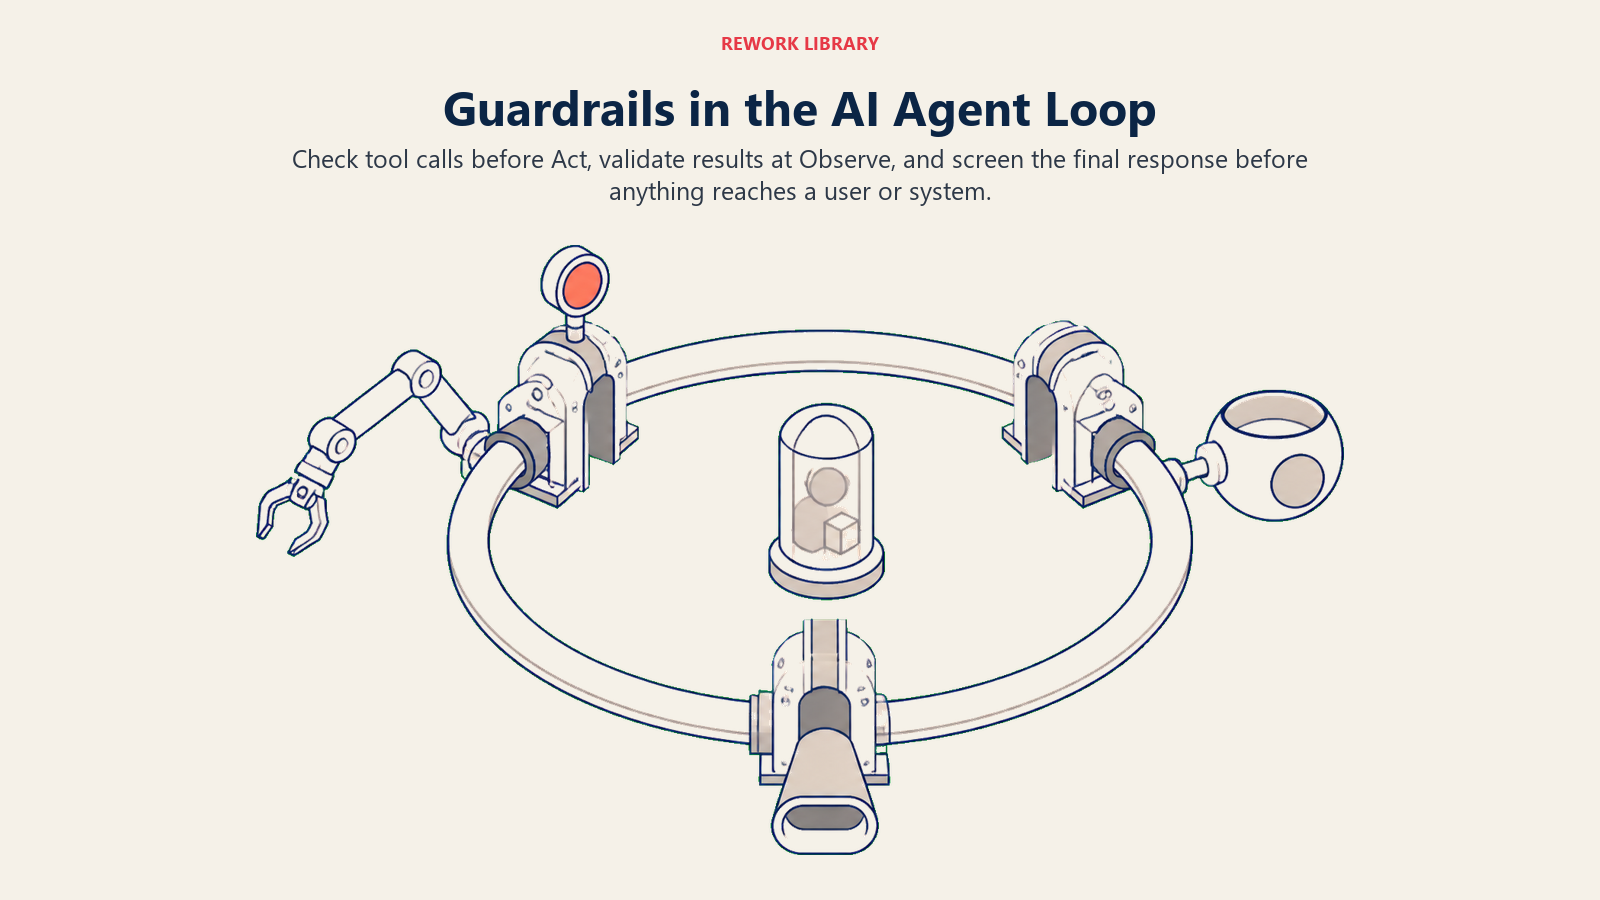
| ループのステップ | ガードレールのチェック | 例 |
|---|---|---|
| 実行の前 | このツール呼び出しは許可リストに載っているか。パラメータは想定範囲内か。 | 自動承認のしきい値を超える返金ツールの呼び出しを、実行前にブロックする |
| 観察の時点 | agentが推論に使う前に、ツールの結果は妥当に見えるか。 | カレンダーAPIが何年も前の日付を返した場合、続行せず停止するサインとして扱う |
| 最終応答の前 | 上流のすべてのステップが問題なく見えても、下書きの出力は規定のポリシーに違反していないか。 | agentに与えられていない価格を述べている返信を捕捉する。ハルシネーションの可能性が高い |
チェックを、後から行われる別個のレビュー工程としてではなく、ループそのものに組み込むことが、ガードレールをポリシー文書ではなくガードレールにします。影響が出る前にリアルタイムで、すべての実行で作動します。コンプライアンスチームが数週間後にレビューする、サンプル抽出された実行だけではありません。また、各パターンのガバナンス要件が求める監査証跡も、これによって生まれます。どのガードレールがいつ、なぜ作動したかを正確に記録したログです。
ガードレールが実際に機能するかをテストする
誰も破ろうとしたことのないガードレールは、推測で信じているだけのガードレールです。AIレッドチーミングは、agentがやってはならないことを実際にやらせようと試みる、構造化された敵対的テストです。これが「ガードレールがあります」という主張を、検証済みの事実に変えます。
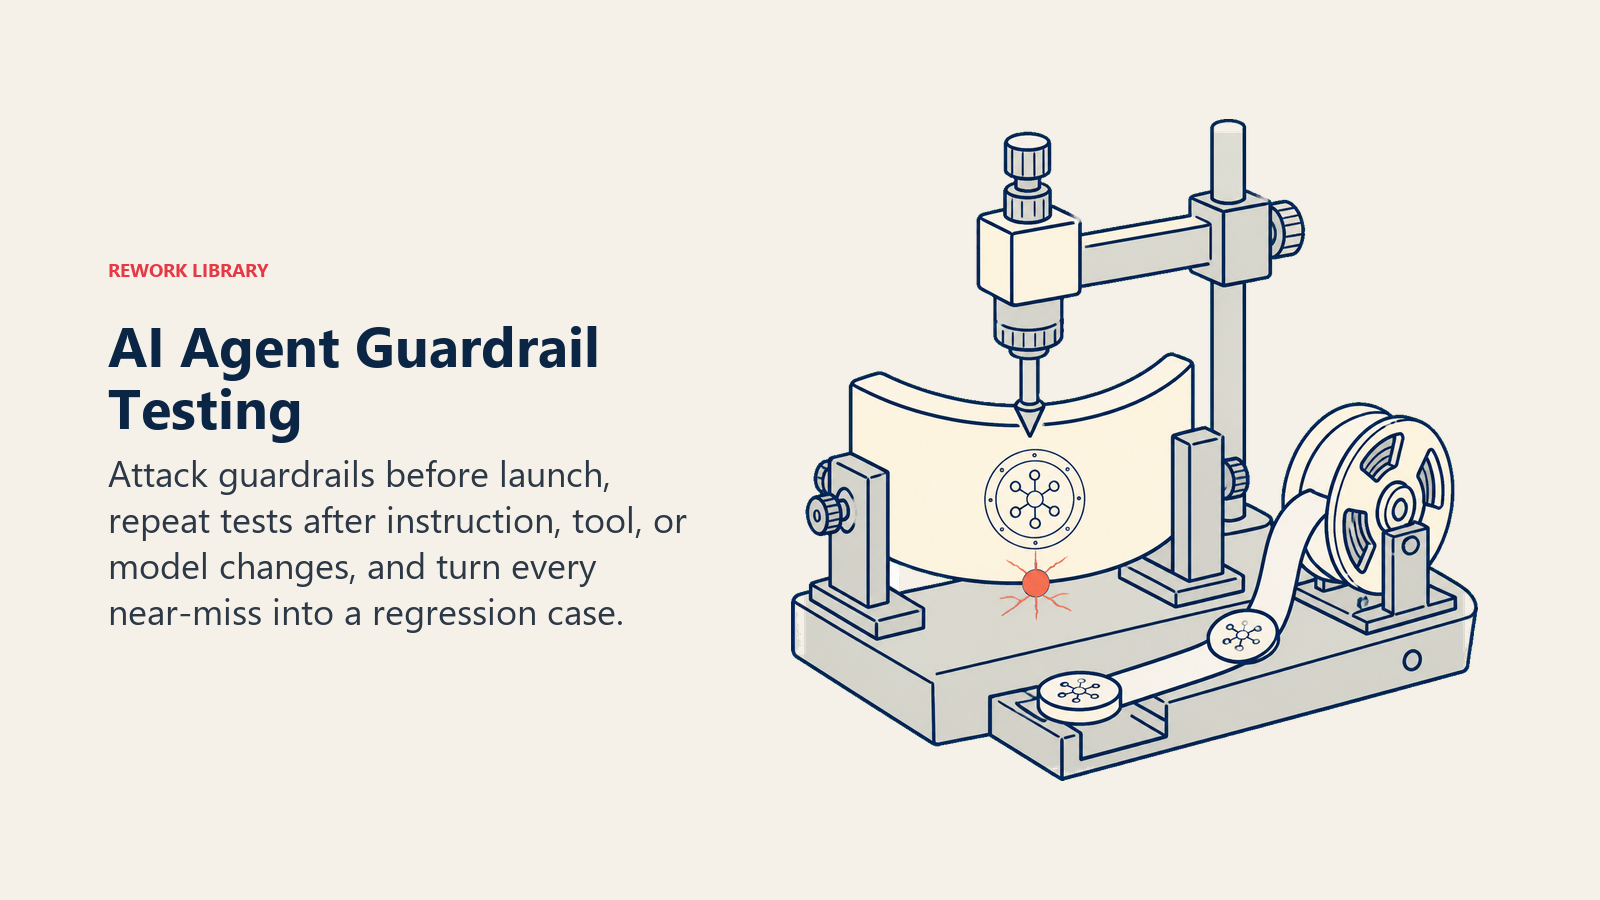
もちろん、ローンチ前に実施します。さらに、プロンプト、ツールの一覧、基盤モデルのいずれかを変更するたびに再度実施してください。前四半期のモデルに対して機能していたガードレールが、今四半期のモデルでは気づかないうちに破られることがあるからです。実際のニアミス、つまりagentが誤った行動を取りかけたものの、ガードレールが捕捉した事例は、無料のテストデータとして扱ってください。次回、どこをさらに厳しくレッドチームすべきかを正確に教えてくれます。
NISTのAI 600-1 Generative AI Profileは、これをMEASURE機能のもとで位置付けています。リスクマネジメントは、統制が書面上に存在するかどうかだけでなく、敵対的な条件下で機能するかどうかをテストするまで完了しません。ただ、AIガバナンス全般で見ると、ほとんどの組織はまだそこに達していません。コンプライアンス、リスク、監査のリーダー193人を対象とした2026年の調査では、AIツールを使っていると答えた組織は83%、しかし強固なガバナンスフレームワークを導入しているのは約25%にとどまりました。つまり、現在本番稼働しているAI agentの大半は、一度書かれたきり、その後一度も敵対的にテストされていないガードレールで動いているということです。
ガードレールとヒューマンインザループ:役割は異なる
ガードレールとヒューマンインザループのチェックポイントはしばしば一括りにされますが、解決する問題が異なり、成熟したagentには両方が必要です。
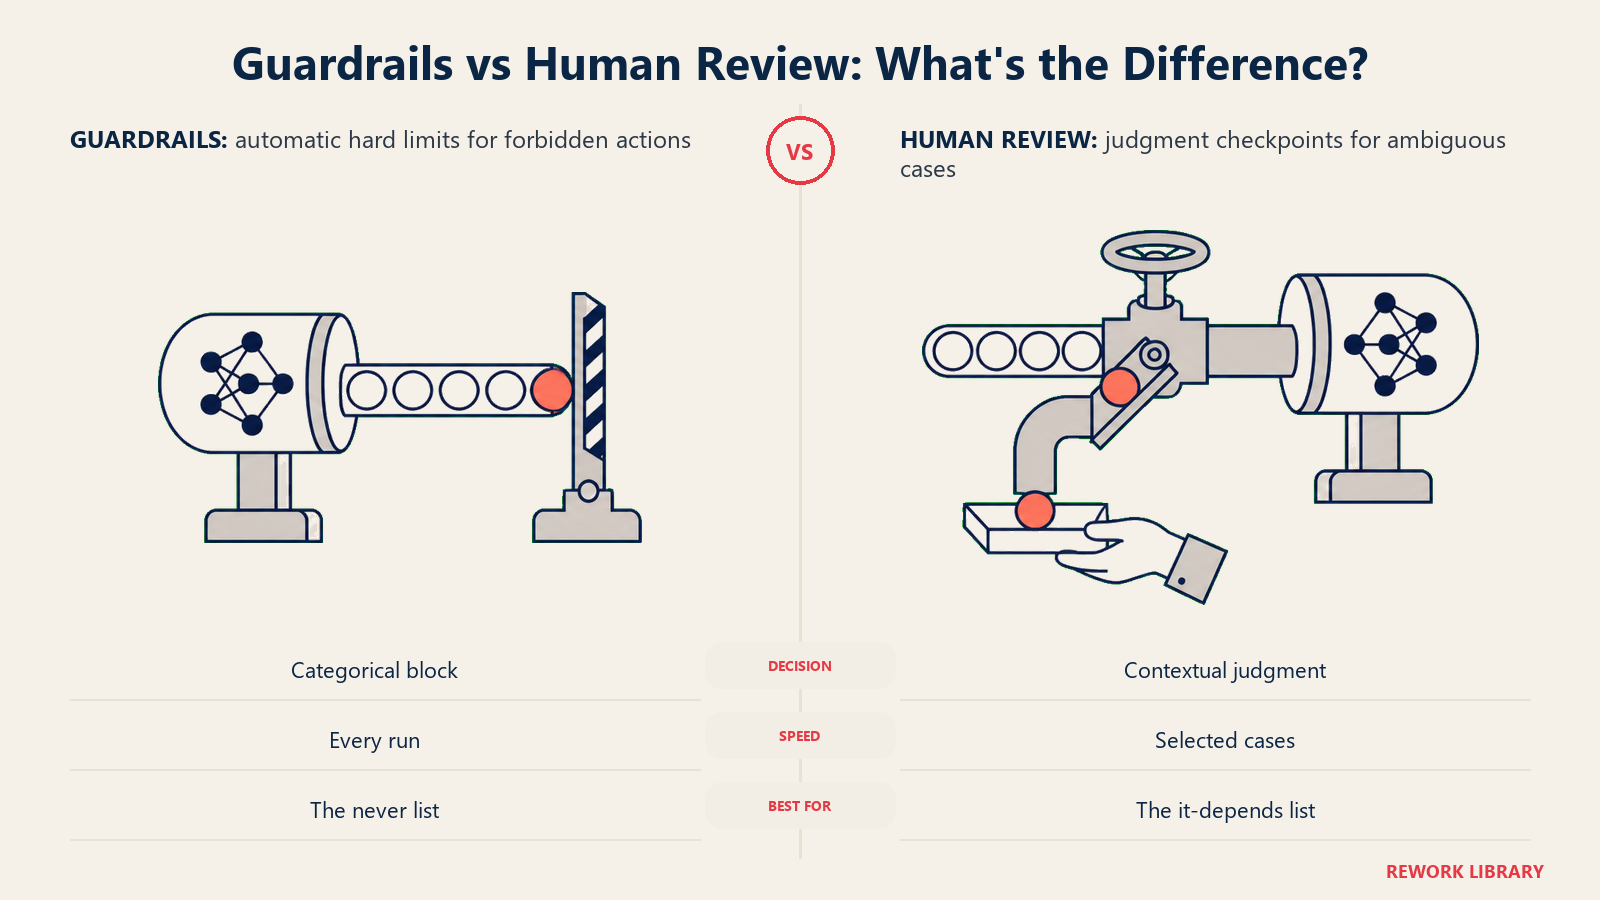
ガードレールは自動的で、例外を認めません。許可を求めることなく、「文脈に関係なく、Xは決してしない」という線を強制します。ループを通過するたびに、機械の速度で、誰もリアルタイムで見ていなくても作動します。
ヒューマンインザループのチェックポイントは、ブロックではなく一時停止です。正しい答えが、ポリシーで事前に完全には表現しきれない判断に左右されるケースのためのものです。特定のアカウントに限って理にかなう価格の例外や、弁護士の確認が必要な微妙な契約条項などです。agentは答えが間違っていると分かっているわけではなく、状況がセカンドオピニオンを要するタイプだと認識しているのです。
まとめると、ガードレールは「絶対にしない」リストを担当し、人間のチェックポイントは「場合による」リストを担当します。ガードレールだけのagentは硬直的で、ルールを書いた人が想定しなかった事態に出し抜かれます。人間のチェックポイントだけのagentは遅く、そもそも仕事を自動化する意味がなくなります。必要なのは、堅い土台と判断のバルブの両方であり、どちらか一方ではありません。
機能別のガードレール例
このライブラリのブループリントから、実際に強制できるほど具体的になったガードレールの例をいくつか挙げます。
| Agent | ガードレール |
|---|---|
| Invoice AP Agent | マッチスコアがどれほど高くても、承認済みの発注書と一致しない請求書は決して支払わない |
| Expense Approval Agent | 固定の金額しきい値を超える場合は決して自動承認せず、それを上書きできる例外ロジックも持たせない |
| AI Contract Review Agent | 個々の変更について人間の承認なしに、レッドラインや回答を相手方に送らない |
| AI Security Monitoring Agent | 重大度がクリティカルのアラートは決して自動でクローズしない。agent自身の確信度に関係なく、SOCにルーティングする |
| AI Access Provisioning Agent | 記録に残る承認者なしに、昇格権限や管理者レベルのアクセスは決して付与しない |
これらはいずれも、意図的に狭く、二者択一です。「支払いについては良識をもって判断する」というガードレールは、ガードレールではなく願望です。「一致する発注書がなければ決して支払わない」なら、構築でき、テストでき、証明できます。
IT向けのagent全体でガードレールとアクセスポリシーを標準化する場合は、開発・ITツールのカテゴリとITSMソフトウェアの選び方が、これらのガードレールの多くが最終的に載ることになるポリシーエンジンと承認ワークフローを取り上げています。
Key Facts
- ガードレールとは、状況のすべてがそれをすり抜けようとしても守られる絶対的な制限です。ルールは通常の振る舞いを形づくり、ガードレールは異常な振る舞いを止めます。
- 効果的なガードレールは2つの層で動きます。コンテンツが信頼できるコンテキストになる前の入力フィルタリングと、アクションや応答が確定する前の出力フィルタリングです。
- ツールの許可リスト(最小権限)は、あらゆる悪い行動を拒否リストで列挙しようとするより優れています。これを怠ることを、OWASPはExcessive Agency(Top 10 for LLM ApplicationsのLLM06)と呼んでいます。
- ガードレールの質は、その裏にある敵対的テストの質で決まります。2026年の調査では、83%の組織がAIツールを使っている一方、強固なガバナンスフレームワークを整備しているのは約25%でした。
- ガードレールとヒューマンインザループのチェックポイントは役割が異なります。ガードレールは「絶対にしない」リストを自動で強制し、チェックポイントは判断が必要な「場合による」ケースを担います。
AI Agentのガードレールに関するよくある質問
AI agentのガードレールとは何ですか。
ガードレールとは、文脈に関係なく守られるようagentに組み込まれた絶対的な制限です。価格を勝手に作らない、ある顧客のデータを別の顧客と共有しない、承認なしにメールを送らない、といったものです。通常の指示と異なるのは、攻撃者、バグ、誰も想定していなかったエッジケースなど、何かが積極的にすり抜けようとしても守られるように設計されている点です。
ガードレールとルールの違いは何ですか。
ルールは、agentが通常どう振る舞うべきかを定めます。トーン、言い回し、どんな事実を述べるかなどです。ガードレールは、ルールが想定していなかった状況でも、決してやってはならないことを定めます。ルールが破られた場合、agentは少しブランドから外れた振る舞いをしただけです。ガードレールが破られた場合、agentは防ぐために作られていたまさにそのことをしてしまったことになります。
ツールには許可リストと拒否リストのどちらを使うべきですか。
許可リストです。agentが取るべきでないあらゆる行動を列挙しようとすると、リストは終わりがありません。許可することを正確に列挙し、それ以外はデフォルトでブロックする方法なら、範囲が有限で監査もできます。OWASPは、agentに仕事に必要な範囲を超える権限を与えることをExcessive Agencyと呼び、LLMアプリケーションのTop 10リスクの1つに挙げています。
agentのガードレールが実際に機能しているかどうかは、どうすれば分かりますか。
セキュリティチームが行うのと同じように、敵対的にテストします。ローンチ前に実施し、プロンプト、ツール、モデルのいずれかを変更するたびに再度実施してください。テストで一度も実際に攻撃されたことのないガードレールは、検証したものではなく、推測で信じているだけのものです。
ガードレールがあれば、ヒューマンインザループのチェックポイントは不要になりますか。
いいえ、対象とする失敗のモードが異なります。ガードレールは自動的で、例外を認めず、「絶対にしない」リストのためのものです。ヒューマンインザループのチェックポイントは、ガードレールでは事前に完全に表現しきれない判断のためのものです。成熟したagentには、堅い土台と判断のバルブの両方が必要です。
次に読むもの
ガードレール、人間によるチェックポイント、インジェクション対策は、3つの別々のプロジェクトではなく、1つのシステムを構成する3つの部分です。まずプロンプトインジェクションで、これらのガードレールが耐えるべき攻撃を理解し、続いてAI agentのヒューマンインザループで、ガードレールと並んで機能する判断の層を確認してください。6つの構成要素がそもそもどう組み合わさっているかについては、AI agentの仕組みから始めるのが最適です。
