Optimización de costos de AI agents: caché, enrutamiento de modelos y presupuestos
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
La optimización de costos de AI agents es el conjunto de técnicas que mantienen el gasto de tokens y de cómputo de un agent proporcional al valor que entrega: caché para que el agent no vuelva a pagar por un contexto que ya procesó, enrutamiento de modelos para que los pasos fáciles se ejecuten en modelos baratos y los difíciles en modelos caros, y presupuestos estrictos que limitan cuánto puede gastar una sola tarea antes de transferirla a una persona. Nada de esto es opcional una vez que un agent sale de la etapa piloto. Un agent que itera, llama herramientas y vuelve a leer el contexto en cada pasada puede convertir una demostración que costaba centavos en una tarea de producción que cuesta dólares, y la diferencia casi siempre está en una de estas tres palancas, no en el modelo en sí.
Por qué la curva de costos de un agent no es la de un modelo
Una sola llamada a un modelo tiene una entrada, una salida y un precio. Cómo funcionan los AI agents describe a un agent como un ciclo: percibir, razonar, actuar, observar y repetir, y cada pasada por ese ciclo puede activar su propia llamada al modelo o a una herramienta. Una tarea que requiere una llamada en un caso simple puede requerir cinco, diez o más en uno más difícil, y cada una de esas llamadas reenvía cierta cantidad de contexto, de modo que el costo se acumula con las iteraciones de una forma en que una sola llamada nunca lo hace.
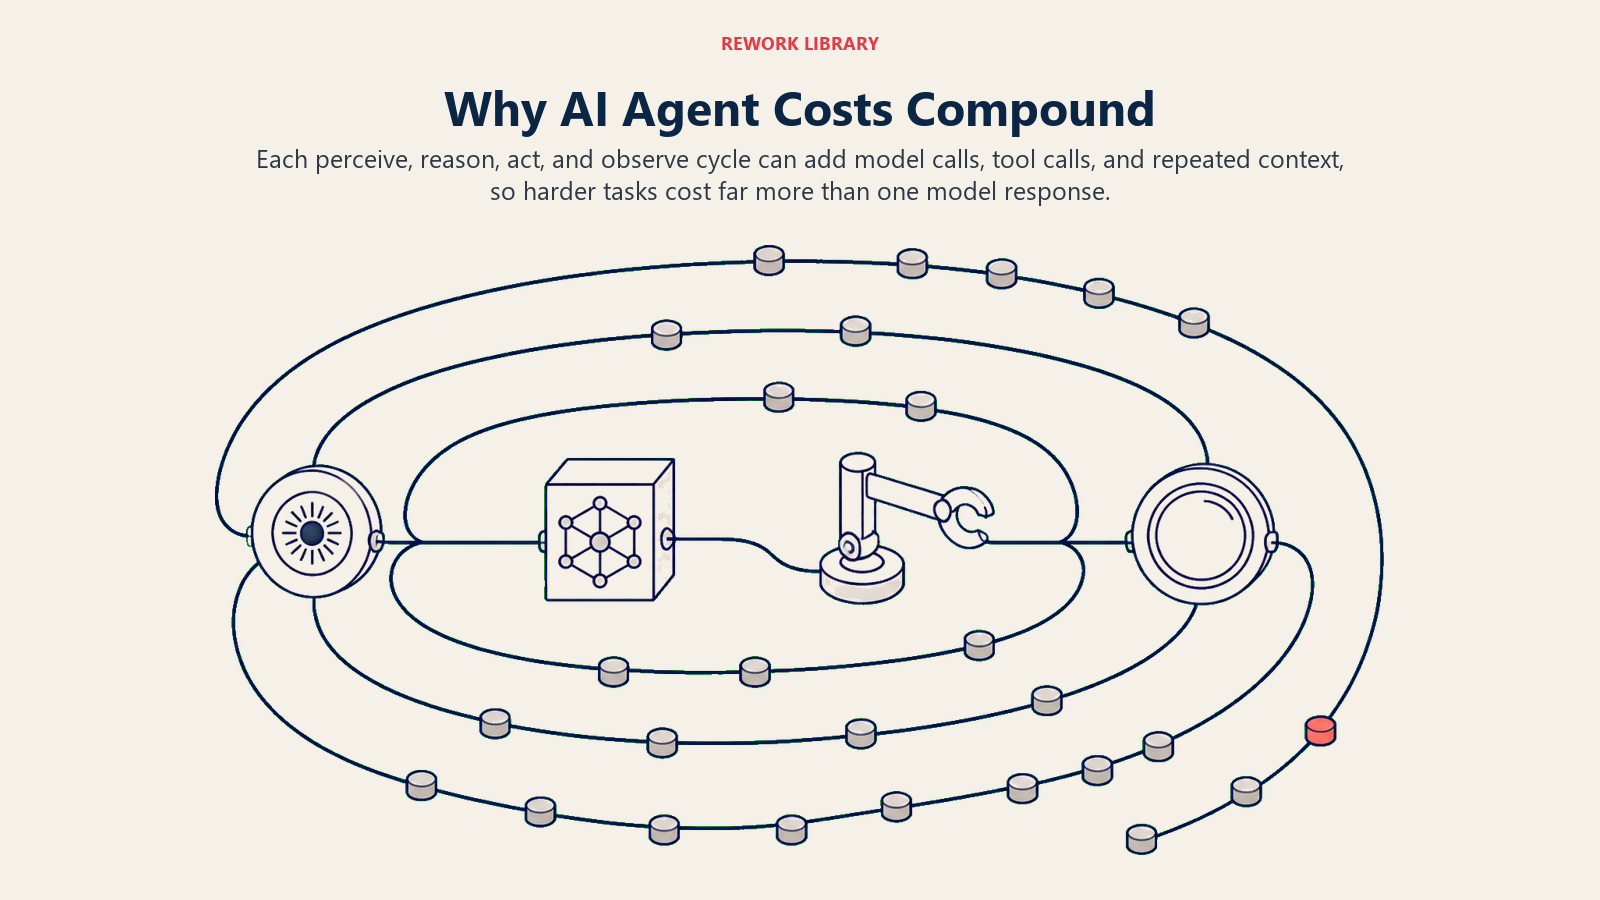
Por eso el costo aparece tan a menudo como razón por la que los proyectos agentic se estancan. Gartner pronostica que más del 40% de los proyectos de agentic AI se cancelará antes de que termine 2027, y cita como causas principales los costos crecientes, el valor de negocio poco claro y los controles de riesgo insuficientes. El aumento de costos rara vez es una sorpresa si se modela antes de escalar. Cuando los patrones de AI se encarecen a escala explica cómo un Autonomous Agent sin controles convirtió un solo ticket de soporte en 25 llamadas al modelo, en lugar de las dos o tres que suponía un piloto. Las tres palancas siguientes son la forma de evitar que eso le ocurra a usted.
Palanca 1: caché, para no pagar dos veces por el mismo contexto
Cada ejecución de un agent reenvía un bloque de contexto que casi no cambia de una llamada a otra: el system prompt, los esquemas de herramientas, un extracto largo de la knowledge base, la conversación hasta el momento. El caché significa que el proveedor del modelo recuerda ese bloque y cobra una fracción del precio por reutilizarlo en lugar de reprocesarlo desde cero.
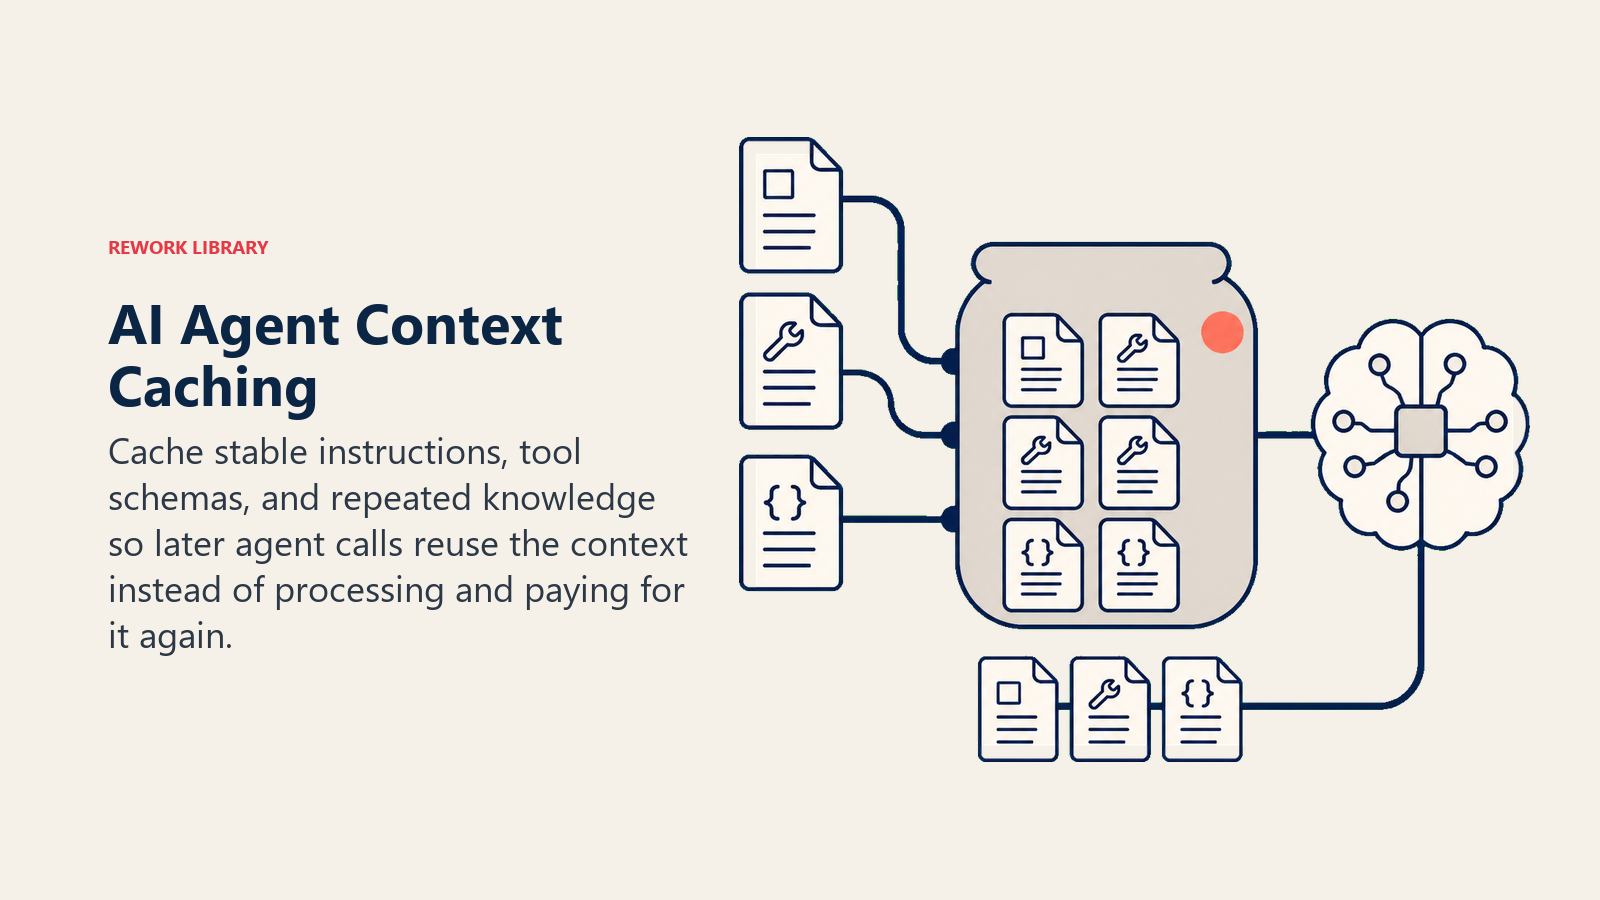
El descuento es real y es grande. Los precios de Anthropic muestran que los tokens de entrada en caché cuestan el 10% del precio base de entrada, una reducción del 90%, aunque escribir contenido nuevo en el caché cuesta un 25% más que una llamada normal, por lo que el caché se amortiza cuando un prompt se reutiliza más de un par de veces. OpenAI y otros proveedores importantes ofrecen su propia versión de descuentos por tokens en caché; el mecanismo exacto varía según el proveedor, pero la economía es la misma en todos. Para el trabajo que no necesita una respuesta inmediata (barridos nocturnos de higiene del CRM, clasificación por lotes de documentos, generación de informes durante la noche), la Batch API de Anthropic suma un descuento adicional: 50% menos que el precio estándar a cambio de un procesamiento asíncrono en lugar de una respuesta en vivo.
Vale la pena incorporar a un agent, desde el primer día, dos patrones de caché:
- Caché de contexto: almacene en caché el system prompt, las definiciones de herramientas y cualquier documento de referencia estático grande (un archivo de políticas, un catálogo de productos), de modo que solo las partes que realmente cambian entre llamadas se cobren a precio completo.
- Caché de respuestas: para preguntas realmente repetidas (las mismas preguntas frecuentes, la misma clasificación sobre entradas casi idénticas), omita por completo la llamada al modelo y sirva una respuesta almacenada, actualizada según un calendario y no regenerada cada vez.
Palanca 2: enrutamiento de modelos, para que los pasos fáciles no paguen precios de frontera
No todos los pasos del ciclo de un agent necesitan su modelo más capaz y más caro. Clasificar un ticket, extraer un campo de un formulario o verificar si un caso coincide con un escenario conocido es un trabajo distinto a redactar una respuesta matizada para un cliente o razonar sobre una excepción ambigua, y los precios de API publicados por todos los proveedores importantes muestran una brecha de un orden de magnitud, a menudo de 10 veces o más, entre un modelo pequeño y rápido y un modelo insignia de frontera.
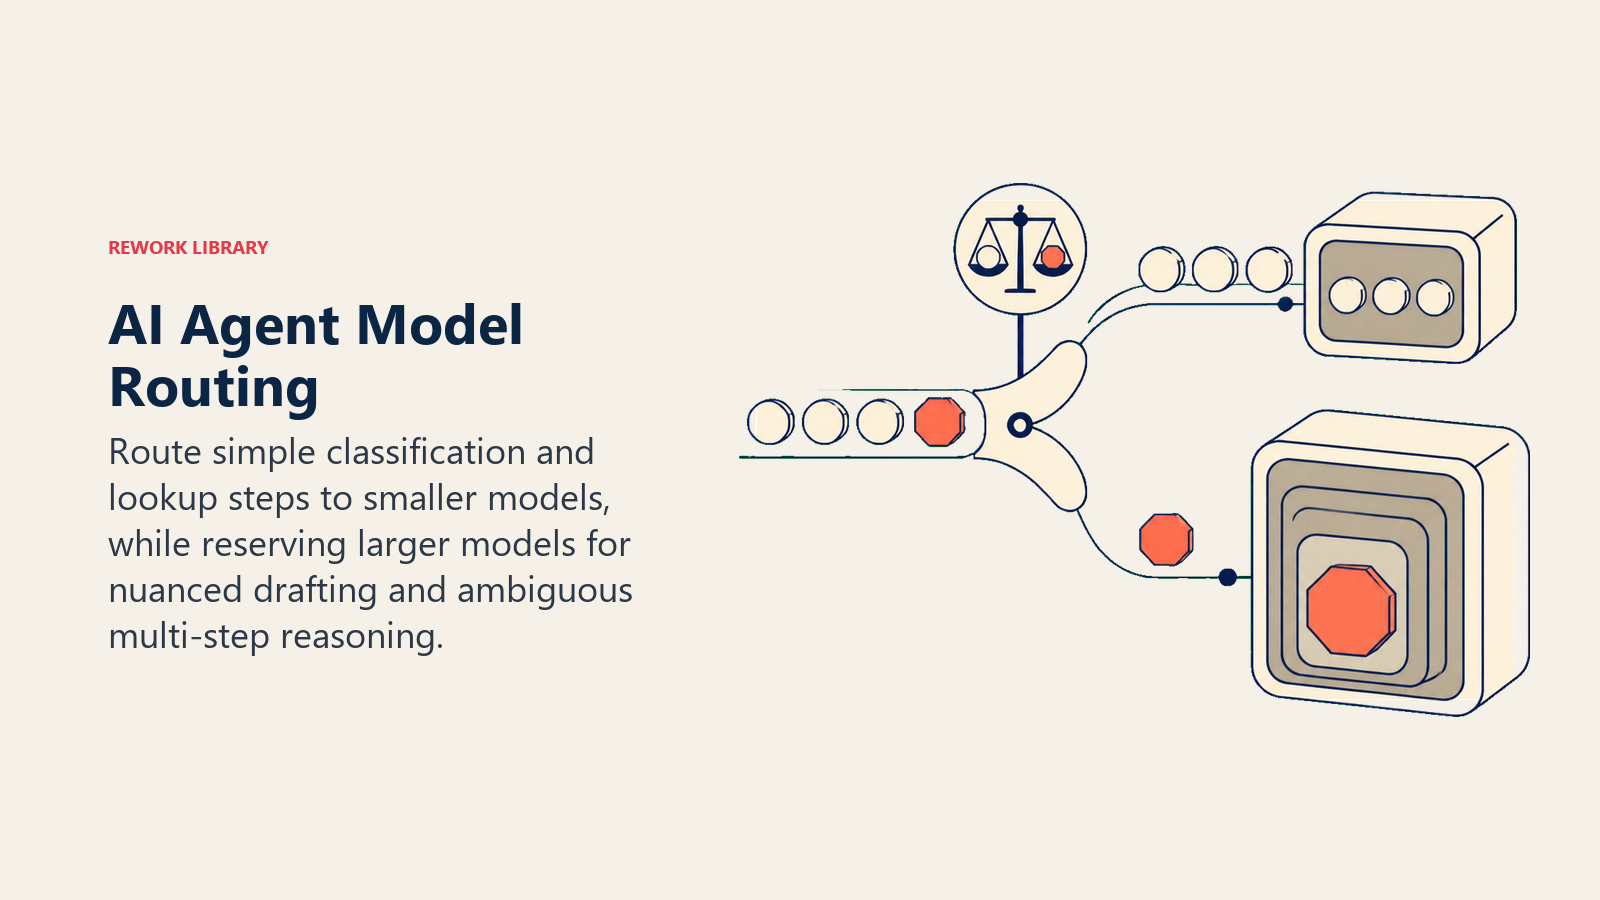
El enrutamiento de modelos significa asignar a cada paso el modelo que le corresponde, en lugar de ejecutar todo el agent en un solo nivel por defecto. Cuando los patrones de AI se encarecen a escala documenta esta misma idea en su sección de costos del Workflow Copilot: enrutar las solicitudes de sugerencias más simples a modelos más baratos y reservar la inferencia premium para las solicitudes que realmente la necesitan. Una tabla de enrutamiento sencilla para un agent típico:
| Tipo de paso | Ejemplo | Nivel de modelo |
|---|---|---|
| Clasificación, extracción, decisiones de enrutamiento | ¿A qué cola pertenece este ticket? | Pequeño, rápido, barato |
| Consultas estructuradas y coincidencia de reglas | ¿Esta factura coincide con una orden de compra aprobada? | Pequeño a mediano |
| Redacción de texto dirigido al cliente | Escribir la respuesta para este caso específico | Mediano a grande |
| Excepciones ambiguas y razonamiento de varios pasos | Este caso no coincide con ningún escenario del manual | El más grande disponible |
El componente de lógica de decisión que determina si un agent actúa, pregunta o transfiere es el mismo lugar al que pertenece el enrutamiento de modelos. Usted ya está ramificando la lógica por tipo de caso. Encamine la elección del modelo a través de esa misma ramificación en lugar de tratarla como una decisión aparte.
Palanca 3: presupuestos estrictos, para que una tarea descontrolada no dispare la factura
El caché y el enrutamiento reducen el precio por llamada. Los presupuestos limitan cuántas llamadas puede hacer una sola tarea, y eso importa porque los verdaderos descontroles de costos rara vez provienen del precio por llamada. Provienen de una tarea que sigue llamando al modelo muchas más veces de las que nadie planificó.
Cuando los patrones de AI se encarecen a escala lo plantea sin rodeos: un Autonomous Agent sin límites estrictos de iteraciones ni presupuestos de tokens por tarea es un pasivo financiero, no una herramienta de productividad. La solución son dos configuraciones, ambas sencillas de enunciar y fáciles de omitir: un número máximo de llamadas al modelo por tarea y una transferencia automática a una persona cuando la tarea alcanza ese límite, en lugar de seguir gastando. Ninguna de las dos es un extra que se añade después del primer mes costoso. Pertenecen junto con todos los demás límites estrictos que un agent necesita. Las barreras de protección de AI agents cubren en profundidad las barreras de salida y de llamadas a herramientas, y un tope de presupuesto es exactamente esa clase de barrera: una regla que se cumple sin importar cuán seguro esté el agent de que una llamada más terminará el trabajo.
Dónde se manifiesta esto en agents reales
Estas palancas no son abstractas. Algunos lugares de esta biblioteca donde acertar con ellas, o equivocarse, tiene un efecto desproporcionado en la factura:
- AI Research Agent: el costo escala directamente con cuántas fuentes lleva al contexto por informe. Acotar el número de fuentes y enrutar el paso de síntesis a un modelo de nivel medio en lugar del más grande disponible suele ser la diferencia entre un informe de 2 dólares y uno de 20 dólares.
- AI Knowledge Base Agent: los mismos documentos de políticas y extractos de preguntas frecuentes se recuperan a lo largo de cientos de preguntas similares, lo que lo convierte en uno de los lugares de mayor rendimiento para almacenar contexto en caché en lugar de reenviar los mismos fragmentos recuperados en cada consulta.
- AI Support Triage Agent: un alto volumen de llamadas hace que incluso un pequeño ahorro por llamada se multiplique rápido. Enrutar el paso de clasificación inicial a un modelo pequeño y reservar uno más grande para redactar la respuesta evita que el volumen se convierta en todo el presupuesto.
Un modelo de costos sencillo antes de escalar más allá del piloto
Antes de llevar un agent de un piloto pequeño a un volumen real, asigne cifras aproximadas a cuatro cosas: el promedio de tokens por llamada (mídalo, no lo adivine), el volumen de llamadas esperado a escala de producción, su supuesto de tasa de aciertos del caché y su distribución de enrutamiento entre niveles de modelo. Multiplíquelo al doble y a cinco veces el volumen del piloto, no solo al volumen del piloto, porque los pilotos se ejecutan con los casos más fáciles y representativos y la producción no. Cuando los patrones de AI se encarecen a escala recomienda añadir un margen del 50 al 100% a lo que sugieran sus muestras, precisamente por esta razón.
La otra cifra que conviene modelar desde temprano es el costo frente al resultado, no el costo frente a la actividad. Medir el ROI de los patrones de AI profundiza en ese enfoque: un agent más barato que falla la mitad de sus tareas no es realmente más barato una vez que se cuenta el tiempo humano dedicado a corregir lo que dejó. Y ampliando la mirada un nivel más: la inferencia de un agent es una partida dentro del panorama más amplio del costo total de propiedad de AI, que también incluye talento, integración y gobernanza, de modo que acertar con esta palanca no significa que el resto del presupuesto de AI se resuelva solo.
Vigilar el costo después del lanzamiento
La optimización del lanzamiento se desvía sin monitoreo posterior. La observabilidad de AI agents ya señala la métrica que más importa aquí: el costo por tarea completada, no el costo por ejecución, porque una ejecución que falla igualmente gastó tokens y una ejecución barata que falla dos veces antes de tener éxito no es realmente barata. Siga ese número junto con la tasa de aciertos del caché y la distribución por nivel de modelo, y preste atención cuando cualquiera de los tres se desvíe: un costo por tarea completada en alza, una tasa de aciertos del caché en descenso o un desplazamiento hacia el nivel caro en tipos de paso que antes se enrutaban al barato. Cualquiera de esas tres señales suele ser el primer indicio de que algo cambió en las entradas o el comportamiento del agent, mucho antes de que lo avise la factura.
Si usted está comparando plataformas para construir u operar agents, vale la pena puntuar explícitamente la previsibilidad de costos en lugar de suponer que es similar entre proveedores. Nuestras comparativas de herramientas de AI evalúan las plataformas más allá de las listas de funciones, y la matriz de evaluación de proveedores SaaS le ofrece una plantilla ponderada para poner la previsibilidad de costos en pie de igualdad con la capacidad al puntuar las opciones.
Datos clave
- Los tokens de entrada en caché cuestan un 90% menos que el precio estándar de entrada en los modelos de Anthropic (10% del precio base por leer del caché), mientras que escribir contenido nuevo en el caché cuesta un 25% más, por lo que el caché se amortiza con todo lo que se reutiliza más de una o dos veces.
- El procesamiento por lotes para el trabajo de agents que no es en tiempo real suma un descuento adicional del 50% sobre el precio estándar de la API.
- Gartner pronostica que más del 40% de los proyectos de agentic AI se cancelará antes de que termine 2027, con los costos crecientes entre las causas principales citadas.
- Los precios publicados de los modelos de los principales proveedores suelen mostrar una brecha de un orden de magnitud entre los modelos pequeños y rápidos y los modelos insignia de frontera, lo que hace del enrutamiento según la dificultad de la tarea la palanca de mayor impacto que la mayoría de los equipos aún no ha usado.
- El control financiero que más importa para un agent que itera es un tope estricto de llamadas al modelo por tarea con transferencia automática al alcanzarlo, no un precio más bajo por llamada.
Preguntas frecuentes sobre la optimización de costos de AI agents
¿Qué es la optimización de costos de AI agents?
Es el conjunto de técnicas que mantienen el gasto de tokens y de cómputo de un agent proporcional a lo que entrega: almacenar en caché el contexto repetido para no pagar por reprocesarlo, enrutar los pasos fáciles a modelos más baratos y los difíciles a modelos más capaces, y limitar cuánto puede gastar una sola tarea antes de transferirse a una persona.
¿Por qué los AI agents cuestan más de operar que una sola llamada a un modelo?
Un agent ejecuta un ciclo (percibir, razonar, actuar, observar y repetir), y cada pasada puede activar su propia llamada al modelo o a una herramienta. Una tarea que requiere una llamada en un caso simple puede requerir muchas más en uno más difícil, por lo que el costo se acumula con el número de iteraciones de una forma en que una sola llamada al modelo nunca lo hace.
¿Cuál es la diferencia entre el caché y el enrutamiento de modelos?
El caché reduce el costo de reutilizar el contexto que ya envió al modelo, a menudo en un 90% o más sobre la parte almacenada. El enrutamiento de modelos reduce el costo al asignar a cada paso el modelo más barato capaz de hacerlo bien, en lugar de ejecutar todos los pasos en su modelo más caro por defecto. Son complementarios, no alternativos.
¿Cuánto pueden ahorrar realmente estas técnicas?
Depende de su mezcla de contexto repetido, volumen de llamadas y complejidad de las tareas, pero los descuentos de fondo son considerables: 90% menos en los tokens de entrada en caché, 50% menos en el procesamiento por lotes y, por lo general, una brecha de precio de un orden de magnitud entre los modelos pequeños y los de frontera para los pasos que no necesitan razonamiento de frontera.
¿Qué es un tope de presupuesto razonable para la tarea de un agent?
No existe un número universal, ya que depende de la complejidad de la tarea, pero el principio sí es universal: fije un número máximo de llamadas por tarea y transfiera automáticamente a una persona cuando se alcance, en lugar de dejar que el agent siga intentando indefinidamente. Trátelo como una barrera de protección, no como una sugerencia.
A dónde ir a continuación
El caché, el enrutamiento y los presupuestos controlan lo que cuesta un agent. La observabilidad de AI agents es la forma de confirmar que esos controles siguen funcionando después del lanzamiento, ya que el costo por tarea completada es una de las señales tempranas más claras de desviación. Si usted aún no ha modelado por qué los costos se disparan a escala, cuando los patrones de AI se encarecen a escala es la lectura más profunda, y cómo construir un AI agent explica dónde encajan los topes de presupuesto entre el resto de las barreras de protección de un agent.

On this page
- Por qué la curva de costos de un agent no es la de un modelo
- Palanca 1: caché, para no pagar dos veces por el mismo contexto
- Palanca 2: enrutamiento de modelos, para que los pasos fáciles no paguen precios de frontera
- Palanca 3: presupuestos estrictos, para que una tarea descontrolada no dispare la factura
- Dónde se manifiesta esto en agents reales
- Un modelo de costos sencillo antes de escalar más allá del piloto
- Vigilar el costo después del lanzamiento
- Datos clave
- A dónde ir a continuación