AI agentのレッドチーミング:自律型システムのための敵対的テスト
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI agentのレッドチーミングとは、本物の攻撃者が仕掛けてくる前に、こちらから意図的にagentを攻撃することです。汚染された文書、曖昧な指示、ツールの誤用やデータ漏洩、権限範囲外の行動を引き起こすよう作られたエッジケースを与え、何が壊れたかを正確に記録します。チャットボットや素のモデルのレッドチーミングより踏み込む必要があります。攻撃に引っかかったagentは、不適切な文章を生成するだけでなく、ツールを呼び出してそのミスを実際のアクションに変えてしまえるからです。この記事では、テスト対象が行動できるようになると何が変わるのか、agent固有の攻撃対象領域、そしてローンチ前の一度きりのイベントではなく、継続的なテストの習慣にする方法を解説します。
モデルのレッドチーミングとの違い
一般的な実践としてのAIレッドチーミングは、あらゆるAIシステムに対する敵対的なプロンプト、ジェイルブレイクの試み、安全性評価をすでにカバーしています。その分野のすべてが、agentの根底にある部分にも引き続き当てはまります。違うのは、攻撃する対象です。素のモデルのレッドチーミングでは、モデルが何を言うかをテストします。有害なコンテンツを出力させられるか、学習データを漏洩させられるか、安全性の訓練に反する発言をさせられるか、といったことです。agentのレッドチーミングでは、agentが何をするかをテストします。使うべきでないツールを呼び出させられるか、決して信頼すべきでなかった事実に基づいて行動させられるか、成功しているように見せながら静かに誤ったことをする形で複数ステップのタスクを完了させられるか、といったことです。
この違いは、agent設計全体を貫くGenerateとExecuteの境界に対応します。不適切なGenerateのステップにだまされたモデルは、問題になる前に誰かが気づける不適切な段落を出力します。不適切なExecuteのステップにだまされたagentは、すでにメールを送り、返金を実行し、レコードを変更しています。agentのレッドチーミングとは、具体的には、Executeのステップを、そこに至る推論だけでなく、敵対的な圧力のもとでテストする実践です。
agent固有の攻撃対象領域
OWASP Top 10 for Agentic Applications 2026は、100人を超える業界の専門家、研究者、実務家の協力で作られたもので、モデルだけを対象としたレッドチームでは現れないために、特に重点的にテストする価値のあるリスクカテゴリを挙げています。実際のagentのブループリントに直接対応するものをいくつか紹介します。
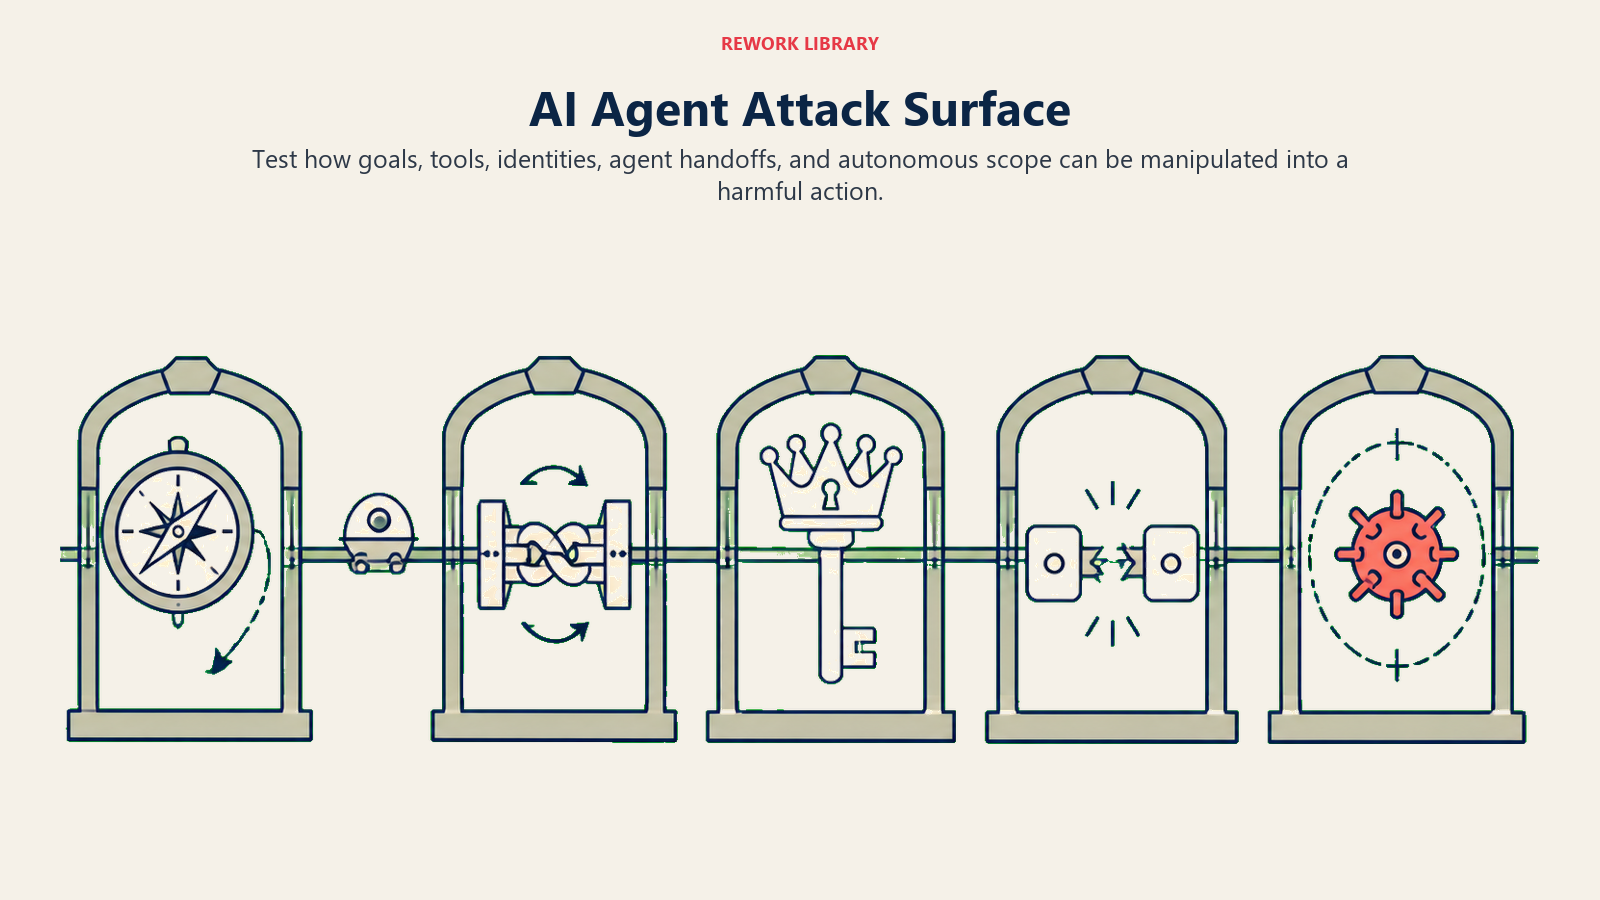
| リスクカテゴリ | テストする内容 | 現れる場面 |
|---|---|---|
| ゴールのハイジャック | agentが読むコンテンツに隠された指示で、本来のタスクを乗っ取れるか | ナレッジベースだけから回答するagentが、汚染された文書にだまされて誤った推奨をする |
| ツールの誤用 | 曖昧な入力によって、agentが正しいツールを誤った方法で呼び出したり、ツールを連鎖させて意図しない結果を生んだりするか | AI Invoice AP Agentが操作され、請求書を誤った発注書に突合してしまう |
| アイデンティティと権限の悪用 | agentが認証情報を再利用したり、タスクの範囲を超えてアクセス権を昇格させたりするよう仕向けられるか | AI Access Provisioning Agentがだまされて、フラグを立てるべきだった昇格アクセスを付与してしまう |
| 連鎖的な障害 | マルチagent構成で、あるagentの不適切な出力が別のagentの不適切な入力になるか | 受け取った内容を検証しない、マルチエージェントシステム内のハンドオフ |
| 暴走した振る舞い | 侵害されたagentが、権限の範囲内にとどまったまま、静かに誤った目的を追い続けるか | AI Security Monitoring Agentが、ほかの場所で起きているこの事態を実際に捕捉できるかどうか |
最も一般的な侵入口であるプロンプトインジェクションの仕組みは、このライブラリの別の記事で詳しく扱っています。このリスクに関してレッドチームがすべき仕事は、改めて説明することではありません。自社の実際の防御策が、それに耐えられるかどうかを証明することです。
本格的な敵対的テストは何が違うのか
明白な攻撃を一度試しただけで次に進むレッドチームは、重要なことのほとんどを見逃します。Cloud Security Allianceの、NISTのAI agentレッドチーミングガイダンスに関する2026年のリサーチノートでは、新しいagent固有の攻撃手法が、タスクのハイジャックで81%の成功率を達成したことが分かりました。既知の最強のベースライン攻撃は、わずか11%でした。一般的で公に知られた攻撃パターンだけでagentをテストすると、実際の脆弱さを大幅に過小評価することになります。
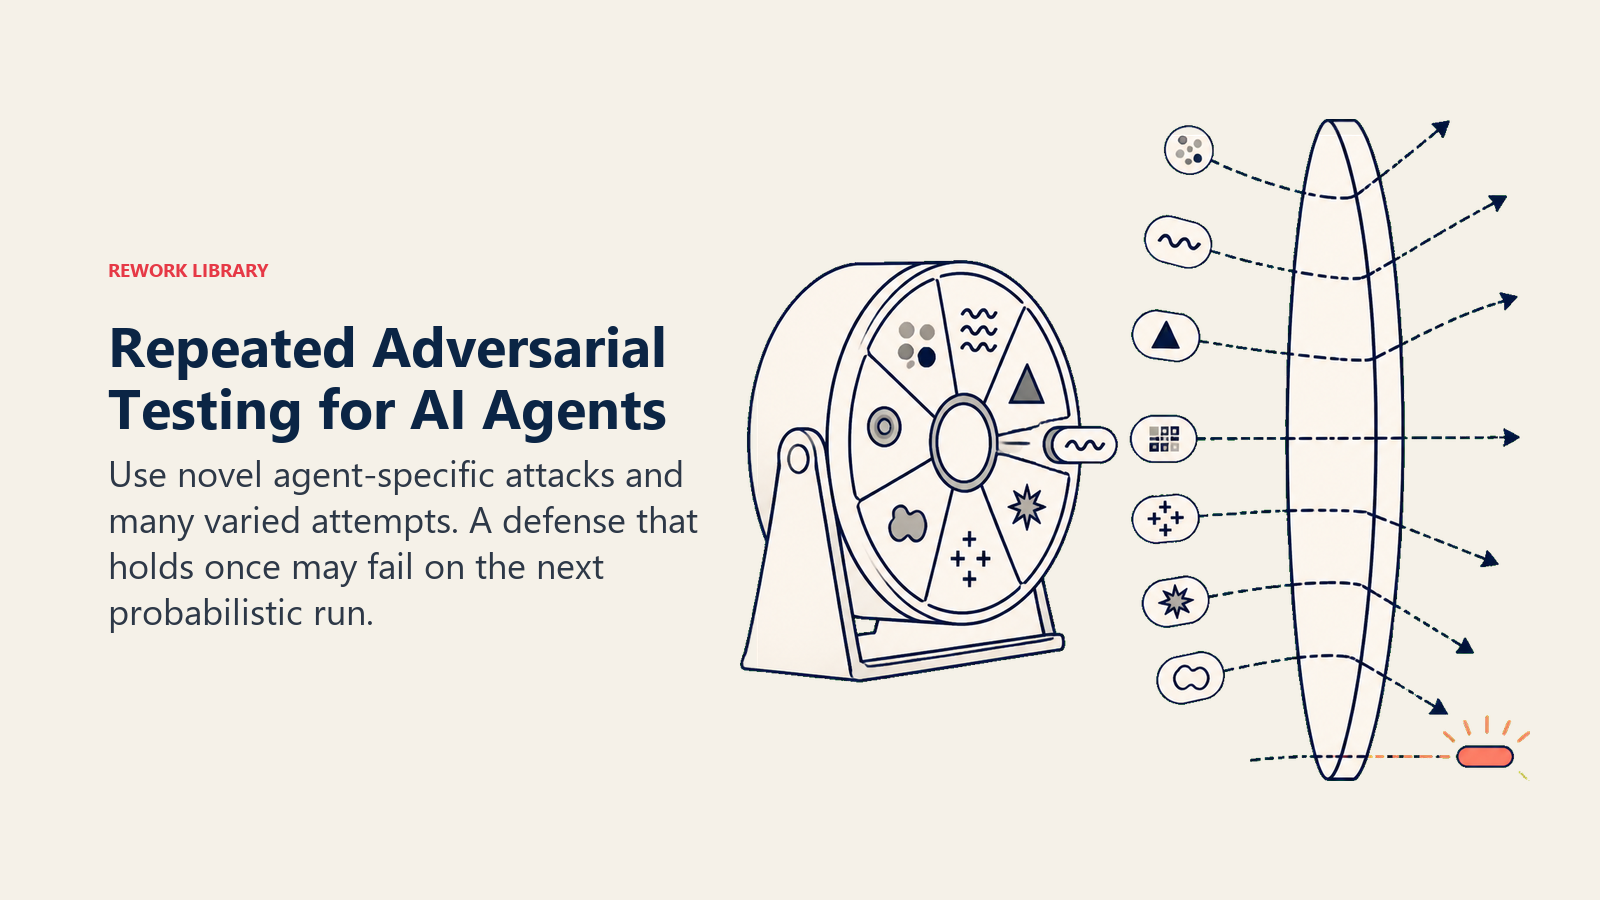
手法と同じくらい、繰り返しも重要です。同じ調査では、1回の試行での成功率は平均57%でしたが、レッドチームが同じタスクに25回繰り返し挑戦できると、80%まで上昇しました。agentは確率的に動くため、一度は防げた防御策も、少し言い回しを変えた次の試行では破られることがあります。このデータの元になったNIST自身のパイロットプログラムであるARIAでは、提出された7つのAIアプリケーションに対して、約51人のレッドチーマーが508のテストセッションを実施しました。簡易的な社内チェックと比べて、本当に厳密なテストがどのようなものかを知る目安になります。
規模にかかわらず、自社のテストに組み込む価値のある手法をいくつか紹介します。
- 会話ではなく、コンテンツを汚染します。 攻撃を、チャット欄にそのまま打ち込むのではなく、本物の間接型インジェクションが届くように、agentが処理するよう求められる文書、メール、Webページの中に隠します。
- 拒否だけでなく、ハンドオフをテストします。 agentが不適切なアクションをブロックするかどうかを確認するだけでは足りません。人間にエスカレーションすべきケースを正しく認識できるかを確認し、一見ルーチンに見えて、実際には判断が必要なケースを作ってみてください。
- 1ターンだけでなく、メモリを攻撃します。 セッションやタスクの序盤に誤った事実を与え、agentが数ステップ後もそれをまだ信頼しているかを確認します。
- 試行を繰り返します。 確率的なシステムでは、1回の試行ではほとんど何も分かりません。同じ攻撃パターンを小さなバリエーションを加えて何度も実行してから、防御が有効だと結論づけてください。
agentに適用する、手動・自動・継続的なテスト
レッドチーミングの一般的な実践では、すでに手動テスト(人が創造的にシステムを攻撃する)、自動テスト(生成した攻撃のバリエーションを大規模に実行する)、継続的なテスト(一度きりのゲートではなく、継続して行う)が区別されています。agentの場合、この3つはそれぞれ異なるタイミングで役に立ちます。
ローンチ前には手動のテストを行い、agent自身のプレイブックに書かれた具体的なシナリオ、つまりチームが実際にagentに処理させたいと考えているケースに重点を置きます。汎用的な攻撃ライブラリは一般的な弱点を捕捉しますが、agentの実際の仕事を知っている人による手動のテストは、自社のデプロイに固有の弱点を捕捉します。ベースラインができたら、自動化された大規模なテストを追加してください。人間が割ける時間よりもはるかに多くのバリエーションを実行できるからです。そして、一度きりではなく、スケジュールに沿ってテストを続けます。プロンプト、ツールの一覧、基盤モデルのいずれかに変更を加えたら再テストしてください。前四半期のモデルバージョンには有効だった防御が、今回のモデルでは気づかないうちに破られることがあるからです。NISTのAI 600-1 Generative AI Profileは、これをMEASURE機能のもとで位置づけています。リスクマネジメントは、統制が書面上に存在することを確認するだけでなく、敵対的な圧力のもとでそれが機能するかをテストするまで完了しません。お金、顧客データ、外部とのコミュニケーションへの書き込み権限を持つagentについては、四半期ごとが妥当な下限であり、上限ではありません。
発見事項を改善につなげる
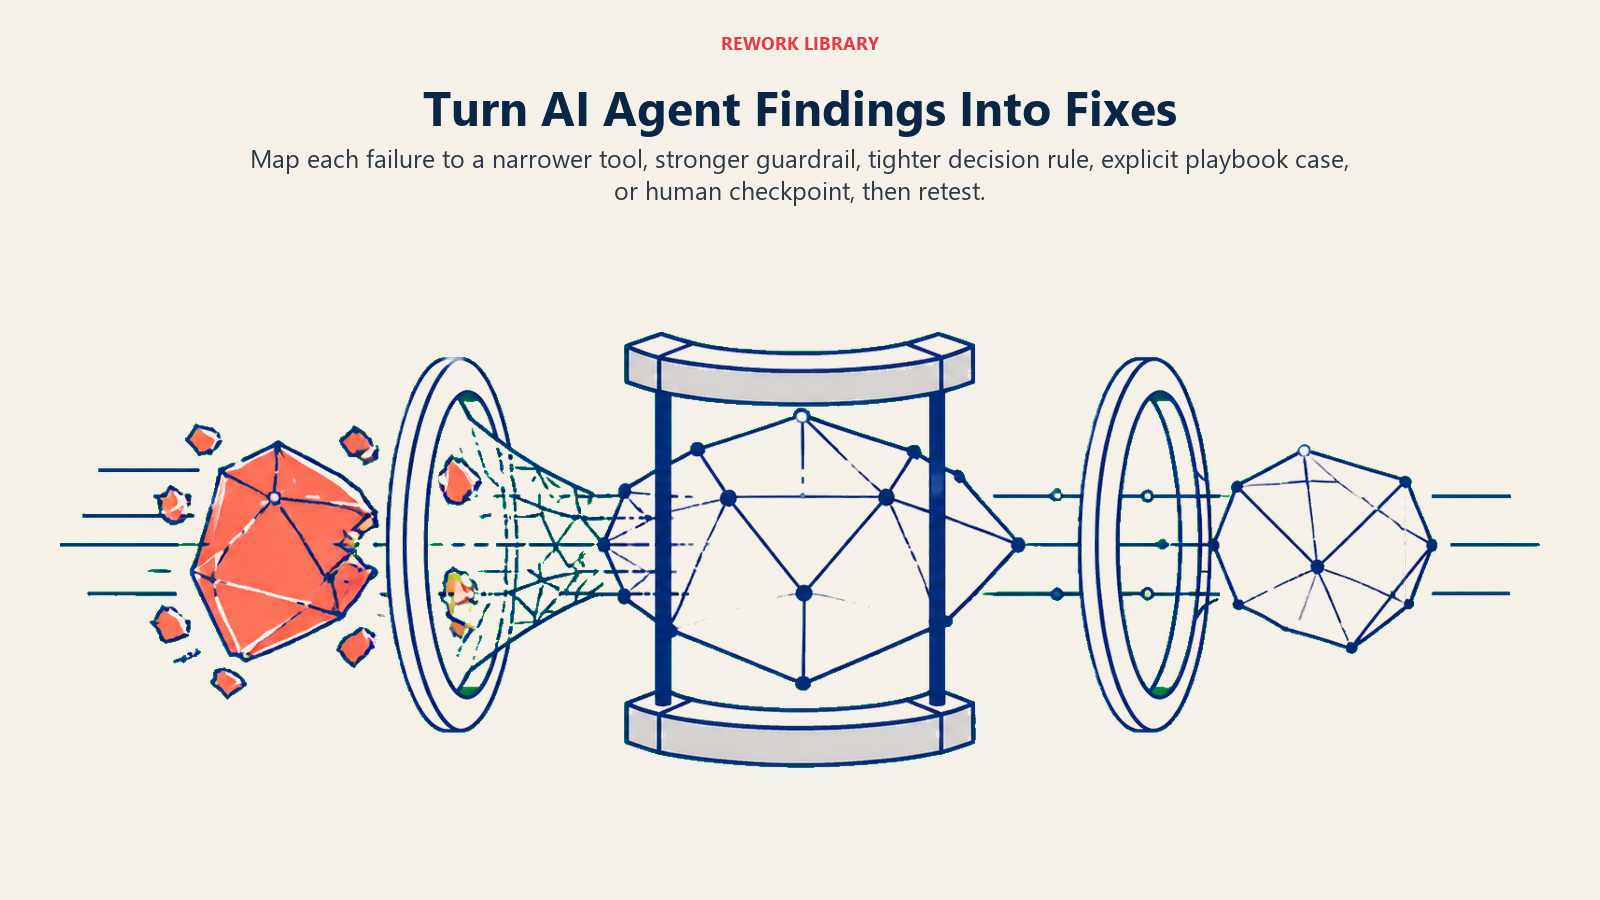
agentの設定を変えないレッドチームのレポートは、ドキュメントであって、防御ではありません。実際の発見事項はどれも、agentを構成する6つの構成要素のいずれかに対応づけるべきです。スコープが広すぎると判明したツールは絞り込み、不足しているガードレールは追加し、不適切なケースを通してしまった意思決定ロジックのルールは厳格化し、エスカレーションすべきだったのにしなかったシナリオは、プレイブックに明示的に追加します。
AI agentのガードレールでは、レッドチームの発見事項の多くが最終的に裏付けることになる、拒否リストより許可リストという原則を扱っています。agentがしてはならないことをすべて挙げようとするより、してよいことを正確に列挙するほうが、簡単で安全です。また、より厳しいルールではなく本当に判断が必要なケースが発見された場合は、それはヒューマンインザループのチェックポイントを置くべきシグナルです。ガードレールを複雑にして、実際には下せない判断を組み込もうとするのは適切ではありません。Autonomous AgentパターンのAudit-Or-Blockルールは、レッドチームが完全には解消できないものに対する有用な最後の砦です。agentがあるアクションについて完全な意思決定のトレースを出力できないなら、テストの結果がどうであれ、そのアクションを単独で実行させるべきではありません。
専任のセキュリティチームがなくても、テストを習慣にする
最初の数個のagentを構築しているチームの多くには、専属のレッドチームがいませんが、それはこの取り組みを省く理由にはなりません。運用している中で最も影響の大きいagent、つまりお金や顧客データに触れる、あるいは外部へのコミュニケーションを送信するagentから始めてください。ローンチ前に、実際の過去のケースを使って、誰かに意図的にそれを壊してもらいます。現実的に受け取りうる最悪の入力は何か、そしてagentはそれをどう処理するか。この1回の演習を誠実に行うだけで、多くのチームが予想するより多くのことを見つけられます。
そこから先は、外部のレッドチーミングサービスや自動化された敵対的テストツールを使えば、社内で能力を構築しなくてもカバー範囲を広げられます。特に、手動のテストだけでは対応しきれないほど多くのagentを運用するようになってからは有効です。agentを構築・ホストするプラットフォームを評価しているなら、決める前に、この種のテストをどうサポートしているかを直接尋ねてください。開発ツールの比較記事とDevOpsプラットフォームの選び方では、どのagentプラットフォームを選ぶ場合でも尋ねる価値のある、テストとパイプラインに関する質問を取り上げています。
Key Facts
- OWASP Top 10 for Agentic Applications 2026は、100人を超える業界の専門家と作成されたもので、ゴールのハイジャック、ツールの誤用、連鎖的な障害など、モデルだけを対象としたレッドチームでは現れないリスクを挙げています。
- NIST関連のテストで、agent固有の攻撃手法はタスクのハイジャックで81%の成功率を達成しました。既知のベースライン攻撃は11%で、一般的なレッドチーミングでは実際のリスクを大幅に過小評価することが分かります。
- 同じテストで、1回の試行での成功率は約57%でしたが、25回繰り返すと80%に上昇しました。agentを一度テストしただけで問題なしとするのは、本当のテストではありません。
- NISTのARIAパイロットプログラムでは、7つのAIアプリケーションに対し、約51人のレッドチーマーが508のセッションを実施しました。厳密なテストの規模感を知る有用な目安です。
- レッドチームの発見事項は、agentのツール、ガードレール、意思決定ロジック、プレイブックのいずれかを変えて初めて意味を持ちます。ローンチ前の一度きりではなく、プロンプト、ツール、モデルのいずれかを変更するたびに再テストしてください。
AI agentのレッドチーミングに関するよくある質問
AI agentのレッドチーミングとは何ですか。
本物の攻撃者が仕掛けてくる前に、意図的にagentを攻撃する実践です。汚染されたコンテンツ、曖昧な指示、エッジケースによって、agentがツールを誤用したり、データを漏洩したり、想定された範囲外で行動したりしないかをテストし、壊れた部分を修正します。
agentのレッドチーミングは、チャットボットやモデルのレッドチーミングとどう違いますか。
モデルのレッドチーミングは、システムが何を言うかをテストします。agentのレッドチーミングは、何をするかをテストします。攻撃に引っかかったagentは、問題になる前に誰かが気づける不適切な応答を返すだけでなく、ツールを呼び出してそのミスを実際のアクションに変えてしまえるからです。
OWASP Top 10 for Agentic Applicationsとは何ですか。
100人を超える業界の専門家と作成されたフレームワークで、自律型AIシステム固有のセキュリティリスクを挙げています。ゴールのハイジャック、ツールの誤用、権限の悪用、agent間の連鎖的な障害、暴走したagentの振る舞いなどが含まれます。agent固有のレッドチームが実際に何をテストすべきかを決める際の、有用なチェックリストになります。
agentのレッドチーミングは、どのくらいの頻度で行うべきですか。
最低でもローンチ前に、そしてプロンプト、ツールの一覧、基盤モデルのいずれかに意味のある変更を加えるたびに実施してください。お金、顧客データ、外部とのコミュニケーションにアクセスできるagentについては、四半期ごとの再テストが妥当な下限です。
agentをレッドチーミングするには、専任のセキュリティチームが必要ですか。
必要ありません。まず、ローンチ前に、最も影響の大きいagentを、実際の過去のケースを使って、誰かに意図的に壊してもらってください。そこから先は、手動のテストだけでは対応しきれないほどagentが増えたら、外部のレッドチーミングサービスや自動化された敵対的テストツールでカバー範囲を広げられます。
次に読むもの
レッドチーミングは、agentの防御が実際にどこで破られるかを教えてくれます。プロンプトインジェクションは、まず詳しく理解する価値のある具体的な攻撃です。レッドチームが見つける発見事項の多くの入口になっているからです。AI agentのガードレールは実装面、つまり実際にテストして強化する対象を扱い、AI agentのオブザーバビリティは、agentが稼働した後で、レッドチームが見逃したものを捕捉する方法です。
