AI Agentのオブザーバビリティとモニタリング
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI agentのオブザーバビリティとは、agentのループの1周ごとの動きを見られるように、agentに計測の仕組みを組み込むことです。何がきっかけで起動したか、何を判断したか、どのツールを呼び出して何が返ってきたか、どこで人に引き継いだかを把握します。単一のアウトプットが正しく見えるかどうかを見るだけにとどまりません。agentが生み出すのは1つのアウトプットではないからです。タスクを通じて一連の判断とアクションを実行し、その連鎖のどこにでも障害が潜みえます。オブザーバビリティがなければ、中を実際には見られない自律的なシステムを、ただ信じているだけになります。
モデルを見ることとは違う理由
AIオブザーバビリティはすでに一般的なケースを扱っています。データパイプライン、モデル呼び出し、アウトプットにわたって、AIシステムが何をしているかを示すログ、メトリクス、トレース、評価です。この土台のすべては、agentにも引き続き当てはまります。変わるのは、見る対象の単位です。
単一のモデル呼び出しには、1つの入力と1つの出力があります。記録し、採点して、次へ進めます。agentの実行は一連のシーケンスです。5ステップのこともあれば20ステップのこともあり、それぞれが直前のステップで起きたことの上に立つ新しい判断です。AI agentの仕組みは、このシーケンスをループとして説明しています。知覚、推論、実行、観察、そして繰り返しです。そこにすでに「観察」という言葉があることに注目してください。これは、次に何をするかを決める前に、agentが自分のツールの出力を確認する、内部的で一瞬のチェックです。agentのオブザーバビリティは別のものです。あなたが外側から、すべての実行にわたって、時間をかけてループ全体を見ることです。agentの内部の観察ステップは、1回のツール呼び出しがうまくいったかを教えてくれます。あなたのオブザーバビリティの層は、agentが2週間ずっと静かに誤った判断を続けていないかを教えてくれます。
この違いが重要なのは、技術的には問題なく動いている、クラッシュもエラーもないagentでも、誤ったことをしている場合があるからです。適切なツールを、微妙に誤ったパラメータで呼び出すかもしれません。同じ失敗したステップを数回余計に繰り返してから諦めるかもしれません。人への引き継ぎが、本来より極端に多かったり少なかったりするかもしれません。そのどれもエラーとしては表示されません。トレースを取っていれば、そのすべてがトレースに表れます。
1回のagent実行でトレースすべきこと
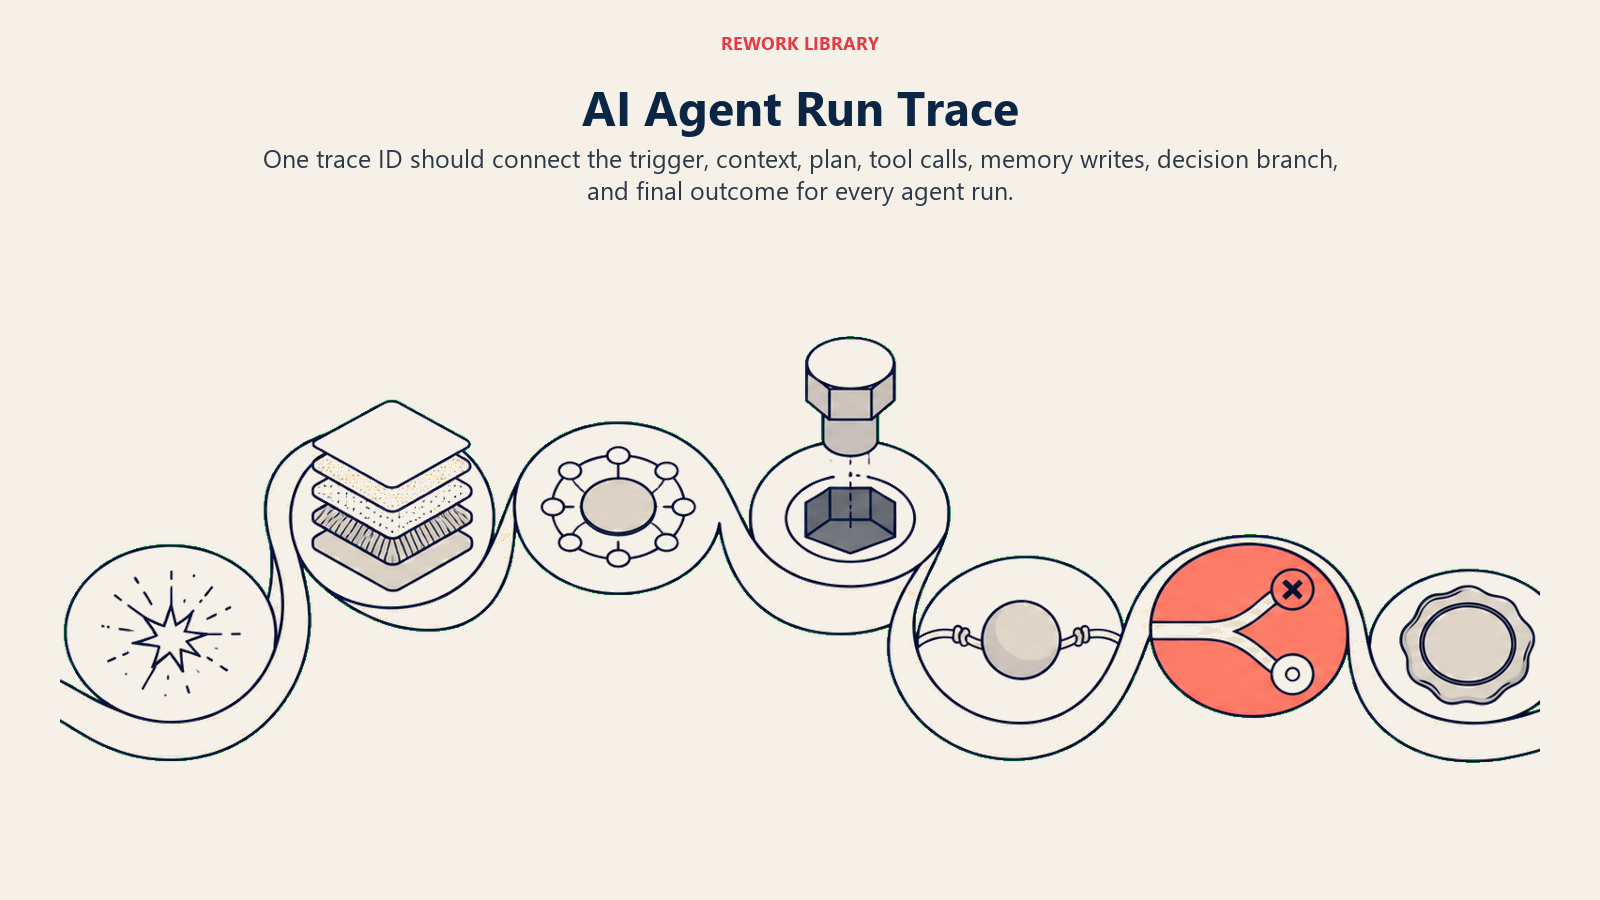
agentの実行は、開始から終了まで追跡する1つのIDを持つ、1つのトレース可能な単位として扱ってください。最低限、次を記録します。
| ステージ | 記録すること |
|---|---|
| トリガー | 実行のきっかけ。新しいメッセージ、レコードの変更、スケジュールなど |
| 取得したコンテキスト | 判断する前にagentが読んだレコード、ドキュメント、メモリ |
| 推論 | 選択した計画や次のアクションと、プラットフォームが表示できる場合はその理由 |
| ツール呼び出し | 呼び出したすべてのツール、送信したパラメータ、返された生の結果 |
| メモリへの書き込み | 後のステップや後の実行のためにagentが保存した内容 |
| 判断の分岐 | 自動で実行したか、確認の質問をしたか、引き継いだか |
| 結果 | 目標を達成した、早期に停止した、エスカレーションした、失敗した、そしてその理由 |
最後の列の「理由」は、チームが省略し、あとで後悔する部分です。「人に引き継いだ」とだけ書かれたログは、ほとんど何も教えてくれません。「引き継ぎ:返信に価格に関する質問が含まれていた。ルール4により、agentの対応範囲外」と書かれたログなら、agentが適切に引き継いでいるのか、安全のためにすべてを引き継いでいるだけなのかが分かります。AI agentの仕組みで取り上げている意思決定ロジックの構成要素は、まさにここで監査する対象であり、一度も記録しなかったルールを監査することはできません。
agentにとって本当に重要な指標
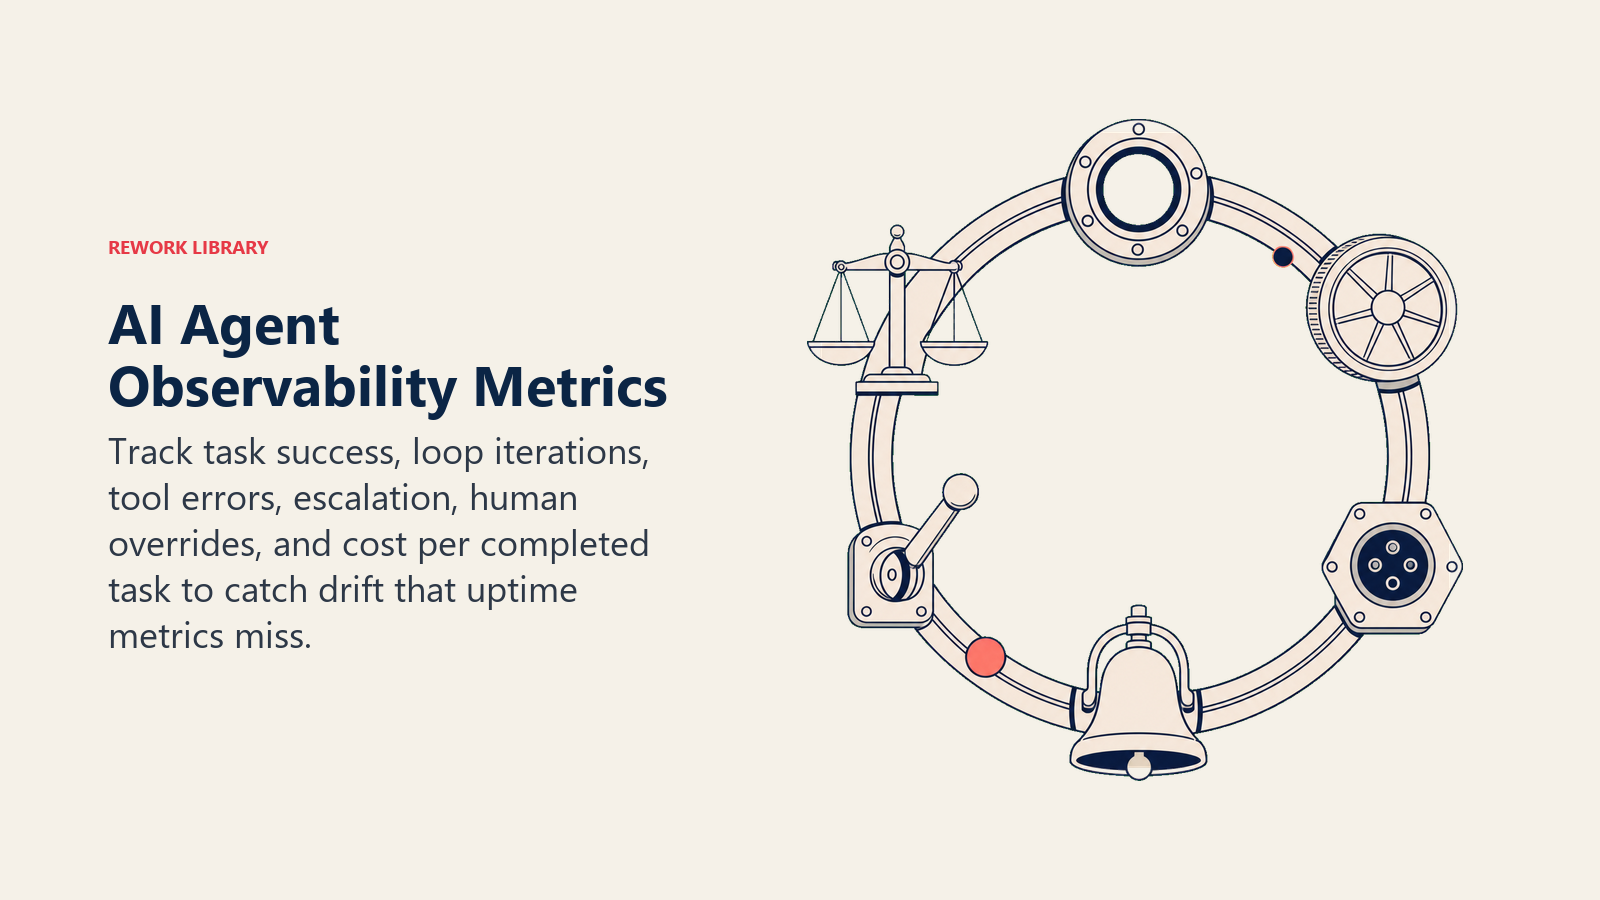
一般的なAIの指標(レイテンシ、リクエストあたりのコスト、エラー率)は引き続き当てはまりますが、ループで動くものについては、全体像を語ってくれません。いくつかのagent固有の指標が、これらの一般的な数字では見逃す問題を捕捉します。
| 指標 | 分かること |
|---|---|
| タスク成功率 | すべての実行のうち、クラッシュせずに終わっただけでなく、実際に目標に到達した割合 |
| 実行あたりのループ回数 | 平均が上昇している場合、多くは丁寧に作業しているのではなく、agentが苦戦していることを示す |
| ツール呼び出しのエラー率 | ツール呼び出しが失敗する、またはagentが誤って扱う結果が返ってくる頻度 |
| エスカレーション率 | 人に引き継がれる実行の割合と、その割合が上昇傾向か下降傾向か |
| 人によるオーバーライド率 | エスカレーションがなかった場合でも、agentの行ったことを人が覆したり修正したりする頻度 |
| 完了したタスクあたりのコスト | 実行あたりではなく、成功した成果あたりに費やしたトークンとツール呼び出しの合計 |
エスカレーション率とオーバーライド率は、通常以上に注目する価値があります。エスカレーション率の上昇は、必ずしも悪いわけではありません。agentがより難しいケースを正しく見分けているのかもしれません。しかし、オーバーライド率の上昇、つまり人が後からagentのしたことを静かに直している状態は、意思決定ロジックの何かがドリフトしていることを示す、ほぼ最も明確なシグナルです。誰もagentに間違いを伝えていません。ただ、その後始末をしているのです。
agentでしか表に出ない障害のモード
いくつかの障害パターンは、ループ型のシステムに固有のもので、単一の呼び出しを対象としたオブザーバビリティの構成ではまったく現れません。
**暴走ループ。**agentが、停止したり助けを求めたりするのではなく、失敗した同じアクションのバリエーションを試し続けます。実行ごとの反復回数がなければ、トークンの請求書が届くまで、ログ上は通常の活動に見えます。
**誤ったツール、確信は正しい。**agentが状況にもっともらしいツールを選び、正しく呼び出しますが、目標にとっては誤ったツールです。呼び出しは成功するため、何もエラーになりません。実際の成果と照らし合わせたトレースだけが、これを捕捉します。
**サイレントなツール障害。**ツール呼び出しは結果を返しますが、agentが必要としていた結果ではありません。空の検索結果、古いキャッシュのヒット、一部だけのレコードなどで、agentは必要なものが揃っているかのように先へ進みます。AIパターン別のハルシネーションリスクの考え方は、純粋な検索の文脈の外でも役に立ちます。取得したコンテキストが実際に十分かどうかを確認していないagentは、欠けた部分があるまま、自信をもって行動します。
**意思決定ロジックのドリフト。**ある種類の状況に対するagentの振る舞いが、ゆっくりと変わっていきます。ルールを編集したからではなく、基盤となるモデルのバージョンが変わった、ツールの出力形式が変わった、あるエッジケースが頻繁に現れるようになった、といった理由からです。これこそ評価(eval)が作られた目的です。目に見えて壊れたときだけでなく、スケジュールに沿って、完了した実行を固定のルーブリックに照らしてサンプリングします。
これらは、偶然ではなく、agentic AIプロジェクトが行き詰まる理由にも近いものです。Gartnerは、2027年末までにagentic AIプロジェクトの40%超が中止されると予測し、コストの増大、不明確なビジネス価値、不十分なリスク管理を主な理由に挙げています。この3つはいずれも、姿を変えたオブザーバビリティの問題です。タスクごとに追跡していないコストは管理できず、成功率に照らして測っていないビジネス価値は証明できず、見えないリスクは制御できません。
可視性の欠如は、数字にも表れています。自律型agentの保護に関するCloud Security Allianceの2026年の調査では、すべての環境にわたって、agentのアクションを人またはシステムまで確実にたどれると答えた組織は28%にとどまり、エンドツーエンドのセッショントレースを導入している組織はわずか45%でした。現在agentを運用しているチームの大半は、計器が一部しかない状態で飛んでいます。
現実的な最初のスタック
初日からフルのプラットフォームは必要ありません。妥当な構築の順序は次のとおりです。
- **まず、実行ごとの構造化ログ。**トリガー、トレースID、すべてのツール呼び出しとその結果、最終的な結果です。これだけでも、推測ではなく、特定の問題のある実行をデバッグできるようになります。
- **最も重要度の高いagentをサンプリングしてレビューする。**最も影響の大きいアクションを行うagentを1つ選びます。お金、顧客データ、外部とのコミュニケーションに関わるものです。そして、人が週に20から50件の実行を読みます。これは、指標が示すよりずっと早くドリフトを捕捉します。
- **実行が長くなったら、分散トレーシングを追加する。**agentが複数のツールを連鎖させる場合、開始時刻と終了時刻だけでなく、各ステップでのタイミングと結果のデータが必要です。
- 自動評価は最後に重ねる。「良い」とはどういうものかを調整できるだけの、人がレビューした実行が十分に集まってからです。人によるベースラインのない自動採点は、根拠のない自信に満ちた数字を出すだけです。
AIオブザーバビリティの概要で取り上げているような、一般的なAIオブザーバビリティに使われるのと同じ評価とトレーシングのツールが、agentにも使えます。違うのは、何に向けるかです。単一の応答ではなく、実行全体です。
この計測の仕組みを構築するエンジニアリングツールを検討している場合は、開発ツールの比較が、このようなトレーシングとモニタリングに対応するプラットフォームを取り上げています。また、DevOpsプラットフォームの選び方は、1つに決める前に確認しておく価値のあるCI/CDとモニタリングの観点を順に説明しています。
Key Facts
- agentのオブザーバビリティは、単一のモデルの出力だけでなく、実行全体にわたるループ(知覚、推論、実行、観察、繰り返し)をトレースします。
- すべてのツール呼び出し、そのパラメータ、結果、取った判断の分岐、その判断の理由を、実行ごとに1つのトレースIDのもとで記録します。
- タスク成功率、ループ回数、エスカレーション率、人によるオーバーライド率は、レイテンシやエラー率では見逃す問題を捕捉します。
- Cloud Security Allianceの2026年の調査によると、すべての環境にわたって、agentのアクションを人またはシステムまで確実にたどれる組織は28%にとどまります。
- Gartnerは、2027年までのagentic AIプロジェクトの中止の40%超を、コスト、不明確な価値、弱いリスク管理に起因するとしています。いずれも、オブザーバビリティが捕捉するために作られたものです。
AI Agentのオブザーバビリティに関するよくある質問
AI agentのオブザーバビリティとは何ですか。
AI agentに計測の仕組みを組み込み、実行全体で何が起きているかを見られるようにすることです。トリガー、取得したコンテキスト、すべてのツール呼び出しと結果、下した判断、そして最終的な結末までを把握します。単一のモデル呼び出しではなく、agentが実行する複数ステップのループまで、一般的なAIオブザーバビリティを拡張したものです。
agentのオブザーバビリティは、通常のAIオブザーバビリティとどう違いますか。
一般的なAIオブザーバビリティは、システムのログ、メトリクス、トレースを、通常は個々のモデル呼び出しを中心に見ます。agentのオブザーバビリティは、1回の実行を構成する判断とツール呼び出しの連鎖全体を、単一のトレースIDのもとで見ます。agentの障害は、どの単一のステップもエラーを出さなくても、その連鎖のどのステップにも潜みうるからです。
agentの実行ごとに何をログに残すべきですか。
最低限、トリガー、agentが取得したコンテキスト、選択した計画やアクション、パラメータと結果を含むすべてのツール呼び出し、メモリに書き込んだ内容、取った判断の分岐(実行、質問、引き継ぎのいずれか)、そして理由を添えた最終的な結果です。
AI agentにとって最も重要な指標は何ですか。
タスク成功率、実行あたりのループ回数、ツール呼び出しのエラー率、エスカレーション率、人によるオーバーライド率です。特にオーバーライド率、つまり人がagentのしたことを静かに修正する頻度は、意思決定ロジックのドリフトを示す最も明確な早期サインの1つです。
agentのオブザーバビリティには、専用のツールが必要ですか。
始めるのには必要ありません。一貫したトレースIDを使った構造化ログで、大半はカバーできます。専用のトレーシングと評価のプラットフォームは、本番で複数のagentが稼働し、大規模に実行を比較する必要が出てきたときに役立ちますが、それはアップグレードであり、前提条件ではありません。
次に読むもの
オブザーバビリティは、agentが実際に何をしているかを教えてくれます。それをAI agentのセキュリティと組み合わせると、もう半分の全体像が揃います。agentが何をしたかだけでなく、それをするよう騙されたのかどうかを知ることです。そもそもどの機能がagentに向いているかをまだ見極めている段階なら、AI agentを使うべきときが次に読むのに適しています。また、AI Risk Monitoring AgentとAI Security Monitoring Agentのブループリントも学ぶ価値があります。どちらも、この記事で説明している「監視して通知する」パターンを中心に、ほぼ全体が構築されているからです。
