AI agentはどう推論するのか:ReAct、プランニング、リフレクション
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI agentは、考えることと行動することを交互に繰り返して推論します。次に何をすべきかを短い「思考」として書き出し、行動(多くの場合ツール呼び出し)を取り、その結果を読み取り、次の一手の前に再び考えます。この交互に進めるパターンがReActと呼ばれ、ほとんどのagentの土台になっています。これを拡張する手法が2つあります。1つは、どのステップにも着手する前に複数のステップを描き出すプランニング、もう1つは、自分の試行を自ら批評し、最初の結果が不十分なら再挑戦するリフレクションです。
推論とは、ループの「推論」ステップを可視化したもの
AI agentの仕組みでは、agentのループを「知覚、推論、行動、観察、繰り返し」として説明しています。この記事では、その推論ステップの内側で何が起きているかを扱います。聞こえるほど不思議なものではありません。ここでいう「推論」とは、モデルが行動を確定する前に、自分の次の一手についての中間テキストを生成することです。しかも同じ会話の中で、読める形で生成されます。どこか別の場所で起きている隠れたプロセスではありません。たとえばサポートagentがチケットの扱いを決めるとき、ツールを呼び出す前に「このメッセージは決済の失敗と怒りのトーンに触れているので、返信を書く前に取引履歴を確認すべきだ」といった内容を生成することがあります。
このように中間の推論ステップを書き出す習慣は、chain-of-thoughtと呼ばれ、この記事のすべての土台になっています。chain-of-thoughtとはで、この手法そのものを取り上げています。ここで扱うのは、その推論が、実際の行動も伴うループにどう組み込まれるかです。これは、静的な質問を推論で解くこととは別の課題です。
ReAct:推論と行動を同じループで行う
ReActは「reasoning and acting(推論と行動)」の略で、Yaoらによる2022年の論文に由来します。この論文は、言語モデルが、最終回答まで推論してから行動する、あるいは推論なしで行動するよりも、短い推論ステップと行動を交互に挟んだほうが性能が高いことを示しました。パターンは単純で、思考(Thought)、行動(Action)、観察(Observation)をタスクが終わるまで繰り返します。思考は次に何を解き明かそうとしているかを説明し、行動は多くの場合ツール呼び出しで、観察は返ってきた結果です。
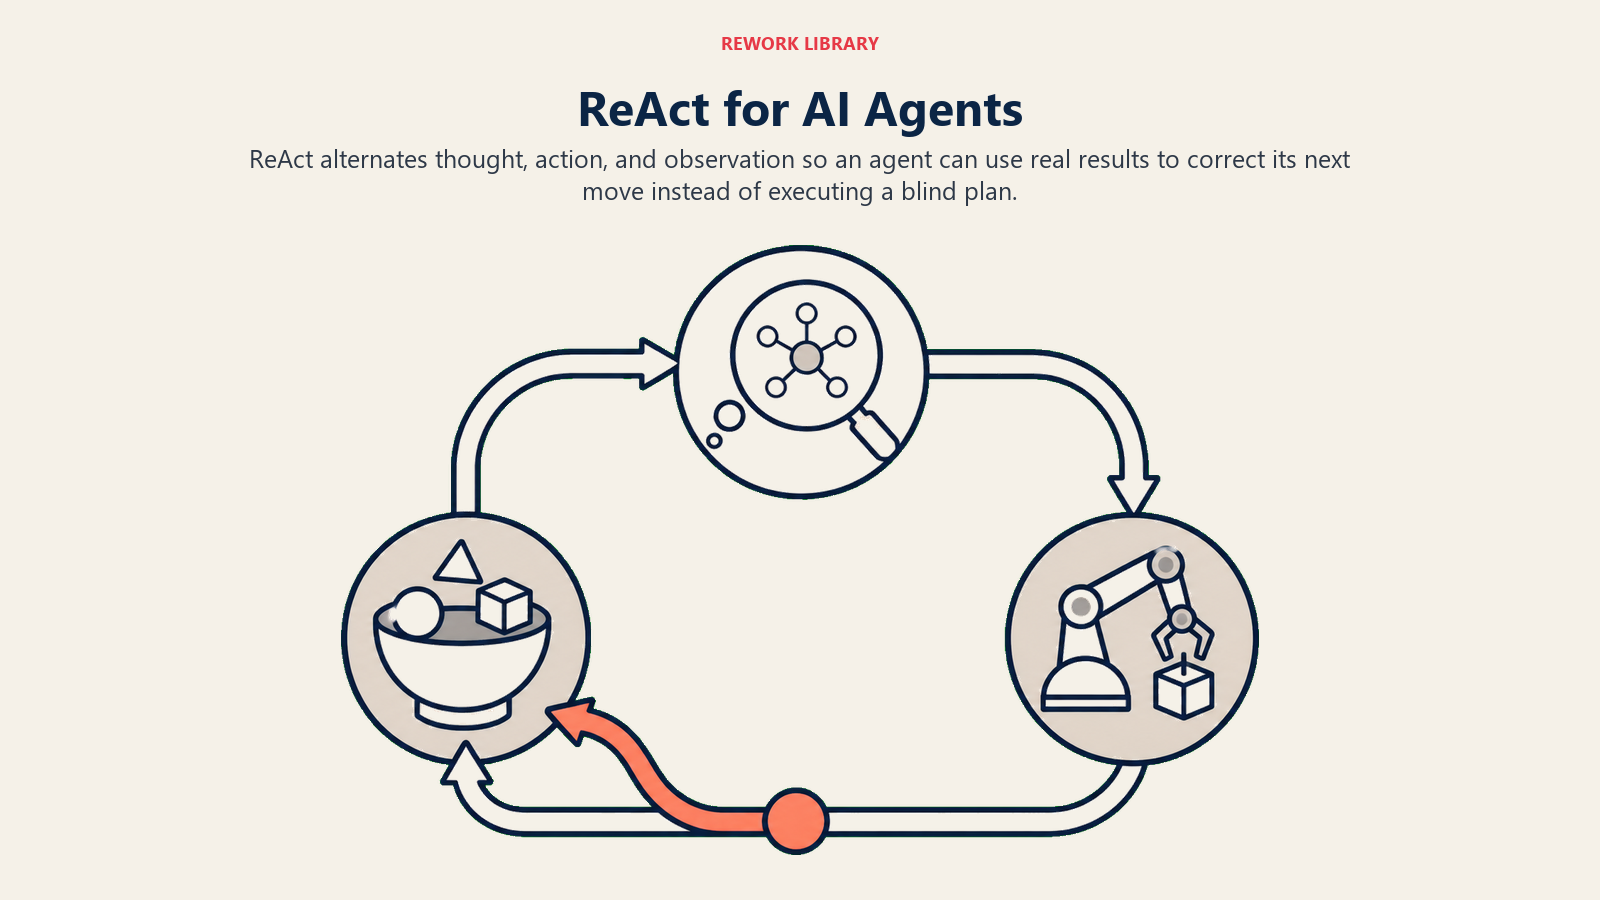
元の研究の成果は大きなものでした。インタラクティブな意思決定を試す2つのベンチマークであるALFWorldとWebShopで、ReActは模倣学習と強化学習のベースラインを、それぞれ34ポイント(71%対37%)と約11ポイント(40%対29.1%)上回りました。このパターンを示すために使った例は、わずか1〜2件です。最初にすべてを計画して盲目的に実行するよりも、交互に進めるほうがうまくいく理由は単純です。agentは、起こると想定したことではなく、実際に起きたことに基づいて軌道を修正できるからです。検索結果が役に立たなければ、次の思考でそのことを述べ、別のクエリを試せます。推測で作った計画のまま突き進むことはありません。
これは、Autonomous Agentパターンで説明しているループと同じ仕組みです。現在の状態を取り込み、分かっていることと不足していることを分析し、次の最善の行動を予測し、それを生成し、実行し、繰り返します。ReActは、そのサイクルの推論側を具体化したものです。
プランニング:数ステップ先を考える
純粋なReActは一歩ずつ即興で進めるため、直前の結果を見て初めて次の一手が明確になるタスクにはよく機能します。一方で、それ以上の構造があるほうが有利なタスクもあります。プランニングでは、agentは目標を、どれにも着手する前に、順序立てた一連のサブステップに分解します。1文ずつ書きながら考えるのではなく、下書きの前にアウトラインを書くのに近い進め方です。
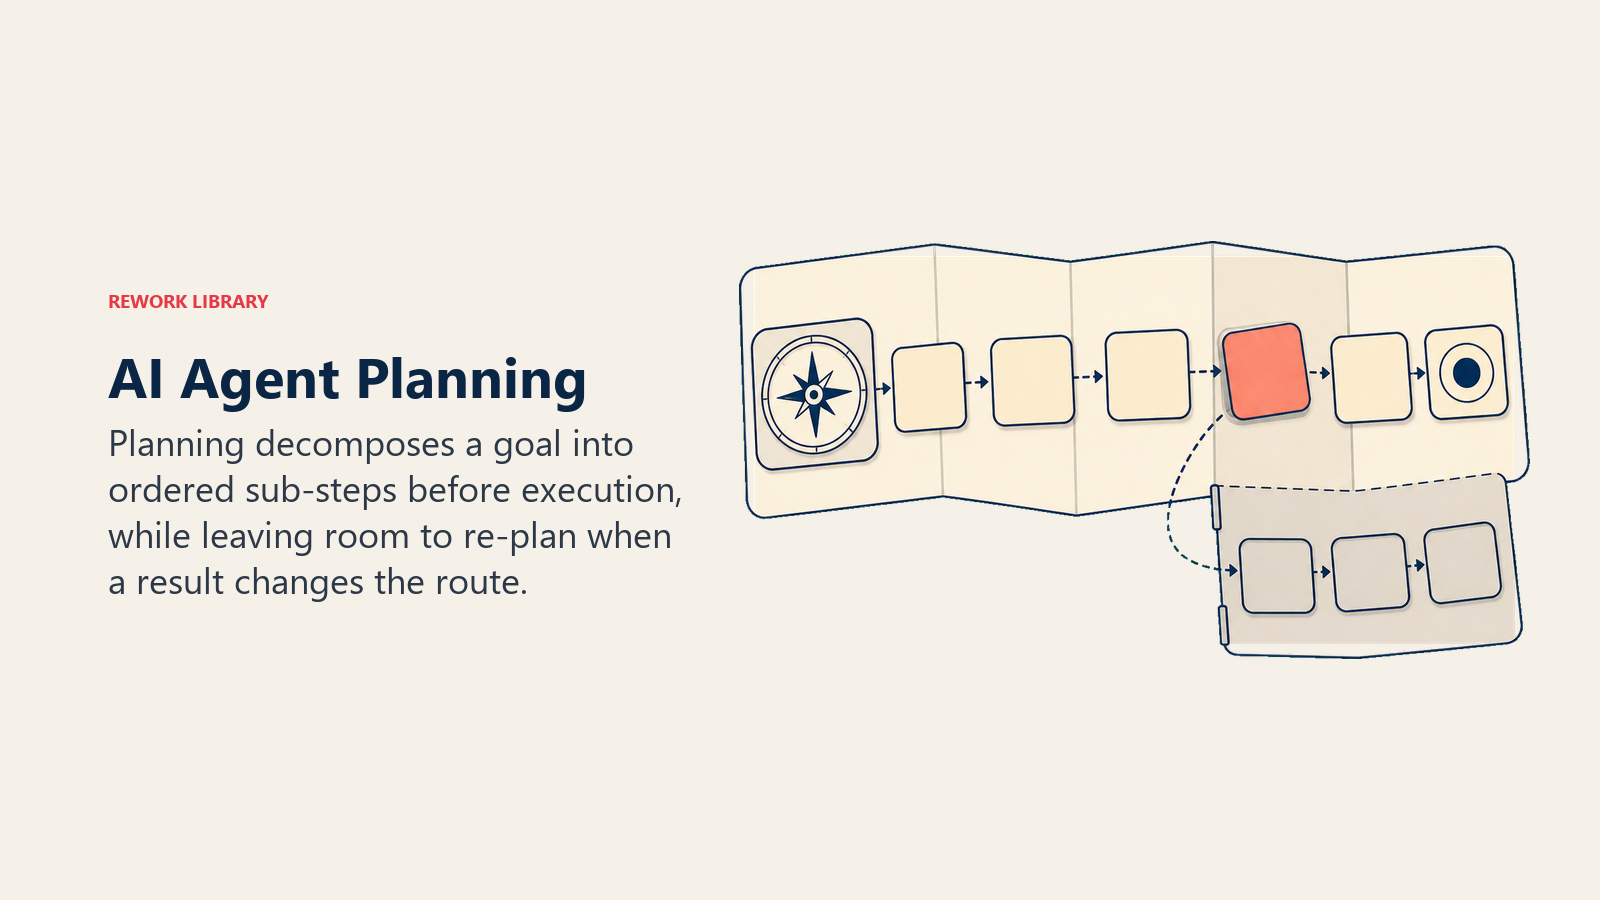
売上予測のタスクが良い例です。クエリを1つずつ即興で実行するのではなく、AI Forecasting Agentのブループリントに基づくagentは、最初にアプローチを計画することで効果を得られます。セグメント別の過去のクローズ率を取得し、現在のパイプラインカバレッジを確認し、オープン案件をステージで重み付けし、それらを組み合わせてレンジを出す、という流れです。これらの各サブステップは、内部でそれぞれReActループを回すことがありますが、全体の形は、ステップごとに見つけていくのではなく、最初に決められています。
プランニングは一度きりの約束ではありません。ステップが失敗したり、新しい情報で状況が変わったりしたとき、よくできたagentは、元の計画を無理に通そうとせず、再計画します。知っておく価値のある拡張として、tree-of-thought推論があります。agentが複数の候補プランを探索し、比較してから確定する方法で、妥当なアプローチが本当に複数ある場合に役立ちます。推論モデルとはでは、この領域に加えて、回答する前により多くの計算を熟考に費やすモデルへのより広い流れを、さらに詳しく取り上げています。
リフレクション:自分のミスに気づく
リフレクションは、別の能力を加えます。試行の結果を出した後、agentが自分のアウトプットを目標に照らして評価し、不十分なら修正します。最初の下書きを最終版として扱いません。
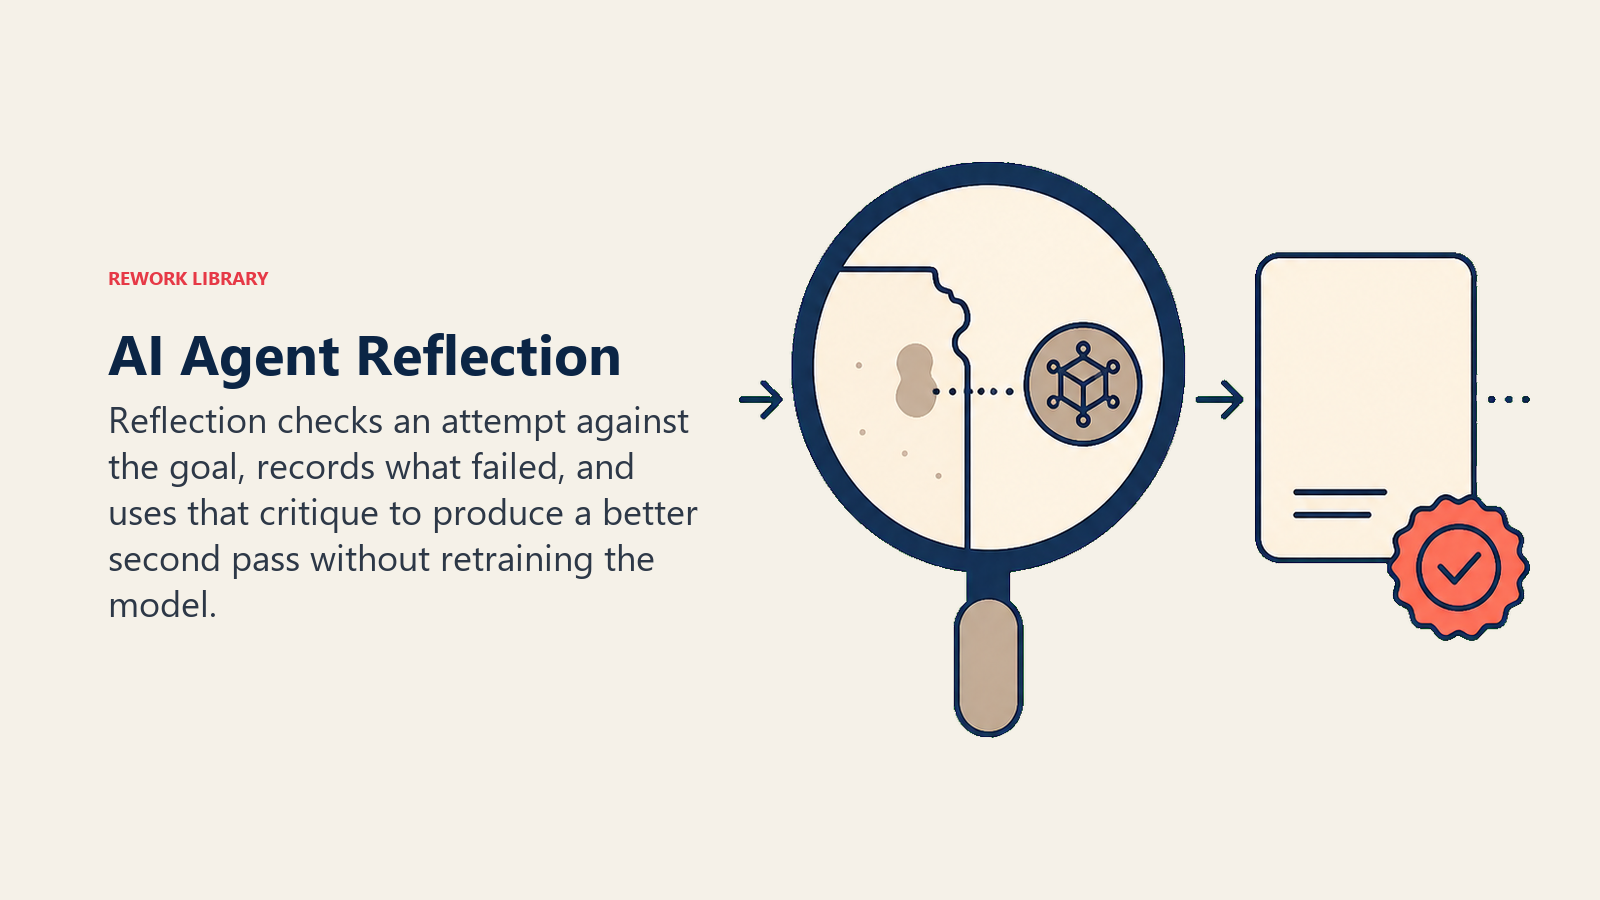
この背景にある研究、ShinnらによるReflexionの2023年の論文は、実際の数字を知っておく価値があります。このアプローチは、コーディングのベンチマークHumanEvalでpass@1の精度91%に到達しました。当時の標準的なGPT-4のベースラインは80%です。使ったのは、試行の合間にメモリへ保存した、言葉による自己批評のループだけです。再学習も、新しいモデルの重みもありません。agentが自分の失敗した試行を読み、何がまずかったかを平易な言葉で書き留め、そのメモをコンテキストに置いて再挑戦するだけです。この保存された自己批評は、AI agentの仕組みで取り上げているワーキングメモリの一形態です。agentがこうした情報をステップや実行をまたいでどう保持するかの全体像を知りたい場合は、AIメモリがより詳しいリファレンスになります。
ビジネスの文脈では、Content Drafting Agentのブループリントが、関連する考え方を使っています。下書きを作り、ブランドガイドラインや必須要素に照らして確認し、修正してから、人間による最終レビューに回します。この自己チェックは人間のレビューの代わりにはなりません。避けられたはずの明白な問題を抱えたまま届く下書きの数を減らします。
まとめ:推論トレースの実例
ここでは、3つの手法を1つの実際のタスクで組み合わせるとどうなるかを見ます。AI Research Agentのブループリントが、営業の通話に先立って、対象企業のブリーフィングを作成するよう求められます。
- プラン。 agentは目標をサブタスクに分解します。最近の資金調達の動き、経営陣の変更、直近の四半期のニュースです。
- ReActループ、サブタスク1。 思考:「最近の資金調達のニュースが必要だ」。行動:検索。観察:3件の結果があり、うち1件は信頼できる情報源から。思考:「これは最新で関連性が高そうなので、読んでみよう」。行動:ページを取得。観察:資金調達ラウンドが日付と金額とともに確認できた。
- ReActループ、サブタスク2と3。 経営陣の変更と最近のニュースについても、同じ思考、行動、観察のサイクルを繰り返します。各ループは、agentが十分なシグナルを得たと判断した時点で止まります。
- リフレクト。 確定する前に、agentは自分の下書きを元の目標に照らして確認します。3つのサブタスクをすべて網羅しているか、古い情報や未確認の情報がないか、根拠となる情報源が欠けている主張がないかを見ます。抜けが見つかれば、穴の空いたままブリーフィングを出すのではなく、もう1回、的を絞った検索を行います。
3つの手法で、1つの一貫したアウトプットが得られ、しかも人間が読み返して理解できるトレースが各ステップに残ります。これは、最終的な答えと同じくらい重要です。
推論の深さは、コストと信頼のトレードオフ
これらはどれも無料ではありません。agentが書き出す思考のすべてがトークンであり、ReActのサイクルやリフレクションのパスが増えるたびに、そのうえでレイテンシが加わります。単純な検索に、複数ステップのプランニングや自己批評のパスは要りません。必要なのは、速く直接的な答えです。熟考を重ねた推論が追加のコストに見合うのはどんなときで、標準的な高速の応答のほうが適切なのはどんなときか、というより広い問いについては、推論モデルとはで取り上げています。この区別は、モデルを選ぶときと同じように、agent内部の推論の深さにも当てはまります。
トレードオフのもう一方は、コストだけでなく信頼です。モデルは、正しい行動に至るときと同じくらい流暢に、自信をもって、誤った行動にも推論でたどり着くことがあります。AnthropicのBuilding Effective Agentsのガイダンスは、本番環境での導入から導き出されたもので、最大限の自律性を最初から求めるのではなく、タスクが許す限りagenticなループをシンプルに保つことを推奨しています。推論ステップが増えるほど、誤りが気づかれずに入り込む場所も増えるからです。だからこそ、最終的な行動だけでなく、すべての推論トレースをログに残し、確認できるようにしておくべきです。AI agentのオブザーバビリティで、そのログ記録とモニタリングの層に何が必要かを取り上げています。
Key Facts
- agentにおける推論とは、モデルが行動する前に、次の一手についての可視化された中間テキストを生成することを指し、最も一般的にはchain-of-thought型のプロセスを通じて行われます。
- ReActは、推論と行動を同じループで交互に行います。元の研究では、これが模倣学習と強化学習のベースラインを、ALFWorldで34ポイント、WebShopで約11ポイント上回りました。
- プランニングは、実行する前に目標を順序立てたサブステップに分解します。よくできたagentは、ステップが失敗したり新しい情報で状況が変わったりしたとき、再計画します。
- リフレクションは、agentに自分の試行を批評させ、修正させます。Reflexionの研究では、再学習なしで、言葉による自己批評のループを使い、HumanEvalのpass@1で、80%のベースラインに対して91%に到達しました。
- 深い推論は、トークン、時間、費用のコストが増え、自信をもって誤った行動をとるリスクを減らすものでもありません。そのため、推論トレースは、ただ信頼するのではなく、ログに残して確認できるようにする必要があります。
AI agentの推論に関するよくある質問
AI agentにおけるReActとは何ですか。
ReActは、reasoning and acting(推論と行動)の略です。AI agentが、短い推論ステップ(思考)と実際の行動(通常はツール呼び出し)を交互に挟み、次の思考の前にその結果(観察)を読み取るパターンです。最終回答まで推論してから行動する、あるいは推論なしで行動するのとは異なります。
AI agentにおけるプランニングとリフレクションの違いは何ですか。
プランニングは実行の前に行われます。agentは、目標を順序立てた一連のサブステップに最初に分解します。リフレクションは試行の後に行われます。agentが自分のアウトプットを目標に照らして評価し、不十分なら修正します。多くの本番環境のagentは両方を使い、計画した各サブタスクの中でReAct型のステップごとの推論も併用しています。
推論ステップを増やすと、AI agentはより正確になりますか。
多くの場合はそうですが、自動的にではなく、無料でもありません。ReActとリフレクションに基づく手法の両方の研究が、複数ステップのタスクで実際の精度向上を示しています。ただし、推論ステップを追加するたびにトークンと時間がかかり、長い推論トレースでも、自信をもって誤った結論に至ることがあります。だからこそ、トレースは長いからといって信頼するのではなく、ログに残して確認する必要があります。
AI agentは自分のミスを修正できますか。
限度はありますが、できます。リフレクションにより、agentは、テストの失敗や不完全な下書きといった特定の種類のミスを、自分のアウトプットを批評して再挑戦することで見つけて修正できます。利用できる情報から検出できないミスには気づけません。そのため、重大な判断では、依然として人間のレビューが重要です。
agentの推論は、OpenAIのo1のような推論モデルとどう関係しますか。
関連はありますが、別のものです。推論モデルは、個々の質問に応答する前に、追加の計算を熟考に費やすよう学習されています。ReAct、プランニング、リフレクションといったagentの推論手法は、その熟考を、実際の行動も伴う複数ステップのタスク全体にわたって構造化するためのパターンです。agentは標準モデルでも推論モデルでも構築でき、どちらを選ぶかは、タスクの推論要求の複雑さによって決まります。
chain-of-thoughtはagentの推論と同じものですか。
chain-of-thoughtは基礎となる手法で、モデルがいきなり答えに飛びつかず、中間の推論ステップを書き出すようにするものです。agentの推論は同じ習慣を土台にしながら、行動を取り、実際の結果を読み戻すループに組み込みます。これは、1つの静的な質問を推論で解くこととは異なる、より複雑な課題です。
次に読むもの
推論は、agentが次に何をするかを決めます。その決定が行動に変わったあとに何が起きるかは、AI agentはツールをどう使うのかで取り上げています。仕事が複数のagentに分割されたとき、単一のagentの推論ループがどう変わるかについては、マルチエージェントシステムをご覧ください。自分のagentに取り入れる準備ができたら、AI agentの作り方で構築プロセスを最初から最後まで確認できます。推論を多用するコーディングagentのようなツールを評価している場合は、生産性ツールの一覧と、AIコーディングアシスタントの選び方のガイドも次の参考になります。
