Cómo evaluar y probar AI agents
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
La evaluación de AI agents es la práctica de probar de forma sistemática si un agent completa tareas reales de manera correcta, segura y consistente, antes de que llegue a un cliente y de forma continua después. Combina un conjunto de prueba con tareas realistas, una métrica de éxito de tareas en lugar de una verificación de respuesta única y correcta, y un método de calificación (reglas, revisión humana o un segundo modelo que actúa como juez) que detecta las fallas antes de que se acumulen en producción. Si se salta este paso, no está operando un agent: está llevando a cabo un experimento sin control sobre su negocio.
Si aún no ha definido con precisión qué es realmente un AI agent y la idea de autonomía acotada que lo sustenta, empiece por ahí. Esta página da por hecho que ya superó ese paso y se pregunta si su agent es lo bastante fiable como para confiarle un volumen real.
Por qué probar un agent no es como probar software
El QA tradicional de software contrasta una entrada fija con una salida esperada fija. Se hace clic en este botón y se espera esa pantalla. Un AI agent rompe ese modelo de tres maneras: la misma entrada puede producir varias salidas válidas, una sola tarea puede tomar cinco o quince pasos según lo que el agent encuentre en el camino, y la naturaleza probabilística del propio modelo implica que no siempre hará exactamente lo mismo dos veces.
| Prueba de software tradicional | Prueba de AI agent | |
|---|---|---|
| De la entrada a la salida | Una única salida correcta | Son posibles varias salidas válidas |
| Ruta | Secuencia fija de pasos | La ruta varía según el caso, las herramientas usadas y el orden |
| Repetibilidad | Misma entrada, mismo resultado siempre | La misma entrada puede producir rutas distintas, igualmente válidas |
| Aprobado o reprobado | Binario | A menudo una puntuación graduada frente a una rúbrica |
| Qué lo rompe | Un cambio de código | Un cambio de prompt, una actualización del modelo, la deriva de los datos, un cambio en la API de una herramienta |
Eso no es un motivo para omitir las pruebas. Es un motivo para probar de otra manera. Y el costo de omitirlas es real: Gartner predice que más del 40% de los proyectos de agentic AI serán cancelados para fines de 2027, y cita como causas principales el aumento de los costos, un valor de negocio poco claro y controles de riesgo inadecuados, no el fracaso de la tecnología. Una práctica rigurosa de evaluación es lo que convierte "creemos que este agent funciona" en una cifra que puede defender ante quien controla el presupuesto.
La métrica central: éxito de la tarea, no precisión
Lo más importante que debe definir antes de escribir un caso de prueba es qué significa "éxito" para este agent en particular, en términos del resultado que produce y no de las palabras que genera por el camino.
Para un AI Lead Scoring Agent, el éxito no es si cada puntuación individual coincide con lo que habría estimado una persona. Es si los leads que califica como "calientes" convierten a una tasa significativamente más alta que los que califica como "fríos" durante las semanas siguientes. Para un AI Support Triage Agent, el éxito es si el ticket llega a la cola correcta con el contexto adecuado adjunto, no si la redacción de su clasificación coincide exactamente con la formulación de una persona.
Divida sus métricas en dos tipos:
- Las métricas de resultado miden si realmente se alcanzó el objetivo: reunión agendada, ticket resuelto, campos de factura extraídos correctamente, transacción señalada con precisión.
- Las métricas de proceso miden cómo llegó el agent hasta allí: qué herramientas llamó, cuántos pasos dio, cuánto costó en tokens y llamadas a la API, y cuánto tardó.
Necesita ambas. Un agent que alcanza su métrica de resultado dando veinte pasos innecesarios y gastando diez veces el costo esperado por tarea no es en realidad un éxito. Es un problema con un buen tablero de resultados.
Construya un conjunto de prueba antes de lanzar
No se puede evaluar lo que no se ha definido. Antes de que un agent entre en producción, reúna un conjunto de tareas realistas que realmente enfrentará, tomadas de tres fuentes:
- Casos reales históricos. Tickets, leads o transacciones pasados, anonimizados si es necesario. Son lo más cercano a la verdad de referencia que tiene, porque ya ocurrieron y usted sabe, o puede determinar, cuál era el resultado correcto.
- Casos límite sintéticos. Situaciones que sabe que ocurrirán tarde o temprano, pero de las que quizá aún no tenga suficientes ejemplos históricos: un cliente que pregunta por un producto recién lanzado, un lead fuera de su ICP habitual, una transacción justo por debajo de su umbral de fraude.
- Casos adversariales. Entradas diseñadas para romper al agent a propósito: un mensaje que intenta convencerlo de ignorar sus reglas, una pregunta sin una buena respuesta en su knowledge base, una solicitud claramente fuera de su alcance.
Un punto de partida práctico es un caso de prueba por cada fila del manual de escenarios del agent, parte de los seis componentes básicos que define cada plan de Rework, más un puñado de casos adversariales encima. Normalmente son unas pocas docenas de casos para empezar, no cientos. El hábito que importa más que el tamaño es volver a añadir al conjunto cada falla real de producción una vez corregida, para que el mismo error nunca se publique dos veces.
Evaluación offline vs. evaluación online
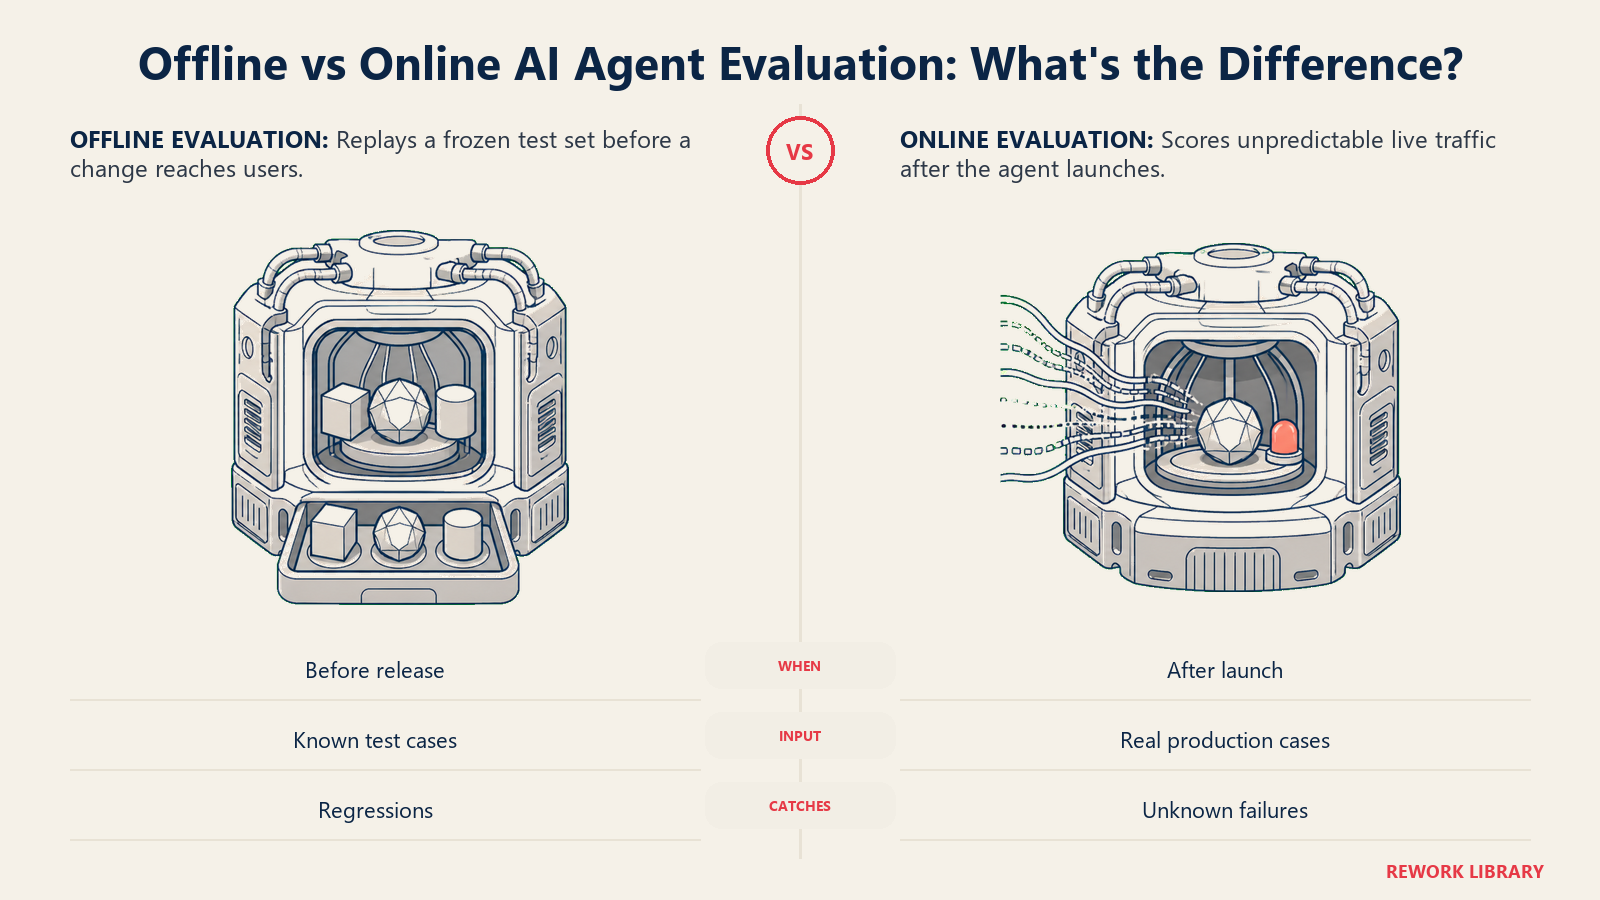
Ejecute ambas y entienda para qué sirve realmente cada una.
| Evaluación offline | Evaluación online | |
|---|---|---|
| Cuándo se ejecuta | Antes de publicar un cambio | Después de que el agent está en producción |
| Contra qué se prueba | Un conjunto de prueba fijo y conocido | Tráfico real e impredecible de producción |
| Costo de ejecución | Barata y repetible, segura con cada cambio | Requiere infraestructura de monitoreo y uso real |
| Qué detecta | Regresiones: si este cambio rompió algo que antes funcionaba | Incógnitas: casos para los que nunca pensó en escribir una prueba |
| Cadencia típica | En cada cambio de prompt, modelo o herramienta | De forma continua |
La evaluación offline es su cinturón de seguridad. Cada vez que toque un prompt, cambie un modelo o añada una herramienta, vuelva a ejecutar el conjunto de prueba completo antes de desplegar. Si la tasa de éxito de las tareas cae en casos que antes pasaban, detectó una regresión antes que un cliente.
La evaluación online es donde el mundo real responde. Un patrón habitual es el modo sombra (shadow mode): ejecutar la nueva versión del agent junto a la versión que ya está en producción, sobre las mismas entradas en vivo, sin dejar que la nueva versión actúe de verdad. Compare los dos conjuntos de salidas antes de pasar el tráfico a la nueva versión. Aquí también toma el relevo el monitoreo continuo de producción, es decir, los logs, las trazas, las métricas y las evaluaciones automatizadas que vigilan a un agent de forma permanente tras el lanzamiento. Esa disciplina tiene su propia profundidad: consulte AI Agent Observability para ver cómo instrumentar un agent de modo que los problemas aparezcan en minutos y no en semanas.
Cómo calificar lo que produjo el agent
Una vez que tiene un conjunto de prueba, necesita una forma de puntuar cada resultado. Hay tres enfoques, que suelen usarse en conjunto más que por separado:
Verificaciones basadas en reglas. Rápidas y baratas: si el agent llamó a la herramienta correcta, si la salida coincidía con un formato esperado, si incluyó una cita obligatoria. Las reglas solo sirven para el comportamiento que se puede verificar de forma mecánica, así que cubren menos de lo que la gente espera. La guía de OpenAI para construir agents lo plantea como una defensa en capas, ya que ninguna verificación aislada lo detecta todo.
Revisión humana. El juez más fiable del tono, de las decisiones de criterio y de todo lo subjetivo, y también el más lento y costoso. Nadie revisa cada conversación a mano. Tome una muestra: de 20 a 50 transcripciones por semana para un agent en producción bastan para detectar la deriva sin convertirlo en el trabajo completo de alguien.
LLM-as-judge. Use un segundo modelo para calificar la salida del agent frente a una rúbrica escrita. Escala a miles de casos en el tiempo que la revisión humana cubre decenas, y por eso se ha vuelto el patrón estándar para evaluar agents con un volumen real. La salvedad: un LLM juez solo es confiable una vez calibrado. Puntúe periódicamente la misma muestra con una persona y con el modelo juez, y si discrepan a menudo, corrija la rúbrica, no el modelo. Para comparaciones lado a lado, como una mejora de prompt, pedirle al juez que elija la mejor de dos salidas suele funcionar mejor que pedirle una puntuación absoluta.
Evalúe los pasos, no solo la respuesta final
Una respuesta final puede parecer correcta por la razón equivocada. Un agent puede llegar a la categoría correcta de ticket después de revisar el artículo equivocado de la knowledge base, o reservar el horario correcto después de ignorar un conflicto de agenda que debió detectar. Eso es un error con calificación aprobatoria, y reaparecerá la próxima vez que el camino afortunado no esté disponible.
La revisión a nivel de traza consiste en recorrer la secuencia real del agent: qué herramienta llamó, con qué parámetros, en qué orden y si manejó un resultado erróneo o vacío antes de continuar. Esto importa más a medida que los agents asumen tareas más largas y autónomas. METR evalúa modelos de AI de frontera en trabajo realista y encontró que la duración de la tarea que un agent puede completar de forma fiable, su "time horizon", se ha duplicado aproximadamente cada siete meses durante seis años seguidos. Los modelos actuales son casi perfectos en tareas que a un experto humano le toman unos minutos, pero tienen éxito menos del 10% de las veces en tareas que toman cerca de cuatro horas. Esa brecha es donde la evaluación a nivel de trayectoria se justifica: una única verificación de la respuesta final no puede mostrarle en qué punto de una larga cadena de pasos las cosas empezaron a desviarse.
Dos ejemplos de por qué la traza importa más que la cifra principal:
- Un AI Support Triage Agent necesita que se revise toda su decisión de enrutamiento, no solo la etiqueta final del ticket. ¿Conservó además la solicitud original del cliente, o el cambio de cola borró un contexto que el agente humano ahora tiene que volver a pedir?
- Un AI Fraud Detection Agent necesita que la precisión (precision) y la exhaustividad (recall) se midan como dos números separados, nunca combinados en uno. Un falso positivo bloquea la cuenta de un cliente legítimo. Un falso negativo deja pasar un fraude real, y esas dos fallas le cuestan al negocio de maneras completamente distintas.
Algunos equipos incorporan esta revisión de trazas directamente en el producto. Un AI Chatbot QA Agent es la evaluación empaquetada como su propio agent: lee conversaciones reales del bot, puntúa cada una en precisión, tono y resolución, y señala las alucinaciones o los bucles sin salida para que una persona los corrija, la misma disciplina que describe este artículo, ejecutándose de forma continua en lugar de una única pasada previa al lanzamiento.
Qué monitorear después del lanzamiento
Una vez que un agent está en producción, una lista corta de cifras le dice si sigue cumpliendo su función:
- Tasa de éxito de las tareas a lo largo del tiempo. Una tendencia a la baja significa que algo se desvió: una actualización del modelo, una fuente de datos obsoleta o un cambio en el tipo de casos que llegan.
- Tasa de escalada y de transferencia. Demasiado baja puede significar que el agent se está excediendo de sus límites. Demasiado alta puede significar que sus reglas son demasiado conservadoras para ser útiles.
- Tasa de anulación humana. ¿Con qué frecuencia una persona revierte o corrige lo que decidió el agent? Una tasa de anulación en aumento es una alerta temprana mucho antes de que el éxito de las tareas caiga de forma visible.
- Costo por tarea completada. Un cambio de modelo o de prompt que duplica en silencio el uso de tokens sin mejorar los resultados es un problema de presupuesto escondido donde nadie mira.
- Tasa de regresión. ¿Qué fracción de las nuevas fallas son repeticiones de errores ya corregidos una vez? Debería tender a cero a medida que madura su conjunto de prueba.
Si está comparando plataformas para construir agents y quiere que este tipo de herramientas de trazado y evaluación vengan incorporadas en lugar de armarse a mano, la guía de compra de plataformas de AI chatbot explica qué buscar, y el resumen de herramientas de automatización es un punto de partida razonable para explorar lo disponible en 2026.
Datos clave
- La evaluación de AI agents combina un conjunto de prueba realista, una métrica de éxito de tareas y un método de calificación (reglas, revisión humana o LLM-as-judge), ejecutados tanto offline antes de cada cambio como online de forma continua tras el lanzamiento.
- Gartner predice que más del 40% de los proyectos de agentic AI serán cancelados para fines de 2027, impulsados por un valor de negocio poco claro y controles de riesgo inadecuados, justo lo que una práctica de evaluación real está pensada para detectar a tiempo.
- La investigación de METR muestra que la duración de tarea fiable de los AI agents se ha duplicado aproximadamente cada siete meses, y por eso la evaluación paso a paso a nivel de traza importa más a medida que los agents asumen trabajo más largo y autónomo.
- Confíe en un LLM-as-judge solo después de calibrarlo frente a calificaciones humanas sobre la misma muestra de casos.
Preguntas frecuentes sobre cómo evaluar y probar AI agents
¿Qué es la evaluación de AI agents?
La evaluación de AI agents es la práctica de probar si un AI agent completa tareas reales de forma correcta, segura y consistente. Usa un conjunto de prueba de casos realistas, una métrica de éxito de tareas que mide el resultado y no una única respuesta correcta, y un método de calificación como reglas, revisión humana o un segundo modelo que actúa como juez, ejecutados tanto antes del lanzamiento como de forma continua después.
¿Cuál es la diferencia entre evaluación offline y online?
La evaluación offline ejecuta un conjunto de prueba fijo contra cada cambio antes de publicarlo, y detecta regresiones de forma barata y repetible. La evaluación online observa el tráfico real de producción tras el lanzamiento y detecta los casos impredecibles para los que no pensó en escribir una prueba. Un programa maduro de agents ejecuta ambas, no una u otra.
¿Puede un LLM calificar de verdad el trabajo de otro AI agent?
Sí, y es la forma estándar de evaluar agents con un volumen real, ya que la revisión humana por sí sola no escala más allá de unas pocas docenas de casos por semana. La salvedad es la calibración: compare periódicamente las puntuaciones del LLM juez con las calificaciones humanas sobre la misma muestra, y corrija la rúbrica si discrepan a menudo, antes de confiar en las puntuaciones del juez a escala.
¿Cuántos casos de prueba necesito antes de lanzar un agent?
Empiece con un caso de prueba por cada fila del manual de escenarios del agent, más un puñado de casos límite y entradas adversariales, normalmente unas pocas docenas de casos y no cientos. Haga crecer el conjunto con el tiempo añadiendo cada falla real de producción una vez corregida, para que el mismo error no pueda publicarse dos veces.
¿Cuál es la métrica más importante que debo monitorear?
La tasa de éxito de las tareas, medida frente al resultado de negocio real que el agent existe para producir, no la precisión en un paso individual. Combínela con una métrica de proceso como el costo por tarea completada, porque un agent que alcanza el resultado correcto por un camino costoso o indirecto igualmente tiene un problema real.
A dónde ir a continuación
Una práctica sólida de evaluación es lo que separa a un agent al que se le puede confiar un volumen real de una demo que solo funciona en los casos que se probaron por casualidad. Una vez que tenga listos su conjunto de prueba y su método de calificación, el siguiente paso natural es cómo construir un AI agent si aún no ha publicado una primera versión, o ver cómo el agent fundamenta sus respuestas en datos reales con RAG para AI agents y cómo mantiene el contexto a lo largo de una tarea larga con AI Agent Memory, ya que ambos afectan directamente lo que su evaluación detectará.

On this page
- Por qué probar un agent no es como probar software
- La métrica central: éxito de la tarea, no precisión
- Construya un conjunto de prueba antes de lanzar
- Evaluación offline vs. evaluación online
- Cómo calificar lo que produjo el agent
- Evalúe los pasos, no solo la respuesta final
- Qué monitorear después del lanzamiento
- Datos clave
- A dónde ir a continuación