Cara Menilai dan Menguji AI Agent
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Penilaian AI agent ialah amalan menguji secara sistematik sama ada agent menyelesaikan tugas sebenar dengan betul, selamat, dan konsisten, sebelum ia sampai kepada pelanggan dan secara berterusan selepas itu. Ia menggabungkan set ujian berisi tugas yang realistik, metrik kejayaan tugas dan bukan semakan satu jawapan betul, serta kaedah penggredan (peraturan, semakan manusia, atau model kedua yang bertindak sebagai hakim) yang menangkap kegagalan sebelum ia bertimbun dalam pengeluaran. Langkau langkah ini dan anda bukan menjalankan agent, anda menjalankan eksperimen tanpa kawalan ke atas perniagaan anda.
Jika anda belum memahami apa sebenarnya AI agent dan idea autonomi terhad di sebaliknya, mulakan di sana dahulu. Halaman ini menganggap anda sudah melepasi langkah itu dan sudah bertanya sama ada agent anda cukup boleh dipercayai untuk volum sebenar.
Mengapa Menguji Agent Tidak Sama dengan Menguji Perisian
QA perisian tradisional menyemak input tetap terhadap output jangkaan yang tetap. Klik butang ini, jangka skrin itu. AI agent memecahkan model itu dalam tiga cara: input yang sama boleh menghasilkan beberapa output yang sah, satu tugas mungkin mengambil lima atau lima belas langkah bergantung pada apa yang ditemui agent di sepanjang jalan, dan sifat kebarangkalian model itu sendiri bermakna ia tidak akan sentiasa melakukan perkara yang sama dua kali.
| Ujian perisian tradisional | Ujian AI agent | |
|---|---|---|
| Input kepada output | Satu output yang betul | Beberapa output sah mungkin |
| Laluan | Jujukan langkah tetap | Laluan berbeza mengikut kes, alat yang digunakan, dan susunan |
| Kebolehulangan | Input sama, hasil sama setiap kali | Input sama boleh menghasilkan laluan berbeza yang masih sah |
| Lulus atau gagal | Binari | Selalunya skor bergred berbanding rubrik |
| Apa yang merosakkannya | Perubahan kod | Perubahan prompt, kemas kini model, hanyutan data, API alat berubah |
Itu bukan sebab untuk melangkau pengujian. Ia sebab untuk menguji dengan cara berbeza. Dan kos melangkaunya adalah nyata: Gartner meramalkan bahawa lebih 40% projek AI agentic akan dibatalkan menjelang akhir 2027, dengan kos yang meningkat, nilai perniagaan yang tidak jelas, dan kawalan risiko yang tidak memadai sebagai punca utama, bukan teknologi yang gagal. Amalan penilaian yang ketat ialah apa yang menukarkan "kami rasa agent ini berfungsi" kepada angka yang boleh anda pertahankan di hadapan pemilik bajet.
Metrik Teras: Kejayaan Tugas, Bukan Ketepatan
Perkara paling penting yang perlu ditakrifkan sebelum anda menulis kes ujian ialah apa maksud "kejayaan" bagi agent khusus ini, dari segi hasil yang dihasilkannya, bukan perkataan yang dijananya di sepanjang jalan.
Bagi AI Lead Scoring Agent, kejayaan bukan sama ada setiap skor individu sepadan dengan tekaan manusia. Ia sama ada lead yang diskornya "panas" bertukar pada kadar yang jauh lebih tinggi daripada lead yang diskornya "sejuk" dalam minggu-minggu berikutnya. Bagi AI Support Triage Agent, kejayaan ialah sama ada tiket mendarat dalam baris gilir yang betul dengan konteks yang betul dilampirkan, bukan sama ada perkataan pengelasannya sepadan tepat dengan ungkapan manusia.
Pisahkan metrik anda kepada dua jenis:
- Metrik hasil mengukur sama ada matlamat benar-benar dicapai: mesyuarat yang ditempah, tiket yang diselesaikan, medan invois yang diekstrak dengan betul, transaksi yang ditandakan dengan tepat.
- Metrik proses mengukur cara agent sampai ke situ: alat mana yang dipanggilnya, berapa banyak langkah yang diambil, berapa kosnya dalam token dan panggilan API, dan berapa lama masa diambil.
Anda memerlukan kedua-duanya. Agent yang mencapai metrik hasilnya dengan mengambil dua puluh langkah yang tidak perlu dan membakar kos sepuluh kali ganda jangkaan bagi setiap tugas sebenarnya bukan satu kejayaan. Ia masalah yang memakai kad skor yang baik.
Bina Set Ujian Sebelum Anda Lancarkan
Anda tidak boleh menilai apa yang belum anda takrifkan. Sebelum agent beroperasi, himpunkan set tugas realistik yang sebenarnya akan dihadapinya, diambil daripada tiga sumber:
- Kes sebenar sejarah. Tiket, lead, atau transaksi lalu, dianonimkan jika perlu. Ini perkara paling hampir dengan kebenaran asas yang anda ada, kerana ia sudah berlaku dan anda tahu, atau boleh menentukan, apakah hasil yang betul.
- Kes pinggir sintetik. Situasi yang anda tahu akan berlaku akhirnya tetapi mungkin belum mempunyai cukup contoh sejarah: pelanggan bertanya tentang produk yang baru anda lancarkan, lead di luar ICP biasa anda, transaksi yang sedikit di bawah ambang penipuan anda.
- Kes musuh. Input yang direka untuk memecahkan agent dengan sengaja: mesej yang cuba memujuknya mengabaikan peraturannya, soalan tanpa jawapan yang baik dalam knowledge base-nya, permintaan yang jelas di luar skopnya.
Titik permulaan yang praktikal ialah satu kes ujian bagi setiap baris dalam panduan senario agent, sebahagian daripada enam blok binaan yang ditakrifkan oleh setiap pelan Rework, ditambah beberapa kes musuh di atasnya. Itu biasanya beberapa dozen kes untuk bermula, bukan ratusan. Tabiat yang lebih penting daripada saiz ialah menambah setiap kegagalan pengeluaran sebenar kembali ke dalam set selepas anda membetulkannya, supaya pepijat yang sama tidak dilancarkan dua kali.
Penilaian Offline lwn. Penilaian Online
Jalankan kedua-duanya, dan fahami untuk apa setiap satu sebenarnya.
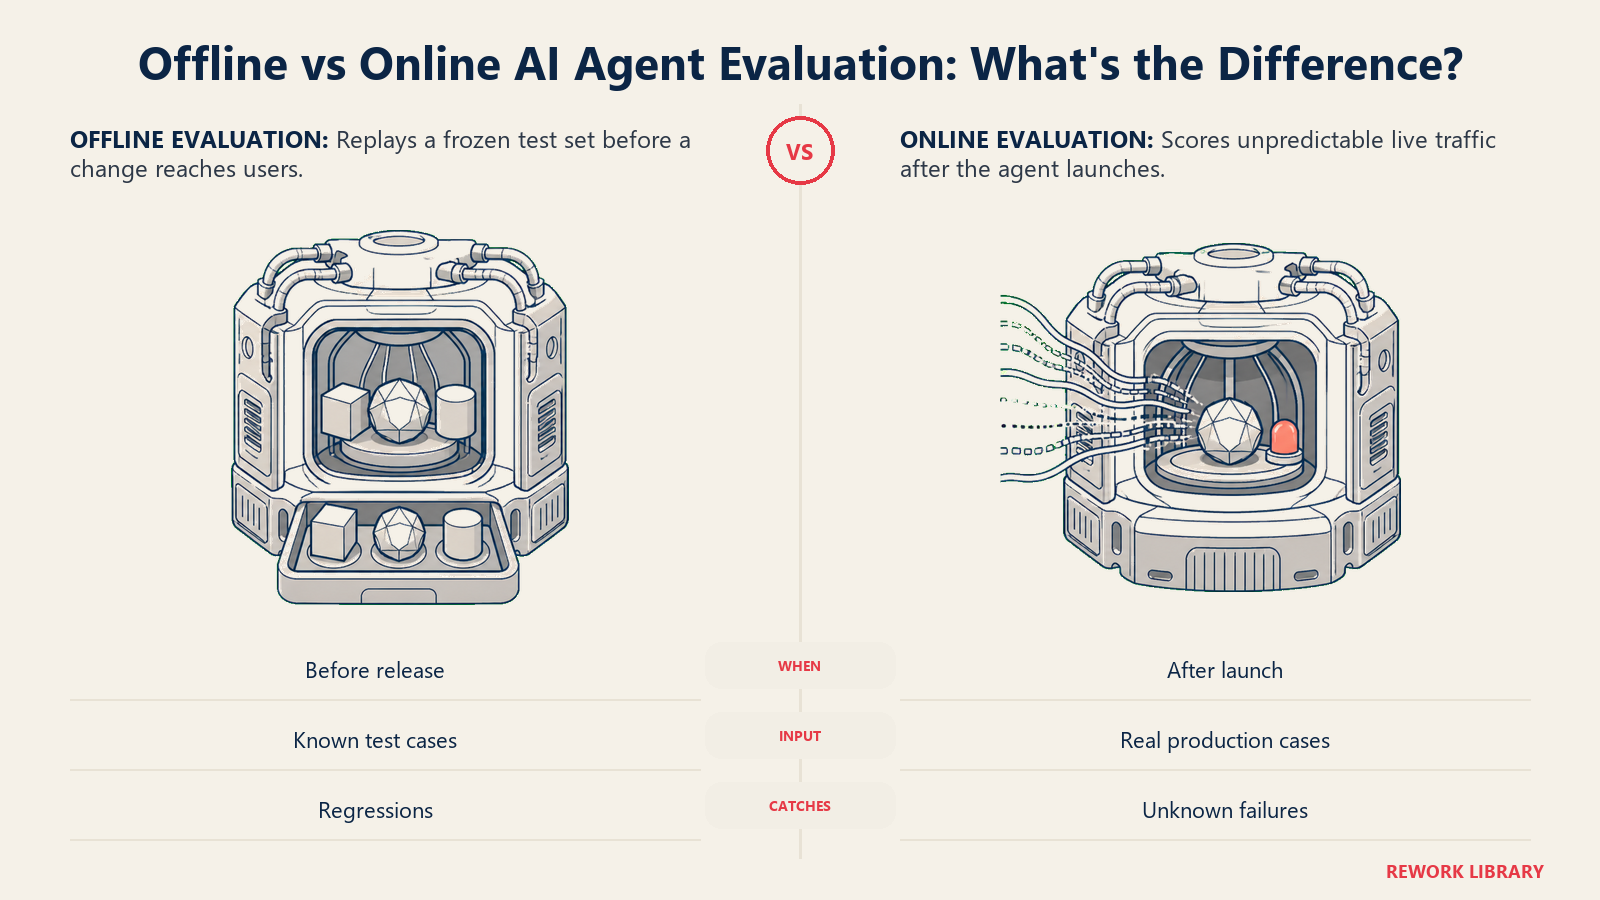
| Penilaian offline | Penilaian online | |
|---|---|---|
| Bila ia berjalan | Sebelum anda melancarkan perubahan | Selepas agent beroperasi |
| Diuji terhadap | Set ujian yang dibekukan dan diketahui | Trafik pengeluaran sebenar yang tidak dapat diramal |
| Kos untuk dijalankan | Murah dan boleh diulang, selamat pada setiap perubahan | Memerlukan infrastruktur pemantauan dan penggunaan sebenar |
| Apa yang ditangkapnya | Regresi: adakah perubahan ini merosakkan sesuatu yang dahulunya berfungsi | Yang tidak diketahui: kes yang anda tidak terfikir untuk menulis ujiannya |
| Kadar lazim | Setiap perubahan prompt, model, atau alat | Secara berterusan |
Penilaian offline ialah tali pinggang keledar anda. Setiap kali anda menyentuh prompt, menukar model, atau menambah alat, jalankan semula set ujian penuh sebelum melancarkan. Jika kadar kejayaan tugas menurun pada kes yang dahulunya lulus, anda menangkap regresi sebelum pelanggan menangkapnya.
Penilaian online ialah tempat dunia sebenar membalas. Corak lazim ialah mod bayang: jalankan versi baharu agent bersebelahan versi yang sudah dalam pengeluaran, pada input langsung yang sama, tanpa membenarkan versi baharu benar-benar bertindak. Bandingkan kedua-dua set output sebelum menukar trafik. Di sinilah juga pemantauan pengeluaran berterusan, log, jejak, metrik, dan penilaian automatik yang memerhati agent secara berterusan selepas pelancaran, mengambil alih. Disiplin itu mempunyai kedalamannya sendiri: lihat kebolehperhatian AI Agent tentang cara melengkapkan agent dengan instrumen supaya masalah timbul dalam beberapa minit dan bukan beberapa minggu.
Cara Menggred Apa yang Dihasilkan Agent
Setelah anda mempunyai set ujian, anda memerlukan cara untuk menskor setiap hasil. Tiga pendekatan, lebih kerap digunakan bersama berbanding bersendirian:
Semakan berasaskan peraturan. Pantas dan murah: adakah agent memanggil alat yang betul, adakah output sepadan dengan format yang dijangka, adakah ia menyertakan petikan yang diperlukan. Peraturan hanya berfungsi untuk tingkah laku yang boleh disemak secara mekanikal, jadi ia meliputi lebih sedikit gambaran daripada yang disangka orang. Panduan OpenAI untuk membina agent membingkaikan ini sebagai pertahanan berlapis, kerana tiada satu semakan pun menangkap segala-galanya.
Semakan manusia. Hakim paling boleh dipercayai bagi nada, pertimbangan, dan apa-apa yang subjektif, dan yang paling perlahan serta mahal. Tiada siapa menyemak setiap perbualan secara manual. Ambil sampel: 20 hingga 50 transkrip seminggu bagi agent langsung sudah memadai untuk menangkap hanyutan tanpa menjadikannya keseluruhan kerja seseorang.
LLM-as-judge. Gunakan model kedua untuk menggred output agent berbanding rubrik bertulis. Ia boleh diskalakan kepada ribuan kes dalam masa yang sama semakan manusia meliputi beberapa dozen, sebab itulah ia menjadi corak piawai untuk menilai agent pada volum sebenar. Tangkapannya: hakim LLM hanya boleh dipercayai selepas ia dikalibrasi. Skor sampel yang sama secara berkala dengan manusia dan model hakim, dan jika keduanya kerap tidak sependapat, baiki rubrik, bukan model. Untuk perbandingan bersebelahan, seperti naik taraf prompt, meminta hakim memilih output yang lebih baik daripada dua cenderung mengatasi meminta skor mutlak.
Nilai Langkah-Langkahnya, Bukan Sekadar Jawapan Akhir
Jawapan akhir boleh kelihatan betul atas sebab yang salah. Agent mungkin mendarat pada kategori tiket yang betul selepas menyemak artikel knowledge base yang salah, atau menempah slot mesyuarat yang betul selepas mengabaikan konflik jadual yang sepatutnya ditangkap. Itu pepijat yang memakai gred lulus, dan ia akan muncul semula apabila laluan bertuah itu tidak tersedia.
Semakan peringkat jejak bermaksud menelusuri jujukan sebenar agent: alat mana yang dipanggilnya, dengan parameter apa, dalam susunan apa, dan sama ada ia mengendalikan hasil yang buruk atau kosong sebelum meneruskan. Ini semakin penting apabila agent mengambil tugas yang lebih panjang dan lebih autonomi. METR menanda aras model AI frontier pada kerja realistik dan mendapati panjang tugas yang boleh disiapkan agent dengan boleh dipercayai, "ufuk masa"-nya, telah berganda lebih kurang setiap tujuh bulan selama enam tahun berturut-turut. Model semasa hampir sempurna pada tugas yang mengambil masa beberapa minit bagi pakar manusia, tetapi berjaya kurang 10% daripada masa pada tugas yang mengambil kira-kira empat jam. Jurang itulah tempat penilaian peringkat trajektori membuktikan nilainya: semakan jawapan akhir tunggal tidak dapat menunjukkan di mana dalam rantaian langkah yang panjang sesuatu mula tersasar.
Dua contoh mengapa jejak lebih penting daripada angka utama:
- AI Support Triage Agent memerlukan keputusan penghalaan penuhnya disemak, bukan sekadar tag akhir tiket. Adakah ia turut mengekalkan permintaan asal pelanggan, atau perubahan baris gilir memadam konteks yang kini perlu ditanya semula oleh ejen manusia?
- AI Fraud Detection Agent memerlukan precision dan recall dijejak sebagai dua angka berasingan, tidak pernah digabungkan menjadi satu. Positif palsu membekukan akaun pelanggan yang sah. Negatif palsu membiarkan penipuan sebenar lepas, dan kedua-dua kegagalan itu merugikan perniagaan dengan cara yang sama sekali berbeza.
Sesetengah pasukan membina semakan jejak ini terus ke dalam produk. AI Chatbot QA Agent ialah penilaian yang dibungkus sebagai agent tersendiri: ia membaca perbualan bot langsung, menskor setiap satu untuk ketepatan, nada, dan penyelesaian, dan menandakan halusinasi atau gelung buntu untuk dibaiki manusia, disiplin yang sama seperti yang diterangkan dalam artikel ini, berjalan secara berterusan dan bukan sebagai satu pusingan pra-pelancaran.
Apa yang Perlu Dijejak Selepas Pelancaran
Setelah agent beroperasi, senarai ringkas angka memberitahu anda sama ada ia masih menjalankan tugasnya:
- Kadar kejayaan tugas dari semasa ke semasa. Trend menurun bermakna sesuatu telah hanyut: kemas kini model, sumber data yang lapuk, atau peralihan dalam jenis kes yang masuk.
- Kadar eskalasi dan serahan. Terlalu rendah boleh bermakna agent melampaui had. Terlalu tinggi boleh bermakna peraturannya terlalu konservatif untuk berguna.
- Kadar override manusia. Berapa kerap seseorang membalikkan atau membetulkan keputusan agent? Kadar override yang meningkat ialah amaran awal lama sebelum kejayaan tugas jelas menurun.
- Kos bagi setiap tugas yang selesai. Pertukaran model atau perubahan prompt yang diam-diam menggandakan penggunaan token tanpa memperbaik hasil ialah masalah bajet yang bersembunyi di tempat yang tiada siapa memandang.
- Kadar regresi. Apakah pecahan kegagalan baharu yang merupakan ulangan pepijat yang sudah dibaiki sekali? Ini patut menuju sifar apabila set ujian anda matang.
Jika anda membandingkan platform pembinaan agent dan mahu alat penjejakan serta penilaian seperti ini terbina dalam dan bukan dipasang secara manual, panduan pembelian platform chatbot AI membincangkan apa yang perlu dicari, dan ringkasan alat automasi ialah titik permulaan yang munasabah untuk menjelajah apa yang ada pada 2026.
Fakta Utama
- Penilaian AI agent menggabungkan set ujian realistik, metrik kejayaan tugas, dan kaedah penggredan (peraturan, semakan manusia, atau LLM-as-judge), dijalankan secara offline sebelum setiap perubahan dan secara online berterusan selepas pelancaran.
- Gartner meramalkan lebih 40% projek AI agentic akan dibatalkan menjelang akhir 2027, didorong oleh nilai perniagaan yang tidak jelas dan kawalan risiko yang tidak memadai, tepat apa yang amalan penilaian sebenar dibina untuk menangkap lebih awal.
- Penyelidikan METR menunjukkan panjang tugas yang boleh disiapkan agent AI dengan boleh dipercayai telah berganda lebih kurang setiap tujuh bulan, sebab itulah penilaian peringkat jejak, langkah demi langkah, semakin penting apabila agent mengambil kerja yang lebih panjang dan lebih autonomi.
- Percayai LLM-as-judge hanya selepas mengkalibrasinya berbanding penilaian manusia pada sampel kes yang sama.
Soalan Lazim tentang Cara Menilai dan Menguji AI Agent
Apakah penilaian AI agent?
Penilaian AI agent ialah amalan menguji sama ada AI agent menyelesaikan tugas sebenar dengan betul, selamat, dan konsisten. Ia menggunakan set ujian kes realistik, metrik kejayaan tugas yang mengukur hasil dan bukan satu jawapan betul, serta kaedah penggredan seperti peraturan, semakan manusia, atau model kedua yang bertindak sebagai hakim, dijalankan sebelum pelancaran dan secara berterusan selepas itu.
Apakah perbezaan antara penilaian offline dengan online?
Penilaian offline menjalankan set ujian beku terhadap setiap perubahan sebelum anda melancarkannya, menangkap regresi dengan murah dan boleh diulang. Penilaian online memerhati trafik pengeluaran sebenar selepas pelancaran, menangkap kes tidak terduga yang anda tidak terfikir untuk menulis ujiannya. Program agent yang matang menjalankan kedua-duanya, bukan salah satu.
Bolehkah LLM benar-benar menggred hasil kerja AI agent lain?
Ya, dan itulah cara piawai untuk menilai agent pada volum sebenar, kerana semakan manusia sahaja tidak dapat diskalakan melebihi beberapa dozen kes seminggu. Tangkapannya ialah kalibrasi: bandingkan skor hakim LLM dengan penilaian manusia pada sampel yang sama secara berkala, dan baiki rubrik jika keduanya kerap tidak sependapat, sebelum mempercayai skor hakim pada skala besar.
Berapa banyak kes ujian yang saya perlukan sebelum melancarkan agent?
Mulakan dengan satu kes ujian bagi setiap baris dalam panduan senario agent, ditambah beberapa kes pinggir dan input musuh, biasanya beberapa dozen kes dan bukan ratusan. Kembangkan set dari semasa ke semasa dengan menambah setiap kegagalan pengeluaran sebenar kembali selepas anda membetulkannya, supaya pepijat yang sama tidak dapat dilancarkan dua kali.
Apakah satu metrik paling penting untuk dijejak?
Kadar kejayaan tugas, diukur berbanding hasil perniagaan sebenar yang menjadi sebab agent itu wujud, bukan ketepatan pada mana-mana langkah individu. Pasangkannya dengan metrik proses seperti kos bagi setiap tugas yang selesai, kerana agent yang mencapai hasil yang betul melalui laluan yang mahal atau berliku masih mempunyai masalah sebenar.
Ke Mana Seterusnya
Amalan penilaian yang kukuh ialah apa yang memisahkan agent yang boleh anda percayai dengan volum sebenar daripada demo yang hanya berfungsi dalam kes yang kebetulan anda cuba. Setelah set ujian dan kaedah penggredan anda sedia, langkah seterusnya yang wajar ialah cara membina AI agent jika anda belum melancarkan versi pertama, atau meneliti bagaimana agent mengasaskan jawapannya pada data sebenar dengan RAG untuk AI Agent dan bagaimana ia mengekalkan konteks sepanjang tugas yang panjang dengan Memori AI Agent, kerana kedua-duanya secara langsung mempengaruhi apa yang akan ditangkap oleh penilaian anda.

On this page
- Mengapa Menguji Agent Tidak Sama dengan Menguji Perisian
- Metrik Teras: Kejayaan Tugas, Bukan Ketepatan
- Bina Set Ujian Sebelum Anda Lancarkan
- Penilaian Offline lwn. Penilaian Online
- Cara Menggred Apa yang Dihasilkan Agent
- Nilai Langkah-Langkahnya, Bukan Sekadar Jawapan Akhir
- Apa yang Perlu Dijejak Selepas Pelancaran
- Fakta Utama
- Ke Mana Seterusnya