Como Avaliar e Testar AI Agents
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
A avaliação de AI agents é a prática de testar sistematicamente se um agent conclui tarefas reais de forma correta, segura e consistente, antes de chegar a um cliente e continuamente depois disso. Ela combina um conjunto de teste com tarefas realistas, uma métrica de sucesso da tarefa em vez de uma única verificação de resposta certa e um método de avaliação (regras, revisão humana ou um segundo modelo atuando como juiz) que pega as falhas antes que elas se acumulem em produção. Pule essa etapa e você não está operando um agent, está conduzindo um experimento sem controle no seu negócio.
Se você ainda não definiu o que um AI agent realmente é e a ideia de autonomia limitada por trás dele, comece por lá. Esta página parte do princípio de que você já passou dessa etapa e já está perguntando se o seu agent é confiável o bastante para receber volume real.
Por Que Testar um Agent Não É Como Testar Software
O QA de software tradicional confere uma entrada fixa com uma saída esperada fixa. Clique neste botão, espere aquela tela. Um AI agent quebra esse modelo de três formas: a mesma entrada pode produzir várias saídas válidas, uma única tarefa pode levar cinco ou quinze etapas dependendo do que o agent encontra pelo caminho, e a própria natureza probabilística do modelo faz com que ele nem sempre faça exatamente a mesma coisa duas vezes.
| Teste de software tradicional | Teste de AI agent | |
|---|---|---|
| Da entrada à saída | Uma única saída correta | Várias saídas válidas possíveis |
| Caminho | Sequência fixa de etapas | O caminho varia conforme o caso, as ferramentas usadas e a ordem |
| Repetibilidade | Mesma entrada, mesmo resultado sempre | A mesma entrada pode gerar caminhos diferentes, ainda válidos |
| Passa ou falha | Binário | Muitas vezes uma nota graduada em relação a uma rubrica |
| O que o quebra | Uma mudança de código | Uma mudança de prompt, uma atualização de modelo, desvio nos dados, a API de uma ferramenta mudando |
Isso não é motivo para pular os testes. É motivo para testar de outro jeito. E o custo de pular é real: a Gartner prevê que mais de 40% dos projetos de agentic AI serão cancelados até o fim de 2027, citando custos crescentes, valor de negócio pouco claro e controles de risco inadequados como as principais causas, e não tecnologia que falhou. Uma prática rigorosa de avaliação é o que transforma "achamos que este agent funciona" em um número que você consegue defender diante de quem controla o orçamento.
A Métrica Central: Sucesso da Tarefa, Não Acurácia
A coisa mais importante a definir antes de escrever um caso de teste é o que "sucesso" significa para este agent específico, em termos do resultado que ele produz, e não das palavras que gera no caminho.
Para um AI Lead Scoring Agent, o sucesso não é se cada pontuação individual bate com o que uma pessoa teria chutado. É se os leads que ele classifica como "quentes" convertem a uma taxa significativamente maior do que os que ele classifica como "frios" nas semanas seguintes. Para um AI Support Triage Agent, o sucesso é se o ticket cai na fila certa com o contexto certo anexado, e não se a redação da classificação bate exatamente com a formulação de uma pessoa.
Divida as suas métricas em dois tipos:
- Métricas de resultado medem se o objetivo foi realmente alcançado: reunião marcada, ticket resolvido, campos de fatura extraídos corretamente, transação sinalizada com precisão.
- Métricas de processo medem como o agent chegou lá: quais ferramentas chamou, quantas etapas levou, quanto custou em tokens e chamadas de API e quanto tempo demorou.
Você precisa das duas. Um agent que atinge a métrica de resultado dando vinte passos desnecessários e gastando dez vezes o custo esperado por tarefa não é de fato um sucesso. É um problema com um bom boletim.
Monte um Conjunto de Teste Antes de Lançar
Você não consegue avaliar o que não definiu. Antes de um agent entrar no ar, monte um conjunto de tarefas realistas que ele de fato vai enfrentar, tiradas de três fontes:
- Casos reais históricos. Tickets, leads ou transações passados, anonimizados se necessário. São o mais próximo de uma verdade de referência que você tem, porque já aconteceram e você sabe, ou consegue determinar, qual era o resultado certo.
- Casos extremos sintéticos. Situações que você sabe que vão acontecer um dia, mas das quais talvez ainda não tenha exemplos históricos suficientes: um cliente perguntando sobre um produto que você acabou de lançar, um lead fora do seu ICP habitual, uma transação logo abaixo do seu limite de fraude.
- Casos adversariais. Entradas desenhadas para quebrar o agent de propósito: uma mensagem tentando convencê-lo a ignorar suas regras, uma pergunta sem boa resposta na knowledge base, um pedido claramente fora do seu escopo.
Um ponto de partida prático é um caso de teste para cada linha do manual de cenários do agent, parte dos seis blocos de construção que todo blueprint da Rework define, mais um punhado de casos adversariais por cima. Normalmente são algumas dezenas de casos para começar, não centenas. O hábito que importa mais do que o tamanho é devolver ao conjunto toda falha real de produção depois de corrigida, para que o mesmo bug nunca seja lançado duas vezes.
Avaliação Offline vs. Avaliação Online
Rode as duas e entenda para que serve cada uma.
| Avaliação offline | Avaliação online | |
|---|---|---|
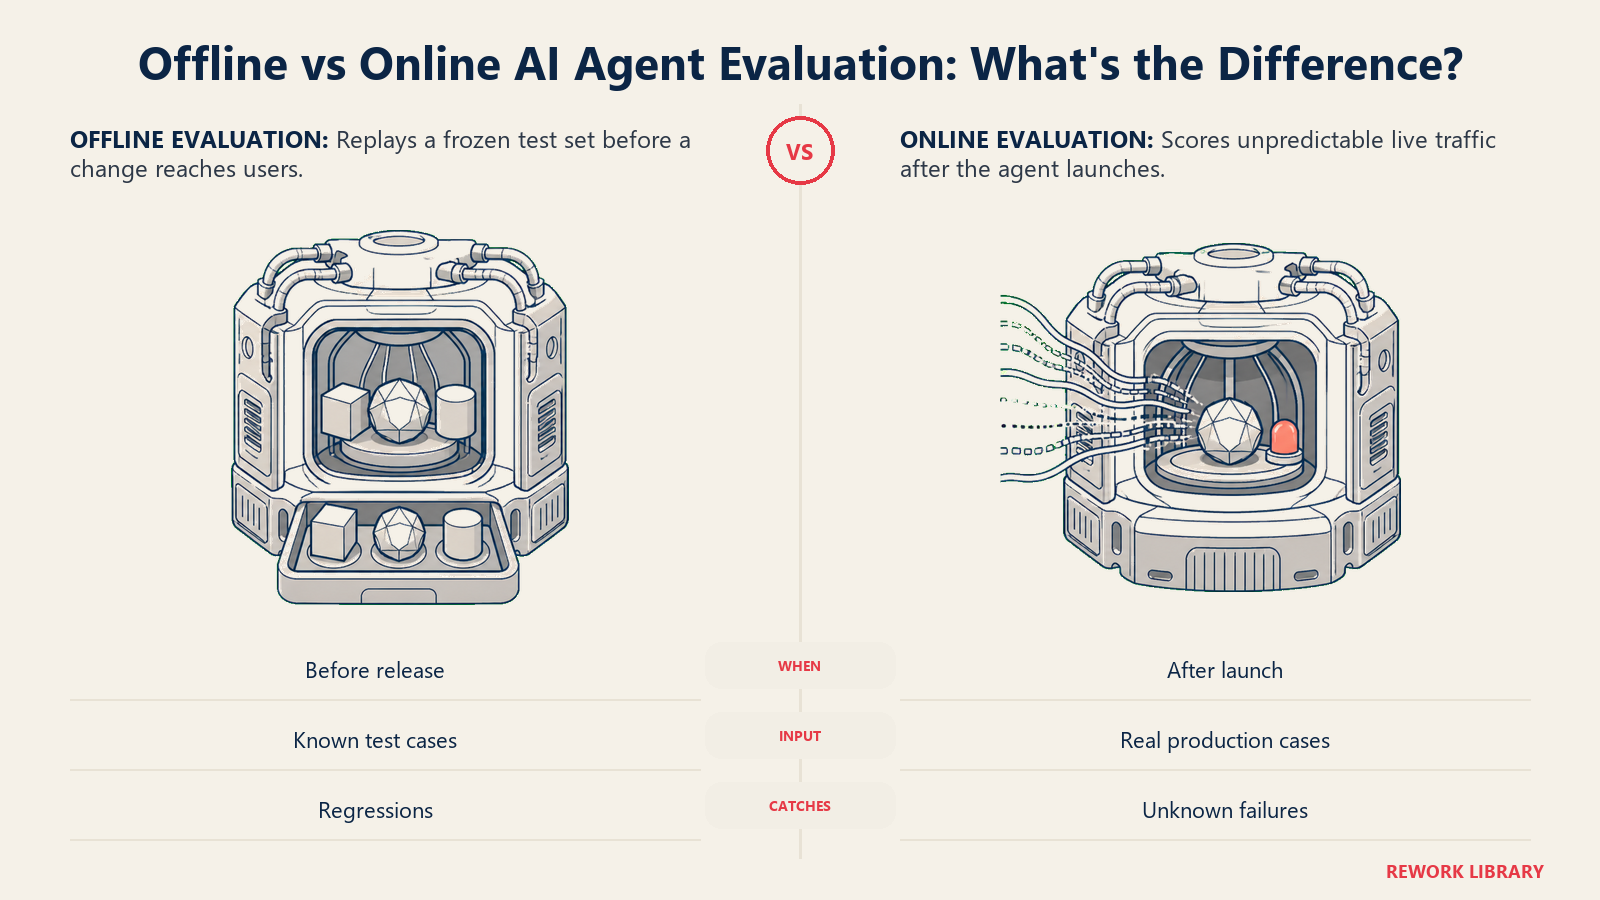
| Quando roda | Antes de lançar uma mudança | Depois que o agent está no ar |
| Testada contra | Um conjunto de teste fixo e conhecido | Tráfego real e imprevisível de produção |
| Custo para rodar | Barata e repetível, segura a cada mudança | Exige infraestrutura de monitoramento e uso real |
| O que detecta | Regressões: essa mudança quebrou algo que funcionava | Incógnitas: casos para os quais você nunca pensou em escrever um teste |
| Cadência típica | A cada mudança de prompt, modelo ou ferramenta | Continuamente |
A avaliação offline é o seu cinto de segurança. Toda vez que você mexe em um prompt, troca um modelo ou adiciona uma ferramenta, rode de novo o conjunto de teste completo antes de implantar. Se a taxa de sucesso das tarefas cair em casos que antes passavam, você pegou uma regressão antes do cliente.
A avaliação online é onde o mundo real responde. Um padrão comum é o shadow mode: rodar a nova versão do agent ao lado da versão que já está em produção, nas mesmas entradas reais, sem deixar a nova versão agir de fato. Compare os dois conjuntos de saídas antes de virar o tráfego. É também aqui que assume o monitoramento contínuo em produção, os logs, rastros, métricas e avaliações automatizadas que observam um agent continuamente depois do lançamento. Essa disciplina tem profundidade própria: veja observabilidade de AI agents para saber como instrumentar um agent de modo que os problemas apareçam em minutos, e não em semanas.
Como Avaliar o Que o Agent Produziu
Com um conjunto de teste em mãos, você precisa de uma forma de pontuar cada resultado. Três abordagens, usadas juntas com mais frequência do que isoladas:
Verificações baseadas em regras. Rápidas e baratas: o agent chamou a ferramenta correta, a saída seguiu o formato esperado, incluiu uma citação obrigatória. As regras só funcionam para comportamentos que podem ser verificados mecanicamente, então cobrem menos do quadro do que as pessoas esperam. O guia da OpenAI para construir agents enquadra isso como defesa em camadas, já que nenhuma verificação isolada pega tudo.
Revisão humana. O juiz mais confiável para tom, decisões de julgamento e tudo que é subjetivo, e também o mais lento e caro. Ninguém revisa toda conversa à mão. Faça amostragem: de 20 a 50 transcrições por semana para um agent no ar bastam para detectar desvios sem transformar isso no trabalho inteiro de alguém.
LLM-as-judge. Use um segundo modelo para avaliar a saída do agent com base em uma rubrica escrita. Ele escala para milhares de casos no tempo em que a revisão humana cobre dezenas, e é por isso que virou o padrão para avaliar agents em volume real. O porém: um juiz LLM só é confiável depois de calibrado. Periodicamente, pontue a mesma amostra com uma pessoa e com o modelo juiz, e, se discordarem com frequência, corrija a rubrica, não o modelo. Em comparações lado a lado, como uma atualização de prompt, pedir ao juiz que escolha a melhor entre duas saídas costuma funcionar melhor do que pedir uma nota absoluta.
Avalie as Etapas, Não Só a Resposta Final
Uma resposta final pode parecer certa pelo motivo errado. Um agent pode chegar à categoria de ticket correta depois de consultar o artigo errado da knowledge base, ou reservar o horário certo de reunião ignorando um conflito de agenda que deveria ter percebido. Isso é um bug com nota de aprovação, e vai reaparecer na próxima vez que o caminho de sorte não estiver disponível.
A revisão no nível do rastro significa percorrer a sequência real do agent: qual ferramenta chamou, com quais parâmetros, em que ordem e se tratou um resultado ruim ou vazio antes de seguir em frente. Isso importa mais à medida que os agents assumem tarefas mais longas e autônomas. A METR faz benchmarks de modelos de AI de ponta em trabalho realista e constatou que a duração da tarefa que um agent consegue concluir de forma confiável, o seu "horizonte de tempo", vem dobrando a cada sete meses, mais ou menos, há seis anos seguidos. Os modelos atuais são quase perfeitos em tarefas que levam alguns minutos para um especialista humano, mas têm sucesso em menos de 10% das vezes em tarefas que levam cerca de quatro horas. Essa lacuna é onde a avaliação no nível da trajetória mostra seu valor: uma verificação única da resposta final não mostra em que ponto de uma longa cadeia de etapas as coisas começaram a se desviar.
Dois exemplos de por que o rastro importa mais do que o número de manchete:
- Um AI Support Triage Agent precisa ter a decisão de roteamento inteira verificada, não só a tag final do ticket. Ele também preservou o pedido original do cliente, ou a mudança de fila apagou um contexto que o atendente humano agora precisa perguntar de novo?
- Um AI Fraud Detection Agent precisa ter precisão e recall acompanhados como dois números separados, nunca misturados em um só. Um falso positivo congela a conta de um cliente legítimo. Um falso negativo deixa passar uma fraude real, e essas duas falhas custam ao negócio de maneiras completamente diferentes.
Algumas equipes embutem essa revisão de rastros diretamente no produto. Um AI Chatbot QA Agent é a avaliação empacotada como um agent próprio: ele lê conversas reais do bot, pontua cada uma em precisão, tom e resolução e sinaliza alucinações ou loops sem saída para uma pessoa corrigir, a mesma disciplina que este artigo descreve, rodando continuamente em vez de numa passada única antes do lançamento.
O Que Acompanhar Depois do Lançamento
Com o agent no ar, uma lista curta de números diz se ele ainda está fazendo o seu trabalho:
- Taxa de sucesso das tarefas ao longo do tempo. Uma tendência de queda significa que algo se desviou: uma atualização de modelo, uma fonte de dados desatualizada ou uma mudança no tipo de caso que chega.
- Taxa de escalonamento e de transferência. Baixa demais pode significar que o agent está passando dos limites. Alta demais pode significar que suas regras são conservadoras demais para serem úteis.
- Taxa de intervenção humana. Com que frequência uma pessoa reverte ou corrige o que o agent decidiu? Uma taxa de intervenção em alta é um alerta precoce muito antes de o sucesso das tarefas cair de forma visível.
- Custo por tarefa concluída. Uma troca de modelo ou mudança de prompt que dobra silenciosamente o uso de tokens sem melhorar os resultados é um problema de orçamento escondido onde ninguém olha.
- Taxa de regressão. Que fração das novas falhas são repetições de bugs já corrigidos uma vez? Isso deve tender a zero conforme o seu conjunto de teste amadurece.
Se você está comparando plataformas para construir agents e quer esse tipo de rastreamento e ferramenta de avaliação embutido, em vez de montado à mão, o guia de compra de plataformas de AI chatbot mostra o que procurar, e o roundup de ferramentas de automação é um ponto de partida razoável para navegar pelo que está disponível em 2026.
Key Facts
- A avaliação de AI agents combina um conjunto de teste realista, uma métrica de sucesso da tarefa e um método de avaliação (regras, revisão humana ou LLM-as-judge), executados tanto offline antes de cada mudança quanto online continuamente depois do lançamento.
- A Gartner prevê que mais de 40% dos projetos de agentic AI serão cancelados até o fim de 2027, impulsionados por valor de negócio pouco claro e controles de risco inadequados, exatamente o que uma prática real de avaliação foi feita para detectar cedo.
- A pesquisa da METR mostra que a duração de tarefa confiável dos AI agents vem dobrando a cada sete meses, mais ou menos, e é por isso que a avaliação no nível do rastro, etapa por etapa, importa mais à medida que os agents assumem trabalhos mais longos e autônomos.
- Confie em um LLM-as-judge só depois de calibrá-lo com avaliações humanas na mesma amostra de casos.
Perguntas Frequentes sobre Como Avaliar e Testar AI Agents
O que é a avaliação de AI agents?
A avaliação de AI agents é a prática de testar se um AI agent conclui tarefas reais de forma correta, segura e consistente. Ela usa um conjunto de teste com casos realistas, uma métrica de sucesso da tarefa que mede o resultado em vez de uma única resposta certa e um método de avaliação, como regras, revisão humana ou um segundo modelo atuando como juiz, executados tanto antes do lançamento quanto continuamente depois.
Qual é a diferença entre avaliação offline e online?
A avaliação offline roda um conjunto de teste fixo a cada mudança antes de você lançá-la, detectando regressões de forma barata e repetível. A avaliação online observa o tráfego real de produção depois do lançamento, detectando os casos imprevisíveis para os quais você não pensou em escrever um teste. Um programa maduro de agents roda as duas, e não uma ou outra.
Um LLM consegue mesmo avaliar o trabalho de outro AI agent?
Sim, e é a forma padrão de avaliar agents em volume real, já que a revisão humana sozinha não escala além de algumas dezenas de casos por semana. O porém é a calibração: compare periodicamente as notas do juiz LLM com avaliações humanas na mesma amostra e corrija a rubrica se discordarem com frequência, antes de confiar nas notas do juiz em escala.
De quantos casos de teste eu preciso antes de lançar um agent?
Comece com um caso de teste para cada linha do manual de cenários do agent, mais um punhado de casos extremos e entradas adversariais, normalmente algumas dezenas de casos e não centenas. Aumente o conjunto ao longo do tempo devolvendo a ele toda falha real de produção depois de corrigida, para que o mesmo bug não seja lançado duas vezes.
Qual é a métrica mais importante a acompanhar?
A taxa de sucesso das tarefas, medida em relação ao resultado de negócio real que o agent existe para produzir, e não a acurácia de qualquer etapa individual. Combine-a com uma métrica de processo, como o custo por tarefa concluída, porque um agent que chega ao resultado certo por um caminho caro ou tortuoso ainda tem um problema real.
Para Onde Ir Agora
Uma prática sólida de avaliação é o que separa um agent em que você pode confiar com volume real de uma demo que só funciona nos casos que você por acaso testou. Com o conjunto de teste e o método de avaliação definidos, o próximo passo natural é como construir um AI agent, se você ainda não lançou uma primeira versão, ou olhar como o agent ancora suas respostas em dados reais com RAG para AI agents e como ele mantém o contexto organizado ao longo de uma tarefa longa com a memória de AI agents, já que ambos afetam diretamente o que a sua avaliação vai detectar.

On this page
- Por Que Testar um Agent Não É Como Testar Software
- A Métrica Central: Sucesso da Tarefa, Não Acurácia
- Monte um Conjunto de Teste Antes de Lançar
- Avaliação Offline vs. Avaliação Online
- Como Avaliar o Que o Agent Produziu
- Avalie as Etapas, Não Só a Resposta Final
- O Que Acompanhar Depois do Lançamento
- Key Facts
- Para Onde Ir Agora