Bahasa Indonesia
Cara Mengevaluasi dan Menguji AI Agent
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Evaluasi AI agent adalah praktik menguji secara sistematis apakah sebuah agent menyelesaikan tugas nyata dengan benar, aman, dan konsisten, sebelum menemui pelanggan dan terus-menerus setelahnya. Evaluasi ini memadukan test set berisi tugas realistis, metrik keberhasilan tugas alih-alih pengecekan satu jawaban benar, dan metode penilaian (aturan, tinjauan manusia, atau model kedua yang bertindak sebagai juri) yang menangkap kegagalan sebelum menumpuk di produksi. Lewati langkah ini dan Anda bukan sedang menjalankan agent, melainkan menjalankan eksperimen tak terkendali pada bisnis Anda.
Jika Anda belum memahami apa sebenarnya AI agent itu dan gagasan otonomi terbatas di baliknya, mulailah dari sana terlebih dahulu. Halaman ini mengasumsikan Anda sudah melewati langkah itu dan sudah bertanya apakah agent Anda cukup andal untuk dipercaya menangani volume nyata.
Mengapa Menguji Agent Tidak Sama dengan Menguji Perangkat Lunak
QA perangkat lunak tradisional memeriksa input tetap terhadap output yang diharapkan secara tetap. Klik tombol ini, harapkan layar itu. AI agent merusak model tersebut dengan tiga cara: input yang sama dapat menghasilkan beberapa output yang valid, satu tugas bisa memakan lima atau lima belas langkah tergantung apa yang ditemukan agent di sepanjang jalan, dan sifat probabilistik model sendiri membuatnya tidak selalu melakukan hal yang persis sama dua kali.
| Pengujian perangkat lunak tradisional | Pengujian AI agent | |
|---|---|---|
| Input ke output | Satu output yang benar | Beberapa output valid dimungkinkan |
| Jalur | Urutan langkah yang tetap | Jalur bervariasi menurut kasus, tool yang dipakai, dan urutannya |
| Keterulangan | Input sama, hasil sama setiap kali | Input sama dapat menghasilkan jalur berbeda yang tetap valid |
| Lulus atau gagal | Biner | Sering berupa skor bertingkat terhadap rubrik |
| Apa yang merusaknya | Perubahan kode | Perubahan prompt, pembaruan model, data drift, API tool yang berubah |
Itu bukan alasan untuk melewatkan pengujian. Itu alasan untuk menguji dengan cara berbeda. Dan biaya melewatkannya nyata: Gartner memprediksi bahwa lebih dari 40% proyek agentic AI akan dibatalkan pada akhir 2027, dengan membengkaknya biaya, nilai bisnis yang tidak jelas, dan kontrol risiko yang tidak memadai sebagai penyebab utama, bukan kegagalan teknologi. Praktik evaluasi yang ketat-lah yang mengubah "kami rasa agent ini berfungsi" menjadi angka yang dapat Anda pertahankan di hadapan pemilik anggaran.
Metrik Inti: Keberhasilan Tugas, Bukan Akurasi
Hal terpenting yang harus ditentukan sebelum menulis test case adalah apa arti "berhasil" bagi agent spesifik ini, dalam hal hasil yang dihasilkannya, bukan kata-kata yang dibuatnya di sepanjang jalan.
Untuk AI Lead Scoring Agent, keberhasilan bukan apakah setiap skor individual cocok dengan tebakan manusia. Keberhasilan adalah apakah lead yang diberi skor "hot" mengonversi pada tingkat yang jauh lebih tinggi daripada lead yang diberi skor "cold" dalam minggu-minggu berikutnya. Untuk AI Support Triage Agent, keberhasilan adalah apakah tiket mendarat di antrean yang tepat dengan konteks yang benar terlampir, bukan apakah rumusan klasifikasinya persis sama dengan frasa manusia.
Bagi metrik Anda menjadi dua jenis:
- Metrik hasil mengukur apakah tujuan benar-benar tercapai: meeting terjadwal, tiket terselesaikan, kolom faktur terekstrak dengan benar, transaksi ditandai dengan akurat.
- Metrik proses mengukur bagaimana agent sampai di sana: tool mana yang dipanggil, berapa langkah yang diambil, berapa biayanya dalam token dan pemanggilan API, dan berapa lama waktunya.
Anda membutuhkan keduanya. Agent yang mencapai metrik hasil dengan mengambil dua puluh langkah yang tidak perlu dan menghabiskan sepuluh kali biaya yang diharapkan per tugas bukanlah keberhasilan. Itu masalah yang mengenakan scorecard yang bagus.
Bangun Test Set Sebelum Rilis
Anda tidak dapat mengevaluasi apa yang belum Anda definisikan. Sebelum agent live, susun serangkaian tugas realistis yang benar-benar akan dihadapinya, yang diambil dari tiga sumber:
- Kasus nyata historis. Tiket, lead, atau transaksi masa lalu, dianonimkan jika perlu. Inilah yang paling mendekati ground truth, karena sudah terjadi dan Anda tahu, atau dapat menentukan, hasil yang benar.
- Edge case sintetis. Situasi yang Anda tahu akan terjadi suatu saat tetapi mungkin belum punya cukup contoh historisnya: pelanggan menanyakan produk yang baru Anda luncurkan, lead di luar ICP biasa Anda, transaksi tepat di bawah ambang penipuan Anda.
- Kasus adversarial. Input yang sengaja dirancang untuk merusak agent: pesan yang berusaha membujuknya mengabaikan aturannya, pertanyaan tanpa jawaban yang baik di knowledge base-nya, permintaan yang jelas di luar cakupannya.
Titik awal yang praktis adalah satu test case untuk setiap baris dalam scenario playbook agent, bagian dari enam blok penyusun yang didefinisikan setiap blueprint Rework, ditambah beberapa kasus adversarial di atasnya. Biasanya itu beberapa lusin kasus untuk memulai, bukan ratusan. Kebiasaan yang lebih penting daripada ukurannya adalah memasukkan kembali setiap kegagalan produksi nyata ke dalam set setelah Anda memperbaikinya, agar bug yang sama tidak pernah dirilis dua kali.
Evaluasi Offline vs. Evaluasi Online
Jalankan keduanya, dan pahami untuk apa masing-masing sebenarnya.
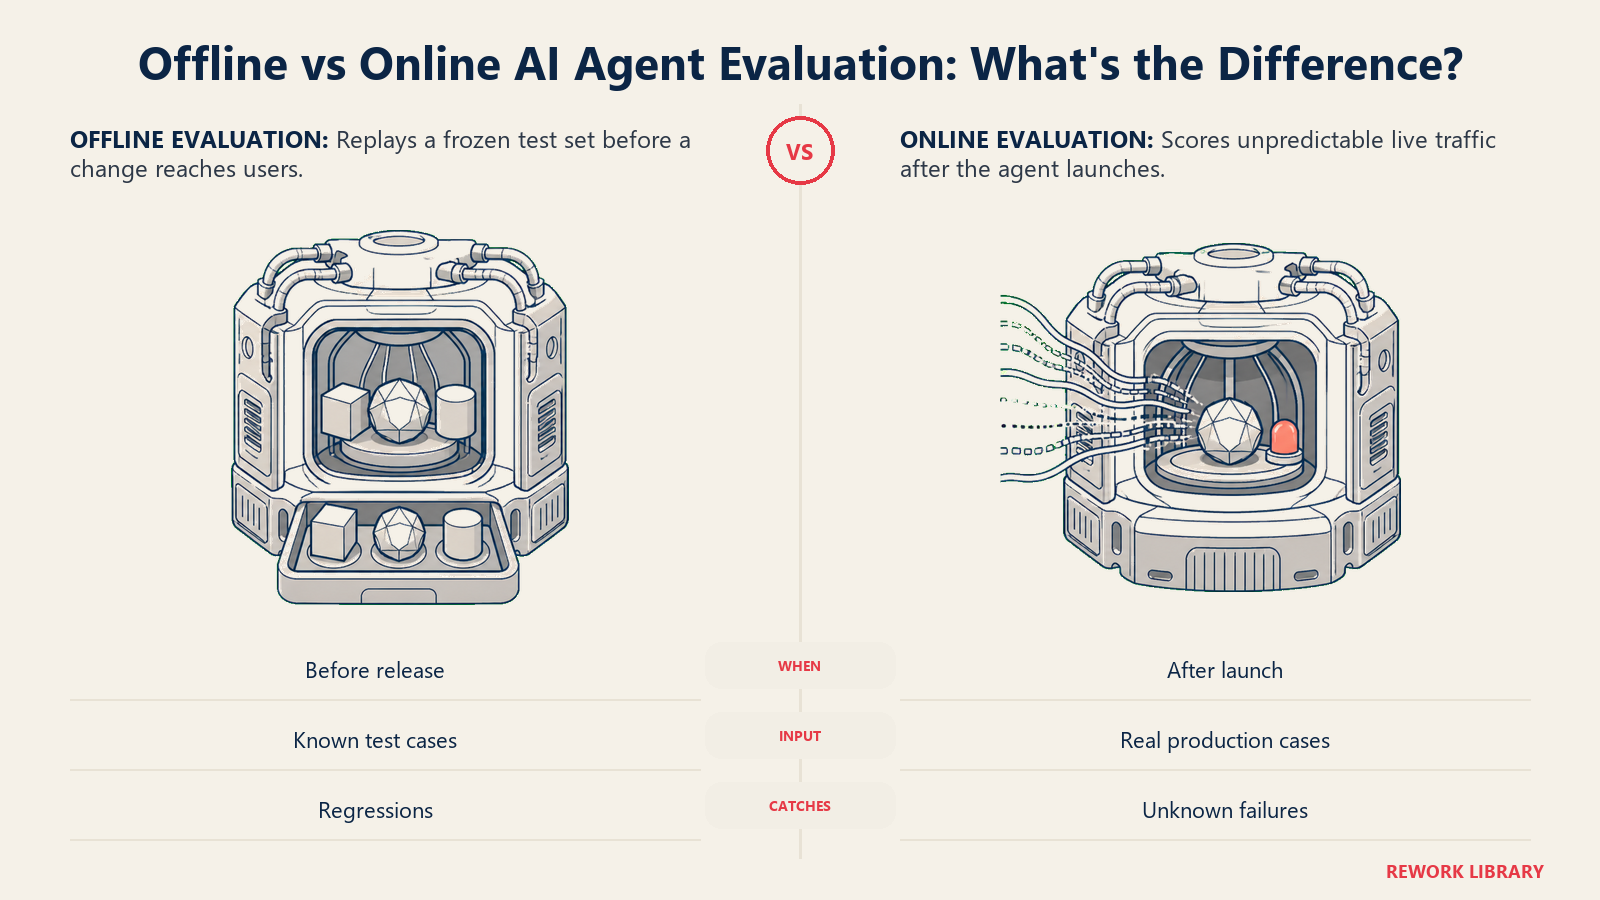
| Evaluasi offline | Evaluasi online | |
|---|---|---|
| Kapan berjalan | Sebelum Anda merilis perubahan | Setelah agent live |
| Diuji terhadap | Test set yang dibekukan dan sudah diketahui | Lalu lintas produksi nyata yang tak terduga |
| Biaya menjalankan | Murah dan dapat diulang, aman pada setiap perubahan | Membutuhkan infrastruktur pemantauan dan penggunaan nyata |
| Apa yang ditangkap | Regresi: apakah perubahan ini merusak sesuatu yang dulu berfungsi | Hal tak terduga: kasus yang tidak terpikir untuk dibuatkan tesnya |
| Kadensi umum | Setiap perubahan prompt, model, atau tool | Terus-menerus |
Evaluasi offline adalah sabuk pengaman Anda. Setiap kali Anda menyentuh prompt, mengganti model, atau menambah tool, jalankan ulang seluruh test set sebelum deploy. Jika tingkat keberhasilan tugas turun pada kasus yang dulu lulus, Anda menangkap regresi sebelum pelanggan.
Evaluasi online adalah tempat dunia nyata menjawab balik. Pola yang umum adalah shadow mode: menjalankan versi baru agent berdampingan dengan versi yang sudah di produksi, pada input langsung yang sama, tanpa membiarkan versi baru benar-benar bertindak. Bandingkan kedua kumpulan output sebelum mengalihkan lalu lintas. Di sinilah pemantauan produksi berkelanjutan, yaitu log, trace, metrik, dan evaluasi otomatis yang mengawasi agent terus-menerus setelah peluncuran, mengambil alih. Disiplin itu punya kedalamannya sendiri: lihat AI Agent Observability untuk cara menginstrumentasi agent agar masalah muncul dalam hitungan menit, bukan minggu.
Cara Menilai Apa yang Dihasilkan Agent
Setelah memiliki test set, Anda membutuhkan cara untuk menilai setiap hasil. Tiga pendekatan, yang lebih sering dipakai bersama daripada sendirian:
Pengecekan berbasis aturan. Cepat dan murah: apakah agent memanggil tool yang benar, apakah output sesuai format yang diharapkan, apakah menyertakan sitasi yang diwajibkan. Aturan hanya berfungsi untuk perilaku yang dapat diperiksa secara mekanis, sehingga cakupannya lebih sempit daripada yang dikira orang. Panduan membangun agent dari OpenAI membingkai ini sebagai pertahanan berlapis, karena tidak ada satu pengecekan pun yang menangkap segalanya.
Tinjauan manusia. Juri paling andal untuk nada, penilaian, dan apa pun yang subjektif, sekaligus yang paling lambat dan paling mahal. Tidak ada yang meninjau setiap percakapan secara manual. Lakukan sampling: 20 sampai 50 transkrip per minggu untuk agent yang live sudah cukup untuk menangkap drift tanpa menjadikannya pekerjaan penuh seseorang.
LLM-as-judge. Gunakan model kedua untuk menilai output agent terhadap rubrik tertulis. Ini dapat diskalakan ke ribuan kasus dalam waktu yang hanya cukup bagi tinjauan manusia untuk puluhan, itulah sebabnya ini menjadi pola standar untuk mengevaluasi agent pada volume nyata. Syaratnya: LLM judge hanya dapat dipercaya setelah dikalibrasi. Secara berkala nilai sampel yang sama dengan manusia dan model juri; jika sering berbeda, perbaiki rubriknya, bukan modelnya. Untuk perbandingan berdampingan, seperti peningkatan prompt, meminta juri memilih yang lebih baik dari dua output cenderung lebih unggul daripada meminta skor absolut.
Evaluasi Langkah-Langkahnya, Bukan Hanya Jawaban Akhir
Jawaban akhir bisa tampak benar karena alasan yang salah. Agent mungkin mendarat di kategori tiket yang benar setelah memeriksa artikel knowledge base yang salah, atau memesan slot meeting yang benar setelah mengabaikan konflik jadwal yang seharusnya ditangkap. Itu bug yang mengenakan nilai lulus, dan akan muncul lagi saat jalur yang kebetulan beruntung itu tidak tersedia.
Tinjauan tingkat trace berarti menelusuri urutan nyata yang dijalani agent: tool mana yang dipanggil, dengan parameter apa, dalam urutan apa, dan apakah ia menangani hasil yang buruk atau kosong sebelum melanjutkan. Ini semakin penting seiring agent mengambil tugas yang lebih panjang dan lebih otonom. METR membandingkan model AI frontier pada pekerjaan realistis dan menemukan bahwa panjang tugas yang dapat diselesaikan agent secara andal, "time horizon"-nya, berlipat ganda kira-kira setiap tujuh bulan selama enam tahun berturut-turut. Model saat ini nyaris sempurna pada tugas yang memakan waktu beberapa menit bagi pakar manusia, tetapi berhasil kurang dari 10% pada tugas yang memakan sekitar empat jam. Kesenjangan itulah yang membuat evaluasi tingkat lintasan terbukti berguna: pengecekan jawaban akhir tunggal tidak dapat menunjukkan di mana dalam rantai langkah yang panjang segalanya mulai menyimpang.
Dua contoh mengapa trace lebih penting daripada angka utama:
- AI Support Triage Agent perlu diperiksa keputusan routing-nya secara utuh, bukan hanya tag akhir tiket. Apakah ia juga mempertahankan permintaan asli pelanggan, atau perpindahan antrean menghapus konteks yang kini harus ditanyakan ulang oleh agen manusia?
- AI Fraud Detection Agent perlu precision dan recall yang dilacak sebagai dua angka terpisah, tidak pernah dicampur menjadi satu. False positive membekukan akun pelanggan yang sah. False negative meloloskan penipuan nyata, dan kedua kegagalan itu merugikan bisnis dengan cara yang sama sekali berbeda.
Sebagian tim membangun tinjauan trace ini langsung ke dalam produk. AI Chatbot QA Agent adalah evaluasi yang dikemas sebagai agent tersendiri: ia membaca percakapan bot yang live, menilai masing-masing untuk akurasi, nada, dan penyelesaian, serta menandai halusinasi atau loop buntu agar diperbaiki manusia, disiplin yang sama dengan yang dijelaskan artikel ini, berjalan terus-menerus alih-alih sebagai pemeriksaan sekali sebelum peluncuran.
Apa yang Perlu Dilacak Setelah Peluncuran
Setelah agent live, daftar singkat angka memberi tahu apakah ia masih menjalankan tugasnya:
- Tingkat keberhasilan tugas dari waktu ke waktu. Tren menurun berarti ada yang bergeser: pembaruan model, sumber data yang usang, atau perubahan jenis kasus yang masuk.
- Tingkat eskalasi dan serah terima. Terlalu rendah bisa berarti agent melampaui batasnya. Terlalu tinggi bisa berarti aturannya terlalu konservatif untuk berguna.
- Tingkat override manusia. Seberapa sering seseorang membalik atau mengoreksi keputusan agent? Tingkat override yang meningkat adalah peringatan dini jauh sebelum keberhasilan tugas terlihat turun.
- Biaya per tugas yang selesai. Pergantian model atau perubahan prompt yang diam-diam menggandakan penggunaan token tanpa memperbaiki hasil adalah masalah anggaran yang bersembunyi di tempat yang tidak dilihat siapa pun.
- Tingkat regresi. Berapa bagian kegagalan baru yang merupakan pengulangan bug yang sudah pernah diperbaiki? Angka ini seharusnya menuju nol seiring matangnya test set Anda.
Jika Anda membandingkan platform pembangun agent dan menginginkan perangkat tracing dan evaluasi seperti ini sudah tertanam, bukan dirakit sendiri, panduan membeli platform chatbot AI membahas apa yang perlu dicari, dan ulasan alat otomatisasi adalah titik awal yang wajar untuk melihat apa yang tersedia di 2026.
Key Facts
- Evaluasi AI agent memadukan test set realistis, metrik keberhasilan tugas, dan metode penilaian (aturan, tinjauan manusia, atau LLM-as-judge), dijalankan baik offline sebelum setiap perubahan maupun online secara terus-menerus setelah peluncuran.
- Gartner memprediksi lebih dari 40% proyek agentic AI akan dibatalkan pada akhir 2027, didorong oleh nilai bisnis yang tidak jelas dan kontrol risiko yang tidak memadai, persis hal yang dirancang untuk ditangkap lebih awal oleh praktik evaluasi yang nyata.
- Riset METR menunjukkan panjang tugas yang andal bagi AI agent berlipat ganda kira-kira setiap tujuh bulan, itulah sebabnya evaluasi tingkat trace, langkah demi langkah, makin penting seiring agent mengambil pekerjaan yang lebih panjang dan lebih otonom.
- Percayai LLM-as-judge hanya setelah mengkalibrasinya terhadap penilaian manusia pada sampel kasus yang sama.
Pertanyaan yang Sering Diajukan tentang Cara Mengevaluasi dan Menguji AI Agent
Apa itu evaluasi AI agent?
Evaluasi AI agent adalah praktik menguji apakah sebuah AI agent menyelesaikan tugas nyata dengan benar, aman, dan konsisten. Evaluasi ini memakai test set berisi kasus realistis, metrik keberhasilan tugas yang mengukur hasil, bukan satu jawaban benar, dan metode penilaian seperti aturan, tinjauan manusia, atau model kedua sebagai juri, dijalankan baik sebelum peluncuran maupun terus-menerus sesudahnya.
Apa perbedaan antara evaluasi offline dan online?
Evaluasi offline menjalankan test set yang dibekukan pada setiap perubahan sebelum Anda merilisnya, menangkap regresi secara murah dan dapat diulang. Evaluasi online mengamati lalu lintas produksi nyata setelah peluncuran, menangkap kasus tak terduga yang tidak terpikir untuk dibuatkan tesnya. Program agent yang matang menjalankan keduanya, bukan salah satu.
Bisakah LLM benar-benar menilai pekerjaan AI agent lain?
Bisa, dan ini cara standar untuk mengevaluasi agent pada volume nyata, karena tinjauan manusia saja tidak dapat diskalakan melampaui beberapa lusin kasus per minggu. Syaratnya adalah kalibrasi: secara berkala bandingkan skor LLM judge dengan penilaian manusia pada sampel yang sama, dan perbaiki rubrik jika sering berbeda, sebelum mempercayai skor juri pada skala besar.
Berapa banyak test case yang saya butuhkan sebelum meluncurkan agent?
Mulailah dengan satu test case untuk setiap baris dalam scenario playbook agent, ditambah beberapa edge case dan input adversarial, biasanya beberapa lusin kasus, bukan ratusan. Perbesar set seiring waktu dengan memasukkan kembali setiap kegagalan produksi nyata setelah Anda memperbaikinya, agar bug yang sama tidak dapat dirilis dua kali.
Apa satu metrik terpenting yang perlu dilacak?
Tingkat keberhasilan tugas, diukur terhadap hasil bisnis nyata yang menjadi alasan agent itu ada, bukan akurasi pada langkah individual mana pun. Padukan dengan metrik proses seperti biaya per tugas yang selesai, karena agent yang mencapai hasil yang tepat melalui jalur mahal atau berputar-putar tetap punya masalah nyata.
Langkah Selanjutnya
Praktik evaluasi yang solid-lah yang memisahkan agent yang dapat dipercaya menangani volume nyata dari demo yang hanya berfungsi pada kasus yang kebetulan Anda coba. Setelah test set dan metode penilaian Anda siap, langkah alaminya adalah cara membangun AI agent jika Anda belum merilis versi pertama, atau melihat bagaimana agent menambatkan jawabannya pada data nyata dengan RAG untuk AI Agent dan bagaimana ia menjaga konteks tetap runtut dalam tugas panjang dengan AI Agent Memory, karena keduanya langsung memengaruhi apa yang akan ditangkap evaluasi Anda.

On this page
- Mengapa Menguji Agent Tidak Sama dengan Menguji Perangkat Lunak
- Metrik Inti: Keberhasilan Tugas, Bukan Akurasi
- Bangun Test Set Sebelum Rilis
- Evaluasi Offline vs. Evaluasi Online
- Cara Menilai Apa yang Dihasilkan Agent
- Evaluasi Langkah-Langkahnya, Bukan Hanya Jawaban Akhir
- Apa yang Perlu Dilacak Setelah Peluncuran
- Key Facts
- Langkah Selanjutnya