Wie Sie AI Agents evaluieren und testen
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI-Agent-Evaluierung ist die Praxis, systematisch zu testen, ob ein Agent echte Aufgaben korrekt, sicher und konsistent erledigt, bevor er je einen Kunden erreicht und danach fortlaufend. Sie kombiniert ein Testset realistischer Aufgaben, eine Task-Success-Metrik statt einer einzelnen Prüfung auf die eine richtige Antwort und eine Bewertungsmethode (Regeln, menschliche Prüfung oder ein zweites Modell als Judge), die Fehler abfängt, bevor sie sich in der Produktion aufschaukeln. Lassen Sie diesen Schritt aus, betreiben Sie keinen Agent, sondern führen ein unkontrolliertes Experiment an Ihrem Geschäft durch.
Falls Sie noch nicht geklärt haben, was ein AI Agent eigentlich ist und welche Idee der begrenzten Autonomie dahintersteckt, beginnen Sie dort. Diese Seite setzt voraus, dass Sie diesen Schritt hinter sich haben und bereits fragen, ob Ihr Agent zuverlässig genug ist, um ihm echtes Volumen anzuvertrauen.
Warum das Testen eines Agents nicht dem Testen von Software gleicht
Klassische Software-QA prüft eine feste Eingabe gegen eine feste erwartete Ausgabe. Diesen Button klicken, jenen Bildschirm erwarten. Ein AI Agent sprengt dieses Modell auf drei Arten: Dieselbe Eingabe kann mehrere gültige Ausgaben erzeugen, eine einzelne Aufgabe kann fünf oder fünfzehn Schritte brauchen, je nachdem, was der Agent unterwegs findet, und die probabilistische Natur des Modells sorgt dafür, dass es nicht jedes Mal exakt dasselbe tut.
| Klassischer Software-Test | AI-Agent-Test | |
|---|---|---|
| Eingabe zu Ausgabe | Eine korrekte Ausgabe | Mehrere gültige Ausgaben möglich |
| Pfad | Feste Schrittfolge | Pfad variiert je nach Fall, genutzten Tools und Reihenfolge |
| Wiederholbarkeit | Gleiche Eingabe, jedes Mal gleiches Ergebnis | Gleiche Eingabe kann andere, trotzdem gültige Pfade erzeugen |
| Bestanden oder durchgefallen | Binär | Oft ein abgestufter Score gegen ein Raster |
| Was ihn bricht | Eine Code-Änderung | Eine Prompt-Änderung, ein Modell-Update, Daten-Drift, eine geänderte API eines Tools |
Das ist kein Grund, auf Tests zu verzichten. Es ist ein Grund, anders zu testen. Und die Kosten des Verzichts sind real: Gartner prognostiziert, dass über 40 % der Agentic-AI-Projekte bis Ende 2027 eingestellt werden, und nennt als Hauptursachen steigende Kosten, unklaren Geschäftsnutzen und unzureichende Risikokontrollen, nicht versagende Technologie. Eine strenge Evaluierungspraxis macht aus „wir glauben, dieser Agent funktioniert“ eine Zahl, die Sie vor einem Budgetverantwortlichen vertreten können.
Die zentrale Metrik: Task Success, nicht Genauigkeit
Das Wichtigste, das Sie vor dem ersten Testfall festlegen sollten, ist, was „Erfolg“ für diesen konkreten Agent bedeutet, gemessen am Ergebnis, das er liefert, nicht an den Worten, die er unterwegs erzeugt.
Für einen AI Lead Scoring Agent heißt Erfolg nicht, dass jeder einzelne Score dem entspricht, was ein Mensch geschätzt hätte. Es heißt, dass die Leads, die er als „heiß“ bewertet, in den folgenden Wochen spürbar häufiger konvertieren als die, die er als „kalt“ bewertet. Für einen AI Support Triage Agent heißt Erfolg, dass das Ticket mit dem richtigen Kontext in der richtigen Warteschlange landet, nicht, dass der Wortlaut seiner Klassifikation exakt der Formulierung eines Menschen entspricht.
Teilen Sie Ihre Metriken in zwei Arten:
- Outcome-Metriken messen, ob das Ziel tatsächlich erreicht wurde: gebuchter Termin, gelöstes Ticket, korrekt extrahierte Rechnungsfelder, richtig markierte Transaktion.
- Prozess-Metriken messen, wie der Agent dorthin kam: welche Tools er aufgerufen hat, wie viele Schritte er brauchte, wie viel er an Tokens und API-Aufrufen gekostet hat und wie lange es dauerte.
Sie brauchen beides. Ein Agent, der seine Outcome-Metrik mit zwanzig unnötigen Schritten und dem Zehnfachen der erwarteten Kosten pro Aufgabe erreicht, ist in Wahrheit kein Erfolg. Er ist ein Problem mit gutem Scorecard.
Bauen Sie ein Testset, bevor Sie live gehen
Was Sie nicht definiert haben, können Sie nicht evaluieren. Stellen Sie vor dem Go-live eines Agents ein Set realistischer Aufgaben zusammen, denen er tatsächlich begegnen wird, aus drei Quellen:
- Historische reale Fälle. Vergangene Tickets, Leads oder Transaktionen, bei Bedarf anonymisiert. Sie sind das Nächste an einer Ground Truth, das Sie haben, weil sie bereits stattgefunden haben und Sie wissen oder ermitteln können, was das richtige Ergebnis war.
- Synthetische Grenzfälle. Situationen, von denen Sie wissen, dass sie irgendwann eintreten, zu denen es aber noch nicht genug historische Beispiele gibt: ein Kunde, der nach einem gerade gestarteten Produkt fragt, ein Lead außerhalb Ihres üblichen ICP, eine Transaktion knapp unter Ihrer Betrugsschwelle.
- Adversariale Fälle. Eingaben, die den Agent absichtlich aus dem Tritt bringen sollen: eine Nachricht, die ihn überreden will, seine Regeln zu ignorieren, eine Frage ohne gute Antwort in seiner Knowledge Base, eine Anfrage, die klar außerhalb seines Aufgabenbereichs liegt.
Ein praktischer Ausgangspunkt ist ein Testfall für jede Zeile im Szenario-Playbook des Agents, das zu den sechs Bausteinen gehört, die jeder Rework-Blueprint definiert, plus eine Handvoll adversarialer Fälle obendrauf. Das sind zu Beginn meist einige Dutzend Fälle, nicht Hunderte. Wichtiger als die Größe ist die Gewohnheit, jeden echten Produktionsfehler nach der Behebung wieder in das Set aufzunehmen, damit derselbe Bug nie zweimal ausgeliefert wird.
Offline-Evaluierung vs. Online-Evaluierung
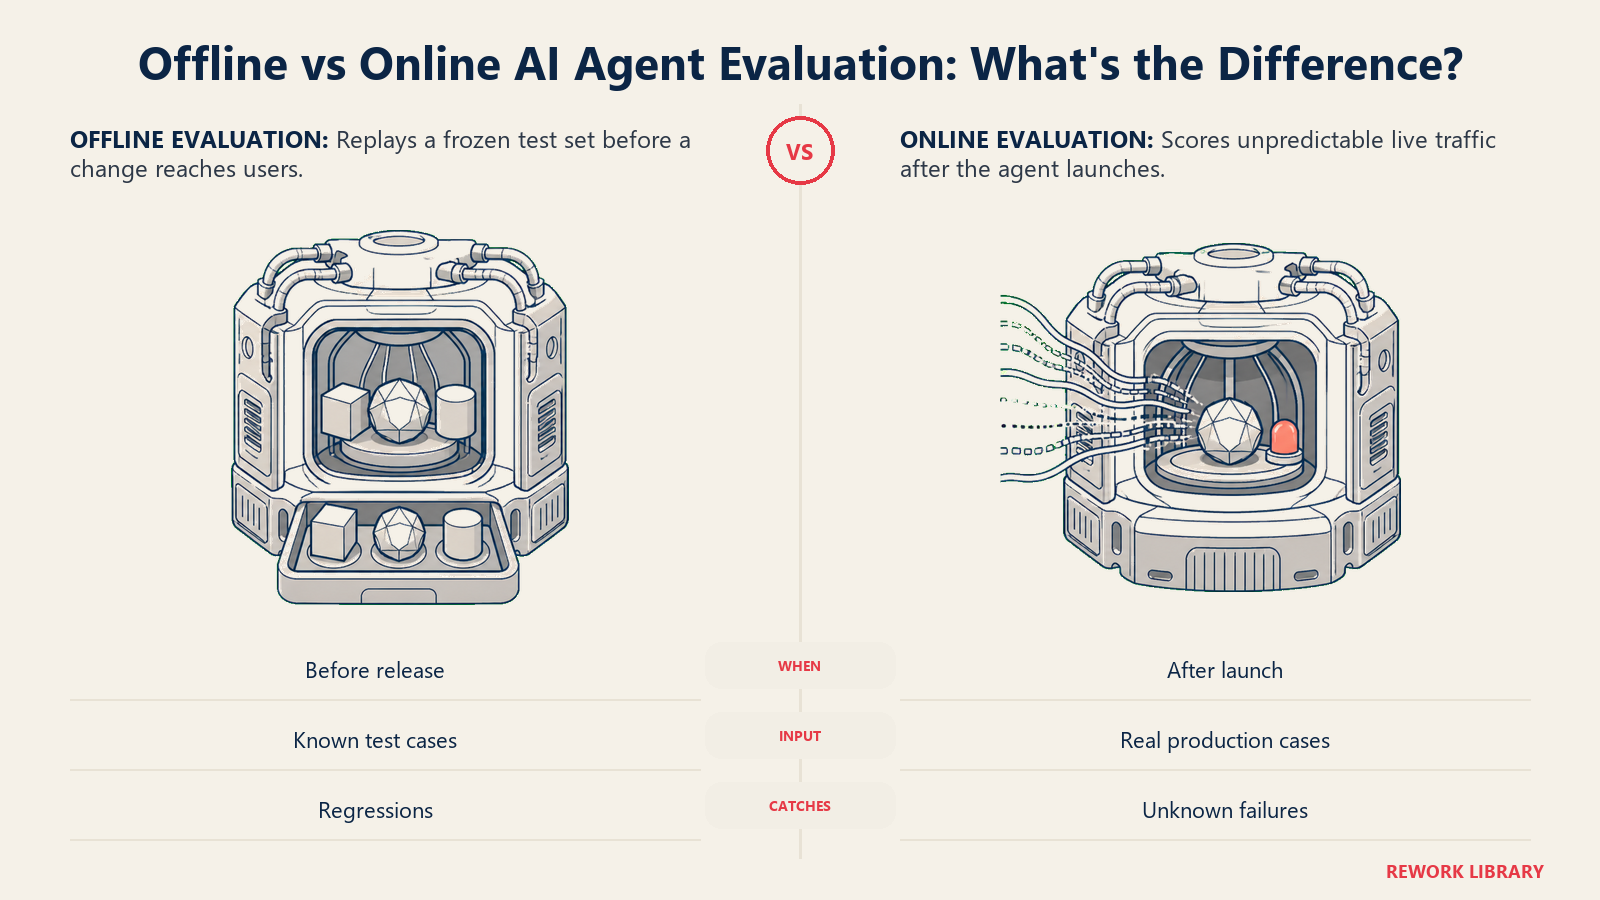
Führen Sie beides durch und verstehen Sie, wofür jede tatsächlich da ist.
| Offline-Evaluierung | Online-Evaluierung | |
|---|---|---|
| Wann sie läuft | Bevor Sie eine Änderung ausliefern | Nachdem der Agent live ist |
| Getestet gegen | Ein eingefrorenes, bekanntes Testset | Echten, unvorhersehbaren Produktionsverkehr |
| Kosten im Betrieb | Günstig und wiederholbar, bei jeder Änderung unbedenklich | Braucht Monitoring-Infrastruktur und echte Nutzung |
| Was sie abfängt | Regressionen: Hat diese Änderung etwas kaputt gemacht, das vorher funktionierte | Unbekanntes: Fälle, für die Sie nie einen Test geschrieben haben |
| Typischer Rhythmus | Bei jeder Änderung an Prompt, Modell oder Tool | Fortlaufend |
Die Offline-Evaluierung ist Ihr Sicherheitsgurt. Jedes Mal, wenn Sie einen Prompt anfassen, ein Modell tauschen oder ein Tool hinzufügen, lassen Sie vor dem Deployment das gesamte Testset erneut laufen. Sinkt die Task-Success-Rate bei Fällen, die früher bestanden haben, haben Sie eine Regression abgefangen, bevor es ein Kunde getan hat.
In der Online-Evaluierung antwortet die reale Welt. Ein gängiges Muster ist der Shadow Mode: Die neue Version des Agents läuft neben der bereits produktiven Version auf denselben Live-Eingaben, ohne dass die neue Version tatsächlich handelt. Vergleichen Sie beide Ausgabesätze, bevor Sie den Traffic umschalten. Hier übernimmt auch das laufende Produktions-Monitoring: die Logs, Traces, Metriken und automatisierten Evaluierungen, die einen Agent nach dem Launch fortlaufend beobachten. Diese Disziplin hat ihre eigene Tiefe: Siehe AI Agent Observability, wie Sie einen Agent so instrumentieren, dass Probleme in Minuten statt Wochen sichtbar werden.
Wie Sie bewerten, was der Agent geliefert hat
Haben Sie ein Testset, brauchen Sie eine Möglichkeit, jedes Ergebnis zu bewerten. Drei Ansätze, die öfter zusammen als allein eingesetzt werden:
Regelbasierte Prüfungen. Schnell und günstig: Hat der Agent das richtige Tool aufgerufen, entsprach die Ausgabe einem erwarteten Format, enthielt sie eine erforderliche Quellenangabe? Regeln funktionieren nur für Verhalten, das sich mechanisch prüfen lässt, und decken daher weniger ab, als man erwartet. Der Leitfaden von OpenAI zum Bau von Agents beschreibt das als mehrschichtige Verteidigung, weil keine einzelne Prüfung alles abfängt.
Menschliche Prüfung. Der verlässlichste Richter für Tonalität, Ermessensentscheidungen und alles Subjektive, zugleich der langsamste und teuerste. Niemand prüft jede Konversation von Hand. Ziehen Sie Stichproben: 20 bis 50 Transkripte pro Woche für einen Live-Agent reichen, um Drift zu erkennen, ohne dass es jemandes gesamte Aufgabe wird.
LLM-as-Judge. Ein zweites Modell bewertet die Ausgabe des Agents anhand eines schriftlichen Bewertungsrasters. Es skaliert auf Tausende Fälle in der Zeit, in der menschliche Prüfung Dutzende schafft, und ist deshalb zum Standardmuster für die Evaluierung von Agents bei echtem Volumen geworden. Der Haken: Ein LLM-Judge ist erst vertrauenswürdig, wenn er kalibriert ist. Bewerten Sie dieselbe Stichprobe regelmäßig sowohl durch einen Menschen als auch durch das Judge-Modell, und wenn beide oft abweichen, korrigieren Sie das Raster, nicht das Modell. Für direkte Vergleiche, etwa bei einem Prompt-Upgrade, schlägt es in der Regel einen absoluten Score, den Judge das bessere von zwei Ergebnissen wählen zu lassen.
Bewerten Sie die Schritte, nicht nur die Endantwort
Eine Endantwort kann aus dem falschen Grund richtig aussehen. Ein Agent landet vielleicht in der richtigen Ticketkategorie, nachdem er den falschen Knowledge-Base-Artikel geprüft hat, oder bucht den richtigen Terminslot, nachdem er einen Terminkonflikt ignoriert hat, den er hätte bemerken müssen. Das ist ein Bug mit bestandener Note, und er taucht wieder auf, sobald der glückliche Pfad nicht mehr verfügbar ist.
Trace-Level-Review heißt, die tatsächliche Abfolge des Agents durchzugehen: welches Tool er aufgerufen hat, mit welchen Parametern, in welcher Reihenfolge und ob er ein fehlerhaftes oder leeres Ergebnis behandelt hat, bevor er weitermachte. Das wird wichtiger, je längere und autonomere Aufgaben Agents übernehmen. METR vergleicht Frontier-AI-Modelle an realistischer Arbeit und fand heraus, dass sich die Länge der Aufgaben, die ein Agent verlässlich erledigen kann, sein „Time Horizon“, sechs Jahre in Folge etwa alle sieben Monate verdoppelt hat. Aktuelle Modelle sind bei Aufgaben, die einen menschlichen Experten wenige Minuten kosten, nahezu perfekt, haben aber bei Aufgaben von rund vier Stunden eine Erfolgsquote von unter 10 %. In dieser Lücke zahlt sich die Evaluierung auf Trajektorien-Ebene aus: Eine einzelne Prüfung der Endantwort zeigt Ihnen nicht, an welcher Stelle einer langen Schrittkette die Dinge abzudriften begannen.
Zwei Beispiele, warum der Trace mehr zählt als die Schlagzeilenzahl:
- Bei einem AI Support Triage Agent muss die gesamte Routing-Entscheidung geprüft werden, nicht nur das endgültige Ticket-Tag. Hat er auch die ursprüngliche Kundenanfrage erhalten, oder hat der Warteschlangenwechsel Kontext gelöscht, den der menschliche Mitarbeiter nun erneut erfragen muss?
- Bei einem AI Fraud Detection Agent müssen Precision und Recall als zwei getrennte Zahlen verfolgt werden, nie vermischt zu einer. Ein False Positive sperrt das Konto eines legitimen Kunden. Ein False Negative lässt echten Betrug durch, und diese beiden Fehler kosten das Unternehmen auf völlig unterschiedliche Weise.
Manche Teams bauen diese Trace-Prüfung direkt ins Produkt ein. Ein AI Chatbot QA Agent ist Evaluierung, verpackt als eigener Agent: Er liest Live-Konversationen des Bots, bewertet jede nach Genauigkeit, Tonalität und Lösung und markiert Halluzinationen oder Sackgassen-Schleifen, die ein Mensch beheben soll. Es ist dieselbe Disziplin, die dieser Artikel beschreibt, nur fortlaufend statt als einmaliger Durchgang vor dem Launch.
Was nach dem Launch zu verfolgen ist
Ist ein Agent live, zeigt Ihnen eine kurze Liste von Zahlen, ob er seine Aufgabe weiterhin erfüllt:
- Task-Success-Rate im Zeitverlauf. Ein Abwärtstrend bedeutet, dass etwas gedriftet ist: ein Modell-Update, eine veraltete Datenquelle oder eine Verschiebung bei der Art der eingehenden Fälle.
- Eskalations- und Übergaberate. Zu niedrig kann heißen, dass der Agent seine Grenzen überschreitet. Zu hoch kann heißen, dass seine Regeln zu konservativ sind, um nützlich zu sein.
- Human-Override-Rate. Wie oft macht ein Mensch eine Entscheidung des Agents rückgängig oder korrigiert sie? Eine steigende Override-Rate ist ein Frühwarnsignal, lange bevor der Task Success sichtbar sinkt.
- Kosten pro erledigter Aufgabe. Ein Modelltausch oder eine Prompt-Änderung, die den Token-Verbrauch still verdoppelt, ohne die Ergebnisse zu verbessern, ist ein Budgetproblem, das sich dort versteckt, wo niemand hinsieht.
- Regressionsrate. Welcher Anteil neuer Fehler sind Wiederholungen von Bugs, die schon einmal behoben wurden? Das sollte mit reiferem Testset gegen null gehen.
Wenn Sie Plattformen zum Bau von Agents vergleichen und Tracing und Evaluierung gleich eingebaut haben wollen, statt sie von Hand zusammenzusetzen, zeigt der Kaufleitfaden für AI-Chatbot-Plattformen, worauf Sie achten sollten, und die Übersicht der Automatisierungs-Tools ist ein guter Startpunkt, um zu stöbern, was 2026 verfügbar ist.
Key Facts
- AI-Agent-Evaluierung kombiniert ein realistisches Testset, eine Task-Success-Metrik und eine Bewertungsmethode (Regeln, menschliche Prüfung oder LLM-as-Judge), offline vor jeder Änderung und online fortlaufend nach dem Launch.
- Gartner prognostiziert, dass mehr als 40 % der Agentic-AI-Projekte bis Ende 2027 eingestellt werden, getrieben von unklarem Geschäftsnutzen und unzureichenden Risikokontrollen, genau dem, was eine echte Evaluierungspraxis früh abfangen soll.
- Die Forschung von METR zeigt, dass sich die verlässliche Aufgabenlänge von AI Agents etwa alle sieben Monate verdoppelt hat. Deshalb wird schrittweise Evaluierung auf Trace-Ebene wichtiger, je länger und autonomer die Arbeit der Agents wird.
- Vertrauen Sie einem LLM-as-Judge erst, nachdem Sie ihn an derselben Stichprobe gegen menschliche Bewertungen kalibriert haben.
Häufig gestellte Fragen zu: Wie Sie AI Agents evaluieren und testen
Was ist AI-Agent-Evaluierung?
AI-Agent-Evaluierung ist die Praxis, zu testen, ob ein AI Agent echte Aufgaben korrekt, sicher und konsistent erledigt. Sie nutzt ein Testset realistischer Fälle, eine Task-Success-Metrik, die das Ergebnis misst statt einer einzelnen richtigen Antwort, und eine Bewertungsmethode wie Regeln, menschliche Prüfung oder ein zweites Modell als Judge, und läuft sowohl vor dem Launch als auch fortlaufend danach.
Was ist der Unterschied zwischen Offline- und Online-Evaluierung?
Die Offline-Evaluierung lässt vor jeder Auslieferung ein eingefrorenes Testset gegen die Änderung laufen und fängt Regressionen günstig und wiederholbar ab. Die Online-Evaluierung beobachtet nach dem Launch echten Produktionsverkehr und fängt die unvorhersehbaren Fälle ab, für die Sie keinen Test geschrieben haben. Ein ausgereiftes Agent-Programm nutzt beides, nicht nur eines.
Kann ein LLM die Arbeit eines anderen AI Agents wirklich bewerten?
Ja, und es ist der Standardweg, Agents bei echtem Volumen zu evaluieren, da menschliche Prüfung allein nicht über einige Dutzend Fälle pro Woche hinaus skaliert. Der Haken ist die Kalibrierung: Vergleichen Sie die Scores des LLM-Judge regelmäßig mit menschlichen Bewertungen derselben Stichprobe und korrigieren Sie das Raster, wenn beide oft abweichen, bevor Sie den Scores des Judge im großen Maßstab vertrauen.
Wie viele Testfälle brauche ich vor dem Launch eines Agents?
Beginnen Sie mit einem Testfall für jede Zeile im Szenario-Playbook des Agents, plus einer Handvoll Grenzfälle und adversarialer Eingaben, meist einige Dutzend Fälle statt Hunderte. Lassen Sie das Set mit der Zeit wachsen, indem Sie jeden echten Produktionsfehler nach der Behebung wieder aufnehmen, damit derselbe Bug nicht zweimal ausgeliefert wird.
Welche ist die wichtigste einzelne Metrik?
Die Task-Success-Rate, gemessen am tatsächlichen Geschäftsergebnis, für das der Agent existiert, nicht an der Genauigkeit einzelner Schritte. Kombinieren Sie sie mit einer Prozess-Metrik wie den Kosten pro erledigter Aufgabe, denn ein Agent, der das richtige Ergebnis auf einem teuren oder umständlichen Weg erreicht, hat trotzdem ein echtes Problem.
Wie es weitergeht
Eine solide Evaluierungspraxis trennt einen Agent, dem Sie echtes Volumen anvertrauen können, von einer Demo, die nur in den Fällen funktioniert, die Sie zufällig ausprobiert haben. Sobald Testset und Bewertungsmethode stehen, ist der nächste natürliche Schritt Wie Sie einen AI Agent bauen, falls Sie noch keine erste Version ausgeliefert haben. Oder Sie schauen, wie der Agent seine Antworten mit RAG für AI Agents in echten Daten verankert und wie er bei einer langen Aufgabe mit AI Agent Memory den Kontext behält, denn beides wirkt sich direkt darauf aus, was Ihre Evaluierung abfängt.

On this page
- Warum das Testen eines Agents nicht dem Testen von Software gleicht
- Die zentrale Metrik: Task Success, nicht Genauigkeit
- Bauen Sie ein Testset, bevor Sie live gehen
- Offline-Evaluierung vs. Online-Evaluierung
- Wie Sie bewerten, was der Agent geliefert hat
- Bewerten Sie die Schritte, nicht nur die Endantwort
- Was nach dem Launch zu verfolgen ist
- Key Facts
- Wie es weitergeht