Segurança de AI Agents: Um Guia Prático
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
A segurança de AI agents é a disciplina de impedir que um agent autônomo seja enganado, receba permissões em excesso ou seja transformado em instrumento de um atacante: modelar as ameaças ao que ele consegue alcançar, aplicar privilégio mínimo a cada ferramenta que ele possui, isolar em sandbox o que ele pode tocar e validar o que entra e sai dele. Ela importa mais do que a segurança de AI em geral porque um agent não apenas gera texto arriscado, ele age. Um modelo enganado produz uma frase ruim. Um agent enganado, em geral, já agiu com base nisso.
Por Que Proteger um Agent É um Problema Maior do que Proteger um Modelo
Segurança de AI cobre as categorias de ameaça que valem para qualquer sistema de AI: entradas adversariais que empurram um modelo para a saída errada, envenenamento de dados que corrompe o treinamento, prompt injection que sequestra instruções, roubo de modelo e inversão de modelo. Todas elas continuam valendo para um agent, porque um agent é construído sobre um modelo. O que muda é o que acontece depois que o modelo é enganado.
O ACE Framework da Rework traça uma linha nítida entre duas de suas capacidades: Generate e Execute. Gerar um rascunho de resposta tem baixo risco; um rascunho ruim simplesmente é apagado antes que alguém o veja. Executar essa ação, ou seja, enviá-la de fato, atualizar um registro, emitir um reembolso, é onde moram as consequências. Um chatbot comum vive, em sua maior parte, do lado Generate dessa linha. Um agent, por definição, a atravessa. É exatamente por isso que os blocos de construção Tools e Guardrails de como os AI agents funcionam existem: Tools define o teto do que um agent pode fazer, e Guardrails define o que ele nunca deve fazer, independentemente do que lhe peçam. A segurança é o que mantém os dois honestos quando alguém está tentando ativamente quebrá-los.
O Modelo de Ameaças de um Agent: Três Lugares Onde os Ataques Acontecem
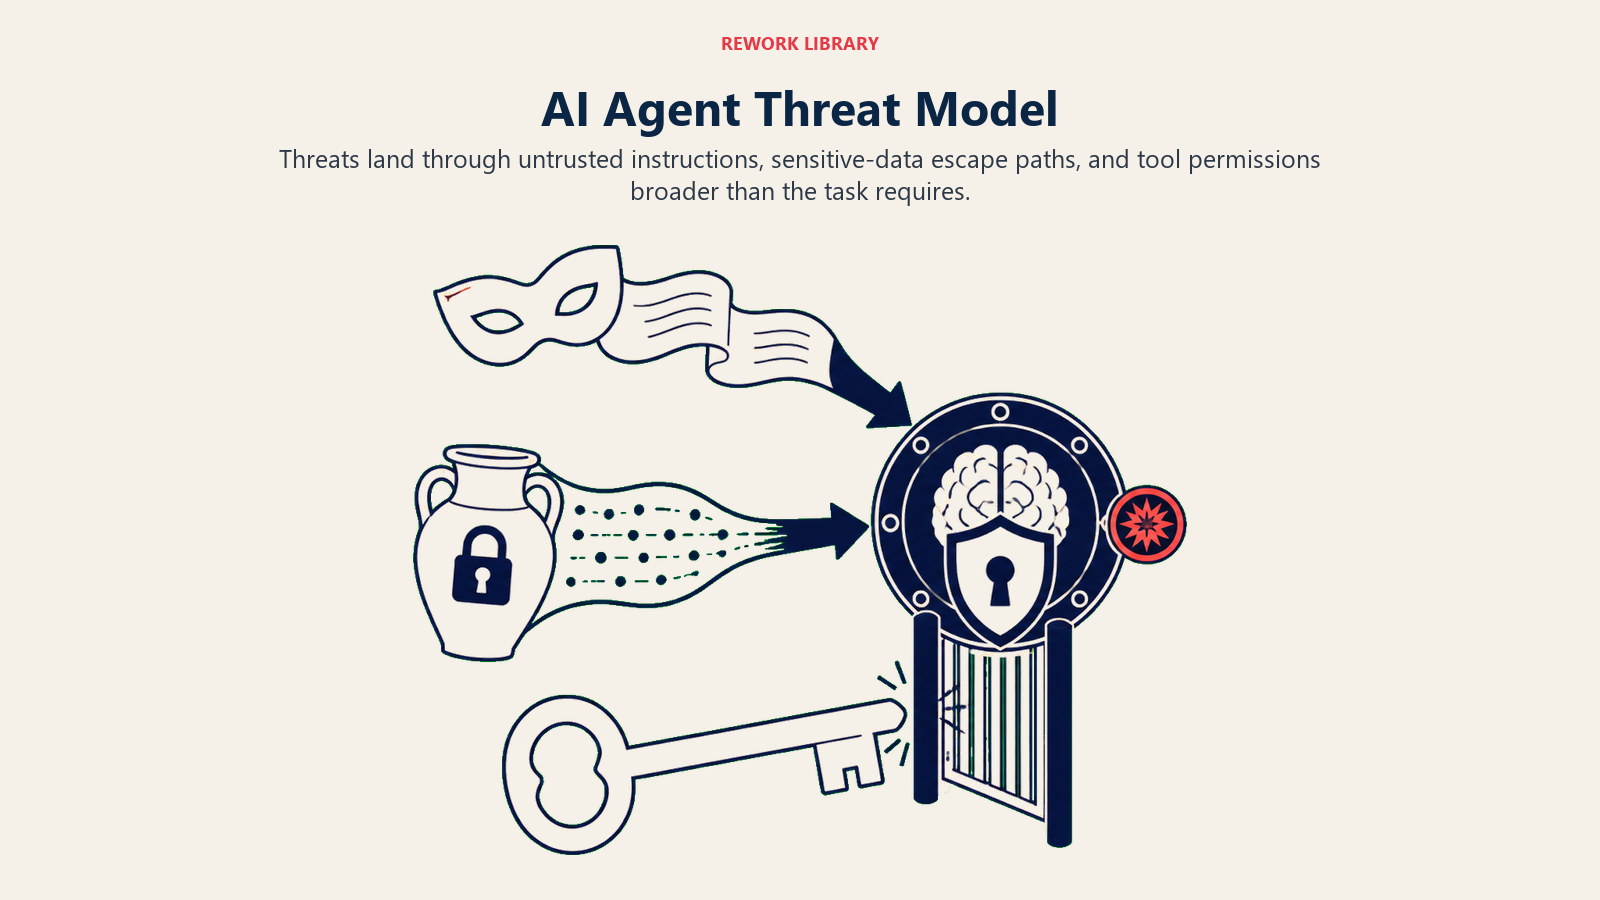
A maioria dos incidentes de segurança com agents remonta a uma de três superfícies.
| Superfície | O que acontece | Por que os agents ficam expostos |
|---|---|---|
| Prompt injection | Instruções escondidas em conteúdo que o agent lê sobrepõem a tarefa real dele | Agents leem conteúdo não confiável por definição: e-mails, tickets, documentos, páginas da web, dados coletados |
| Exfiltração de dados | O agent é manipulado para incluir dados sensíveis em uma saída, em uma chamada de ferramenta ou em uma mensagem para uma parte externa | Agents costumam ter amplo acesso de leitura a sistemas de CRM, suporte ou financeiros para fazer seu trabalho |
| Ferramentas com permissões em excesso | Uma única manipulação bem-sucedida se propaga porque o acesso do agent às ferramentas é mais amplo do que a tarefa realmente exige | As equipes costumam conceder uma credencial de integração ampla em vez de restringir o acesso por tarefa |
Prompt injection é a que deve ser levada mais a sério. Ela ocupa o primeiro lugar, LLM01, no OWASP Top 10 para Aplicações de LLM, pela segunda edição consecutiva, justamente porque é barata de tentar e difícil de fechar por completo. A injeção direta é um usuário digitando uma instrução para sobrepor o system prompt. A injeção indireta é pior para agents em particular: a instrução fica escondida em um documento, e-mail, ticket ou página da web que o agent é solicitado a processar, de modo que quem ataca o agent nunca precisa interagir diretamente com ele.
Privilégio Mínimo: Dê ao Agent Apenas as Ferramentas de que o Trabalho Dele Precisa
A decisão de segurança de maior alavancagem é também a mais tediosa: restrinja cada ferramenta ao menor acesso que permita ao agent fazer o seu trabalho real, nada além disso.
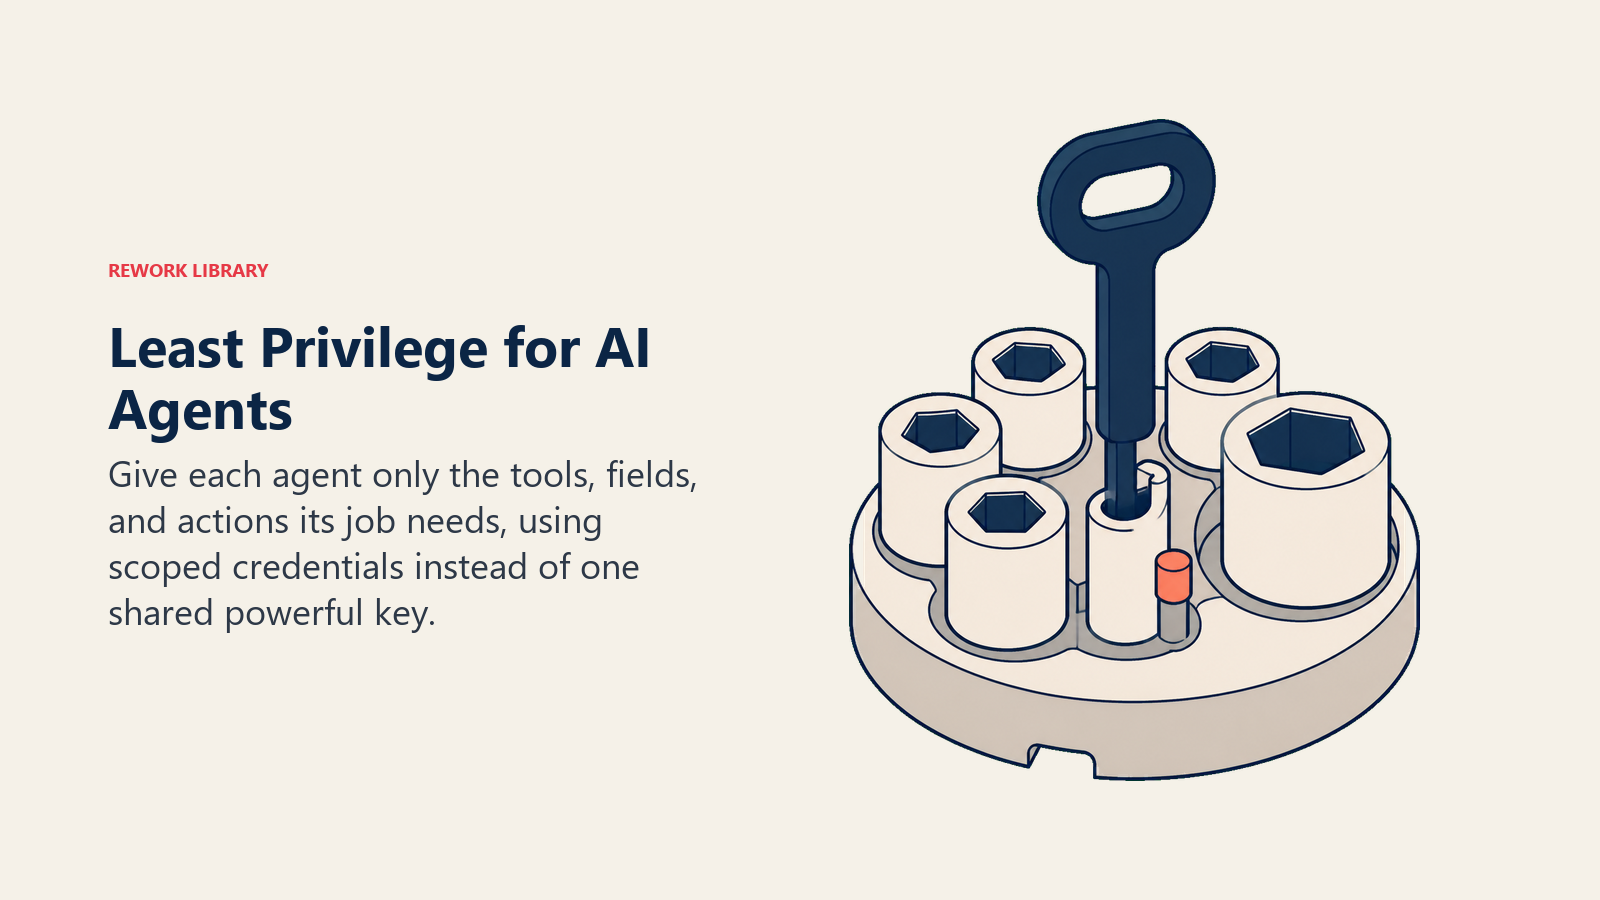
Na prática, isso significa que um agent de triagem de suporte recebe acesso de leitura aos tickets e um caminho de escrita estreito para atualizar o status do ticket, e não uma credencial permanente para todo o painel de administração do seu helpdesk. Significa que um agent de higiene de CRM pode editar campos específicos, mas não excluir registros. Significa que cada chamada de ferramenta roda sob o seu próprio token restrito, em vez de uma única chave de API compartilhada e poderosa que todos os agents da sua stack reutilizam, porque essa chave compartilhada transforma um agent comprometido em tudo comprometido.
É a mesma disciplina por trás do blueprint do AI Access Provisioning Agent, que existe justamente para checar cada pedido de acesso contra a política e sinalizar qualquer coisa que pareça escalonamento de privilégios, em vez de conceder por padrão. Aplique esse mesmo padrão às permissões do próprio agent, e não apenas às permissões que ele gerencia em nome de outras pessoas. Se você não daria a um novo contratado acesso permanente a tudo no primeiro dia, não dê isso a um agent também.
Sandboxing: Contendo o Que o Agent Pode Tocar
O privilégio mínimo limita o que um agent consegue alcançar. O sandboxing limita o que acontece se ele alcançar a coisa errada mesmo assim.
Alguns padrões práticos que valem a pena adotar:
- Faça um estágio antes de conceder acesso de escrita. Rode um novo agent em um modo em que ele propõe ações e um humano as aprova, e depois promova tipos específicos de ação de baixo risco para autônomos, quando você tiver visto que ele acerta de forma consistente.
- Limite gasto e taxa por tipo de ação. Um loop descontrolado ou um agent manipulado não consegue causar muito dano se tiver limite de taxa e teto de custo por execução.
- Separe ambientes para conteúdo não confiável. Um agent que resume um e-mail recebido não deveria rodar no mesmo contexto que tem acesso de escrita à folha de pagamento.
- Exija confirmação humana nas ações irreversíveis. Enviar uma comunicação externa, movimentar dinheiro e excluir um registro são exatamente os casos em que o custo de um falso positivo (perguntar a um humano sem necessidade) é muito menor do que o custo de um falso negativo (agir com base em uma instrução manipulada).
Este é o lado prático do que Requisitos de Governança por Pattern de AI descreve: os requisitos de governança devem acompanhar o risco, e o risco se concentra na etapa Execute. Um agent que só consegue redigir é um sandbox muito menor de proteger do que um que também consegue enviar, pagar e excluir.
Defendendo-se Especificamente de Prompt Injection
Como prompt injection é o risco de primeiro lugar no ranking, ela merece defesas próprias além do privilégio mínimo e do sandboxing.
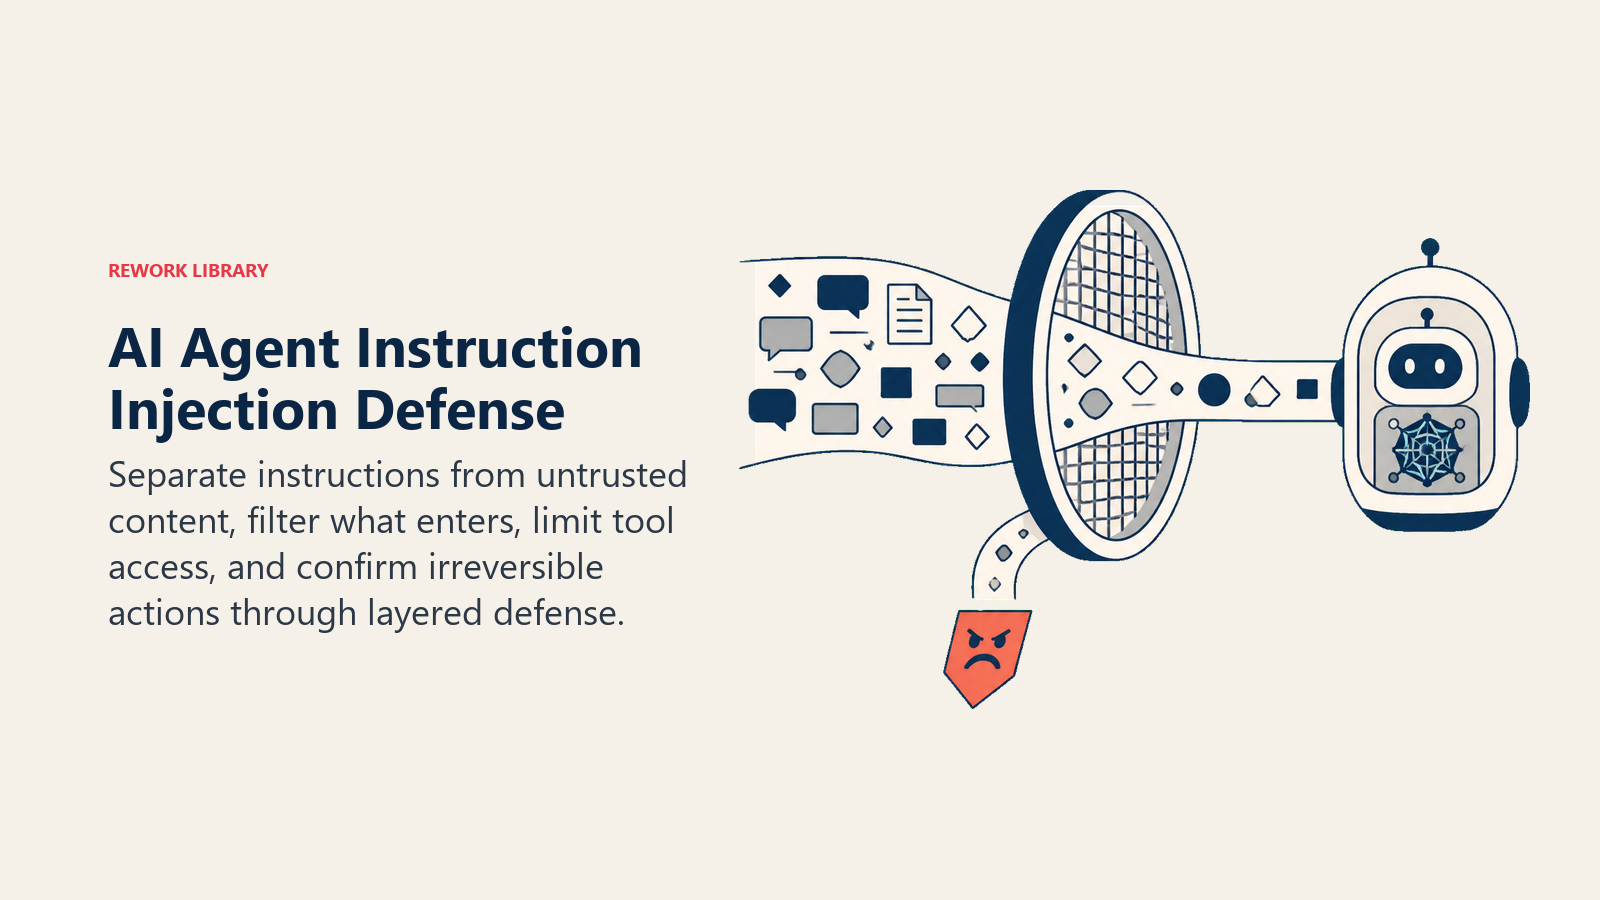
Separe o canal de instruções do canal de conteúdo sempre que a sua plataforma permitir, de modo que o texto extraído de um documento ou e-mail seja marcado estruturalmente como dado a avaliar, e não como comando a seguir. Trate tudo o que for recuperado de fora da sua organização, uma página coletada, uma mensagem recebida, um arquivo enviado, como não confiável por padrão, da mesma forma que uma aplicação web trata a entrada do usuário. Filtre e examine as entradas antes que cheguem ao modelo, entendendo que nenhum filtro pega todas as tentativas de um atacante determinado, e é por isso que esta é uma camada entre várias, e não a defesa inteira. E mantenha um humano no loop para os tipos específicos de ação em que uma injeção bem-sucedida causaria dano real, não para tudo, apenas para os casos irreversíveis ou de alto valor.
Nenhum controle isolado aqui é suficiente. Esse é o ponto. Defesa em profundidade, várias camadas mais fracas empilhadas em vez de uma única forte, é a abordagem aceita porque as falhas de segurança em agents tendem a passar por uma camada de cada vez.
Como É um Nível de Segurança Suficiente
O NIST AI Risk Management Framework organiza o trabalho de risco de AI em quatro funções: GOVERN, MAP, MEASURE e MANAGE. Aplicado a um agent, isso se traduz em uma checklist curta e concreta: governe quem pode aprovar novo acesso a ferramentas para um agent, mapeie a superfície real de ameaças de cada agent que você opera em vez de depender de uma política de AI genérica, meça continuamente o que o agent está fazendo em relação a esse modelo de ameaças e gerencie os incidentes com um plano de resposta de verdade, em vez de descobrir por um cliente.
A urgência aqui não é hipotética. A Gartner prevê que, até 2028, 25% das violações em empresas terão origem no abuso de AI agents, tanto por atacantes externos quanto por insiders mal-intencionados. Separadamente, a Gartner projeta que 25% das aplicações corporativas de AI generativa terão pelo menos cinco incidentes de segurança menores por ano até 2028, contra 9% em 2025. Os dois números apontam na mesma direção: à medida que os agents ganham mais acesso a ferramentas e mais autonomia, os incidentes crescem junto, não porque a tecnologia esteja piorando, mas porque a superfície de ataque cresce mais rápido do que os controles da maioria das equipes.
Key Facts
- A segurança de agents é um problema maior do que a segurança de modelos porque os agents agem, e não apenas geram. Um modelo enganado produz texto ruim; um agent enganado produz uma ação ruim.
- As três principais superfícies de ataque são prompt injection, exfiltração de dados e ferramentas com permissões em excesso. Prompt injection (OWASP LLM01) é o maior risco de LLM há duas edições consecutivas.
- Privilégio mínimo significa restringir cada ferramenta ao menor acesso que o trabalho real do agent exige, com seu próprio token, e não uma credencial compartilhada de poderes ilimitados.
- Sandboxing significa fazer um estágio do acesso de escrita, limitar gasto e taxa e exigir confirmação humana nas ações irreversíveis.
- A Gartner prevê que 25% das violações em empresas terão origem no abuso de AI agents até 2028, e que 25% das aplicações corporativas de GenAI terão cinco ou mais incidentes de segurança menores por ano até 2028, contra 9% em 2025.
Perguntas Frequentes sobre a Segurança de AI Agents
O que é segurança de AI agents?
A segurança de AI agents é o conjunto de práticas que impedem que um agent autônomo seja manipulado, receba permissões em excesso ou seja explorado para executar ações prejudiciais. Ela abrange a modelagem de ameaças do acesso do agent às ferramentas, a aplicação de privilégio mínimo, o sandboxing do que ele pode tocar e a defesa específica contra prompt injection.
Qual é o maior risco de segurança para AI agents?
Prompt injection, em que instruções escondidas em conteúdo que o agent processa sobrepõem a tarefa real dele. Ela ocupa o primeiro lugar (LLM01) no OWASP Top 10 para Aplicações de LLM há duas edições consecutivas, e é especialmente perigosa para agents porque uma injeção bem-sucedida pode disparar uma ação real, e não apenas uma resposta ruim.
O que significa privilégio mínimo para um AI agent?
Significa dar a um agent apenas o acesso a ferramentas que o trabalho específico dele exige, restrito da forma mais estreita possível, com credenciais próprias em vez de uma chave de API compartilhada e poderosa. Um agent de suporte que pode atualizar o status de um ticket não deveria também ter acesso de exclusão a todo o seu helpdesk.
O que é sandboxing para AI agents?
O sandboxing limita o dano se um agent for manipulado apesar dos seus outros controles: fazer um estágio do acesso de escrita com aprovação humana antes de concedê-lo de forma autônoma, limitar gasto e taxa de chamadas por tipo de ação e exigir confirmação antes de ações irreversíveis, como enviar comunicação externa ou excluir registros.
Como se defender de prompt injection?
Nenhuma defesa isolada é suficiente. Combine a separação entre instruções e conteúdo não confiável, o tratamento de conteúdo recuperado ou recebido como dado e não como comando, a filtragem de entradas, o acesso a ferramentas com privilégio mínimo e a confirmação humana em ações de alta consequência. A defesa em profundidade pega o que qualquer camada isolada deixa passar.
Para Onde Ir a Seguir
A segurança diz que um agent não pode ser enganado com facilidade para agir de forma errada. Observabilidade de AI agents diz se ele está agindo de forma errada mesmo assim, já que até um agent bem protegido pode sofrer drift, e você precisa conseguir enxergar isso. Para ver de forma concreta como esses controles aparecem em um design real, os blueprints do AI Security Monitoring Agent e do AI Access Provisioning Agent embutem a lógica de privilégio mínimo e aprovação humana no núcleo do design, em vez de acrescentá-la depois do lançamento.

On this page
- Por Que Proteger um Agent É um Problema Maior do que Proteger um Modelo
- O Modelo de Ameaças de um Agent: Três Lugares Onde os Ataques Acontecem
- Privilégio Mínimo: Dê ao Agent Apenas as Ferramentas de que o Trabalho Dele Precisa
- Sandboxing: Contendo o Que o Agent Pode Tocar
- Defendendo-se Especificamente de Prompt Injection
- Como É um Nível de Segurança Suficiente
- Key Facts
- Para Onde Ir a Seguir