Seguridad de los AI agents: guía práctica
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
La seguridad de los AI agents es la disciplina que evita que un agent autónomo sea engañado, reciba más permisos de los necesarios o se convierta en una herramienta para un atacante: modelar las amenazas de lo que puede alcanzar, aplicar mínimo privilegio en cada herramienta que posee, aislar con sandboxing lo que se le permite tocar y validar lo que entra y sale de él. Importa más que la seguridad general de AI porque un agent no solo genera texto riesgoso, sino que actúa. Un modelo engañado produce una frase equivocada. Un agent engañado, por lo general, ya actuó en consecuencia.
Por qué proteger un agent es un problema mayor que proteger un modelo
La seguridad de AI abarca las categorías de amenazas que se aplican a cualquier sistema de AI: entradas adversarias que empujan a un modelo hacia el resultado equivocado, envenenamiento de datos que corrompe el entrenamiento, prompt injection que secuestra las instrucciones, robo de modelos e inversión de modelos. Todas ellas siguen aplicándose a un agent, porque por debajo un agent está construido sobre un modelo. Lo que cambia es lo que ocurre después de que el modelo es engañado.
El ACE Framework de Rework traza una línea clara entre dos de sus capacidades: Generate y Execute. Generar un borrador de respuesta tiene poco riesgo; un mal borrador simplemente se elimina antes de que alguien lo vea. Ejecutar esa acción, es decir, enviarla de verdad, actualizar un registro o emitir un reembolso, es donde están las consecuencias. Un chatbot común vive sobre todo del lado Generate de esa línea. Un agent, por definición, la cruza. Por eso existen los componentes básicos de Tools y Guardrails descritos en cómo funcionan los AI agents: las Tools definen el techo de lo que un agent puede hacer, y los Guardrails definen lo que nunca debe hacer, sin importar lo que se le indique. La seguridad es lo que mantiene a ambos firmes cuando alguien intenta activamente romperlos.
El modelo de amenazas de un agent: tres lugares donde aterrizan los ataques
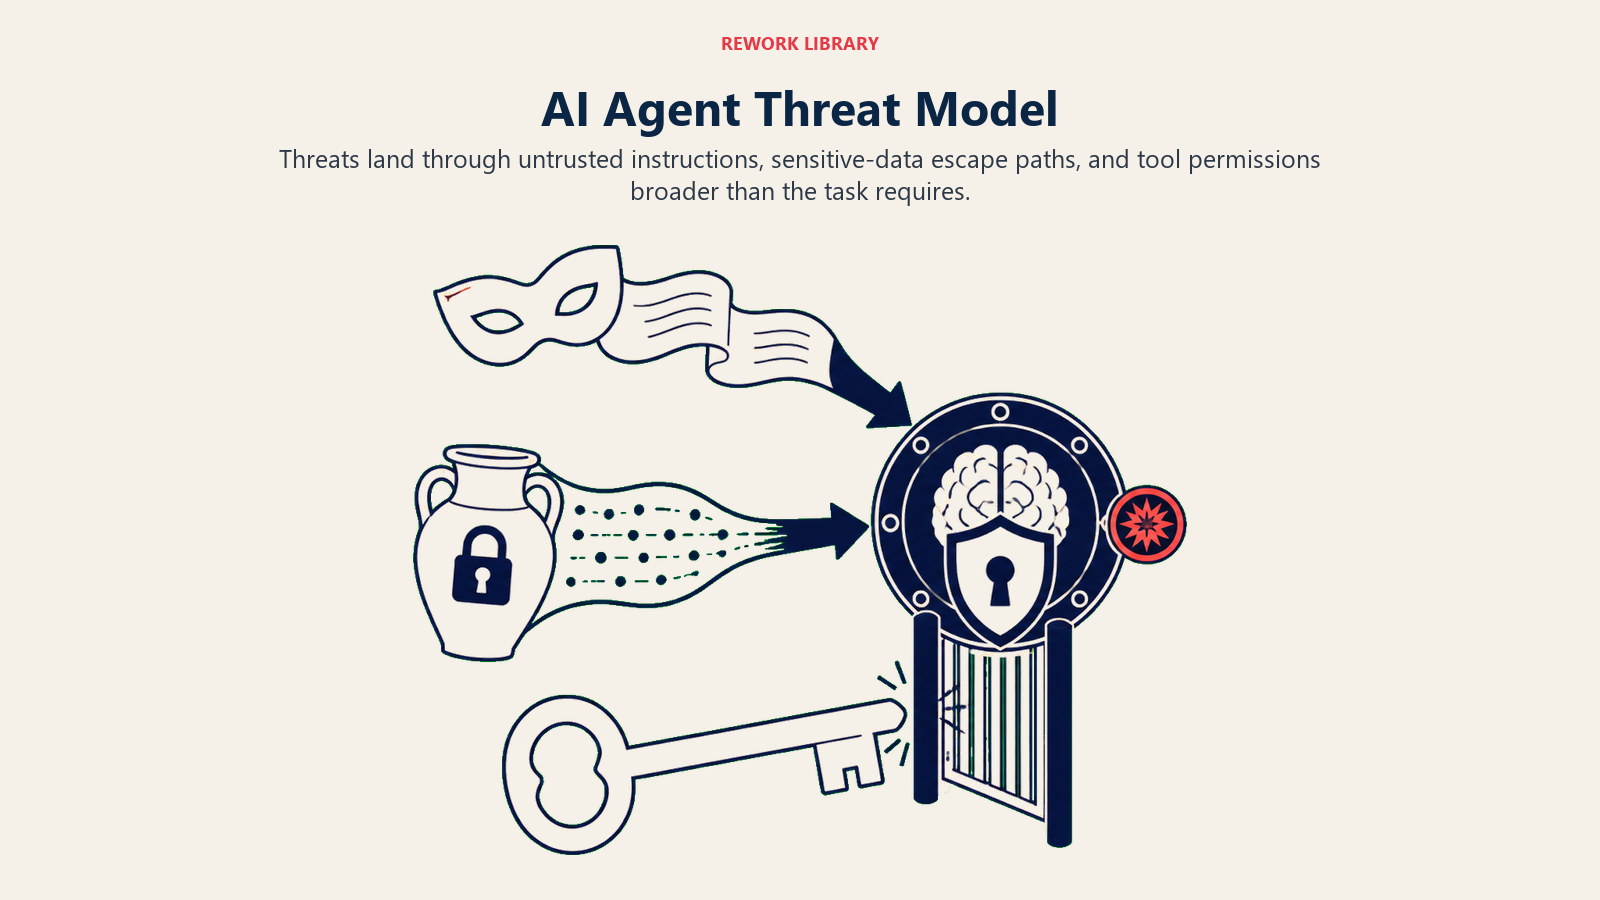
La mayoría de los incidentes de seguridad de los agents se remonta a una de tres superficies.
| Superficie | Qué ocurre | Por qué los agents están expuestos |
|---|---|---|
| Prompt injection | Instrucciones ocultas en el contenido que lee el agent anulan su tarea real | Los agents leen contenido no confiable por diseño: correos, tickets, documentos, páginas web, datos extraídos |
| Exfiltración de datos | Se manipula al agent para que incluya datos sensibles en una salida, una llamada a una herramienta o un mensaje a un tercero | Los agents suelen tener acceso de lectura amplio a sistemas de CRM, soporte o finanzas para hacer su trabajo |
| Herramientas con permisos excesivos | Una sola manipulación exitosa se propaga en cascada porque el acceso del agent a las herramientas es más amplio de lo que necesita su tarea real | Los equipos suelen otorgar una única credencial de integración amplia en lugar de acotar el acceso por tarea |
El prompt injection es el que hay que tomar más en serio. Ocupa el primer puesto, LLM01, en el OWASP Top 10 for LLM Applications, por segunda edición consecutiva, precisamente porque es barato de intentar y difícil de cerrar por completo. La inyección directa es un usuario que escribe una instrucción pensada para anular el system prompt. La inyección indirecta es peor para los agents en particular: la instrucción está oculta en un documento, correo, ticket o página web que se le pide procesar al agent, de modo que quien ataca al agent nunca necesita interactuar con él directamente.
Mínimo privilegio: dé al agent solo las herramientas que su trabajo necesita
La decisión de seguridad de mayor impacto es también la más aburrida: acotar cada herramienta al acceso más estrecho que permita al agent hacer su trabajo real, y nada más.
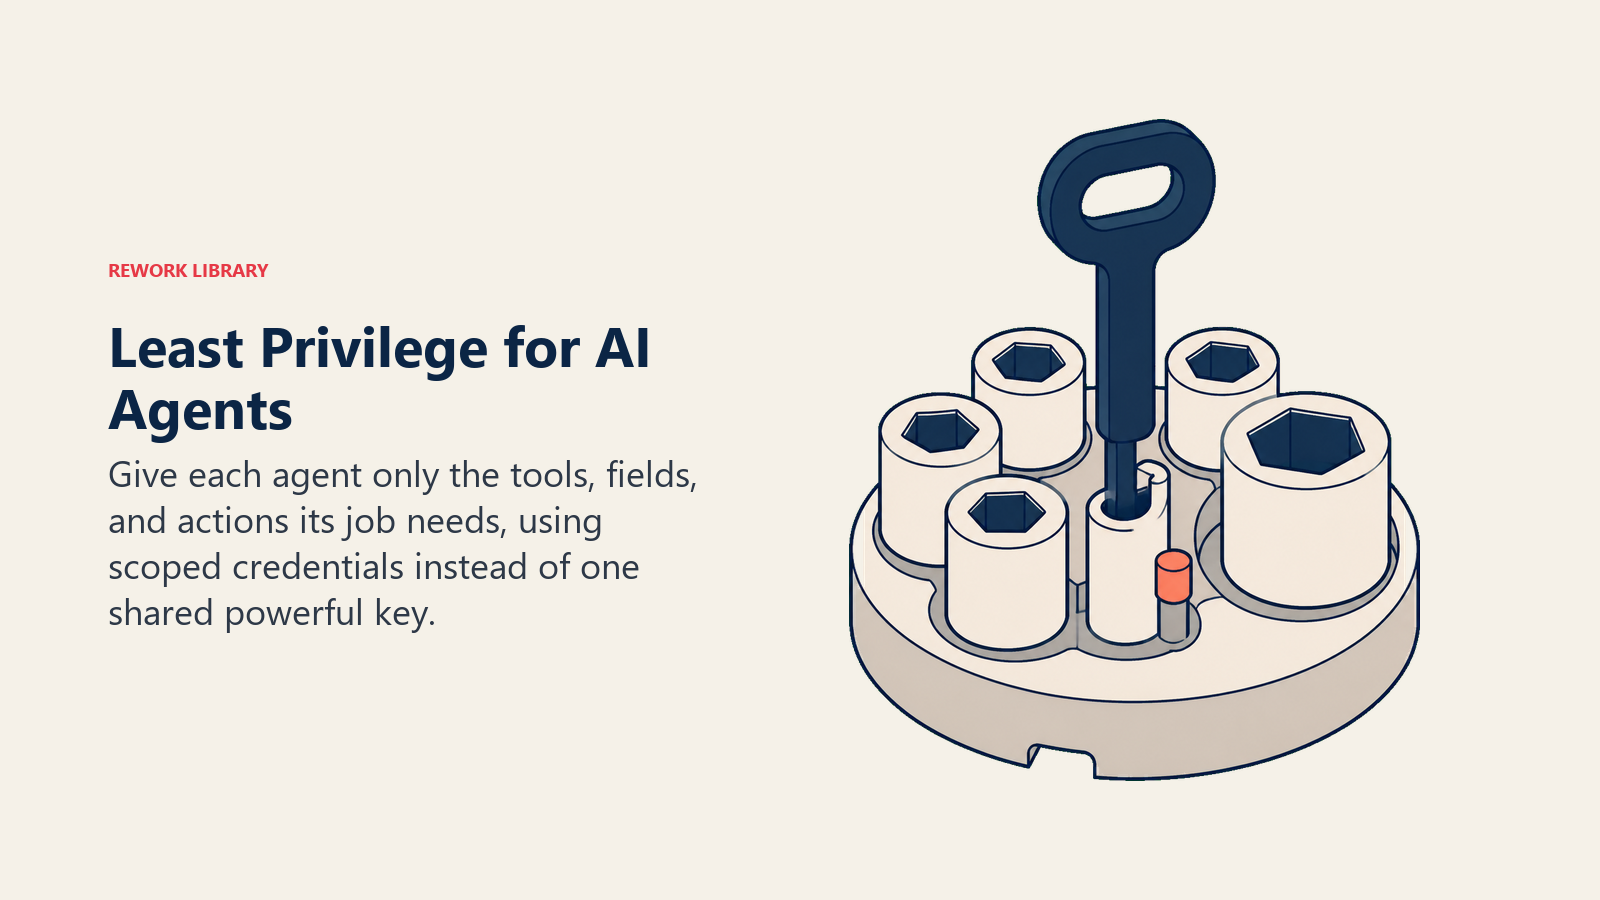
En la práctica, eso significa que un agent de triaje de soporte recibe acceso de lectura a los tickets y una vía de escritura estrecha para actualizar el estado del ticket, no una credencial permanente para todo el panel de administración de su helpdesk. Significa que un agent de higiene de CRM puede editar campos específicos, pero no eliminar registros. Significa que cada llamada a una herramienta se ejecuta con su propio token acotado, en lugar de una única API key poderosa y compartida que reutiliza cada agent de su stack, porque esa clave compartida convierte a un agent comprometido en todo comprometido.
Es la misma disciplina que respalda el plan de construcción del AI Access Provisioning Agent, que existe precisamente para comparar cada solicitud de acceso con la política y señalar cualquier cosa que parezca una escalada de privilegios en lugar de concederla por defecto. Aplique ese mismo estándar a los permisos del propio agent, no solo a los permisos que gestiona en nombre de otras personas. Si no daría a un nuevo empleado acceso permanente a todo desde el primer día, tampoco se lo dé a un agent.
Sandboxing: contener lo que el agent puede tocar
El mínimo privilegio limita lo que un agent puede alcanzar. El sandboxing limita lo que ocurre si de todos modos alcanza lo que no debe.
Algunos patrones prácticos que vale la pena adoptar:
- Pase por una etapa previa antes de conceder acceso de escritura. Ejecute un agent nuevo en un modo en que proponga acciones y una persona las apruebe, y luego promueva a autónomos tipos de acción específicos y de bajo riesgo una vez que haya comprobado que los realiza bien de forma consistente.
- Limite el gasto y la frecuencia por tipo de acción. Un bucle descontrolado o un agent manipulado no puede causar mucho daño si tiene límite de frecuencia y tope de costo por ejecución.
- Separe los entornos para el contenido no confiable. Un agent que resume un correo entrante no debería ejecutarse en el mismo contexto que tiene acceso de escritura a la nómina.
- Exija confirmación humana en las acciones irreversibles. Enviar una comunicación externa, mover dinero y eliminar un registro son justamente los casos en que el costo de un falso positivo (consultar a una persona sin necesidad) es mucho menor que el costo de un falso negativo (actuar según una instrucción manipulada).
Este es el lado práctico de lo que describe los requisitos de gobernanza por patrón de AI: los requisitos de gobernanza deben seguir al riesgo, y el riesgo se concentra en el paso Execute. Un agent que solo puede redactar es un sandbox mucho más pequeño de proteger que uno que además puede enviar, pagar y eliminar.
Defensa específica contra el prompt injection
Dado que el prompt injection es el riesgo mejor clasificado, merece sus propias defensas más allá del mínimo privilegio y el sandboxing.
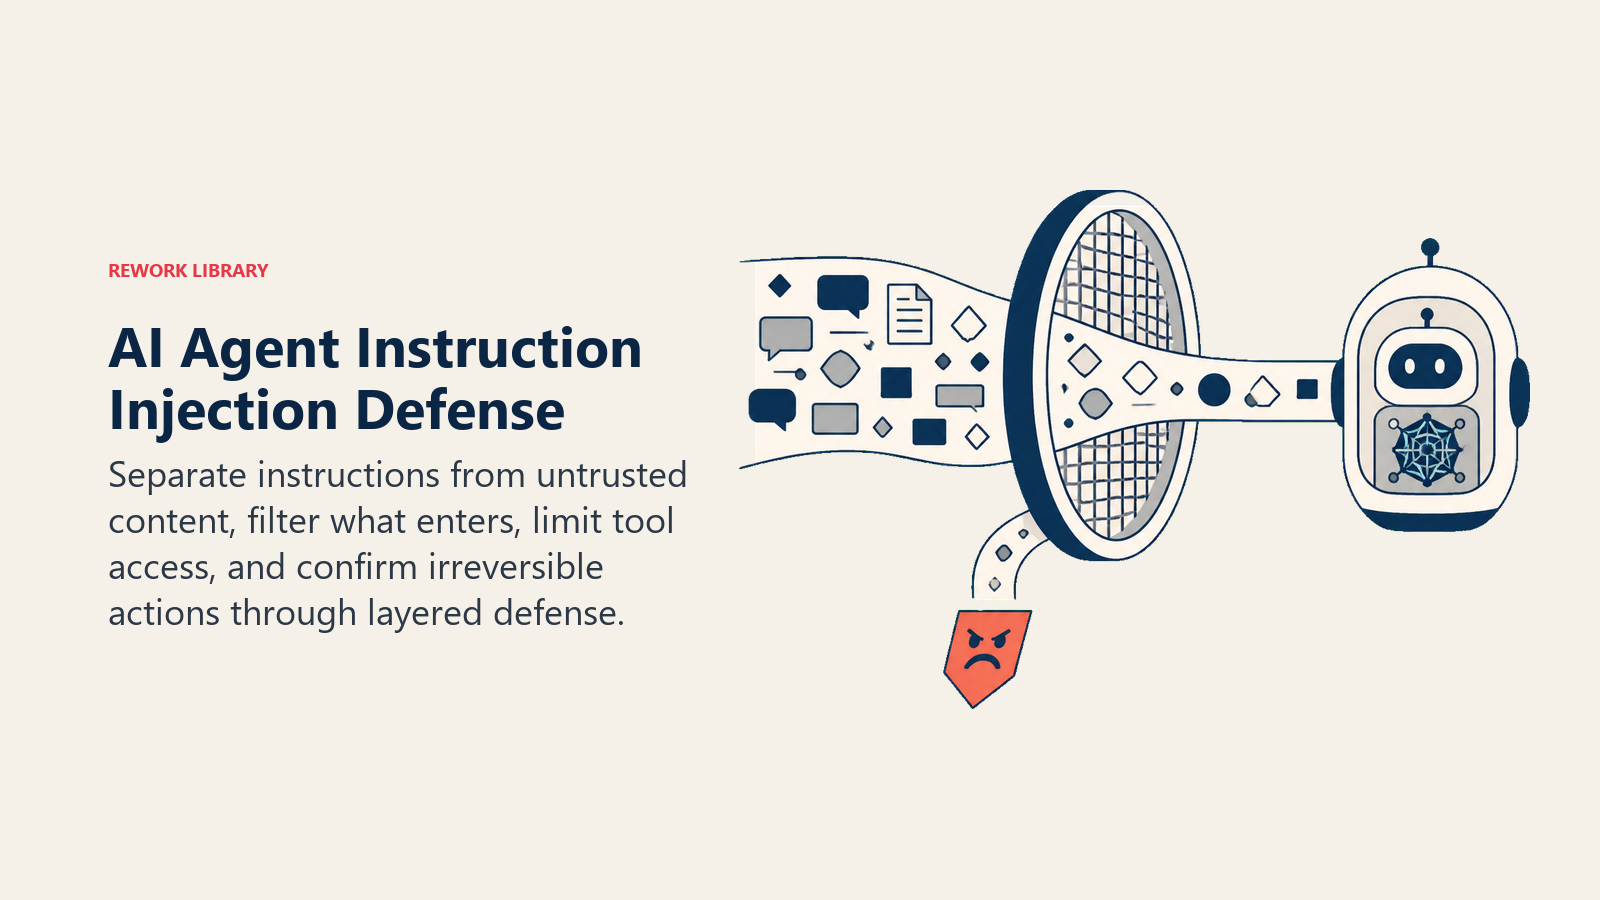
Separe el canal de instrucciones del canal de contenido siempre que su plataforma lo permita, de modo que el texto extraído de un documento o correo esté marcado estructuralmente como datos que evaluar, no como comandos que seguir. Trate todo lo recuperado desde fuera de su organización, una página extraída, un mensaje entrante, un archivo cargado, como no confiable por defecto, igual que una aplicación web trata la entrada del usuario. Filtre y revise las entradas antes de que lleguen al modelo, sabiendo que ningún filtro detiene todos los intentos de un atacante decidido, por lo que esta es una capa entre varias, no la defensa completa. Y mantenga una intervención humana en los tipos de acción específicos en los que una inyección exitosa causaría un daño real: no en todo, solo en los casos irreversibles o de alto valor.
Ningún control aislado es suficiente por sí solo. Ese es el punto. La defensa en profundidad, varias capas más débiles apiladas en lugar de una sola fuerte, es el enfoque aceptado porque los fallos de seguridad de los agents tienden a atravesar una sola capa a la vez.
Qué significa "suficientemente seguro"
El NIST AI Risk Management Framework organiza el trabajo sobre riesgos de AI en cuatro funciones: GOVERN, MAP, MEASURE y MANAGE. Aplicado a un agent, eso se traduce en una lista de verificación breve y concreta: gobierne quién puede aprobar nuevo acceso a herramientas para un agent, mapee la superficie de amenazas real de cada agent que ejecuta en lugar de depender de una política genérica de AI, mida de forma continua lo que hace el agent frente a ese modelo de amenazas y gestione los incidentes con un plan de respuesta real en lugar de enterarse por un cliente.
La urgencia no es hipotética. Gartner prevé que para 2028, el 25% de las brechas empresariales se originará en el abuso de AI agents, tanto por atacantes externos como por personas internas malintencionadas. Por separado, Gartner pronostica que el 25% de las aplicaciones empresariales de generative AI sufrirá al menos cinco incidentes de seguridad menores al año para 2028, frente al 9% en 2025. Ambas cifras apuntan en la misma dirección: a medida que los agents obtienen más acceso a herramientas y más autonomía, los incidentes escalan con ellos, no porque la tecnología empeore, sino porque la superficie de ataque crece más rápido que los controles de la mayoría de los equipos.
Datos clave
- La seguridad de un agent es un problema mayor que la seguridad de un modelo porque los agents actúan, no solo generan. Un modelo engañado produce texto malo; un agent engañado produce una acción mala.
- Las tres superficies de ataque principales son el prompt injection, la exfiltración de datos y las herramientas con permisos excesivos. El prompt injection (OWASP LLM01) ha encabezado la lista de riesgos de LLM durante dos ediciones consecutivas.
- Mínimo privilegio significa acotar cada herramienta al acceso más estrecho que necesita el trabajo real del agent, con su propio token, no una credencial compartida con permisos totales.
- Sandboxing significa pasar por una etapa previa antes de conceder acceso de escritura, limitar el gasto y la frecuencia, y exigir confirmación humana en las acciones irreversibles.
- Gartner prevé que el 25% de las brechas empresariales se originará en el abuso de AI agents para 2028, y que el 25% de las aplicaciones empresariales de GenAI tendrá cinco o más incidentes de seguridad menores al año para 2028, frente al 9% en 2025.
Preguntas frecuentes sobre la seguridad de los AI agents
¿Qué es la seguridad de los AI agents?
La seguridad de los AI agents es el conjunto de prácticas que evitan que un agent autónomo sea manipulado, reciba permisos excesivos o sea explotado para realizar acciones dañinas. Abarca el modelado de amenazas del acceso del agent a herramientas, la aplicación del mínimo privilegio, el sandboxing de lo que puede tocar y la defensa específica contra el prompt injection.
¿Cuál es el mayor riesgo de seguridad de los AI agents?
El prompt injection, en el que instrucciones ocultas en el contenido que procesa el agent anulan su tarea real. Ha ocupado el primer puesto (LLM01) en el OWASP Top 10 for LLM Applications durante dos ediciones consecutivas, y es especialmente peligroso para los agents porque una inyección exitosa puede desencadenar una acción real, no solo una mala respuesta.
¿Qué significa mínimo privilegio para un AI agent?
Significa dar a un agent solo el acceso a herramientas que su trabajo específico requiere, acotado lo más posible, con sus propias credenciales en lugar de una API key poderosa y compartida. Un agent de soporte que puede actualizar el estado de un ticket no debería tener además permiso para eliminar todo su helpdesk.
¿Qué es el sandboxing para AI agents?
El sandboxing limita el daño si un agent es manipulado a pesar de sus demás controles: pasa por una etapa de aprobación humana antes de conceder acceso de escritura de forma autónoma, limita el gasto y la frecuencia de llamadas por tipo de acción, y exige confirmación antes de acciones irreversibles como enviar comunicaciones externas o eliminar registros.
¿Cómo se defiende uno contra el prompt injection?
Ninguna defensa aislada es suficiente. Combine la separación entre instrucciones y contenido no confiable, el tratamiento del contenido recuperado o entrante como datos y no como comandos, el filtrado de entradas, el acceso a herramientas con mínimo privilegio y la confirmación humana en acciones de alta consecuencia. La defensa en profundidad atrapa lo que una sola capa deja pasar.
A dónde ir a continuación
La seguridad le dice que un agent no puede ser engañado fácilmente para actuar mal. La observabilidad de los AI agents le dice si está actuando mal de todos modos, ya que incluso un agent bien protegido puede desviarse, y usted necesita poder verlo. Para ver con detalle cómo se reflejan estos controles en un diseño real, los planes de construcción del AI Security Monitoring Agent y del AI Access Provisioning Agent incorporan la lógica de mínimo privilegio y aprobación humana en su diseño central, en lugar de añadirla después del lanzamiento.

On this page
- Por qué proteger un agent es un problema mayor que proteger un modelo
- El modelo de amenazas de un agent: tres lugares donde aterrizan los ataques
- Mínimo privilegio: dé al agent solo las herramientas que su trabajo necesita
- Sandboxing: contener lo que el agent puede tocar
- Defensa específica contra el prompt injection
- Qué significa "suficientemente seguro"
- Datos clave
- A dónde ir a continuación