Keselamatan AI Agent: Panduan Praktikal
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Keselamatan AI agent ialah disiplin untuk menghalang agent autonomi daripada diperdaya, diberi kebenaran berlebihan, atau dijadikan alat penyerang: memodelkan ancaman pada apa yang boleh dicapainya, menguatkuasakan hak akses minimum pada setiap alat yang dipegangnya, mengasingkan apa yang dibenarkan untuk disentuhnya, dan mengesahkan apa yang masuk dan keluar daripadanya. Ia lebih penting daripada keselamatan AI umum kerana agent bukan sekadar menjana teks yang berisiko, ia mengambil tindakan. Model yang diperdaya menghasilkan satu ayat yang buruk. Agent yang diperdaya biasanya sudah pun bertindak berdasarkannya.
Sebab Mengamankan Agent Masalah yang Lebih Besar daripada Mengamankan Model
Keselamatan AI merangkumi kategori ancaman yang terpakai pada mana-mana sistem AI: input musuh yang menolak model ke arah output yang salah, peracunan data yang merosakkan latihan, prompt injection yang merampas arahan, kecurian model, dan penyongsangan model. Setiap satunya masih terpakai pada agent, kerana agent dibina atas model di bawahnya. Yang berubah ialah apa yang berlaku selepas model diperdaya.
ACE Framework Rework menarik garis tegas antara dua keupayaannya: Generate dan Execute. Menjana draf balasan berisiko rendah; draf yang buruk hanya dipadam sebelum sesiapa melihatnya. Melaksanakan tindakan itu, iaitu benar-benar menghantarnya, mengemas kini rekod, mengeluarkan bayaran balik, ialah tempat akibat wujud. Chatbot biasa kebanyakannya berada di sebelah Generate pada garis itu. Agent, mengikut definisinya, melintasinya. Itulah sebabnya blok binaan Alat dan Pagar Pelindung dalam cara AI agent berfungsi wujud: Alat menetapkan siling pada apa yang boleh dilakukan agent, dan Pagar Pelindung menetapkan apa yang tidak boleh sekali-kali dilakukannya walau apa pun yang disuruh. Keselamatan ialah apa yang memastikan kedua-duanya kekal teguh apabila ada pihak yang sedang cuba memecahkannya.
Model Ancaman Agent: Tiga Tempat Serangan Mendarat
Kebanyakan insiden keselamatan agent berpunca daripada salah satu daripada tiga permukaan.
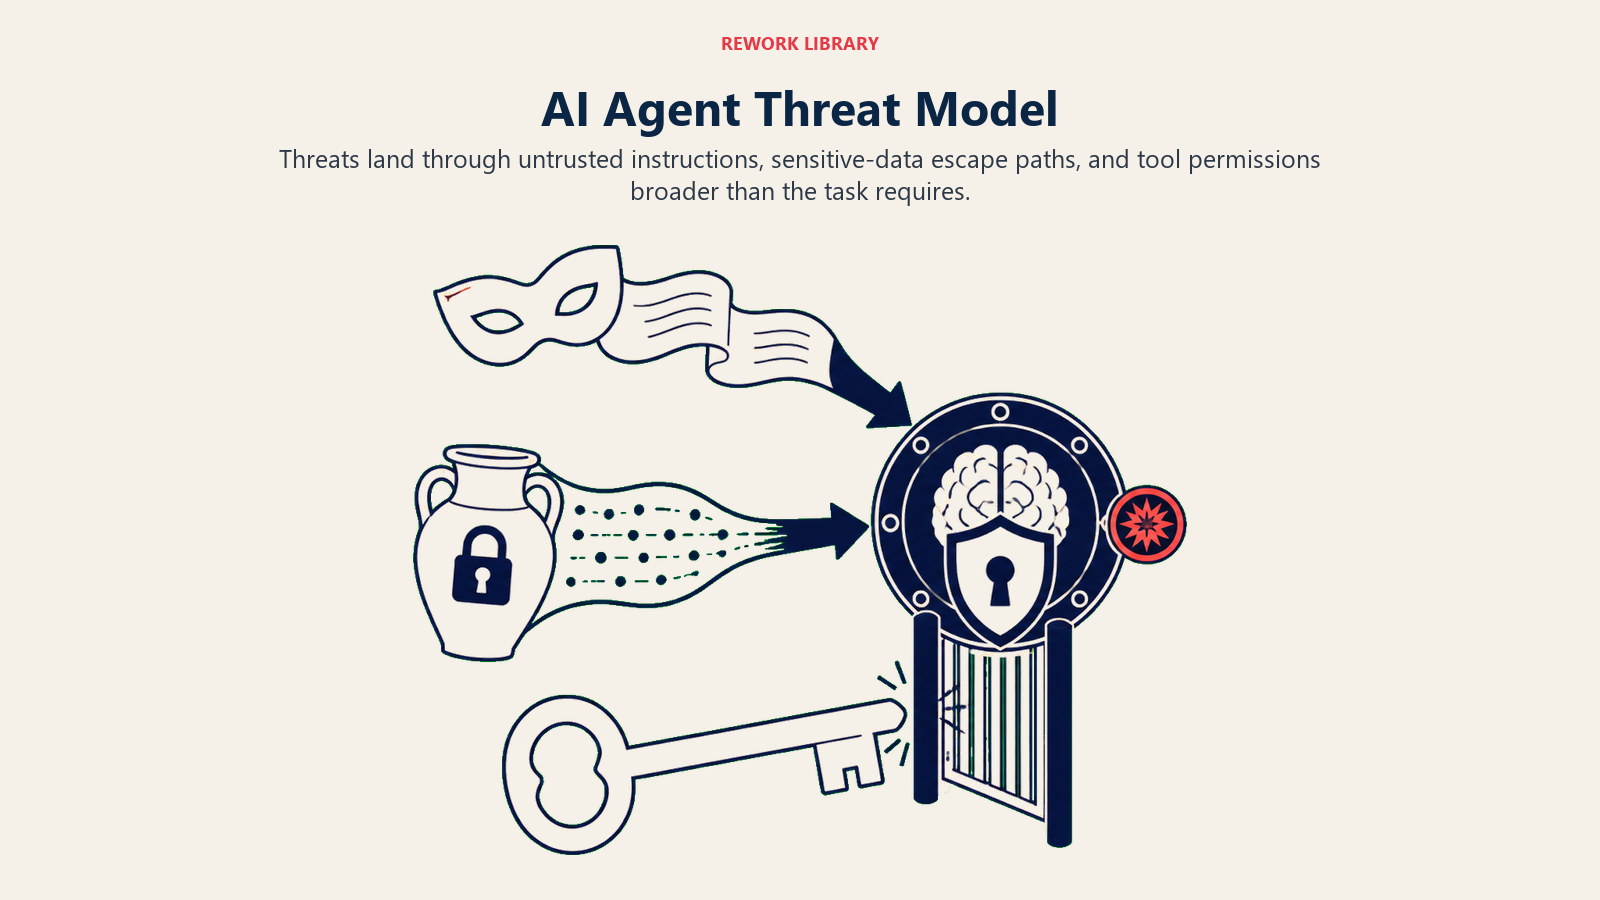
| Permukaan | Apa yang berlaku | Sebab agent terdedah |
|---|---|---|
| Prompt injection | Arahan yang tersembunyi dalam kandungan yang dibaca agent mengatasi tugas sebenarnya | Agent membaca kandungan yang tidak dipercayai secara reka bentuk: e-mel, tiket, dokumen, halaman web, data yang dikikis |
| Pemindahan data haram | Agent dimanipulasi untuk memasukkan data sensitif dalam output, panggilan alat, atau mesej kepada pihak luar | Agent sering mempunyai akses baca yang luas kepada sistem CRM, sokongan, atau kewangan untuk menjalankan tugasnya |
| Alat yang diberi kebenaran berlebihan | Satu manipulasi yang berjaya merebak kerana akses alat agent lebih luas daripada keperluan tugasnya | Pasukan sering memberi satu kredensial integrasi yang luas dan bukan mengehadkan akses mengikut tugasan |
Prompt injection ialah yang paling wajar diambil serius. Ia menduduki tempat teratas, LLM01, dalam OWASP Top 10 untuk Aplikasi LLM untuk edisi berturut-turut yang kedua, justeru kerana ia murah untuk dicuba dan sukar ditutup sepenuhnya. Suntikan langsung ialah pengguna menaip arahan yang bertujuan mengatasi system prompt. Suntikan tidak langsung lebih buruk khusus untuk agent: arahan itu tersembunyi dalam dokumen, e-mel, tiket, atau halaman web yang diminta agent proses, jadi pihak yang menyerang agent itu langsung tidak perlu berinteraksi dengannya secara terus.
Hak Akses Minimum: Beri Agent Hanya Alat yang Diperlukan Tugasnya
Keputusan keselamatan yang paling tinggi pengaruhnya juga yang paling membosankan: hadkan setiap alat kepada akses tersempit yang membolehkan agent menjalankan tugas sebenarnya, tidak lebih.
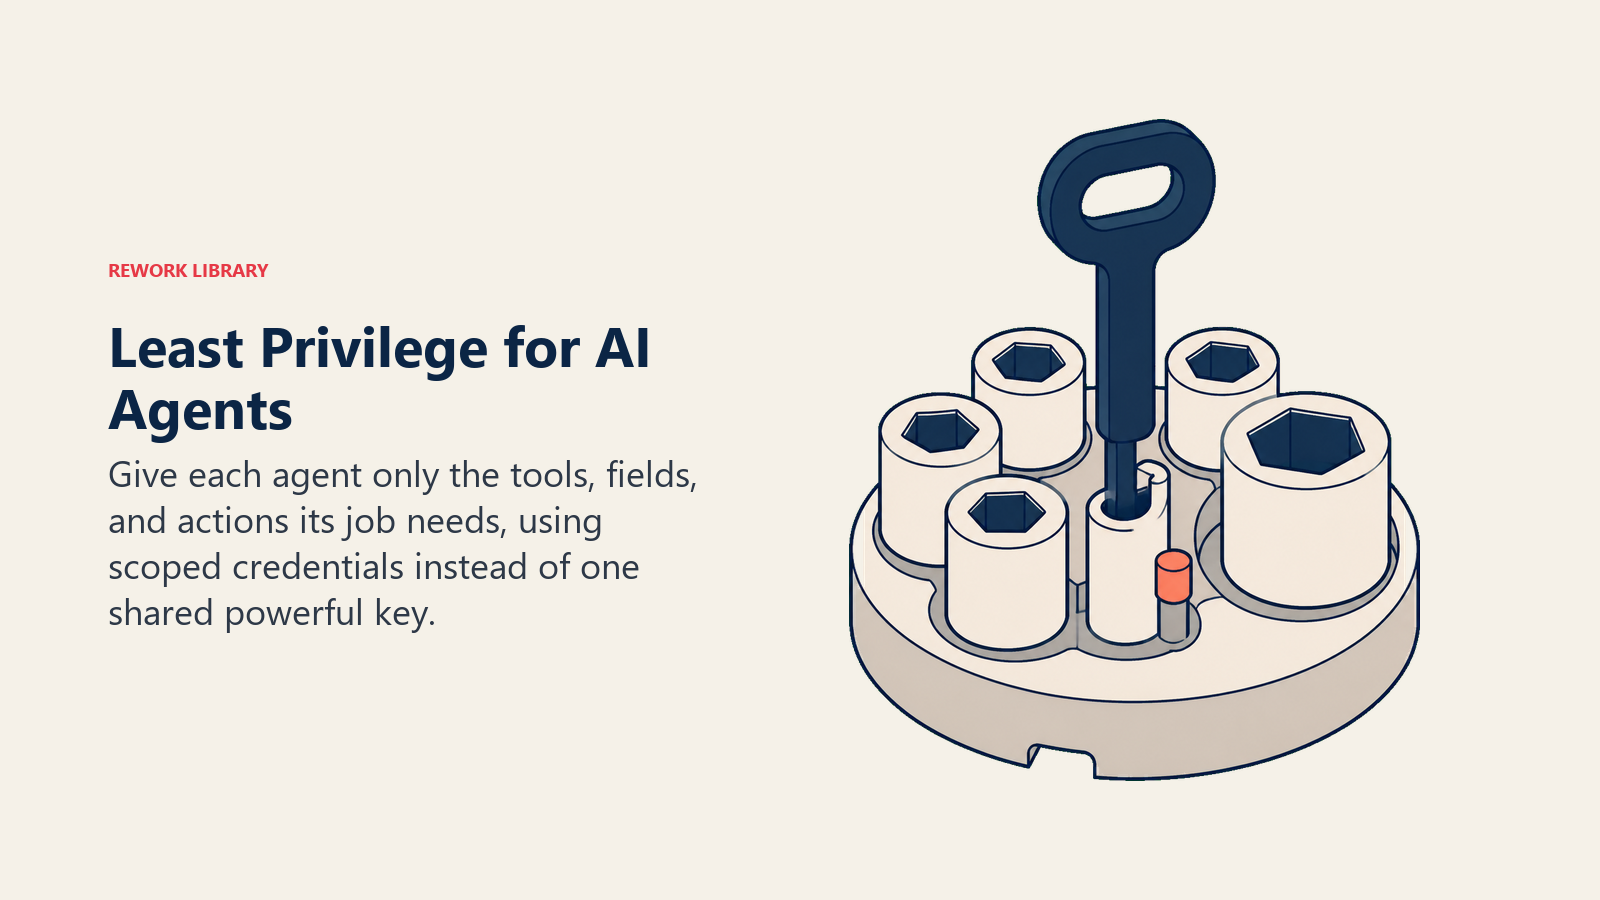
Dalam amalan, ini bermakna agent triage sokongan mendapat akses baca kepada tiket dan laluan tulis yang sempit untuk mengemas kini status tiket, bukan kredensial tetap kepada keseluruhan panel pentadbir helpdesk anda. Ia bermakna agent kebersihan CRM boleh menyunting medan tertentu, bukan memadam rekod. Ia bermakna setiap panggilan alat berjalan di bawah token berskopnya sendiri dan bukan satu kunci API yang berkuasa dan dikongsi, yang digunakan semula oleh setiap agent dalam tindanan anda, kerana kunci kongsi itu menjadikan satu agent yang terjejas sebagai semuanya terjejas.
Ini disiplin yang sama di sebalik pelan AI Access Provisioning Agent, yang wujud khusus untuk menyemak setiap permintaan akses berbanding dasar dan menandai apa-apa yang kelihatan seperti peningkatan keistimewaan dan bukan memberikannya secara lalai. Terapkan piawaian yang sama pada kebenaran agent itu sendiri, bukan hanya kebenaran yang diuruskannya bagi pihak orang lain. Jika anda tidak akan memberi pekerja baharu akses tetap kepada segala-galanya pada hari pertama, jangan beri kepada agent juga.
Sandboxing: Mengekang Apa yang Boleh Disentuh Agent
Hak akses minimum mengehadkan apa yang boleh dicapai agent. Sandboxing mengehadkan apa yang berlaku jika ia tetap mencapai sesuatu yang salah.
Beberapa corak praktikal yang wajar diamalkan:
- Pentaskan sebelum memberi akses tulis. Jalankan agent baharu dalam mod di mana ia mencadangkan tindakan tetapi manusia meluluskannya, kemudian naikkan jenis tindakan tertentu yang berisiko rendah kepada autonomi setelah anda memerhatikannya melakukannya dengan betul secara konsisten.
- Hadkan perbelanjaan dan kadar bagi setiap jenis tindakan. Gelung tidak terkawal atau agent yang dimanipulasi tidak boleh menyebabkan banyak kerosakan jika kadarnya dihadkan dan kosnya dihadkan bagi setiap larian.
- Asingkan persekitaran untuk kandungan yang tidak dipercayai. Agent yang meringkaskan e-mel masuk tidak patut berjalan dalam konteks yang sama dengan yang memegang akses tulis kepada gaji.
- Perlukan pengesahan manusia pada tindakan yang tidak boleh diundurkan. Menghantar komunikasi luar, memindahkan wang, dan memadam rekod tepat sekali kes di mana kos positif palsu (bertanya kepada manusia tanpa perlu) jauh lebih rendah daripada kos negatif palsu (bertindak atas arahan yang dimanipulasi).
Ini sisi praktikal apa yang diterangkan oleh Keperluan Tadbir Urus mengikut Corak AI: keperluan tadbir urus patut mengikut risiko, dan risiko tertumpu pada langkah Execute. Agent yang hanya boleh menggubal draf ialah sandbox yang jauh lebih kecil untuk diamankan berbanding agent yang juga boleh menghantar, membayar, dan memadam.
Bertahan daripada Prompt Injection Secara Khusus
Oleh kerana prompt injection ialah risiko berkedudukan teratas, ia wajar mempunyai pertahanan sendiri di luar hak akses minimum dan sandboxing.
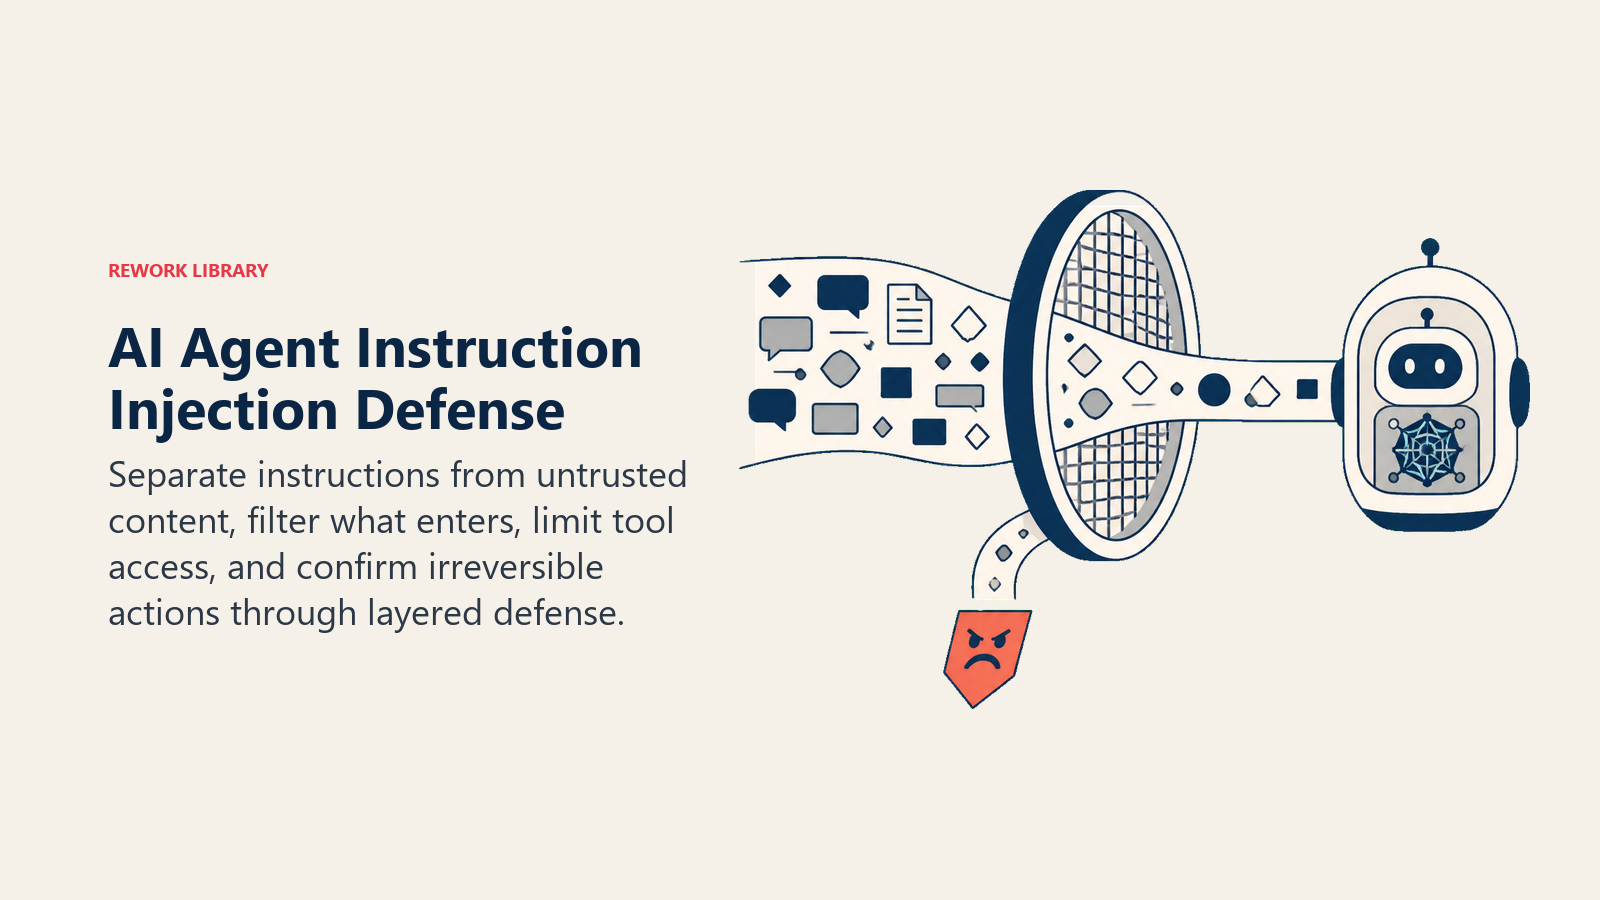
Asingkan saluran arahan daripada saluran kandungan di mana-mana platform anda membenarkan, supaya teks yang ditarik daripada dokumen atau e-mel ditandai secara struktur sebagai data untuk dinilai, bukan arahan untuk diikuti. Anggap segala yang diambil dari luar organisasi anda, halaman yang dikikis, mesej masuk, fail yang dimuat naik, sebagai tidak dipercayai secara lalai, sama seperti aplikasi web melayan input pengguna. Tapis dan saring input sebelum ia sampai ke model, dengan memahami bahawa tiada penapis yang menangkap setiap percubaan penyerang yang bertekad, itulah sebabnya ini satu lapisan antara beberapa lapisan, bukan keseluruhan pertahanan. Dan kekalkan manusia dalam gelung untuk jenis tindakan tertentu di mana suntikan yang berjaya akan menyebabkan kerosakan sebenar, bukan untuk semua perkara, hanya kes yang tidak boleh diundurkan atau bernilai tinggi.
Tiada satu kawalan pun di sini mencukupi sendirian. Itulah maksudnya. Pertahanan berlapis, beberapa lapisan yang lebih lemah disusun dan bukan satu lapisan yang kuat, ialah pendekatan yang diterima kerana kegagalan keselamatan agent cenderung terlepas melalui satu lapisan pada satu masa.
Rupa Keselamatan yang Cukup Baik
NIST AI Risk Management Framework menyusun kerja risiko AI kepada empat fungsi: GOVERN, MAP, MEASURE, dan MANAGE. Apabila diterapkan pada agent, ia diterjemahkan kepada senarai semak yang ringkas dan konkrit: tadbir siapa yang boleh meluluskan akses alat baharu untuk agent, petakan permukaan ancaman sebenar bagi setiap agent yang anda jalankan dan bukan bergantung pada satu dasar AI generik, ukur apa yang agent lakukan berbanding model ancaman itu secara berterusan, dan uruskan insiden dengan pelan tindak balas sebenar dan bukan mengetahuinya daripada pelanggan.
Kecemasan di sini bukan andaian. Gartner meramalkan bahawa menjelang 2028, 25% pelanggaran keselamatan perusahaan akan berpunca daripada penyalahgunaan AI agent, daripada penyerang luar dan orang dalam yang berniat jahat. Secara berasingan, Gartner meramalkan bahawa 25% aplikasi AI generatif perusahaan akan mengalami sekurang-kurangnya lima insiden keselamatan kecil setahun menjelang 2028, meningkat daripada 9% pada 2025. Kedua-dua angka menunjuk ke arah yang sama: apabila agent mendapat lebih banyak akses alat dan lebih banyak autonomi, insiden meningkat bersama mereka, bukan kerana teknologinya bertambah buruk, tetapi kerana permukaan serangan berkembang lebih pantas daripada kawalan kebanyakan pasukan.
Fakta Utama
- Keselamatan agent ialah masalah yang lebih besar daripada keselamatan model kerana agent bertindak, bukan sekadar menjana. Model yang diperdaya menghasilkan teks yang buruk; agent yang diperdaya menghasilkan tindakan yang buruk.
- Tiga permukaan serangan utama ialah prompt injection, pemindahan data haram, dan alat yang diberi kebenaran berlebihan. Prompt injection (OWASP LLM01) telah menduduki tempat teratas risiko LLM untuk dua edisi berturut-turut.
- Hak akses minimum bermakna menghadkan setiap alat kepada akses tersempit yang diperlukan tugas sebenar agent, dengan tokennya sendiri, bukan kredensial kuasa penuh yang dikongsi.
- Sandboxing bermakna mementaskan akses tulis, menghadkan perbelanjaan dan kadar, dan memerlukan pengesahan manusia pada tindakan yang tidak boleh diundurkan.
- Gartner meramalkan 25% pelanggaran keselamatan perusahaan akan berpunca daripada penyalahgunaan AI agent menjelang 2028, dan 25% aplikasi GenAI perusahaan akan mengalami lima atau lebih insiden keselamatan kecil setahun menjelang 2028, meningkat daripada 9% pada 2025.
Soalan Lazim tentang Keselamatan AI Agent
Apakah keselamatan AI agent?
Keselamatan AI agent ialah set amalan yang menghalang agent autonomi daripada dimanipulasi, diberi kebenaran berlebihan, atau dieksploitasi untuk mengambil tindakan yang memudaratkan. Ia merangkumi pemodelan ancaman pada akses alat agent, penguatkuasaan hak akses minimum, sandboxing apa yang boleh disentuhnya, dan pertahanan terhadap prompt injection secara khusus.
Apakah risiko keselamatan terbesar bagi AI agent?
Prompt injection, di mana arahan yang tersembunyi dalam kandungan yang diproses agent mengatasi tugas sebenarnya. Ia telah menduduki risiko nombor satu (LLM01) dalam OWASP Top 10 untuk Aplikasi LLM untuk dua edisi berturut-turut, dan ia amat berbahaya bagi agent kerana suntikan yang berjaya boleh mencetuskan tindakan sebenar, bukan sekadar respons yang buruk.
Apakah maksud hak akses minimum bagi AI agent?
Ia bermakna memberi agent hanya akses alat yang diperlukan tugas khususnya, dihadkan seketat mungkin, dengan kredensialnya sendiri dan bukan kunci API berkuasa yang dikongsi. Agent sokongan yang boleh mengemas kini status tiket tidak patut turut memegang akses padam kepada keseluruhan helpdesk anda.
Apakah sandboxing untuk AI agent?
Sandboxing mengehadkan kerosakan jika agent dimanipulasi walaupun ada kawalan anda yang lain: mementaskan akses tulis di sebalik kelulusan manusia sebelum memberinya secara autonomi, menghadkan perbelanjaan dan kadar panggilan bagi setiap jenis tindakan, dan memerlukan pengesahan sebelum tindakan yang tidak boleh diundurkan seperti menghantar komunikasi luar atau memadam rekod.
Bagaimana anda bertahan daripada prompt injection?
Tiada satu pertahanan pun yang mencukupi. Gabungkan pengasingan arahan daripada kandungan yang tidak dipercayai, melayan kandungan yang diambil atau masuk sebagai data dan bukan arahan, penapisan input, akses alat dengan hak akses minimum, dan pengesahan manusia pada tindakan yang berakibat tinggi. Pertahanan berlapis menangkap apa yang terlepas daripada mana-mana satu lapisan.
Ke Mana Seterusnya
Keselamatan memberitahu anda bahawa agent tidak mudah diperdaya untuk bertindak dengan salah. Kebolehperhatian AI agent memberitahu anda sama ada ia tetap bertindak dengan salah, kerana agent yang diamankan dengan baik pun boleh menyimpang, dan anda perlu dapat melihatnya. Untuk melihat secara konkrit bagaimana kawalan ini muncul dalam reka bentuk sebenar, pelan AI Security Monitoring Agent dan AI Access Provisioning Agent kedua-duanya membina logik hak akses minimum dan kelulusan manusia ke dalam reka bentuk terasnya dan bukan menambahnya selepas pelancaran.

On this page
- Sebab Mengamankan Agent Masalah yang Lebih Besar daripada Mengamankan Model
- Model Ancaman Agent: Tiga Tempat Serangan Mendarat
- Hak Akses Minimum: Beri Agent Hanya Alat yang Diperlukan Tugasnya
- Sandboxing: Mengekang Apa yang Boleh Disentuh Agent
- Bertahan daripada Prompt Injection Secara Khusus
- Rupa Keselamatan yang Cukup Baik
- Fakta Utama
- Ke Mana Seterusnya