Bahasa Indonesia
Keamanan AI Agent: Panduan Praktis
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Keamanan AI agent adalah disiplin untuk menjaga agent otonom agar tidak tertipu, diberi izin berlebihan, atau dijadikan alat oleh penyerang: memodelkan ancaman pada apa yang dapat dijangkaunya, menerapkan least privilege pada setiap alat yang dipegangnya, melakukan sandboxing pada apa yang boleh disentuhnya, dan memvalidasi apa yang masuk dan keluar darinya. Ini lebih penting daripada keamanan AI secara umum karena agent tidak hanya menghasilkan teks yang berisiko, tetapi juga mengambil tindakan. Model yang tertipu menghasilkan satu kalimat yang buruk. Agent yang tertipu biasanya sudah bertindak berdasarkan tipuan itu.
Mengapa Mengamankan Agent Lebih Sulit daripada Mengamankan Model
Keamanan AI mencakup kategori ancaman yang berlaku untuk sistem AI apa pun: input adversarial yang mendorong model ke keluaran yang salah, data poisoning yang merusak pelatihan, prompt injection yang membajak instruksi, pencurian model, dan inversi model. Semuanya tetap berlaku untuk agent, karena agent dibangun di atas sebuah model. Yang berubah adalah apa yang terjadi setelah model tertipu.
ACE Framework dari Rework menarik garis tegas antara dua kapabilitasnya: Generate dan Execute. Menghasilkan draf balasan berisiko rendah; draf yang buruk tinggal dihapus sebelum ada yang melihatnya. Mengeksekusi tindakan itu, yaitu benar-benar mengirimnya, memperbarui data, atau menerbitkan pengembalian dana, adalah tempat konsekuensi berada. Chatbot biasa sebagian besar berada di sisi Generate dari garis itu. Agent, menurut definisinya, melintasinya. Itulah sebabnya blok penyusun Tools dan Guardrails dalam cara kerja AI agent ada: Tools menetapkan batas atas apa yang dapat dilakukan agent, dan Guardrails menetapkan apa yang tidak boleh dilakukannya apa pun yang diperintahkan kepadanya. Keamanan adalah yang menjaga keduanya tetap jujur ketika seseorang secara aktif berusaha menjebolnya.
Model Ancaman Agent: Tiga Tempat Serangan Mendarat
Sebagian besar insiden keamanan agent bermuara pada salah satu dari tiga permukaan.
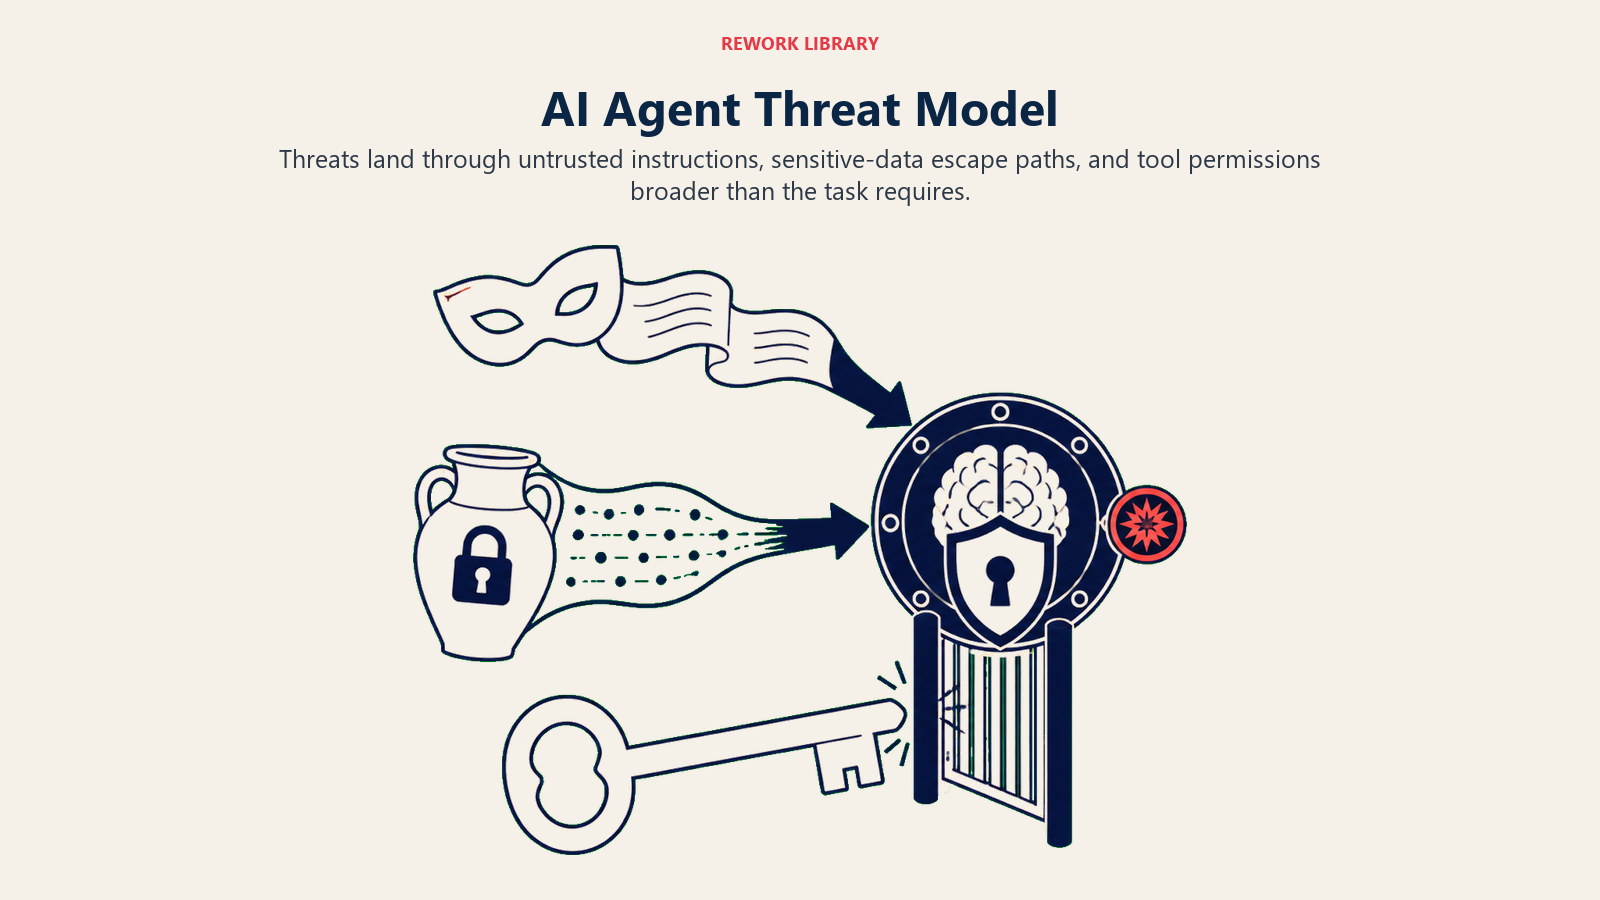
| Permukaan | Apa yang terjadi | Mengapa agent terekspos |
|---|---|---|
| Prompt injection | Instruksi tersembunyi dalam konten yang dibaca agent menimpa tugas aslinya | Agent membaca konten yang tidak tepercaya secara desain: email, tiket, dokumen, halaman web, data hasil scraping |
| Eksfiltrasi data | Agent dimanipulasi untuk menyertakan data sensitif dalam keluaran, panggilan alat, atau pesan kepada pihak luar | Agent sering memiliki akses baca yang luas ke sistem CRM, dukungan, atau keuangan untuk menjalankan tugasnya |
| Alat dengan izin berlebihan | Satu manipulasi yang berhasil merembet karena akses alat agent lebih luas daripada yang dibutuhkan tugas sebenarnya | Tim sering memberikan satu kredensial integrasi yang luas alih-alih membatasi akses per tugas |
Prompt injection adalah yang paling perlu ditanggapi serius. Ia menempati posisi teratas, LLM01, dalam OWASP Top 10 untuk Aplikasi LLM selama dua edisi berturut-turut, tepatnya karena murah untuk dicoba dan sulit ditutup sepenuhnya. Injeksi langsung adalah pengguna yang mengetik instruksi untuk menimpa system prompt. Injeksi tidak langsung lebih buruk bagi agent secara khusus: instruksinya tersembunyi dalam dokumen, email, tiket, atau halaman web yang diminta untuk diproses agent, sehingga pihak yang menyerang agent tidak perlu berinteraksi langsung dengannya sama sekali.
Least Privilege: Berikan Agent Hanya Alat yang Dibutuhkan Tugasnya
Keputusan keamanan dengan pengaruh terbesar yang Anda buat sekaligus yang paling membosankan: batasi setiap alat pada akses tersempit yang memungkinkan agent menjalankan tugas aslinya, tidak lebih.
Dalam praktiknya, itu berarti agent triase dukungan mendapat akses baca ke tiket dan jalur tulis yang sempit untuk memperbarui status tiket, bukan kredensial permanen ke seluruh panel admin helpdesk Anda. Itu berarti agent kebersihan CRM dapat mengedit kolom tertentu, bukan menghapus data. Itu berarti setiap panggilan alat berjalan dengan token terbatasnya sendiri, bukan satu API key bersama yang kuat yang dipakai ulang oleh setiap agent di stack Anda, karena kunci bersama itu mengubah satu agent yang dibobol menjadi semuanya dibobol.
Ini adalah disiplin yang sama di balik blueprint AI Access Provisioning Agent, yang ada khusus untuk memeriksa setiap permintaan akses terhadap kebijakan dan menandai apa pun yang tampak seperti eskalasi hak istimewa, alih-alih memberikannya secara default. Terapkan standar yang sama pada izin agent itu sendiri, bukan hanya izin yang dikelolanya atas nama orang lain. Jika Anda tidak akan memberi karyawan baru akses permanen ke segalanya di hari pertama, jangan berikan juga kepada agent.
Sandboxing: Membatasi Apa yang Dapat Disentuh Agent
Least privilege membatasi apa yang dapat dijangkau agent. Sandboxing membatasi apa yang terjadi jika ia tetap menjangkau hal yang salah.
Beberapa pola praktis yang layak diadopsi:
- Lakukan staging sebelum memberi akses tulis. Jalankan agent baru dalam mode di mana ia mengusulkan tindakan tetapi manusia yang menyetujuinya, lalu naikkan jenis tindakan tertentu yang berisiko rendah menjadi otonom setelah Anda melihatnya melakukannya dengan benar secara konsisten.
- Batasi pengeluaran dan laju per jenis tindakan. Loop yang lepas kendali atau agent yang dimanipulasi tidak bisa menimbulkan banyak kerusakan jika dibatasi lajunya dan dibatasi biayanya per run.
- Pisahkan lingkungan untuk konten yang tidak tepercaya. Agent yang merangkum email masuk tidak boleh berjalan dalam konteks yang sama dengan yang memegang akses tulis ke penggajian.
- Wajibkan konfirmasi manusia pada tindakan yang tidak dapat dibatalkan. Mengirim komunikasi eksternal, memindahkan uang, dan menghapus data adalah kasus di mana biaya false positive (menanyai manusia tanpa perlu) jauh lebih rendah daripada biaya false negative (bertindak berdasarkan instruksi yang dimanipulasi).
Ini adalah sisi praktis dari apa yang dijelaskan Persyaratan Tata Kelola menurut Pola AI: persyaratan tata kelola harus mengikuti risiko, dan risiko terkonsentrasi pada langkah Execute. Agent yang hanya dapat membuat draf adalah sandbox yang jauh lebih kecil untuk diamankan daripada agent yang juga dapat mengirim, membayar, dan menghapus.
Bertahan dari Prompt Injection Secara Khusus
Karena prompt injection adalah risiko peringkat teratas, ia layak mendapat pertahanan tersendiri di luar least privilege dan sandboxing.
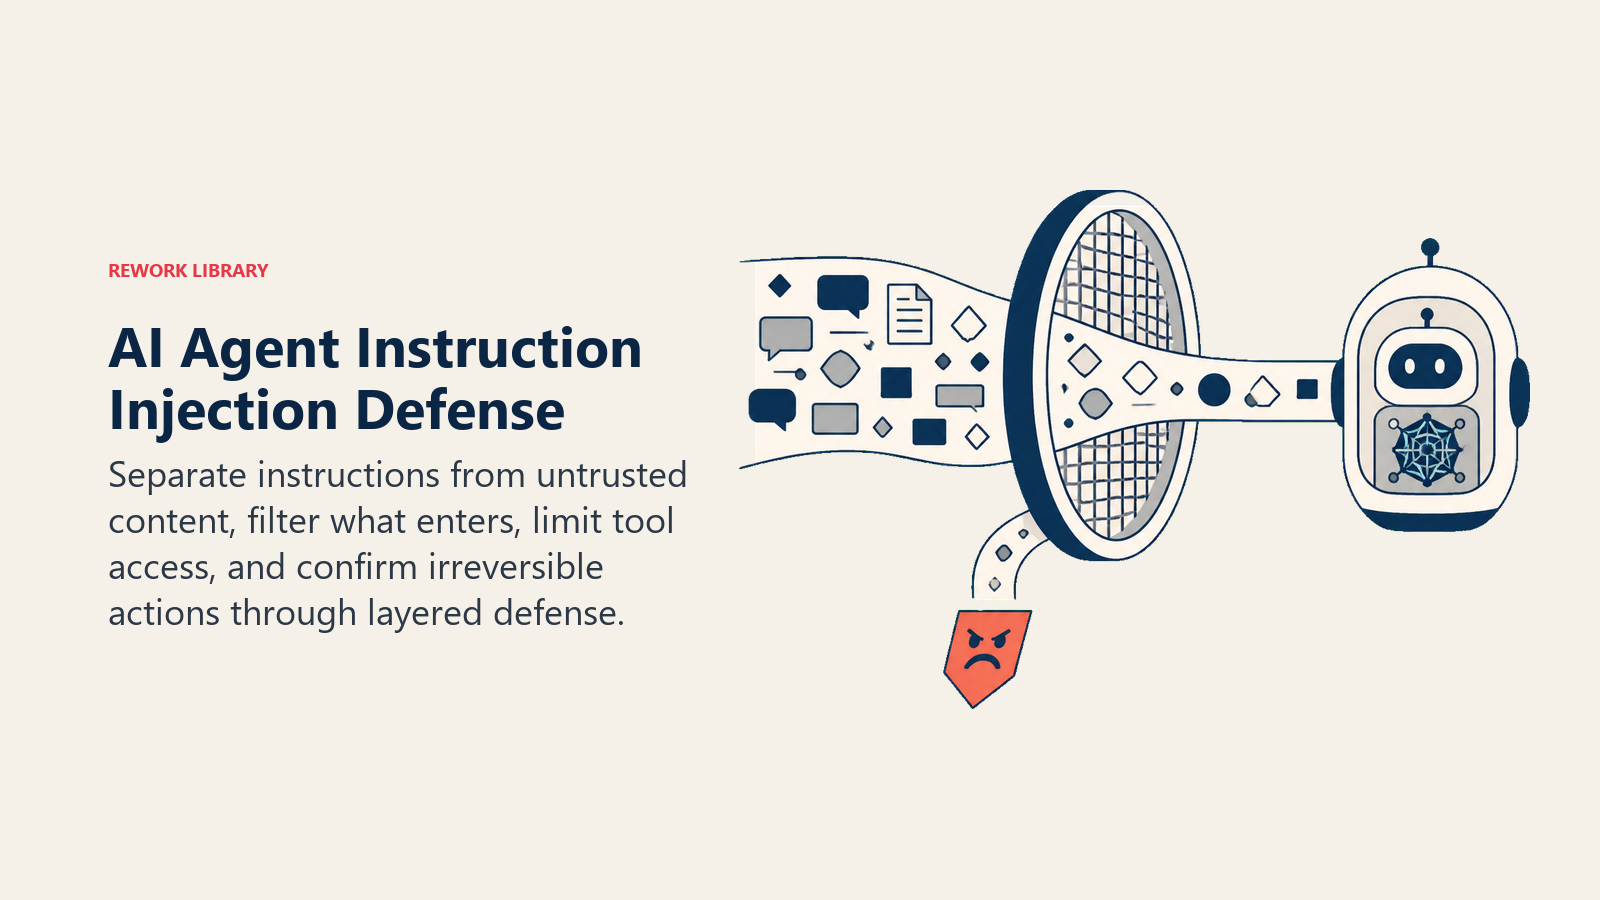
Pisahkan saluran instruksi dari saluran konten di mana pun platform Anda memungkinkan, sehingga teks yang diambil dari dokumen atau email ditandai secara struktural sebagai data untuk dievaluasi, bukan perintah untuk diikuti. Perlakukan semua yang diambil dari luar organisasi Anda, halaman hasil scraping, pesan masuk, file yang diunggah, sebagai tidak tepercaya secara default, sama seperti aplikasi web memperlakukan input pengguna. Filter dan saring input sebelum mencapai model, dengan memahami bahwa tidak ada filter yang menangkap setiap upaya penyerang yang gigih, itulah sebabnya ini hanya satu lapisan di antara beberapa, bukan seluruh pertahanan. Dan tetaplah libatkan manusia dalam alur untuk jenis tindakan tertentu di mana injeksi yang berhasil akan menimbulkan kerusakan nyata, bukan untuk segalanya, hanya untuk kasus yang tidak dapat dibatalkan atau bernilai tinggi.
Tidak ada satu kontrol pun di sini yang cukup dengan sendirinya. Justru itu intinya. Defense in depth, beberapa lapisan yang lebih lemah ditumpuk alih-alih satu lapisan yang kuat, adalah pendekatan yang diterima karena kegagalan keamanan agent cenderung lolos dari tepat satu lapisan pada satu waktu.
Seperti Apa Aman yang Cukup
NIST AI Risk Management Framework mengorganisasi pekerjaan risiko AI ke dalam empat fungsi: GOVERN, MAP, MEASURE, dan MANAGE. Diterapkan pada agent, itu diterjemahkan menjadi daftar periksa yang singkat dan konkret: tentukan (govern) siapa yang dapat menyetujui akses alat baru untuk agent, petakan (map) permukaan ancaman sebenarnya untuk setiap agent yang Anda jalankan alih-alih mengandalkan satu kebijakan AI generik, ukur (measure) apa yang dilakukan agent terhadap model ancaman itu secara berkelanjutan, dan kelola (manage) insiden dengan rencana respons yang nyata alih-alih mengetahuinya dari pelanggan.
Urgensinya di sini bukan hipotetis. Gartner memprediksi bahwa pada 2028, 25% pelanggaran di perusahaan akan bersumber dari penyalahgunaan AI agent, baik dari penyerang eksternal maupun orang dalam yang berniat jahat. Secara terpisah, Gartner memperkirakan bahwa 25% aplikasi generative AI perusahaan akan mengalami setidaknya lima insiden keamanan minor per tahun pada 2028, naik dari 9% pada 2025. Kedua angka menunjuk ke arah yang sama: seiring agent mendapat lebih banyak akses alat dan lebih banyak otonomi, insiden ikut meningkat, bukan karena teknologinya memburuk, tetapi karena permukaan serangan tumbuh lebih cepat daripada kontrol kebanyakan tim.
Fakta Utama
- Keamanan agent adalah masalah yang lebih besar daripada keamanan model karena agent bertindak, bukan hanya menghasilkan. Model yang tertipu menghasilkan teks yang buruk; agent yang tertipu menghasilkan tindakan yang buruk.
- Tiga permukaan serangan utama adalah prompt injection, eksfiltrasi data, dan alat dengan izin berlebihan. Prompt injection (OWASP LLM01) telah menjadi risiko LLM teratas selama dua edisi berturut-turut.
- Least privilege berarti membatasi setiap alat pada akses tersempit yang dibutuhkan tugas agent yang sebenarnya, dengan tokennya sendiri, bukan kredensial serba bisa yang dipakai bersama.
- Sandboxing berarti melakukan staging akses tulis, membatasi pengeluaran dan laju, dan mewajibkan konfirmasi manusia pada tindakan yang tidak dapat dibatalkan.
- Gartner memprediksi 25% pelanggaran di perusahaan akan bersumber dari penyalahgunaan AI agent pada 2028, dan 25% aplikasi GenAI perusahaan akan mengalami lima atau lebih insiden keamanan minor per tahun pada 2028, naik dari 9% pada 2025.
Pertanyaan yang Sering Diajukan tentang Keamanan AI Agent
Apa itu keamanan AI agent?
Keamanan AI agent adalah serangkaian praktik yang menjaga agent otonom agar tidak dimanipulasi, diberi izin berlebihan, atau dieksploitasi untuk mengambil tindakan yang merugikan. Cakupannya meliputi pemodelan ancaman pada akses alat agent, penerapan least privilege, sandboxing pada apa yang dapat disentuhnya, dan pertahanan terhadap prompt injection secara khusus.
Apa risiko keamanan terbesar bagi AI agent?
Prompt injection, di mana instruksi tersembunyi dalam konten yang diproses agent menimpa tugas aslinya. Ia menempati peringkat risiko nomor satu (LLM01) dalam OWASP Top 10 untuk Aplikasi LLM selama dua edisi berturut-turut, dan sangat berbahaya bagi agent karena injeksi yang berhasil dapat memicu tindakan nyata, bukan sekadar respons yang buruk.
Apa arti least privilege bagi sebuah AI agent?
Artinya memberi agent hanya akses alat yang dibutuhkan tugas spesifiknya, dibatasi seketat mungkin, dengan kredensialnya sendiri alih-alih API key bersama yang kuat. Agent dukungan yang dapat memperbarui status tiket tidak seharusnya juga memegang akses hapus ke seluruh helpdesk Anda.
Apa itu sandboxing untuk AI agent?
Sandboxing membatasi kerusakan jika agent dimanipulasi meskipun kontrol Anda yang lain sudah ada: melakukan staging akses tulis di balik persetujuan manusia sebelum memberikannya secara otonom, membatasi pengeluaran dan laju panggilan per jenis tindakan, dan mewajibkan konfirmasi sebelum tindakan yang tidak dapat dibatalkan seperti mengirim komunikasi eksternal atau menghapus data.
Bagaimana cara bertahan dari prompt injection?
Tidak ada satu pertahanan pun yang cukup. Gabungkan pemisahan instruksi dari konten yang tidak tepercaya, perlakuan terhadap konten yang diambil atau masuk sebagai data, bukan perintah, penyaringan input, akses alat dengan least privilege, dan konfirmasi manusia pada tindakan berkonsekuensi tinggi. Defense in depth menangkap apa yang terlewat oleh satu lapisan.
Langkah Selanjutnya
Keamanan memberi tahu Anda bahwa agent tidak mudah ditipu untuk bertindak salah. Observabilitas AI agent memberi tahu Anda apakah ia tetap bertindak salah, karena agent yang terlindungi dengan baik pun dapat menyimpang, dan Anda perlu bisa melihatnya. Untuk gambaran konkret tentang bagaimana kontrol ini muncul dalam desain nyata, blueprint AI Security Monitoring Agent dan AI Access Provisioning Agent sama-sama menanamkan logika least privilege dan persetujuan manusia ke dalam desain intinya, bukan menempelkannya setelah peluncuran.

On this page
- Mengapa Mengamankan Agent Lebih Sulit daripada Mengamankan Model
- Model Ancaman Agent: Tiga Tempat Serangan Mendarat
- Least Privilege: Berikan Agent Hanya Alat yang Dibutuhkan Tugasnya
- Sandboxing: Membatasi Apa yang Dapat Disentuh Agent
- Bertahan dari Prompt Injection Secara Khusus
- Seperti Apa Aman yang Cukup
- Fakta Utama
- Langkah Selanjutnya