AI Agent Security: Ein praktischer Leitfaden
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI Agent Security ist die Disziplin, die verhindert, dass ein autonomer Agent ausgetrickst, mit zu vielen Rechten ausgestattet oder zum Werkzeug eines Angreifers gemacht wird: per Threat Modeling klären, worauf er zugreifen kann, auf jedem seiner Tools Least Privilege durchsetzen, per Sandbox begrenzen, was er berühren darf, und prüfen, was in ihn hinein- und aus ihm herausfließt. Sie ist wichtiger als allgemeine AI-Sicherheit, weil ein Agent nicht nur riskanten Text erzeugt, sondern handelt. Ein Modell, das getäuscht wird, produziert einen schlechten Satz. Ein Agent, der getäuscht wird, hat in der Regel schon danach gehandelt.
Warum es ein größeres Problem ist, einen Agent abzusichern als ein Modell
AI-Sicherheit behandelt die Bedrohungskategorien, die für jedes AI-System gelten: Adversarial Inputs, die ein Modell zum falschen Output drängen, Data Poisoning, das das Training korrumpiert, Prompt Injection, die Anweisungen kapert, Modelldiebstahl und Model Inversion. Jede davon gilt weiterhin auch für einen Agent, denn darunter liegt ein Modell. Was sich ändert, ist das, was passiert, nachdem das Modell getäuscht wurde.
Das ACE Framework von Rework zieht eine klare Grenze zwischen zwei seiner Fähigkeiten: Generate und Execute. Einen Antwortentwurf zu generieren ist wenig riskant; ein schlechter Entwurf wird einfach gelöscht, bevor ihn jemand sieht. Diese Aktion auszuführen, also sie tatsächlich zu senden, einen Datensatz zu aktualisieren oder eine Rückerstattung auszulösen, ist der Punkt, an dem die Folgen liegen. Ein einfacher Chatbot bewegt sich überwiegend auf der Generate-Seite dieser Linie. Ein Agent überschreitet sie per Definition. Genau deshalb gibt es die Bausteine Tools und Guardrails in So funktionieren AI Agents: Tools definieren die Obergrenze dessen, was ein Agent tun kann, und Guardrails definieren, was er unabhängig von jeder Anweisung niemals tun darf. Security sorgt dafür, dass beide ehrlich bleiben, wenn jemand aktiv versucht, sie zu brechen.
Das Threat Model für Agents: Drei Stellen, an denen Angriffe ansetzen
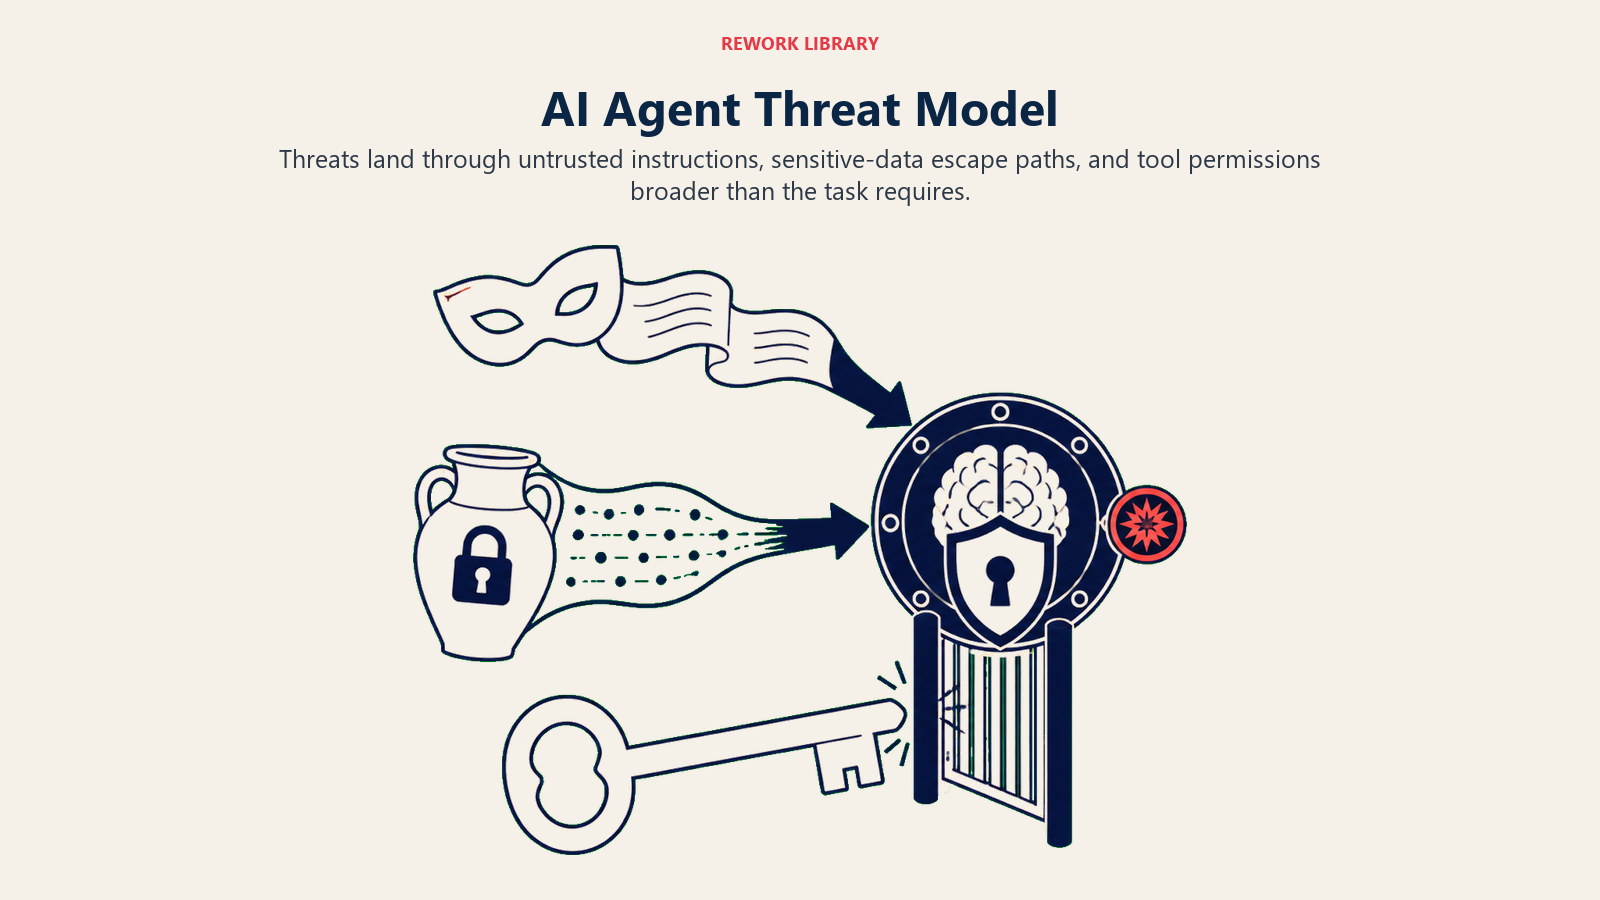
Die meisten Sicherheitsvorfälle bei Agents lassen sich auf eine von drei Angriffsflächen zurückführen.
| Angriffsfläche | Was passiert | Warum Agents exponiert sind |
|---|---|---|
| Prompt Injection | In Inhalten versteckte Anweisungen, die der Agent liest, überschreiben seine eigentliche Aufgabe | Agents lesen von Natur aus nicht vertrauenswürdige Inhalte: E-Mails, Tickets, Dokumente, Webseiten, gescrapte Daten |
| Datenabfluss | Der Agent wird manipuliert, sensible Daten in eine Ausgabe, einen Tool-Aufruf oder eine Nachricht an Externe aufzunehmen | Agents haben oft breiten Lesezugriff auf CRM-, Support- oder Finanzsysteme, um ihre Arbeit zu erledigen |
| Tools mit zu weitreichenden Rechten | Eine einzige erfolgreiche Manipulation zieht Kreise, weil der Tool-Zugriff des Agents weiter reicht, als seine eigentliche Aufgabe verlangt | Teams vergeben oft eine breite Integrations-Credential statt den Zugriff pro Aufgabe einzugrenzen |
Prompt Injection ist die, die Sie am ernstesten nehmen sollten. Sie steht seit zwei Ausgaben in Folge an der Spitze, als LLM01 in der OWASP Top 10 für LLM-Anwendungen, gerade weil sie billig zu versuchen und schwer vollständig zu schließen ist. Direkte Injection ist ein Nutzer, der eine Anweisung eintippt, die den System Prompt überschreiben soll. Indirekte Injection ist für Agents besonders schlimm: Die Anweisung ist in einem Dokument, einer E-Mail, einem Ticket oder einer Webseite versteckt, die der Agent verarbeiten soll, sodass der Angreifer überhaupt nie direkt mit ihm interagieren muss.
Least Privilege: Geben Sie dem Agent nur die Tools, die sein Job braucht
Die wirkungsvollste Sicherheitsentscheidung ist zugleich die langweiligste: Grenzen Sie jedes Tool auf den engsten Zugriff ein, mit dem der Agent seinen eigentlichen Job erledigen kann, nicht mehr.
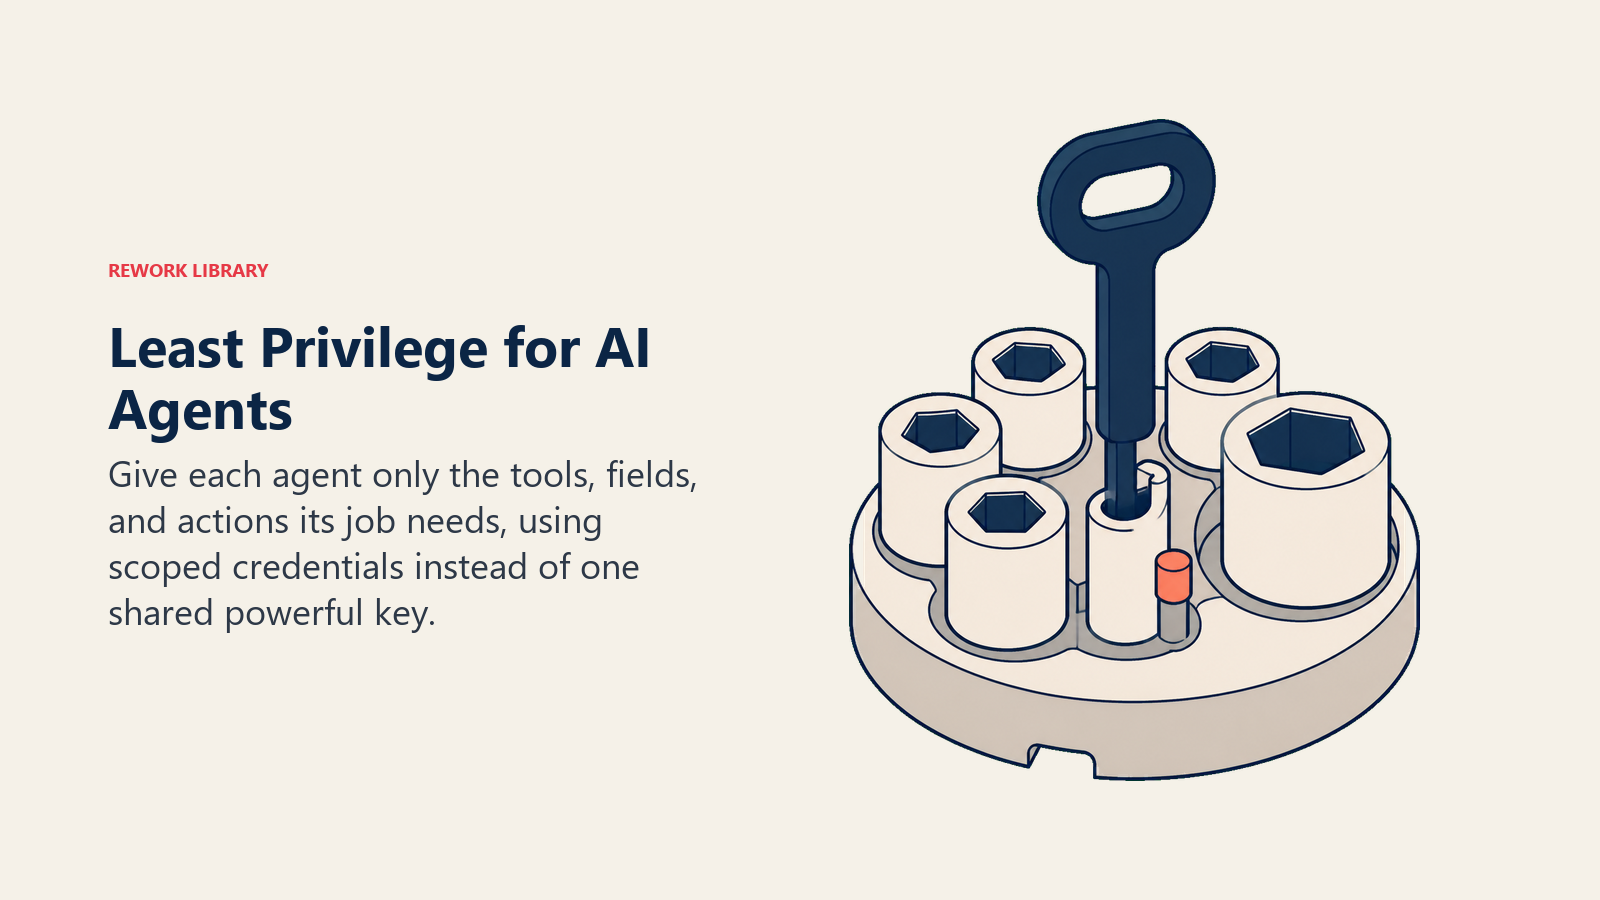
In der Praxis heißt das: Ein Support-Triage-Agent erhält Lesezugriff auf Tickets und einen schmalen Schreibpfad, um den Ticketstatus zu aktualisieren, keine dauerhafte Credential für das gesamte Admin-Panel Ihres Helpdesks. Ein CRM-Hygiene-Agent darf bestimmte Felder bearbeiten, nicht Datensätze löschen. Jeder Tool-Aufruf läuft unter einem eigenen eng begrenzten Token statt unter einem gemeinsamen, mächtigen API-Schlüssel, den jeder Agent in Ihrem Stack wiederverwendet, denn dieser gemeinsame Schlüssel macht aus einem kompromittierten Agent ein kompromittiertes Alles.
Dieselbe Disziplin steckt hinter dem Blueprint AI Access Provisioning Agent, der gezielt jede Zugriffsanfrage gegen die Richtlinie prüft und alles meldet, was nach Rechteausweitung aussieht, statt sie standardmäßig zu gewähren. Wenden Sie denselben Maßstab auf die eigenen Berechtigungen des Agents an, nicht nur auf die Berechtigungen, die er im Auftrag anderer verwaltet. Wenn Sie einem neuen Mitarbeiter am ersten Tag keinen dauerhaften Zugriff auf alles geben würden, geben Sie ihn auch keinem Agent.
Sandboxing: Eingrenzen, was der Agent berühren kann
Least Privilege begrenzt, worauf ein Agent zugreifen kann. Sandboxing begrenzt, was passiert, wenn er trotzdem auf das Falsche zugreift.
Ein paar praktische Muster, die sich lohnen:
- Stufen Sie ab, bevor Sie Schreibzugriff gewähren. Lassen Sie einen neuen Agent in einem Modus laufen, in dem er Aktionen vorschlägt, ein Mensch sie aber freigibt, und überführen Sie dann bestimmte, risikoarme Aktionstypen in den autonomen Betrieb, sobald Sie gesehen haben, dass er sie konsistent richtig macht.
- Deckeln Sie Ausgaben und Rate pro Aktionstyp. Eine außer Kontrolle geratene Schleife oder ein manipulierter Agent kann wenig Schaden anrichten, wenn er in der Rate begrenzt und bei den Kosten pro Lauf gedeckelt ist.
- Trennen Sie Umgebungen für nicht vertrauenswürdige Inhalte. Ein Agent, der eine eingehende E-Mail zusammenfasst, sollte nicht im selben Kontext laufen, der Schreibzugriff auf die Gehaltsabrechnung hat.
- Verlangen Sie bei unumkehrbaren Aktionen eine menschliche Bestätigung. Externe Kommunikation zu versenden, Geld zu bewegen und einen Datensatz zu löschen sind genau die Fälle, in denen die Kosten eines Fehlalarms (einen Menschen unnötig zu fragen) deutlich niedriger sind als die Kosten eines übersehenen Falls (auf eine manipulierte Anweisung hin zu handeln).
Das ist die praktische Seite dessen, was Governance-Anforderungen nach AI-Pattern beschreibt: Governance-Anforderungen sollten dem Risiko folgen, und das Risiko konzentriert sich am Execute-Schritt. Ein Agent, der nur Entwürfe erstellen kann, ist eine deutlich kleinere Sandbox als einer, der auch senden, bezahlen und löschen kann.
Gezielt gegen Prompt Injection verteidigen
Weil Prompt Injection das am höchsten eingestufte Risiko ist, verdient sie eigene Abwehrmaßnahmen über Least Privilege und Sandboxing hinaus.
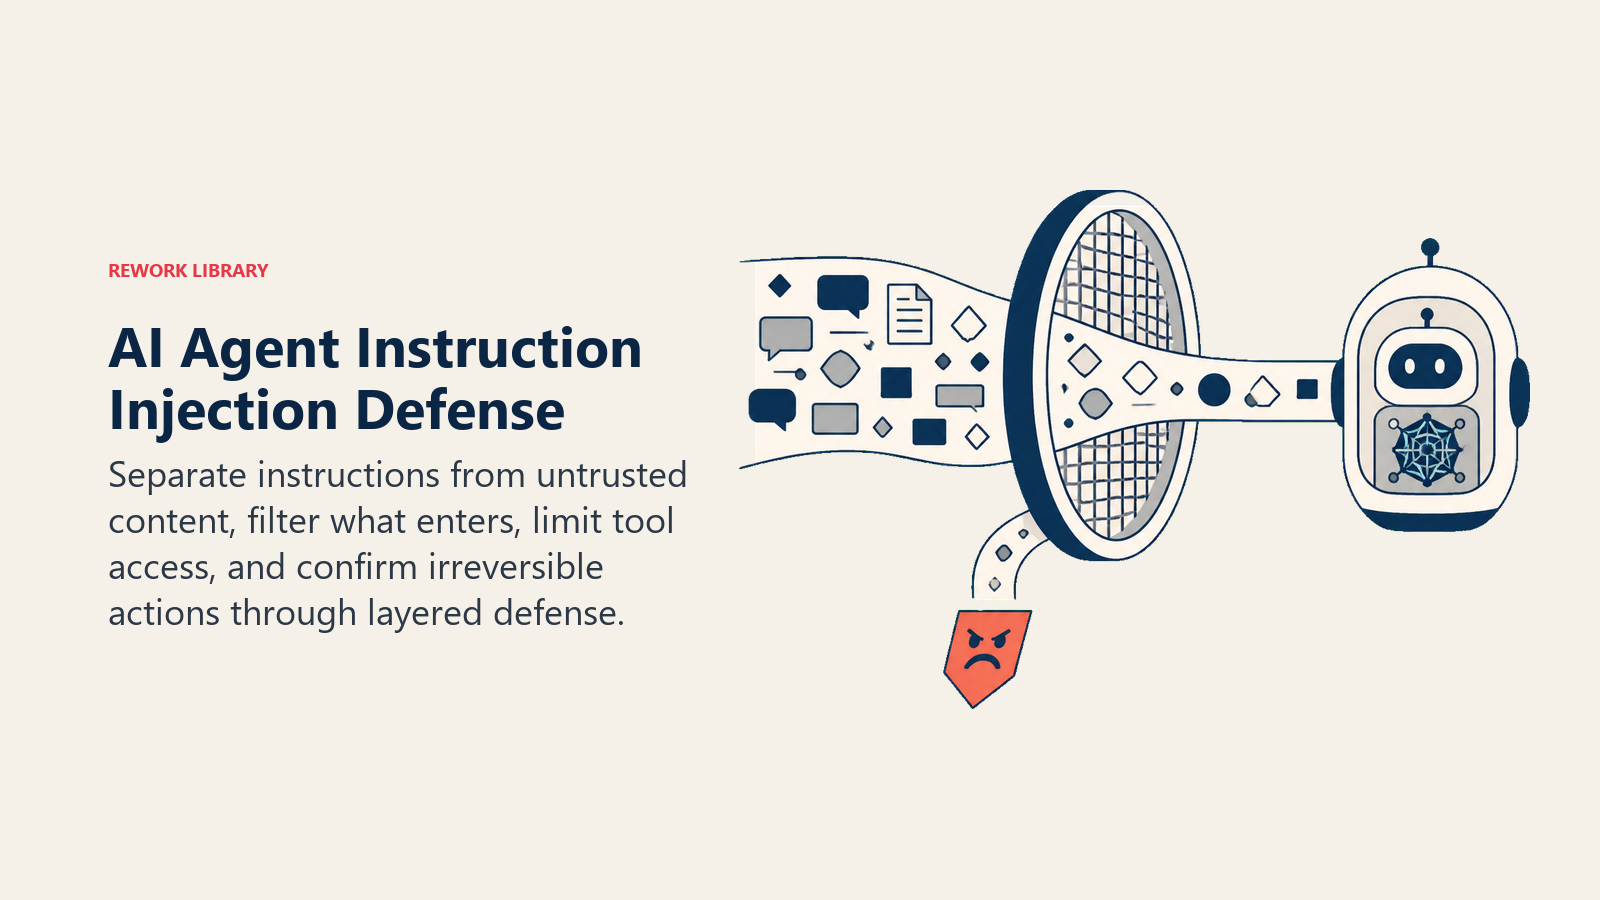
Trennen Sie den Anweisungskanal vom Inhaltskanal, wo immer Ihre Plattform es erlaubt, sodass Text aus einem Dokument oder einer E-Mail strukturell als Daten markiert ist, die es zu bewerten gilt, nicht als Befehle, denen zu folgen ist. Behandeln Sie alles, was von außerhalb Ihrer Organisation abgerufen wird, eine gescrapte Seite, eine eingehende Nachricht, eine hochgeladene Datei, standardmäßig als nicht vertrauenswürdig, so wie eine Webanwendung Nutzereingaben behandelt. Filtern und prüfen Sie Eingaben, bevor sie das Modell erreichen, in dem Wissen, dass kein Filter jeden Versuch eines entschlossenen Angreifers abfängt, weshalb dies eine Schicht unter mehreren ist, nicht die ganze Verteidigung. Und halten Sie einen Menschen in der Schleife für die konkreten Aktionstypen, bei denen eine erfolgreiche Injection echten Schaden anrichten würde, nicht für alles, nur für die unumkehrbaren oder hochwertigen Fälle.
Keine einzelne Maßnahme reicht hier allein aus. Das ist der Punkt. Defense in Depth, also mehrere schwächere Schichten übereinander statt einer starken, ist der anerkannte Ansatz, weil Sicherheitsversagen bei Agents typischerweise immer nur an genau einer Schicht vorbeirutscht.
Wie „sicher genug“ aussieht
Das NIST AI Risk Management Framework gliedert die Arbeit an AI-Risiken in vier Funktionen: GOVERN, MAP, MEASURE und MANAGE. Auf einen Agent angewandt, ergibt das eine kurze, konkrete Checkliste: Legen Sie fest (govern), wer neuen Tool-Zugriff für einen Agent freigeben darf, erfassen Sie (map) die tatsächliche Bedrohungsfläche für jeden Agent, den Sie betreiben, statt sich auf eine allgemeine AI-Richtlinie zu verlassen, messen Sie (measure) fortlaufend, was der Agent im Verhältnis zu diesem Threat Model tut, und steuern Sie (manage) Vorfälle mit einem echten Reaktionsplan, statt es von einem Kunden zu erfahren.
Die Dringlichkeit ist nicht hypothetisch. Gartner prognostiziert, dass bis 2028 25 % der Sicherheitsverletzungen in Unternehmen auf den Missbrauch von AI Agents zurückgehen, sowohl durch externe Angreifer als auch durch böswillige Insider. Zudem erwartet Gartner, dass 25 % der generativen AI-Anwendungen in Unternehmen bis 2028 mindestens fünf kleinere Sicherheitsvorfälle pro Jahr haben werden, gegenüber 9 % im Jahr 2025. Beide Zahlen weisen in dieselbe Richtung: Je mehr Tool-Zugriff und Autonomie Agents erhalten, desto stärker wächst die Zahl der Vorfälle, nicht weil die Technologie schlechter wird, sondern weil die Angriffsfläche schneller wächst als die Kontrollen der meisten Teams.
Key Facts
- Agent-Sicherheit ist ein größeres Problem als Modellsicherheit, weil Agents handeln, nicht nur generieren. Ein getäuschtes Modell erzeugt schlechten Text; ein getäuschter Agent erzeugt eine schlechte Aktion.
- Die drei wichtigsten Angriffsflächen sind Prompt Injection, Datenabfluss und Tools mit zu weitreichenden Rechten. Prompt Injection (OWASP LLM01) steht seit zwei Ausgaben in Folge an der Spitze der LLM-Risiken.
- Least Privilege heißt, jedes Tool auf den engsten Zugriff einzugrenzen, den der eigentliche Job des Agents braucht, mit eigenem Token, nicht mit einer gemeinsamen Allmachts-Credential.
- Sandboxing heißt, Schreibzugriff abzustufen, Ausgaben und Rate zu deckeln und bei unumkehrbaren Aktionen eine menschliche Bestätigung zu verlangen.
- Gartner prognostiziert, dass bis 2028 25 % der Sicherheitsverletzungen in Unternehmen auf den Missbrauch von AI Agents zurückgehen und 25 % der GenAI-Anwendungen in Unternehmen fünf oder mehr kleinere Sicherheitsvorfälle pro Jahr haben, gegenüber 9 % im Jahr 2025.
Häufig gestellte Fragen zu AI Agent Security
Was ist AI Agent Security?
AI Agent Security umfasst die Praktiken, die verhindern, dass ein autonomer Agent manipuliert, mit zu vielen Rechten ausgestattet oder zu schädlichen Aktionen missbraucht wird. Sie umfasst Threat Modeling für den Tool-Zugriff des Agents, die Durchsetzung von Least Privilege, Sandboxing dessen, was er berühren kann, und gezielte Abwehr von Prompt Injection.
Was ist das größte Sicherheitsrisiko für AI Agents?
Prompt Injection, bei der in Inhalten versteckte Anweisungen, die der Agent verarbeitet, seine eigentliche Aufgabe überschreiben. Sie steht seit zwei Ausgaben in Folge auf Platz eins (LLM01) der OWASP Top 10 für LLM-Anwendungen und ist für Agents besonders gefährlich, weil eine erfolgreiche Injection eine echte Aktion auslösen kann, nicht nur eine schlechte Antwort.
Was bedeutet Least Privilege für einen AI Agent?
Es bedeutet, einem Agent nur den Tool-Zugriff zu geben, den seine konkrete Aufgabe verlangt, so eng wie möglich eingegrenzt, mit eigenen Credentials statt eines gemeinsamen mächtigen API-Schlüssels. Ein Support-Agent, der den Ticketstatus aktualisieren kann, sollte nicht auch Löschrechte für Ihren gesamten Helpdesk besitzen.
Was ist Sandboxing für AI Agents?
Sandboxing begrenzt den Schaden, falls ein Agent trotz Ihrer übrigen Kontrollen manipuliert wird: Schreibzugriff wird zunächst hinter eine menschliche Freigabe gestellt, bevor er autonom gewährt wird, Ausgaben und Aufrufrate pro Aktionstyp werden gedeckelt, und vor unumkehrbaren Aktionen wie dem Versand externer Kommunikation oder dem Löschen von Datensätzen wird eine Bestätigung verlangt.
Wie wehrt man Prompt Injection ab?
Keine einzelne Maßnahme genügt. Kombinieren Sie die Trennung von Anweisungen und nicht vertrauenswürdigen Inhalten, die Behandlung abgerufener oder eingehender Inhalte als Daten statt als Befehle, Eingabefilter, Tool-Zugriff nach Least Privilege und menschliche Bestätigung bei Aktionen mit schwerwiegenden Folgen. Defense in Depth fängt ab, was einer einzelnen Schicht entgeht.
Wie es weitergeht
Security sagt Ihnen, dass ein Agent sich nicht leicht zu falschem Handeln verleiten lässt. AI Agent Observability sagt Ihnen, ob er trotzdem falsch handelt, denn auch ein gut abgesicherter Agent kann abdriften, und Sie müssen das sehen können. Einen konkreten Einblick, wie diese Kontrollen in einem echten Design aussehen, geben die Blueprints AI Security Monitoring Agent und AI Access Provisioning Agent, die Least-Privilege- und Human-Approval-Logik beide fest in ihr Kerndesign einbauen, statt sie nach dem Start nachzurüsten.

On this page
- Warum es ein größeres Problem ist, einen Agent abzusichern als ein Modell
- Das Threat Model für Agents: Drei Stellen, an denen Angriffe ansetzen
- Least Privilege: Geben Sie dem Agent nur die Tools, die sein Job braucht
- Sandboxing: Eingrenzen, was der Agent berühren kann
- Gezielt gegen Prompt Injection verteidigen
- Wie „sicher genug“ aussieht
- Key Facts
- Wie es weitergeht