AI Agent Observability und Monitoring
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI Agent Observability ist die Praxis, einen Agent so zu instrumentieren, dass Sie jeden Durchlauf seines Loops sehen können: was ihn ausgelöst hat, was er entschieden hat, welche Tools er aufgerufen hat und was zurückkam und wo er an eine Person übergeben hat. Sie geht weiter als zu beobachten, ob eine einzelne Ausgabe richtig aussieht, denn ein Agent erzeugt nicht eine Ausgabe. Er führt über eine Aufgabe hinweg eine Kette von Entscheidungen und Aktionen aus, und ein Fehler kann sich irgendwo in dieser Kette verstecken. Ohne Observability vertrauen Sie einem autonomen System, in das Sie nicht hineinsehen können.
Warum das nicht dasselbe ist wie ein Modell zu beobachten
AI Observability deckt den allgemeinen Fall bereits ab: Logs, Metriken, Traces und Evaluierungen, die Ihnen sagen, was ein AI-System über seine Datenpipeline, seine Modellaufrufe und seine Ausgaben hinweg tut. All das gilt weiterhin für Agents. Was sich ändert, ist die Einheit, die Sie beobachten.
Ein einzelner Modellaufruf hat eine Eingabe und eine Ausgabe. Sie können ihn loggen, bewerten und weitergehen. Ein Agent-Durchlauf ist eine Sequenz, manchmal fünf Schritte, manchmal zwanzig, jeder eine neue Entscheidung, aufgebaut auf dem, was im Schritt davor geschah. Wie AI Agents funktionieren beschreibt diese Sequenz als Loop: wahrnehmen, schlussfolgern, handeln, beobachten, wiederholen. Beachten Sie, dass das Wort „beobachten“ dort schon vorkommt. Das ist der Agent, der seine eigene Tool-Ausgabe prüft, bevor er entscheidet, was als Nächstes zu tun ist, eine interne, momentane Prüfung. Agent Observability ist etwas anderes: Sie beobachten von außen den gesamten Loop, über alle Durchläufe und über die Zeit. Der interne Beobachtungsschritt des Agents sagt ihm, ob ein Tool-Aufruf funktioniert hat. Ihre Observability-Ebene sagt Ihnen, ob der Agent seit zwei Wochen still die falsche Entscheidung trifft.
Diese Unterscheidung ist wichtig, weil ein Agent, der technisch einwandfrei läuft, ohne Abstürze, ohne Fehler, trotzdem das Falsche tun kann. Er ruft vielleicht das richtige Tool mit leicht falschen Parametern auf, durchläuft denselben fehlgeschlagenen Schritt ein paar Mal zu oft, bevor er aufgibt, oder übergibt viel häufiger oder viel seltener an einen Menschen, als er sollte. Nichts davon erscheint als Fehler. All das erscheint in einem Trace, wenn Sie einen erfassen.
Was in einem einzelnen Agent-Durchlauf zu tracen ist
Behandeln Sie jeden Agent-Durchlauf als eine nachverfolgbare Einheit mit einer einzigen ID, die ihn von Anfang bis Ende begleitet. Erfassen Sie mindestens:
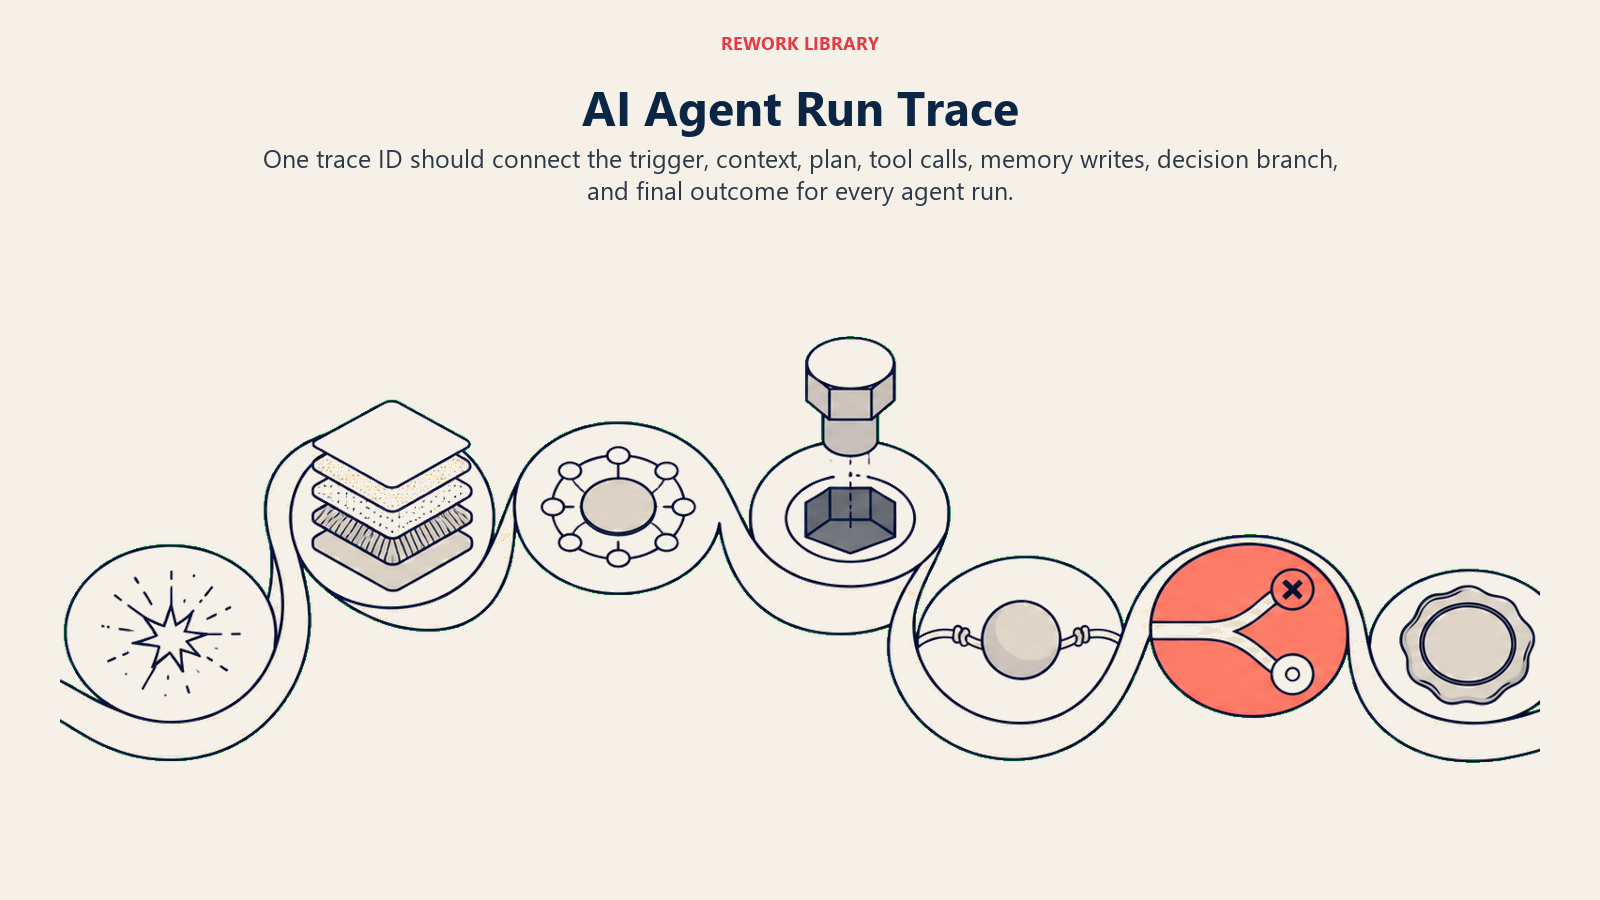
| Phase | Was zu erfassen ist |
|---|---|
| Trigger | Was den Durchlauf gestartet hat: eine neue Nachricht, eine Datensatzänderung, ein Zeitplan |
| Abgerufener Kontext | Welche Datensätze, Dokumente oder Erinnerungen der Agent vor der Entscheidung gelesen hat |
| Schlussfolgern | Der gewählte Plan oder die nächste Aktion und warum, sofern Ihre Plattform das offenlegen kann |
| Tool-Aufrufe | Jedes aufgerufene Tool, die gesendeten Parameter und das rohe zurückgegebene Ergebnis |
| Memory-Schreibvorgänge | Was der Agent für spätere Schritte oder spätere Durchläufe gespeichert hat |
| Entscheidungszweig | Ob er automatisch gehandelt, eine Rückfrage gestellt oder übergeben hat |
| Ergebnis | Ziel erreicht, vorzeitig gestoppt, eskaliert oder gescheitert, und warum |
Diese letzte Spalte, das „warum“, ist der Teil, den Teams überspringen und dann bereuen. Ein Log, der „an Mensch übergeben“ sagt, sagt Ihnen fast nichts. Ein Log, der sagt „übergeben: Antwort enthielt eine Preisfrage, außerhalb des Umfangs des Agents laut Regel 4“, sagt Ihnen, ob der Agent korrekt übergibt oder einfach alles übergibt, um sicher zu sein. Der Baustein Entscheidungslogik aus Wie AI Agents funktionieren ist genau das, was Sie hier prüfen, und eine Regel, die Sie nie geloggt haben, können Sie nicht prüfen.
Die Kennzahlen, die für Agents wirklich zählen
Allgemeine AI-Kennzahlen (Latenz, Kosten pro Anfrage, Fehlerrate) gelten weiterhin, erzählen aber nicht die ganze Geschichte für etwas, das in einem Loop läuft. Eine Handvoll agentenspezifischer Kennzahlen fängt Probleme ab, die diese allgemeinen Zahlen übersehen.
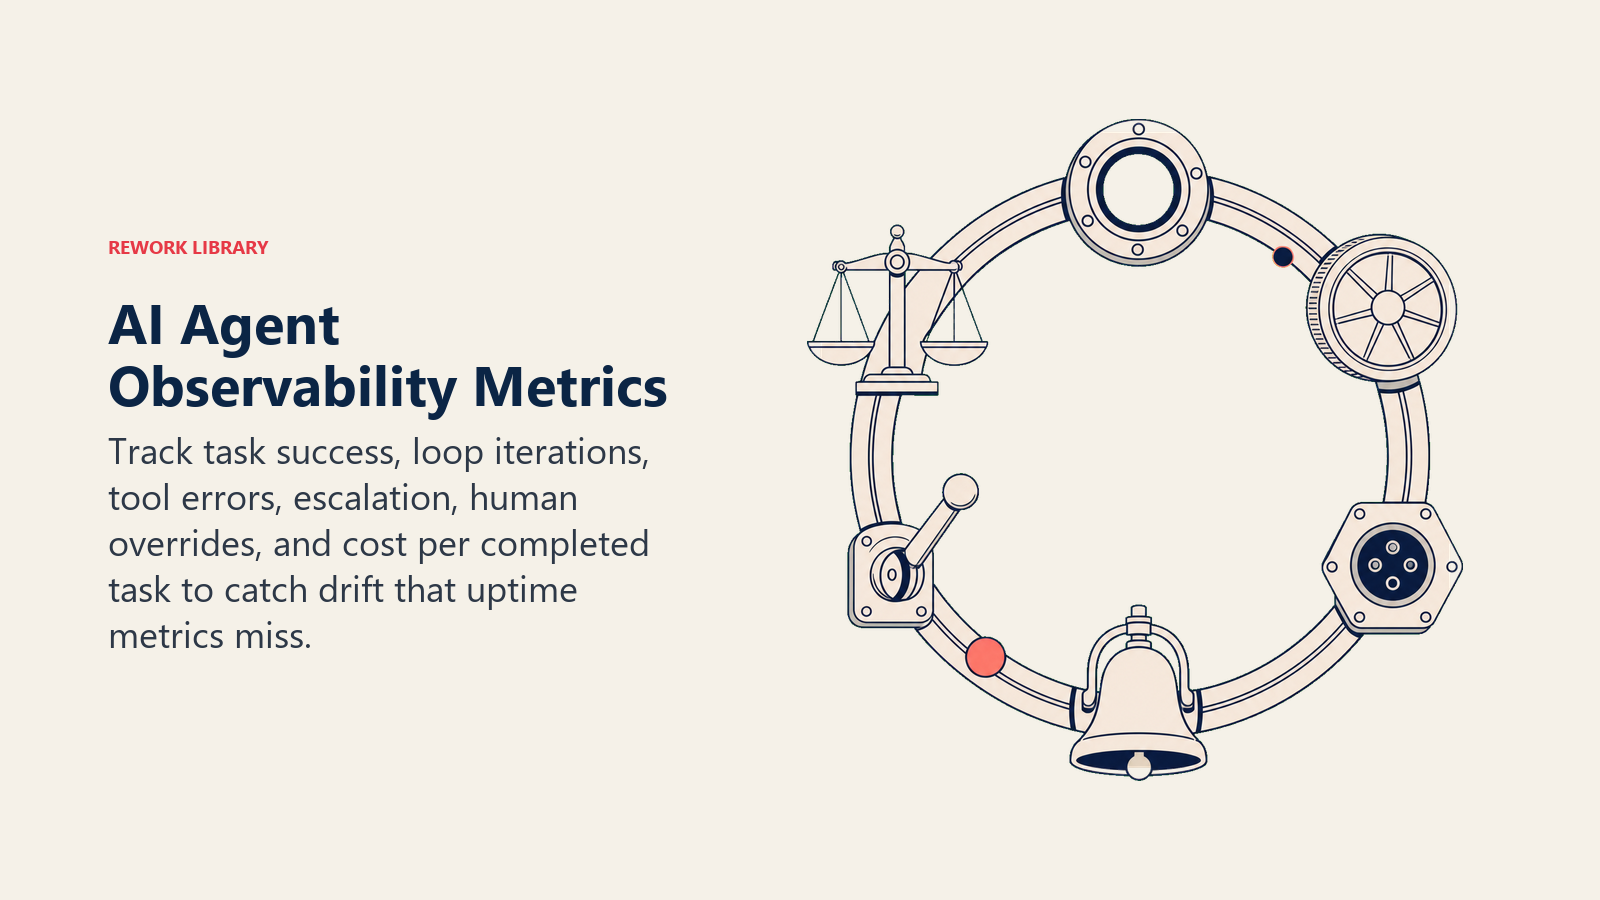
| Kennzahl | Was sie Ihnen sagt |
|---|---|
| Task Success Rate | Von allen Durchläufen, wie viele das Ziel tatsächlich erreicht haben, nicht nur ohne Absturz zu Ende kamen |
| Loop-Iterationen pro Durchlauf | Ein steigender Durchschnitt bedeutet oft, dass der Agent sich schwertut, nicht dass er gründlich ist |
| Fehlerrate der Tool-Aufrufe | Wie oft ein Tool-Aufruf fehlschlägt oder etwas liefert, das der Agent falsch behandelt |
| Eskalationsrate | Welcher Anteil der Durchläufe an einen Menschen übergibt und ob dieser Anteil steigt oder sinkt |
| Human Override Rate | Wie oft eine Person korrigiert oder rückgängig macht, was der Agent getan hat, auch wenn er nicht eskaliert hat |
| Kosten pro erledigter Aufgabe | Gesamte Tokens und Tool-Aufrufe pro erfolgreichem Ergebnis, nicht pro Durchlauf |
Eskalationsrate und Override-Rate verdienen mehr Aufmerksamkeit, als sie meist bekommen. Eine steigende Eskalationsrate ist nicht automatisch schlecht; sie kann bedeuten, dass der Agent schwierigere Fälle korrekt erkennt. Aber eine steigende Override-Rate, Menschen, die im Nachhinein still korrigieren, was der Agent getan hat, ist fast das klarste Signal, das Sie bekommen, dass sich in der Entscheidungslogik etwas verschoben hat. Niemand sagt dem Agent, dass er falsch liegt; sie räumen nur hinter ihm auf.
Fehlerarten, die nur bei Agents auftreten
Einige Fehlermuster sind spezifisch für schleifenbasierte Systeme und erscheinen in einem Observability-Setup für Einzelaufrufe gar nicht.
Außer Kontrolle geratene Loops. Der Agent versucht immer wieder eine Variante derselben fehlgeschlagenen Aktion, statt zu stoppen oder um Hilfe zu bitten. Ohne Iterationszähler pro Durchlauf sieht das in Ihren Logs wie normale Aktivität aus, bis die Token-Rechnung kommt.
Falsches Tool, richtiges Selbstvertrauen. Der Agent wählt ein plausibel klingendes Tool für die Situation und ruft es korrekt auf, aber es ist das falsche Tool für das Ziel. Der Aufruf gelingt, also gibt es keinen Fehler. Nur ein Trace im Abgleich mit dem tatsächlichen Ergebnis fängt das ab.
Stille Tool-Fehler. Ein Tool-Aufruf liefert ein Ergebnis, aber nicht das, das der Agent brauchte: eine leere Suche, ein veralteter Cache-Treffer, ein unvollständiger Datensatz, und der Agent macht weiter, als hätte er, was er brauchte. Die Perspektive aus Halluzinationsrisiko nach AI-Pattern ist hier auch außerhalb eines reinen Retrieval-Kontexts nützlich: Ein Agent, der nicht prüft, ob sein abgerufener Kontext tatsächlich ausreicht, handelt selbstsicher auf Lücken.
Drift der Entscheidungslogik. Das Verhalten des Agents in einer bestimmten Situationsart verändert sich langsam, nicht weil Sie eine Regel bearbeitet haben, sondern weil sich die Modellversion geändert hat, das Ausgabeformat eines Tools sich geändert hat oder ein Grenzfall häufiger auftritt. Dafür sind Evals gebaut: abgeschlossene Durchläufe regelmäßig anhand einer festen Bewertungsrubrik zu sampeln, nicht erst, wenn sichtbar etwas bricht.
Das sind, nicht zufällig, auch nahe Verwandte der Gründe, warum Agentic-AI-Projekte versanden. Gartner prognostiziert, dass über 40 % der Agentic-AI-Projekte bis Ende 2027 eingestellt werden, und nennt steigende Kosten, unklaren Geschäftsnutzen und unzureichende Risikokontrollen als Hauptgründe. Alle drei sind verkappte Observability-Probleme. Sie können keine Kosten steuern, die Sie nicht pro Aufgabe erfassen, keinen Geschäftsnutzen belegen, den Sie nicht an einer Erfolgsrate messen, und kein Risiko kontrollieren, das Sie nicht sehen.
Auch die Sichtbarkeitslücke ist messbar. In einer Umfrage der Cloud Security Alliance von 2026 zur Absicherung autonomer Agents gaben nur 28 % der Organisationen an, die Aktionen eines Agents über alle ihre Umgebungen hinweg zuverlässig auf einen Menschen oder ein System zurückführen zu können, und nur 45 % hatten überhaupt durchgängiges Session-Tracing. Die meisten Teams, die heute Agents betreiben, fliegen mit Teilinstrumenten.
Ein praktischer Einstiegs-Stack
Sie brauchen am ersten Tag keine vollständige Plattform. Eine sinnvolle Aufbaureihenfolge:
- Zuerst strukturiertes Logging pro Durchlauf. Trigger, Trace-ID, jeder Tool-Aufruf und jedes Ergebnis, finales Ergebnis. Allein das macht das Debugging eines konkreten schlechten Durchlaufs möglich statt Ratespiel.
- Den Agent mit dem höchsten Risiko sampeln und prüfen. Wählen Sie den einen Agent mit den folgenreichsten Aktionen, den, der Geld, Kundendaten oder externe Kommunikation anfasst, und lassen Sie eine Person pro Woche 20 bis 50 seiner Durchläufe lesen. Das fängt Drift lange vor einer Kennzahl ab.
- Distributed Tracing ergänzen, sobald Durchläufe länger werden. Wenn ein Agent mehrere Tools verkettet, brauchen Sie Zeit- und Ergebnisdaten für jeden Schritt, nicht nur Start- und Endzeit.
- Automatisierte Evals zuletzt hinzufügen, wenn Sie genug von Menschen geprüfte Durchläufe haben, um zu kalibrieren, was „gut“ bedeutet. Ein automatischer Scorer ohne menschliche Baseline liefert nur eine selbstsichere, unfundierte Zahl.
Dasselbe Evaluierungs- und Tracing-Tooling, das für allgemeine AI Observability genutzt wird, wie in der Übersicht zu AI Observability beschrieben, funktioniert auch für Agents. Anders ist, worauf Sie es richten: nicht auf eine einzelne Antwort, sondern auf den gesamten Durchlauf.
Wenn Sie Engineering-Tooling prüfen, auf dem Sie diese Instrumentierung aufbauen, behandelt unser Vergleich der Dev-Tools Plattformen, die solches Tracing und Monitoring unterstützen, und Wie Sie eine DevOps-Plattform auswählen führt durch die CI/CD- und Monitoring-Fragen, die es wert sind, vor einer Festlegung gestellt zu werden.
Key Facts
- Agent Observability traced den gesamten Loop (wahrnehmen, schlussfolgern, handeln, beobachten, wiederholen) über einen Durchlauf, nicht nur eine einzelne Modellausgabe.
- Loggen Sie jeden Tool-Aufruf, seine Parameter, sein Ergebnis, den gewählten Entscheidungszweig und den Grund dafür, alles unter einer Trace-ID pro Durchlauf.
- Task Success Rate, Loop-Iterationen, Eskalationsrate und Human Override Rate fangen Probleme ab, die Latenz und Fehlerrate übersehen.
- Nur 28 % der Organisationen können die Aktionen eines Agents über alle Umgebungen hinweg zuverlässig auf einen Menschen oder ein System zurückführen, laut einer Umfrage der Cloud Security Alliance von 2026.
- Gartner führt über 40 % der Projektabbrüche bei Agentic AI bis 2027 auf Kosten, unklaren Nutzen und schwache Risikokontrollen zurück, alles Dinge, die Observability erfassen soll.
Häufig gestellte Fragen zu AI Agent Observability
Was ist AI Agent Observability?
Es ist die Praxis, einen AI Agent so zu instrumentieren, dass Sie sehen können, was über seinen gesamten Durchlauf geschieht: den Trigger, den abgerufenen Kontext, jeden Tool-Aufruf und jedes Ergebnis, die getroffene Entscheidung und wie er endete. Sie erweitert die allgemeine AI Observability auf den mehrstufigen Loop, den Agents ausführen, statt auf einen einzelnen Modellaufruf.
Wie unterscheidet sich Agent Observability von normaler AI Observability?
Allgemeine AI Observability beobachtet Logs, Metriken und Traces eines Systems, meist rund um einzelne Modellaufrufe. Agent Observability beobachtet eine vollständige Kette von Entscheidungen und Tool-Aufrufen, die einen Durchlauf bilden, unter einer einzigen Trace-ID, weil sich ein Fehler in einem Agent in jedem Schritt dieser Kette verstecken kann, auch wenn kein einzelner Schritt einen Fehler wirft.
Was sollte man bei jedem Agent-Durchlauf loggen?
Mindestens: den Trigger, den vom Agent hereingeholten Kontext, den gewählten Plan oder die gewählte Aktion, jeden Tool-Aufruf mit Parametern und Ergebnis, alles, was ins Gedächtnis geschrieben wurde, welchen Entscheidungszweig er genommen hat (handeln, nachfragen oder übergeben) und das finale Ergebnis mit einem Grund.
Welche Kennzahlen sind für AI Agents am wichtigsten?
Task Success Rate, Loop-Iterationen pro Durchlauf, Fehlerrate der Tool-Aufrufe, Eskalationsrate und Human Override Rate. Gerade die Override-Rate, wie oft eine Person still korrigiert, was der Agent getan hat, ist eines der klarsten frühen Zeichen für Drift der Entscheidungslogik.
Braucht man für Agent Observability spezialisierte Tools?
Nicht zum Einstieg. Strukturiertes Logging mit einer einheitlichen Trace-ID bringt Sie schon weit. Spezialisierte Tracing- und Evaluierungsplattformen helfen, sobald Sie mehrere Agents im Produktivbetrieb haben und Durchläufe im großen Maßstab vergleichen müssen, aber sie sind ein Upgrade, keine Voraussetzung.
Wie es weitergeht
Observability sagt Ihnen, was Ihr Agent tatsächlich tut. In Kombination mit AI Agent Security schließen Sie die andere Hälfte des Bildes: nicht nur zu wissen, was der Agent getan hat, sondern ob er dazu verleitet wurde. Wenn Sie noch eingrenzen, welche Funktionen überhaupt bereit für einen Agent sind, ist Wann Sie einen AI Agent einsetzen sollten die nächste gute Lektüre, und auch die Blueprints AI Risk Monitoring Agent und AI Security Monitoring Agent sind das Studium wert, denn beide sind fast vollständig um das Watch-and-Alert-Pattern gebaut, das dieser Artikel beschreibt.
