Observabilidad y monitoreo de AI agents
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
La observabilidad de los AI agents es la práctica de instrumentar un agent para poder ver cada pasada de su ciclo: qué lo activó, qué decidió, qué herramientas llamó y qué devolvieron, y en qué momento transfirió a una persona. Va más allá de comprobar si una salida individual se ve correcta, porque un agent no produce una sola salida. Ejecuta una cadena de decisiones y acciones a lo largo de una tarea, y un fallo puede esconderse en cualquier punto de esa cadena. Sin observabilidad, usted confía en un sistema autónomo en cuyo interior no puede ver realmente.
Por qué esto no es lo mismo que vigilar un modelo
La observabilidad de la AI ya cubre el caso general: logs, métricas, trazas y evaluaciones que le indican qué está haciendo un sistema de AI a lo largo de su pipeline de datos, sus llamadas al modelo y sus salidas. Todo lo de esa base sigue aplicando a los agents. Lo que cambia es la unidad que usted vigila.
Una sola llamada a un modelo tiene una entrada y una salida. Se puede registrar, puntuar y seguir adelante. Una ejecución de un agent es una secuencia, a veces de cinco pasos, a veces de veinte, y cada uno es una decisión nueva construida sobre lo ocurrido en el paso anterior. Cómo funcionan los AI agents describe esa secuencia como un ciclo: percibir, razonar, actuar, observar, repetir. Note que la palabra "observar" ya está ahí. Es el agent revisando la salida de su propia herramienta antes de decidir qué hacer a continuación, una comprobación interna y momentánea. La observabilidad del agent es otra cosa: es usted vigilando el ciclo completo desde fuera, en cada ejecución y a lo largo del tiempo. El paso interno de observar del agent le dice si una llamada a una herramienta funcionó. Su capa de observabilidad le dice si el agent lleva dos semanas tomando en silencio la decisión equivocada.
Esa distinción importa porque un agent que técnicamente funciona bien, sin caídas ni errores, puede seguir haciendo lo incorrecto. Puede llamar a la herramienta correcta con parámetros sutilmente equivocados, repetir el mismo paso fallido unas veces de más antes de rendirse, o transferir a una persona mucho más, o mucho menos, de lo debido. Nada de eso aparece como un error. Todo aparece en una traza, si usted está capturando una.
Qué rastrear en una sola ejecución del agent
Trate cada ejecución del agent como una unidad rastreable con un único ID que la acompañe de principio a fin. Como mínimo, capture:
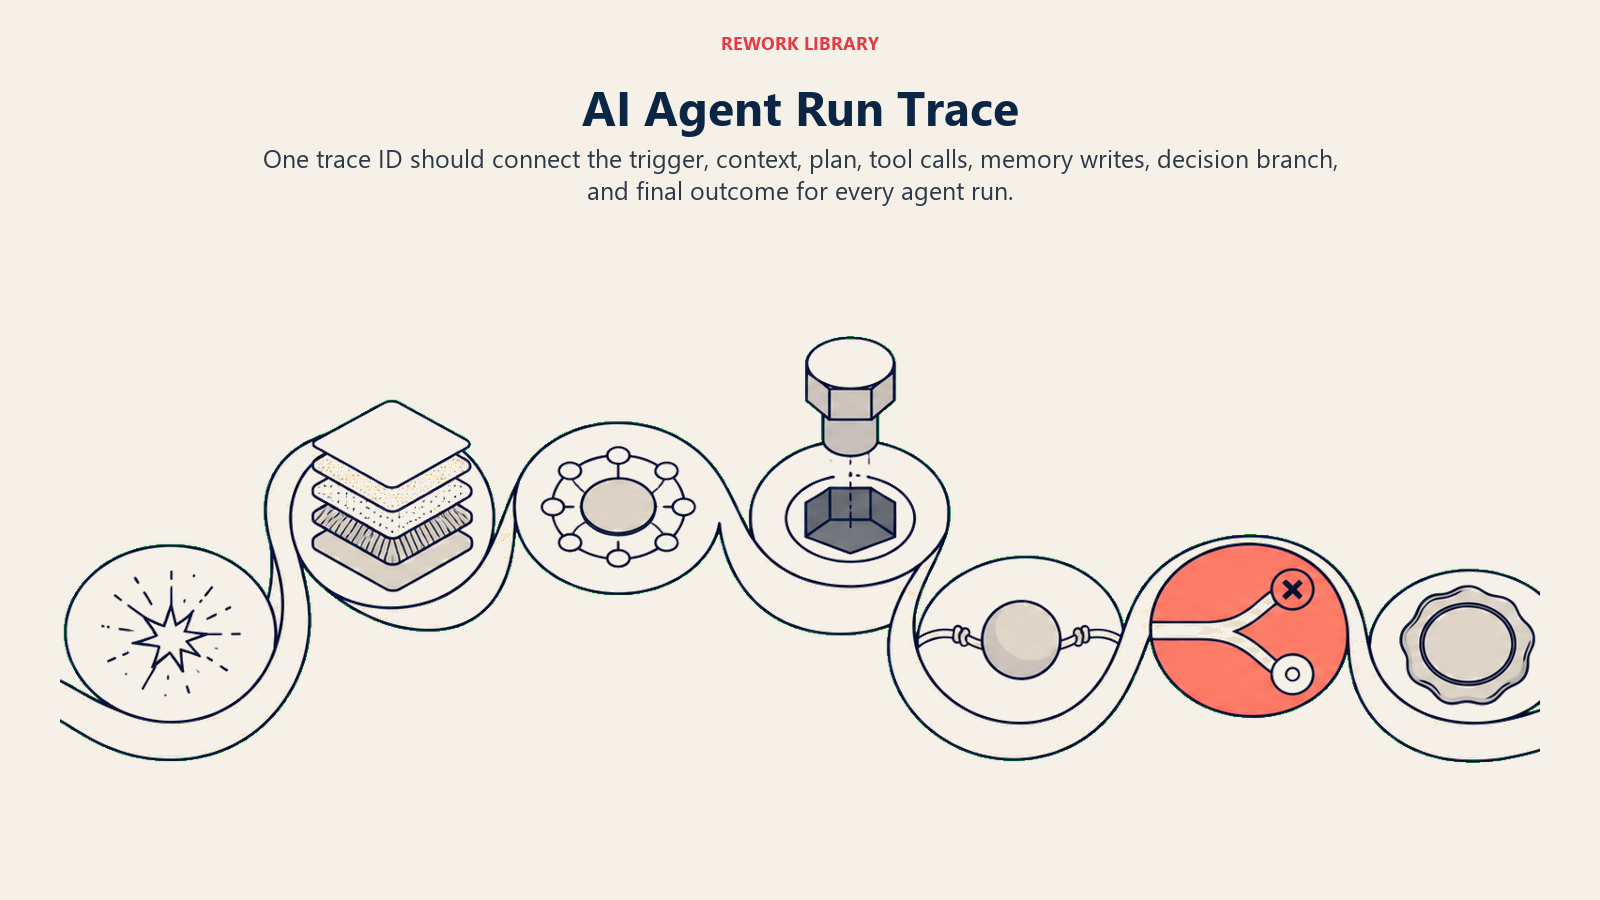
| Etapa | Qué registrar |
|---|---|
| Disparador | Qué inició la ejecución: un mensaje nuevo, un cambio en un registro, una programación |
| Contexto obtenido | Qué registros, documentos o memoria leyó el agent antes de decidir |
| Razonamiento | El plan o la siguiente acción elegida, y por qué, si su plataforma puede mostrarlo |
| Llamadas a herramientas | Cada herramienta llamada, los parámetros enviados y el resultado sin procesar devuelto |
| Escrituras en memoria | Qué almacenó el agent para pasos posteriores o ejecuciones posteriores |
| Rama de decisión | Si actuó automáticamente, hizo una pregunta aclaratoria o transfirió |
| Resultado | Objetivo cumplido, detenido antes de tiempo, escalado o fallido, y por qué |
Esa última columna, el "por qué", es la parte que los equipos omiten y luego lamentan. Un log que dice "transferido a una persona" casi no dice nada. Un log que dice "transferido: la respuesta contenía una pregunta de precios, fuera del alcance del agent según la regla 4" le dice si el agent transfiere correctamente o si simplemente transfiere todo para mantenerse a salvo. El componente de lógica de decisión que cubre cómo funcionan los AI agents es exactamente lo que usted audita aquí, y no se puede auditar una regla que nunca se registró.
Las métricas que realmente importan para los agents
Las métricas generales de AI (latencia, costo por solicitud, tasa de errores) siguen aplicando, pero no cuentan la historia completa de algo que se ejecuta en un ciclo. Un puñado de métricas específicas de los agents detecta problemas que esas cifras generales pasan por alto.
| Métrica | Qué le dice |
|---|---|
| Tasa de éxito de tareas | De todas las ejecuciones, cuántas realmente alcanzaron el objetivo, no solo terminaron sin caerse |
| Iteraciones del ciclo por ejecución | Un promedio en aumento suele significar que el agent tiene dificultades, no que sea simplemente minucioso |
| Tasa de errores en llamadas a herramientas | Con qué frecuencia falla una llamada a una herramienta o devuelve algo que el agent maneja mal |
| Tasa de escalada | Qué proporción de las ejecuciones se transfiere a una persona, y si esa proporción sube o baja |
| Tasa de corrección humana | Con qué frecuencia una persona revierte o corrige lo que hizo el agent, incluso cuando no escaló |
| Costo por tarea completada | Total de tokens y llamadas a herramientas gastados por resultado exitoso, no por ejecución |
La tasa de escalada y la tasa de corrección merecen más atención de la que suelen recibir. Una tasa de escalada en aumento no es automáticamente mala; puede significar que el agent reconoce correctamente los casos más difíciles. Pero una tasa de corrección en aumento, personas arreglando en silencio lo que hizo el agent después de los hechos, es casi la señal más clara que obtendrá de que algo en la lógica de decisión ha derivado. Nadie le dice al agent que se equivocó; simplemente limpian lo que dejó atrás.
Modos de fallo que solo aparecen en los agents
Algunos patrones de fallo son específicos de los sistemas basados en ciclos y no aparecerán en absoluto en una configuración de observabilidad de una sola llamada.
Bucles descontrolados. El agent sigue intentando una variación de la misma acción fallida en lugar de detenerse o pedir ayuda. Sin un conteo de iteraciones por ejecución, esto parece actividad normal en sus logs hasta que llega la factura de tokens.
Herramienta equivocada, confianza correcta. El agent elige una herramienta que suena plausible para la situación y la llama correctamente, pero es la herramienta equivocada para el objetivo. La llamada tiene éxito, así que nada da error. Solo una traza comparada con el resultado real lo detecta.
Fallos silenciosos de herramientas. Una llamada a una herramienta devuelve un resultado, pero no el que el agent necesitaba: una búsqueda vacía, un acierto de caché desactualizado, un registro parcial, y el agent continúa como si tuviera lo que necesitaba. El enfoque de riesgo de alucinación por patrón de AI es útil aquí incluso fuera de un contexto puramente de recuperación: un agent que no verifica si su contexto recuperado es realmente suficiente actuará con total seguridad sobre vacíos.
Deriva de la lógica de decisión. El comportamiento del agent ante un tipo de situación cambia lentamente, no porque usted haya editado una regla, sino porque cambió la versión del modelo subyacente, cambió el formato de salida de una herramienta o un caso límite empezó a aparecer con más frecuencia. Para esto están hechas las evaluaciones: muestrear ejecuciones completadas frente a una rúbrica fija de forma programada, no solo cuando algo se rompe a la vista.
Estas son también, no por casualidad, cercanas a las razones por las que los proyectos de agentic AI se estancan. Gartner predice que más del 40% de los proyectos de agentic AI será cancelado a finales de 2027, y cita los costos crecientes, el valor de negocio poco claro y los controles de riesgo inadecuados como las razones principales. Los tres son problemas de observabilidad disfrazados. No se puede gestionar un costo que no se rastrea por tarea, no se puede demostrar un valor de negocio que no se mide frente a una tasa de éxito y no se puede controlar un riesgo que no se ve.
La brecha de visibilidad también es medible. En una encuesta de 2026 de la Cloud Security Alliance sobre cómo proteger a los agents autónomos, solo el 28% de las organizaciones dijo poder rastrear de forma confiable las acciones de un agent hasta una persona o un sistema en todos sus entornos, y apenas el 45% tenía algún tipo de trazabilidad de sesión de extremo a extremo. La mayoría de los equipos que hoy ejecutan agents vuela con instrumentos parciales.
Un stack inicial práctico
No necesita una plataforma completa desde el primer día. Un orden de construcción razonable:
- Primero, logging estructurado por ejecución. Disparador, ID de traza, cada llamada a una herramienta y su resultado, resultado final. Solo esto hace posible depurar una ejecución mala específica en lugar de adivinar.
- Muestree y revise su agent de mayor riesgo. Elija el agent con las acciones de mayor consecuencia, el que toca dinero, datos de clientes o comunicaciones externas, y haga que una persona lea de 20 a 50 de sus ejecuciones por semana. Esto detecta la deriva mucho antes de que lo haga una métrica.
- Agregue trazabilidad distribuida cuando las ejecuciones se alarguen. Cuando un agent encadena varias herramientas, necesita datos de tiempo y de resultado en cada paso, no solo una hora de inicio y de fin.
- Incorpore evaluaciones automatizadas al final, cuando tenga suficientes ejecuciones revisadas por personas para calibrar cómo se ve lo "bueno". Un evaluador automático sin una línea base humana solo le da un número seguro y sin fundamento.
Las mismas herramientas de evaluación y trazabilidad que se usan para la observabilidad general de la AI, del tipo que cubre el resumen de observabilidad de la AI, sirven también para los agents. Lo que cambia es hacia qué las apunta: no a una sola respuesta, sino a la ejecución completa.
Si está evaluando herramientas de ingeniería para construir esta instrumentación, nuestra comparación de herramientas de desarrollo cubre las plataformas que admiten este tipo de trazabilidad y monitoreo, y cómo elegir una plataforma DevOps recorre las preguntas de CI/CD y monitoreo que vale la pena hacer antes de comprometerse con una.
Datos clave
- La observabilidad de agents rastrea el ciclo completo (percibir, razonar, actuar, observar, repetir) a lo largo de una ejecución, no solo una salida individual del modelo.
- Registre cada llamada a una herramienta, sus parámetros, su resultado, la rama de decisión tomada y el motivo de esa decisión, todo bajo un único ID de traza por ejecución.
- La tasa de éxito de tareas, las iteraciones del ciclo, la tasa de escalada y la tasa de corrección humana detectan problemas que la latencia y la tasa de errores pasan por alto.
- Solo el 28% de las organizaciones puede rastrear de forma confiable las acciones de un agent hasta una persona o un sistema en todos los entornos, según una encuesta de 2026 de la Cloud Security Alliance.
- Gartner atribuye más del 40% de las cancelaciones de proyectos de agentic AI para 2027 a los costos, el valor poco claro y los controles de riesgo débiles, todo lo que la observabilidad está hecha para detectar.
Preguntas frecuentes sobre la observabilidad de los AI agents
¿Qué es la observabilidad de los AI agents?
Es la práctica de instrumentar un AI agent para poder ver lo que ocurre a lo largo de toda su ejecución: el disparador, el contexto que obtuvo, cada llamada a una herramienta y su resultado, la decisión que tomó y cómo terminó. Extiende la observabilidad general de la AI para cubrir el ciclo de varios pasos que ejecutan los agents, en lugar de una sola llamada a un modelo.
¿En qué se diferencia la observabilidad de agents de la observabilidad de AI habitual?
La observabilidad general de la AI vigila los logs, las métricas y las trazas de un sistema, normalmente centrados en llamadas individuales a un modelo. La observabilidad de agents vigila una cadena completa de decisiones y llamadas a herramientas que componen una ejecución, bajo un único ID de traza, porque un fallo en un agent puede esconderse en cualquier paso de esa cadena incluso cuando ningún paso individual da error.
¿Qué se debe registrar en cada ejecución de un agent?
Como mínimo: el disparador, el contexto que el agent obtuvo, el plan o la acción que eligió, cada llamada a una herramienta con sus parámetros y su resultado, todo lo escrito en memoria, qué rama de decisión tomó (actuar, preguntar o transferir) y el resultado final con un motivo.
¿Qué métricas importan más para los AI agents?
La tasa de éxito de tareas, las iteraciones del ciclo por ejecución, la tasa de errores en llamadas a herramientas, la tasa de escalada y la tasa de corrección humana. La tasa de corrección en particular, con qué frecuencia una persona corrige en silencio lo que hizo el agent, es una de las señales tempranas más claras de deriva de la lógica de decisión.
¿Se necesitan herramientas especializadas para la observabilidad de agents?
No para empezar. El logging estructurado con un ID de traza consistente le lleva la mayor parte del camino. Las plataformas de trazabilidad y evaluación creadas para este fin ayudan cuando tiene varios agents en producción y necesita comparar ejecuciones a escala, pero son una mejora, no un requisito previo.
A dónde ir a continuación
La observabilidad le dice qué está haciendo realmente su agent. Combinarla con la seguridad de los AI agents completa la otra mitad del panorama: saber no solo qué hizo el agent, sino si lo engañaron para hacerlo. Si todavía está delimitando qué funciones están listas para un agent, cuándo usar un AI agent es una buena siguiente lectura, y vale la pena estudiar también los planes del AI Risk Monitoring Agent y del AI Security Monitoring Agent, ya que ambos están construidos casi por completo en torno al patrón de vigilar y alertar que describe este artículo.
