Observabilidade e Monitoramento de AI Agents
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
A observabilidade de AI agents é a prática de instrumentar um agent para que você consiga ver cada passagem do seu ciclo: o que o disparou, o que ele decidiu, quais ferramentas chamou e o que voltou, e onde ele passou o bastão para uma pessoa. Ela vai além de verificar se uma única saída parece correta, porque um agent não produz uma saída. Ele executa uma cadeia de decisões e ações ao longo de uma tarefa, e uma falha pode se esconder em qualquer ponto dessa cadeia. Sem observabilidade, você está confiando em um sistema autônomo por dentro do qual não consegue realmente enxergar.
Por Que Isso Não É o Mesmo que Observar um Modelo
A observabilidade de AI já cobre o caso geral: logs, métricas, traces e avaliações que dizem o que um sistema de AI está fazendo ao longo do seu pipeline de dados, das suas chamadas ao modelo e das suas saídas. Tudo o que há nessa base continua valendo para os agents. O que muda é a unidade que você observa.
Uma única chamada ao modelo tem uma entrada e uma saída. Você pode registrá-la, avaliá-la e seguir em frente. A execução de um agent é uma sequência, às vezes de cinco etapas, às vezes de vinte, cada uma delas uma decisão nova construída sobre o que aconteceu na etapa anterior. Como os AI agents funcionam descreve essa sequência como um ciclo: perceber, raciocinar, agir, observar, repetir. Note que a palavra "observar" já está ali. É o agent verificando a saída da própria ferramenta antes de decidir o que fazer em seguida, uma verificação interna e momentânea. A observabilidade de agents é outra coisa: é você observando o ciclo inteiro de fora, em todas as execuções, ao longo do tempo. A etapa interna de observar do agent diz a ele se uma chamada de ferramenta funcionou. A sua camada de observabilidade diz a você se o agent vem tomando em silêncio a decisão errada há duas semanas.
Essa distinção importa porque um agent que tecnicamente está rodando bem, sem travamentos e sem erros, ainda pode estar fazendo a coisa errada. Ele pode chamar a ferramenta certa com parâmetros sutilmente errados, repetir a mesma etapa que falhou algumas vezes a mais antes de desistir, ou passar para um humano muito mais, ou muito menos, do que deveria. Nada disso aparece como erro. Tudo isso aparece num trace, se você estiver capturando um.
O Que Rastrear em uma Única Execução do Agent
Trate cada execução do agent como uma unidade rastreável, com um único ID que a acompanha do início ao fim. No mínimo, capture:
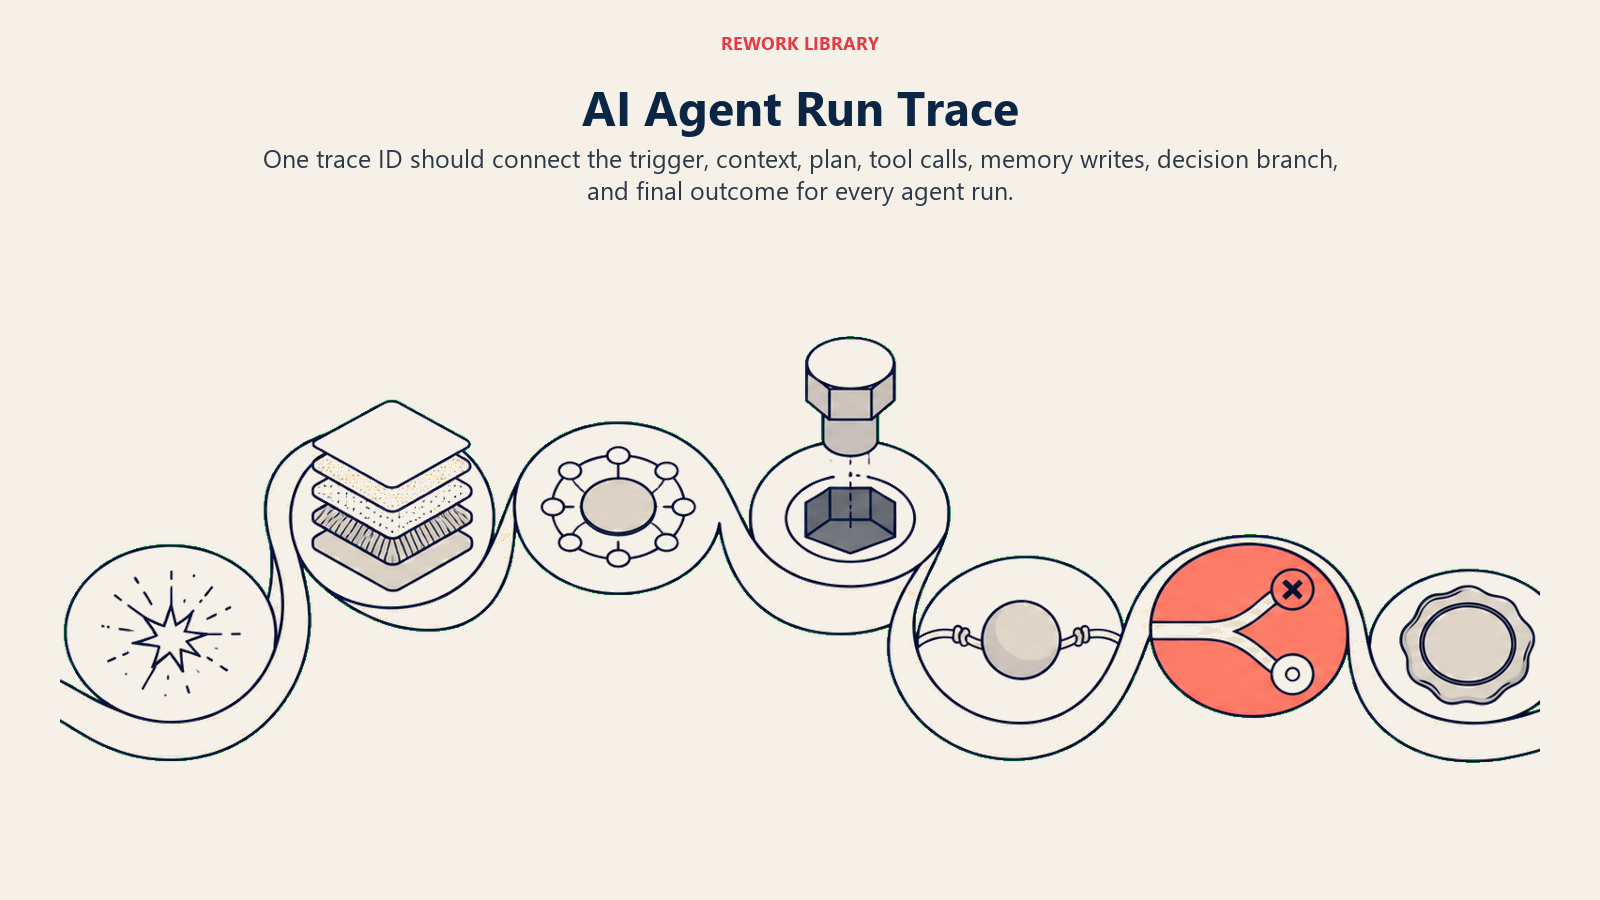
| Etapa | O que registrar |
|---|---|
| Gatilho | O que iniciou a execução: uma nova mensagem, uma alteração de registro, um agendamento |
| Contexto obtido | Quais registros, documentos ou memória o agent leu antes de decidir |
| Raciocínio | O plano ou a próxima ação escolhida, e por quê, se a sua plataforma conseguir expor isso |
| Chamadas de ferramentas | Cada ferramenta chamada, os parâmetros enviados e o resultado bruto devolvido |
| Gravações na memória | O que o agent armazenou para etapas ou execuções posteriores |
| Ramo de decisão | Se agiu automaticamente, fez uma pergunta de esclarecimento ou passou para um humano |
| Resultado | Meta atingida, interrompida cedo, escalada ou falha, e por quê |
Essa última linha, o "por quê", é a parte que as equipes pulam e depois lamentam. Um log que diz "passado para um humano" diz quase nada. Um log que diz "passado para um humano: a resposta continha uma pergunta de preço, fora do escopo do agent conforme a regra 4" diz se o agent está passando para um humano do jeito certo ou apenas passando tudo para ficar seguro. O bloco de construção de lógica de decisão abordado em como os AI agents funcionam é exatamente o que você audita aqui, e não se audita uma regra que nunca foi registrada.
As Métricas que Realmente Importam para Agents
As métricas gerais de AI (latência, custo por requisição, taxa de erro) continuam valendo, mas não contam a história completa de algo que roda em ciclo. Um punhado de métricas específicas de agents pega problemas que esses números gerais deixam passar.
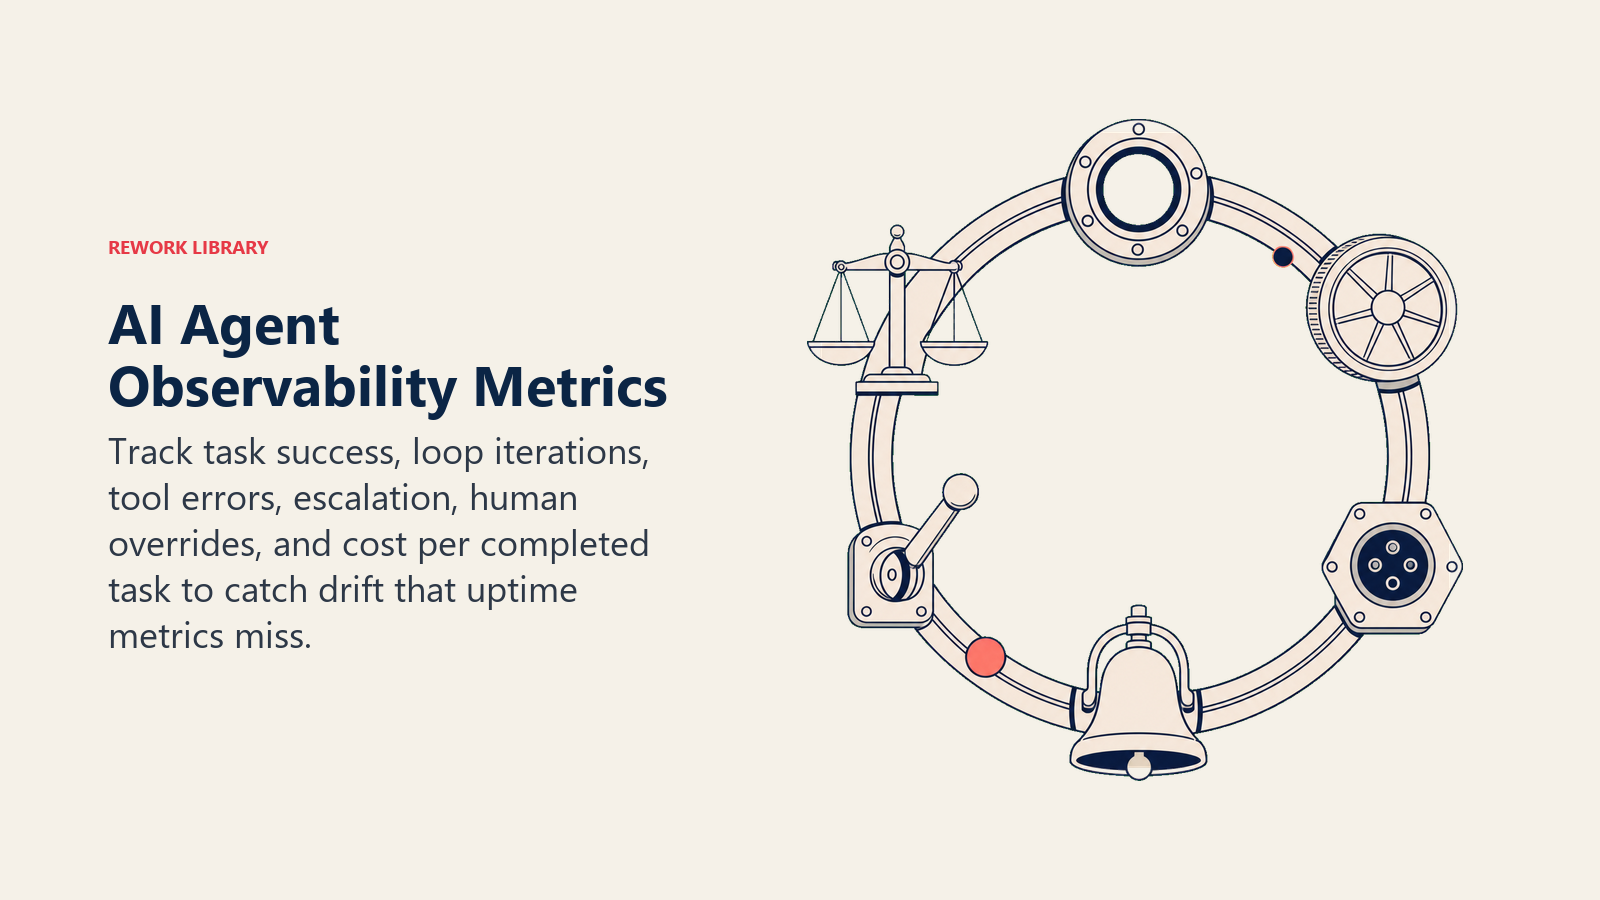
| Métrica | O que ela diz |
|---|---|
| Taxa de sucesso das tarefas | De todas as execuções, quantas realmente atingiram a meta, e não apenas terminaram sem travar |
| Iterações do ciclo por execução | Uma média crescente costuma indicar que o agent está com dificuldade, e não apenas sendo minucioso |
| Taxa de erro nas chamadas de ferramentas | Com que frequência uma chamada de ferramenta falha ou devolve algo que o agent trata mal |
| Taxa de escalação | Que fatia das execuções passa para um humano e se essa fatia está subindo ou caindo |
| Taxa de sobreposição humana | Com que frequência uma pessoa reverte ou corrige o que o agent fez, mesmo sem ter havido escalação |
| Custo por tarefa concluída | Total de tokens e chamadas de ferramentas gastos por resultado bem-sucedido, e não por execução |
A taxa de escalação e a taxa de sobreposição merecem mais atenção do que costumam receber. Uma taxa de escalação crescente não é automaticamente ruim; pode significar que o agent está reconhecendo corretamente casos mais difíceis. Mas uma taxa de sobreposição crescente, humanos corrigindo em silêncio, depois do fato, o que o agent fez, é quase o sinal mais claro que você terá de que algo na lógica de decisão derivou. Ninguém está dizendo ao agent que ele errou; estão apenas limpando o que ele deixou para trás.
Modos de Falha que Só Aparecem em Agents
Alguns padrões de falha são específicos de sistemas baseados em ciclo e não aparecem de forma alguma em uma configuração de observabilidade de chamada única.
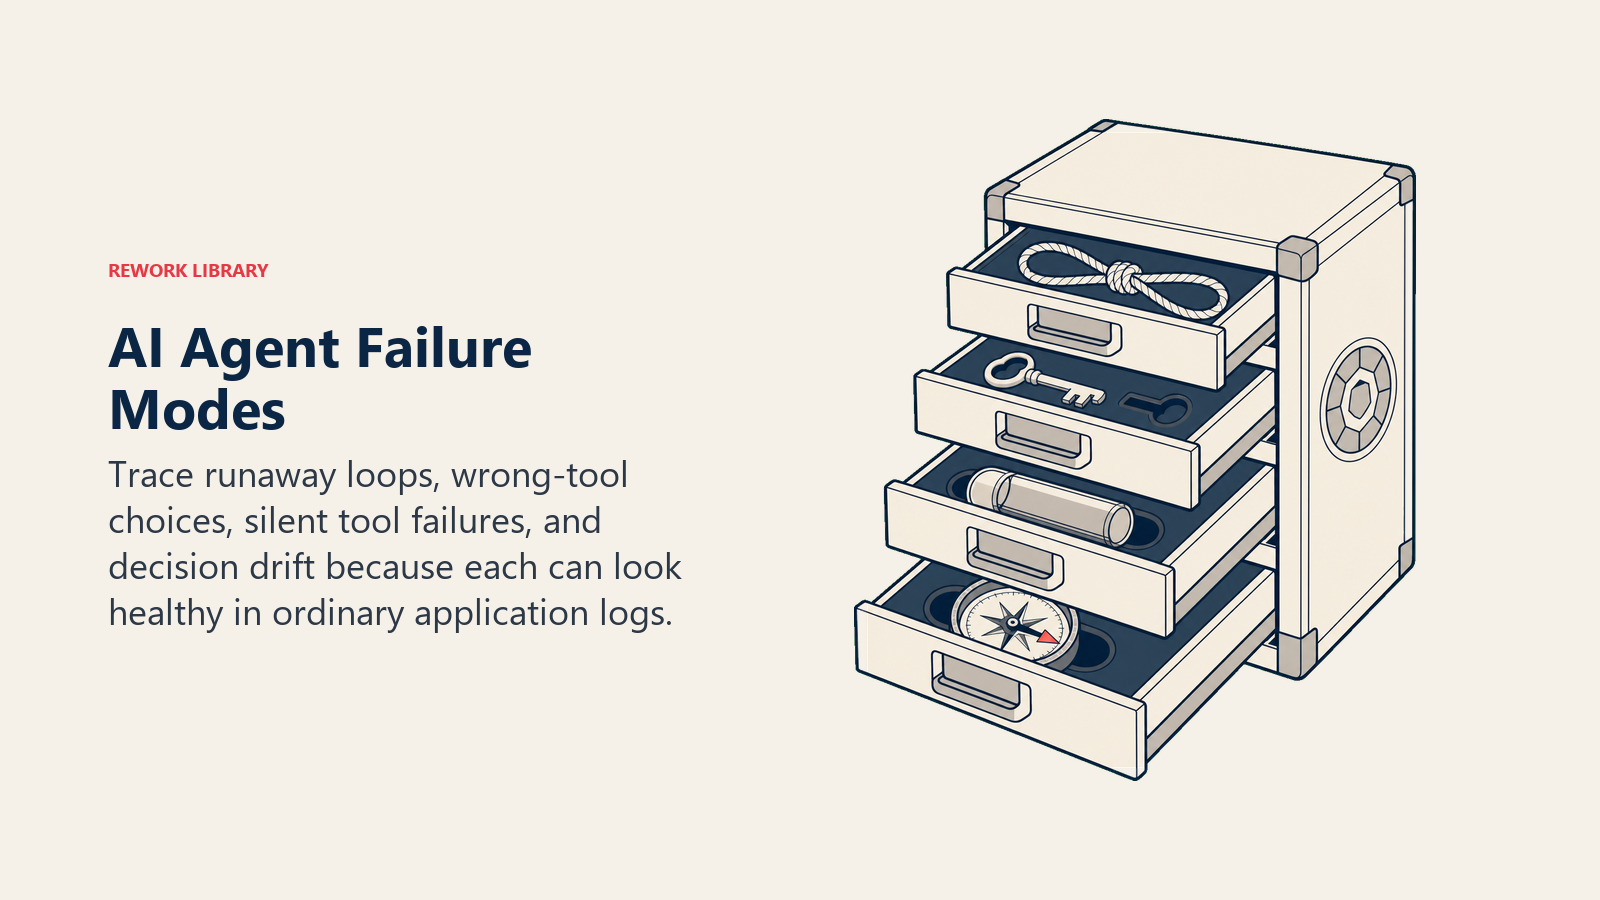
Loops descontrolados. O agent continua tentando uma variação da mesma ação que falhou em vez de parar ou pedir ajuda. Sem uma contagem de iterações por execução, isso parece atividade normal nos seus logs até a conta de tokens chegar.
Ferramenta errada, confiança certa. O agent escolhe uma ferramenta de aparência plausível para a situação e a chama corretamente, mas é a ferramenta errada para o objetivo. A chamada tem sucesso, então nada dá erro. Só um trace confrontado com o resultado real pega isso.
Falhas silenciosas de ferramentas. Uma chamada de ferramenta devolve um resultado, mas não o de que o agent precisava: uma busca vazia, um acerto de cache desatualizado, um registro parcial, e o agent segue como se tivesse o que precisava. O enquadramento de Risco de Alucinação por Padrão de AI é útil aqui mesmo fora de um contexto puro de recuperação: um agent que não verifica se o contexto recuperado é de fato suficiente agirá com confiança sobre lacunas.
Deriva da lógica de decisão. O comportamento do agent para um determinado tipo de situação muda aos poucos, não porque você editou uma regra, mas porque a versão do modelo subjacente mudou, o formato de saída de uma ferramenta mudou ou um caso-limite passou a aparecer com mais frequência. É para isso que servem as avaliações (evals): amostrar execuções concluídas contra uma rubrica fixa em uma periodicidade, e não apenas quando algo quebra de forma visível.
Não por coincidência, esses também são motivos próximos de projetos de agentic AI travarem. A Gartner prevê que mais de 40% dos projetos de agentic AI serão cancelados até o fim de 2027, citando custos crescentes, valor de negócio pouco claro e controles de risco inadequados como as principais razões. Os três são problemas de observabilidade disfarçados. Você não consegue gerir um custo que não acompanha por tarefa, não consegue provar um valor de negócio que não mede contra uma taxa de sucesso e não consegue controlar um risco que não enxerga.
A lacuna de visibilidade também é mensurável. Em uma pesquisa de 2026 da Cloud Security Alliance sobre a proteção de agents autônomos, apenas 28% das organizações disseram conseguir rastrear de forma confiável as ações de um agent até um humano ou sistema em todos os seus ambientes, e somente 45% tinham rastreamento de sessão de ponta a ponta. A maioria das equipes que rodam agents hoje voa com instrumentos parciais.
Um Stack Inicial Prático
Você não precisa de uma plataforma completa no primeiro dia. Uma ordem razoável de construção:
- Primeiro, logging estruturado por execução. Gatilho, ID do trace, cada chamada de ferramenta e seu resultado, resultado final. Só isso já torna possível depurar uma execução ruim específica em vez de adivinhar.
- Amostre e revise o seu agent de maior risco. Escolha o agent com as ações mais consequentes, o que mexe com dinheiro, dados de clientes ou comunicação externa, e peça a uma pessoa que leia de 20 a 50 execuções dele por semana. Isso pega a deriva muito antes de uma métrica pegar.
- Adicione tracing distribuído quando as execuções ficarem longas. Quando um agent encadeia várias ferramentas, você precisa de dados de tempo e resultado em cada etapa, e não apenas dos horários de início e fim.
- Por último, camadas de evals automatizadas, quando você tiver execuções revisadas por humanos em número suficiente para calibrar como é o "bom". Um avaliador automático sem uma linha de base humana só lhe dá um número confiante e sem fundamento.
As mesmas ferramentas de avaliação e tracing usadas na observabilidade geral de AI, do tipo abordado na visão geral de observabilidade de AI, funcionam também para agents. O que muda é para o que você as aponta: não uma única resposta, mas a execução inteira.
Se você está avaliando ferramentas de engenharia para construir essa instrumentação, nossa comparação de ferramentas de dev cobre plataformas que oferecem suporte a esse tipo de tracing e monitoramento, e como escolher uma plataforma de DevOps percorre as perguntas de CI/CD e monitoramento que vale fazer antes de se comprometer com uma.
Key Facts
- A observabilidade de agents rastreia o ciclo inteiro (perceber, raciocinar, agir, observar, repetir) ao longo de uma execução, e não apenas uma única saída do modelo.
- Registre cada chamada de ferramenta, seus parâmetros, seu resultado, o ramo de decisão tomado e o motivo dessa decisão, tudo sob um único ID de trace por execução.
- A taxa de sucesso das tarefas, as iterações do ciclo, a taxa de escalação e a taxa de sobreposição humana pegam problemas que a latência e a taxa de erro deixam passar.
- Apenas 28% das organizações conseguem rastrear de forma confiável as ações de um agent até um humano ou sistema em todos os ambientes, segundo uma pesquisa de 2026 da Cloud Security Alliance.
- A Gartner atribui mais de 40% dos cancelamentos de projetos de agentic AI até 2027 a custos, valor pouco claro e controles de risco fracos, tudo isso coisas que a observabilidade foi feita para pegar.
Perguntas Frequentes sobre Observabilidade de AI Agents
O que é observabilidade de AI agents?
É a prática de instrumentar um AI agent para que você veja o que acontece ao longo de toda a sua execução: o gatilho, o contexto obtido, cada chamada de ferramenta e resultado, a decisão tomada e como terminou. Ela estende a observabilidade geral de AI para cobrir o ciclo de várias etapas que os agents executam, em vez de uma única chamada ao modelo.
Em que a observabilidade de agents difere da observabilidade de AI comum?
A observabilidade geral de AI acompanha os logs, as métricas e os traces de um sistema, normalmente centrada em chamadas individuais ao modelo. A observabilidade de agents acompanha uma cadeia completa de decisões e chamadas de ferramentas que formam uma execução, sob um único ID de trace, porque uma falha em um agent pode se esconder em qualquer etapa dessa cadeia, mesmo quando nenhuma etapa isolada gera erro.
O que registrar em cada execução do agent?
No mínimo: o gatilho, o contexto que o agent obteve, o plano ou a ação escolhida, cada chamada de ferramenta com seus parâmetros e resultado, qualquer coisa gravada na memória, qual ramo de decisão foi tomado (agir, perguntar ou passar para um humano) e o resultado final com um motivo.
Quais métricas mais importam para AI agents?
Taxa de sucesso das tarefas, iterações do ciclo por execução, taxa de erro nas chamadas de ferramentas, taxa de escalação e taxa de sobreposição humana. A taxa de sobreposição em particular, com que frequência uma pessoa corrige em silêncio o que o agent fez, é um dos sinais precoces mais claros de deriva da lógica de decisão.
É preciso ferramentas especializadas para a observabilidade de agents?
Não para começar. Logging estruturado com um ID de trace consistente leva você a maior parte do caminho. Plataformas de tracing e avaliação feitas sob medida ajudam quando você tem vários agents rodando em produção e precisa comparar execuções em escala, mas são uma evolução, não um pré-requisito.
Para Onde Ir Agora
A observabilidade diz o que o seu agent está de fato fazendo. Combiná-la com segurança de AI agents fecha a outra metade do quadro: saber não só o que o agent fez, mas se ele foi enganado para fazê-lo. Se você ainda está definindo quais funções estão prontas para um agent, quando usar um AI agent é uma boa próxima leitura, e vale estudar também os blueprints do AI Risk Monitoring Agent e do AI Security Monitoring Agent, já que ambos são construídos quase inteiramente em torno do padrão de observar e alertar que este artigo descreve.
