Bahasa Indonesia
Observabilitas dan Monitoring AI Agent
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Observabilitas AI agent adalah praktik memasang instrumentasi pada agent sehingga Anda dapat melihat setiap putaran loop-nya: apa yang memicunya, apa yang diputuskannya, tool mana yang dipanggil dan apa yang dikembalikan, serta di mana ia menyerahkan ke manusia. Cakupannya lebih jauh daripada sekadar memeriksa apakah satu output tampak benar, karena agent tidak menghasilkan satu output. Agent menjalankan rantai keputusan dan tindakan sepanjang sebuah tugas, dan kegagalan bisa bersembunyi di mana saja dalam rantai itu. Tanpa observabilitas, Anda mempercayakan diri pada sistem otonom yang tidak benar-benar bisa Anda lihat bagian dalamnya.
Mengapa Ini Berbeda dari Memantau Sebuah Model
Observabilitas AI sudah mencakup kasus umum: log, metrik, trace, dan evaluasi yang memberi tahu Anda apa yang dilakukan sistem AI di seluruh data pipeline, panggilan model, dan outputnya. Semua yang ada dalam fondasi itu tetap berlaku untuk agent. Yang berubah adalah unit yang Anda pantau.
Satu panggilan model memiliki satu input dan satu output. Anda bisa mencatatnya, menilainya, lalu lanjut. Satu proses agent adalah sebuah urutan, kadang lima langkah, kadang dua puluh, masing-masing merupakan keputusan baru yang dibangun di atas apa yang terjadi pada langkah sebelumnya. Cara kerja AI agent menggambarkan urutan itu sebagai loop: perceive, reason, act, observe, ulangi. Perhatikan bahwa kata "observe" sudah ada di dalamnya. Itu adalah agent yang memeriksa output tool-nya sendiri sebelum memutuskan langkah berikutnya, pemeriksaan internal yang sesaat. Observabilitas agent adalah hal yang berbeda: Anda mengamati seluruh loop dari luar, di setiap proses, sepanjang waktu. Langkah observe internal agent memberi tahu agent apakah satu panggilan tool berhasil. Lapisan observabilitas Anda memberi tahu Anda apakah agent sudah diam-diam mengambil keputusan yang salah selama dua minggu.
Perbedaan itu penting karena agent yang secara teknis berjalan baik, tanpa crash, tanpa error, tetap bisa melakukan hal yang salah. Ia mungkin memanggil tool yang tepat dengan parameter yang keliru secara halus, mengulang langkah gagal yang sama beberapa kali ekstra sebelum menyerah, atau menyerahkan ke manusia jauh lebih sering, atau jauh lebih jarang, daripada seharusnya. Tidak satu pun dari itu muncul sebagai error. Semuanya muncul dalam sebuah trace, jika Anda menangkapnya.
Apa yang Perlu Dilacak dalam Satu Proses Agent
Perlakukan setiap proses agent sebagai satu unit yang dapat dilacak dengan satu ID yang mengikutinya dari awal hingga akhir. Setidaknya, catat:
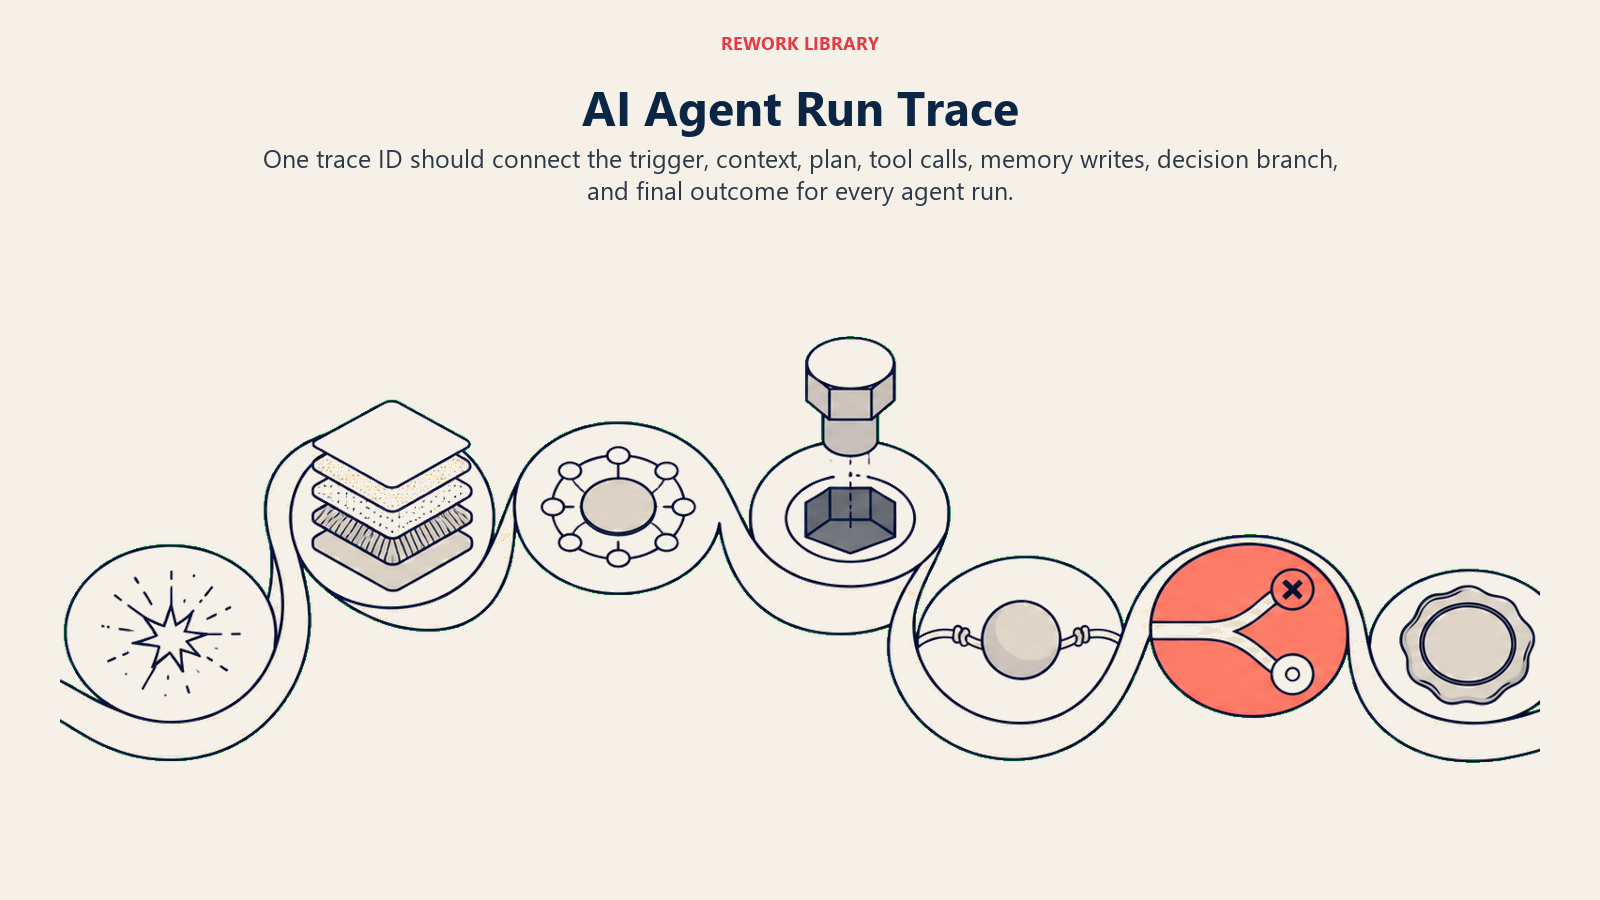
| Tahap | Apa yang dicatat |
|---|---|
| Pemicu | Apa yang memulai proses: pesan baru, perubahan record, jadwal |
| Konteks yang diambil | Record, dokumen, atau memori mana yang dibaca agent sebelum memutuskan |
| Penalaran | Rencana atau tindakan berikutnya yang dipilih, dan alasannya, jika platform Anda dapat menampilkannya |
| Panggilan tool | Setiap tool yang dipanggil, parameter yang dikirim, dan hasil mentah yang dikembalikan |
| Penulisan memori | Apa yang disimpan agent untuk langkah atau proses berikutnya |
| Cabang keputusan | Apakah ia bertindak otomatis, mengajukan pertanyaan klarifikasi, atau menyerahkan ke manusia |
| Hasil | Tujuan tercapai, berhenti lebih awal, dieskalasi, atau gagal, beserta alasannya |
Kolom terakhir itu, yaitu "alasan," adalah bagian yang dilewati tim lalu disesali. Log yang berbunyi "diserahkan ke manusia" hampir tidak memberi tahu Anda apa pun. Log yang berbunyi "diserahkan: balasan berisi pertanyaan harga, di luar lingkup agent menurut aturan 4" memberi tahu Anda apakah agent menyerahkan dengan benar atau hanya menyerahkan segalanya demi aman. Blok penyusun logika keputusan yang dibahas dalam cara kerja AI agent adalah persis yang Anda audit di sini, dan Anda tidak dapat mengaudit aturan yang tidak pernah Anda catat.
Metrik yang Benar-Benar Penting untuk Agent
Metrik AI umum (latensi, biaya per permintaan, tingkat error) tetap berlaku, tetapi tidak menceritakan gambaran lengkap untuk sesuatu yang berjalan dalam loop. Beberapa metrik khusus agent menangkap masalah yang terlewat oleh angka-angka umum itu.
| Metrik | Apa yang diberitahukannya |
|---|---|
| Task success rate | Dari semua proses, berapa banyak yang benar-benar mencapai tujuan, bukan sekadar selesai tanpa crash |
| Iterasi loop per proses | Rata-rata yang meningkat sering berarti agent sedang kesulitan, bukan sekadar teliti |
| Tingkat error panggilan tool | Seberapa sering panggilan tool gagal atau mengembalikan sesuatu yang salah ditangani agent |
| Tingkat eskalasi | Berapa persen proses yang diserahkan ke manusia, dan apakah persentase itu naik atau turun |
| Tingkat override manusia | Seberapa sering seseorang membalik atau mengoreksi apa yang dilakukan agent, bahkan ketika tidak ada eskalasi |
| Biaya per tugas selesai | Total token dan panggilan tool yang dihabiskan per hasil yang berhasil, bukan per proses |
Tingkat eskalasi dan tingkat override pantas mendapat perhatian lebih daripada yang biasanya diberikan. Tingkat eskalasi yang meningkat tidak otomatis buruk; bisa jadi agent dengan tepat mengenali kasus yang lebih sulit. Tetapi tingkat override yang meningkat, yaitu manusia diam-diam memperbaiki apa yang dilakukan agent setelah kejadian, hampir merupakan sinyal paling jelas yang akan Anda dapatkan bahwa ada sesuatu dalam logika keputusan yang telah bergeser. Tidak ada yang memberi tahu agent bahwa ia salah; mereka hanya membereskan di belakangnya.
Mode Kegagalan yang Hanya Muncul pada Agent
Beberapa pola kegagalan khusus untuk sistem berbasis loop dan sama sekali tidak akan muncul dalam pengaturan observabilitas satu panggilan.
Loop tak terkendali. Agent terus mencoba variasi dari tindakan gagal yang sama alih-alih berhenti atau meminta bantuan. Tanpa hitungan iterasi per proses, ini tampak seperti aktivitas normal di log Anda sampai tagihan token tiba.
Tool yang salah, keyakinan yang tepat. Agent memilih tool yang terdengar masuk akal untuk situasinya dan memanggilnya dengan benar, tetapi itu adalah tool yang salah untuk tujuannya. Panggilan berhasil, sehingga tidak ada yang error. Hanya trace yang dibandingkan dengan hasil sebenarnya yang menangkapnya.
Kegagalan tool yang senyap. Panggilan tool mengembalikan hasil, tetapi bukan hasil yang dibutuhkan agent: pencarian kosong, cache usang, record parsial, dan agent melanjutkan seolah ia sudah memiliki apa yang dibutuhkan. Kerangka Risiko Halusinasi menurut AI Pattern berguna di sini bahkan di luar konteks retrieval murni: agent yang tidak memeriksa apakah konteks yang diambilnya benar-benar memadai akan bertindak dengan yakin di atas celah.
Drift logika keputusan. Perilaku agent pada satu jenis situasi perlahan berubah, bukan karena Anda mengedit aturan, melainkan karena versi model dasarnya berubah, format output tool berubah, atau kasus tepi mulai lebih sering muncul. Inilah yang dirancang untuk ditangani oleh eval: mengambil sampel proses yang selesai terhadap rubrik tetap secara terjadwal, bukan hanya ketika sesuatu rusak secara terlihat.
Ini juga, bukan kebetulan, mendekati alasan proyek agentic AI mandek. Gartner memprediksi bahwa lebih dari 40% proyek agentic AI akan dibatalkan pada akhir 2027, dengan menyebut biaya yang membengkak, nilai bisnis yang tidak jelas, dan kontrol risiko yang tidak memadai sebagai alasan utama. Ketiganya adalah masalah observabilitas dalam penyamaran. Anda tidak dapat mengelola biaya yang tidak Anda lacak per tugas, Anda tidak dapat membuktikan nilai bisnis yang tidak Anda ukur terhadap success rate, dan Anda tidak dapat mengendalikan risiko yang tidak dapat Anda lihat.
Kesenjangan visibilitas ini juga terukur. Dalam survei Cloud Security Alliance 2026 tentang pengamanan agent otonom, hanya 28% organisasi yang mengatakan mereka dapat melacak tindakan agent secara andal kembali ke manusia atau sistem di seluruh lingkungan mereka, dan hanya 45% yang memiliki session tracing ujung ke ujung sama sekali. Sebagian besar tim yang menjalankan agent saat ini terbang dengan instrumen yang tidak lengkap.
Stack Awal yang Praktis
Anda tidak membutuhkan platform lengkap sejak hari pertama. Urutan pembangunan yang masuk akal:
- Logging terstruktur per proses lebih dulu. Pemicu, trace ID, setiap panggilan tool beserta hasilnya, hasil akhir. Hanya ini saja sudah membuat debugging proses buruk tertentu menjadi mungkin, bukan tebak-tebakan.
- Ambil sampel dan tinjau agent dengan taruhan tertinggi. Pilih satu agent dengan tindakan paling berdampak, yang menyentuh uang, data pelanggan, atau komunikasi eksternal, dan minta seseorang membaca 20 hingga 50 prosesnya setiap minggu. Ini menangkap drift jauh sebelum sebuah metrik melakukannya.
- Tambahkan distributed tracing begitu proses menjadi panjang. Ketika agent merangkai beberapa tool, Anda membutuhkan data waktu dan hasil di setiap langkah, bukan hanya waktu mulai dan selesai.
- Tambahkan eval otomatis paling akhir, setelah Anda memiliki cukup banyak proses yang ditinjau manusia untuk mengkalibrasi seperti apa "baik" itu. Penilai otomatis tanpa baseline manusia hanya memberi Anda angka yang percaya diri tetapi tidak berlandaskan apa pun.
Tooling evaluasi dan tracing yang sama yang digunakan untuk observabilitas AI umum, seperti yang dibahas dalam ulasan observabilitas AI, juga berfungsi untuk agent. Yang berbeda adalah apa yang Anda arahkan padanya: bukan satu respons, melainkan seluruh proses.
Jika Anda sedang mengevaluasi tooling engineering untuk membangun instrumentasi ini, perbandingan tool dev kami membahas platform yang mendukung tracing dan monitoring semacam ini, dan cara memilih platform DevOps menguraikan pertanyaan CI/CD dan monitoring yang layak diajukan sebelum Anda berkomitmen pada satu platform.
Key Facts
- Observabilitas agent melacak seluruh loop (perceive, reason, act, observe, ulangi) di sepanjang sebuah proses, bukan hanya satu output model.
- Catat setiap panggilan tool, parameternya, hasilnya, cabang keputusan yang diambil, dan alasan keputusan itu, semuanya di bawah satu trace ID per proses.
- Task success rate, iterasi loop, tingkat eskalasi, dan tingkat override manusia menangkap masalah yang terlewat oleh latensi dan tingkat error.
- Hanya 28% organisasi yang dapat melacak tindakan agent secara andal kembali ke manusia atau sistem di seluruh lingkungan, menurut survei Cloud Security Alliance 2026.
- Gartner menghubungkan lebih dari 40% pembatalan proyek agentic AI pada 2027 dengan biaya, nilai yang tidak jelas, dan kontrol risiko yang lemah, semuanya hal yang dirancang untuk ditangkap oleh observabilitas.
Pertanyaan yang Sering Diajukan tentang Observabilitas AI Agent
Apa itu observabilitas AI agent?
Ini adalah praktik memasang instrumentasi pada AI agent sehingga Anda dapat melihat apa yang terjadi di seluruh proses-nya: pemicu, konteks yang diambil, setiap panggilan tool dan hasilnya, keputusan yang dibuat, dan bagaimana proses berakhir. Praktik ini memperluas observabilitas AI umum untuk mencakup loop multi-langkah yang dijalankan agent, bukan satu panggilan model.
Apa bedanya observabilitas agent dengan observabilitas AI biasa?
Observabilitas AI umum memantau log, metrik, dan trace sebuah sistem, biasanya berpusat pada panggilan model individual. Observabilitas agent memantau seluruh rantai keputusan dan panggilan tool yang membentuk satu proses, di bawah satu trace ID, karena kegagalan pada agent dapat bersembunyi di langkah mana pun dalam rantai itu bahkan ketika tidak ada satu langkah pun yang melempar error.
Apa yang sebaiknya dicatat untuk setiap proses agent?
Minimal: pemicu, konteks yang diambil agent, rencana atau tindakan yang dipilih, setiap panggilan tool beserta parameter dan hasilnya, apa pun yang ditulis ke memori, cabang keputusan mana yang diambil (bertindak, bertanya, atau menyerahkan), dan hasil akhir beserta alasannya.
Metrik apa yang paling penting untuk AI agent?
Task success rate, iterasi loop per proses, tingkat error panggilan tool, tingkat eskalasi, dan tingkat override manusia. Tingkat override khususnya, yaitu seberapa sering seseorang diam-diam mengoreksi apa yang dilakukan agent, adalah salah satu tanda dini paling jelas dari drift logika keputusan.
Apakah Anda membutuhkan tool khusus untuk observabilitas agent?
Tidak untuk memulai. Logging terstruktur dengan trace ID yang konsisten sudah membawa Anda sebagian besar jalan. Platform tracing dan evaluasi yang dibuat khusus membantu setelah Anda memiliki banyak agent berjalan di produksi dan perlu membandingkan proses dalam skala besar, tetapi itu adalah peningkatan, bukan prasyarat.
Langkah Selanjutnya
Observabilitas memberi tahu Anda apa yang sebenarnya dilakukan agent Anda. Memadukannya dengan keamanan AI agent melengkapi separuh gambaran lainnya: mengetahui bukan hanya apa yang dilakukan agent, tetapi apakah ia ditipu untuk melakukannya. Jika Anda masih memetakan fungsi mana yang siap menggunakan agent sejak awal, kapan menggunakan AI agent adalah bacaan berikutnya yang baik, dan blueprint AI Risk Monitoring Agent serta AI Security Monitoring Agent juga layak dipelajari, karena keduanya dibangun hampir sepenuhnya di sekitar pola watch-and-alert yang dijelaskan artikel ini.
