Kebolehperhatian dan Pemantauan AI Agent
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Kebolehperhatian AI agent ialah amalan memasang instrumen pada agent supaya anda dapat melihat setiap laluan gelungnya: apa yang mencetuskannya, apa yang diputuskannya, alat mana yang dipanggilnya dan apa yang dipulangkan, serta di mana ia menyerahkan kepada seseorang. Ia lebih jauh daripada sekadar memerhati sama ada satu output kelihatan betul, kerana agent tidak menghasilkan satu output. Ia menjalankan rantaian keputusan dan tindakan merentas satu tugas, dan kegagalan boleh bersembunyi di mana-mana dalam rantaian itu. Tanpa kebolehperhatian, anda mempercayai sistem autonomi yang tidak dapat anda lihat ke dalamnya.
Mengapa Ini Tidak Sama dengan Memerhati Model
Kebolehperhatian AI sudah merangkumi kes umum: log, metrik, jejak, dan penilaian yang memberitahu anda apa yang dilakukan oleh sistem AI merentas saluran datanya, panggilan modelnya, dan outputnya. Segala-galanya dalam asas itu masih terpakai kepada agent. Apa yang berubah ialah unit yang anda perhatikan.
Satu panggilan model mempunyai satu input dan satu output. Anda boleh melog, menilai, dan meneruskan. Larian agent ialah jujukan, kadangkala lima langkah, kadangkala dua puluh, setiap satu ialah keputusan baharu yang dibina atas apa yang berlaku pada langkah sebelumnya. Cara AI agent berfungsi menerangkan jujukan itu sebagai gelung: tanggap, nalar, bertindak, perhati, ulang. Perhatikan perkataan "perhati" sudah ada di dalamnya. Itu ialah agent menyemak output alatnya sendiri sebelum memutuskan apa yang perlu dilakukan seterusnya, semakan dalaman yang seketika. Kebolehperhatian agent ialah perkara yang berbeza: ia ialah anda memerhati keseluruhan gelung dari luar, merentas setiap larian, dari semasa ke semasa. Langkah perhati dalaman agent memberitahunya sama ada satu panggilan alat berjaya. Lapisan kebolehperhatian anda memberitahu anda sama ada agent telah secara senyap membuat pilihan yang salah selama dua minggu.
Perbezaan itu penting kerana agent yang secara teknikalnya berjalan lancar, tiada ranap, tiada ralat, masih boleh melakukan perkara yang salah. Ia mungkin memanggil alat yang betul dengan parameter yang sedikit tersasar, mengulang langkah gagal yang sama beberapa kali lagi sebelum mengalah, atau menyerahkan kepada manusia jauh lebih kerap, atau jauh lebih jarang, daripada yang sepatutnya. Tiada satu pun daripada itu muncul sebagai ralat. Kesemuanya muncul dalam jejak, jika anda menangkapnya.
Apa yang Perlu Dijejak dalam Satu Larian Agent
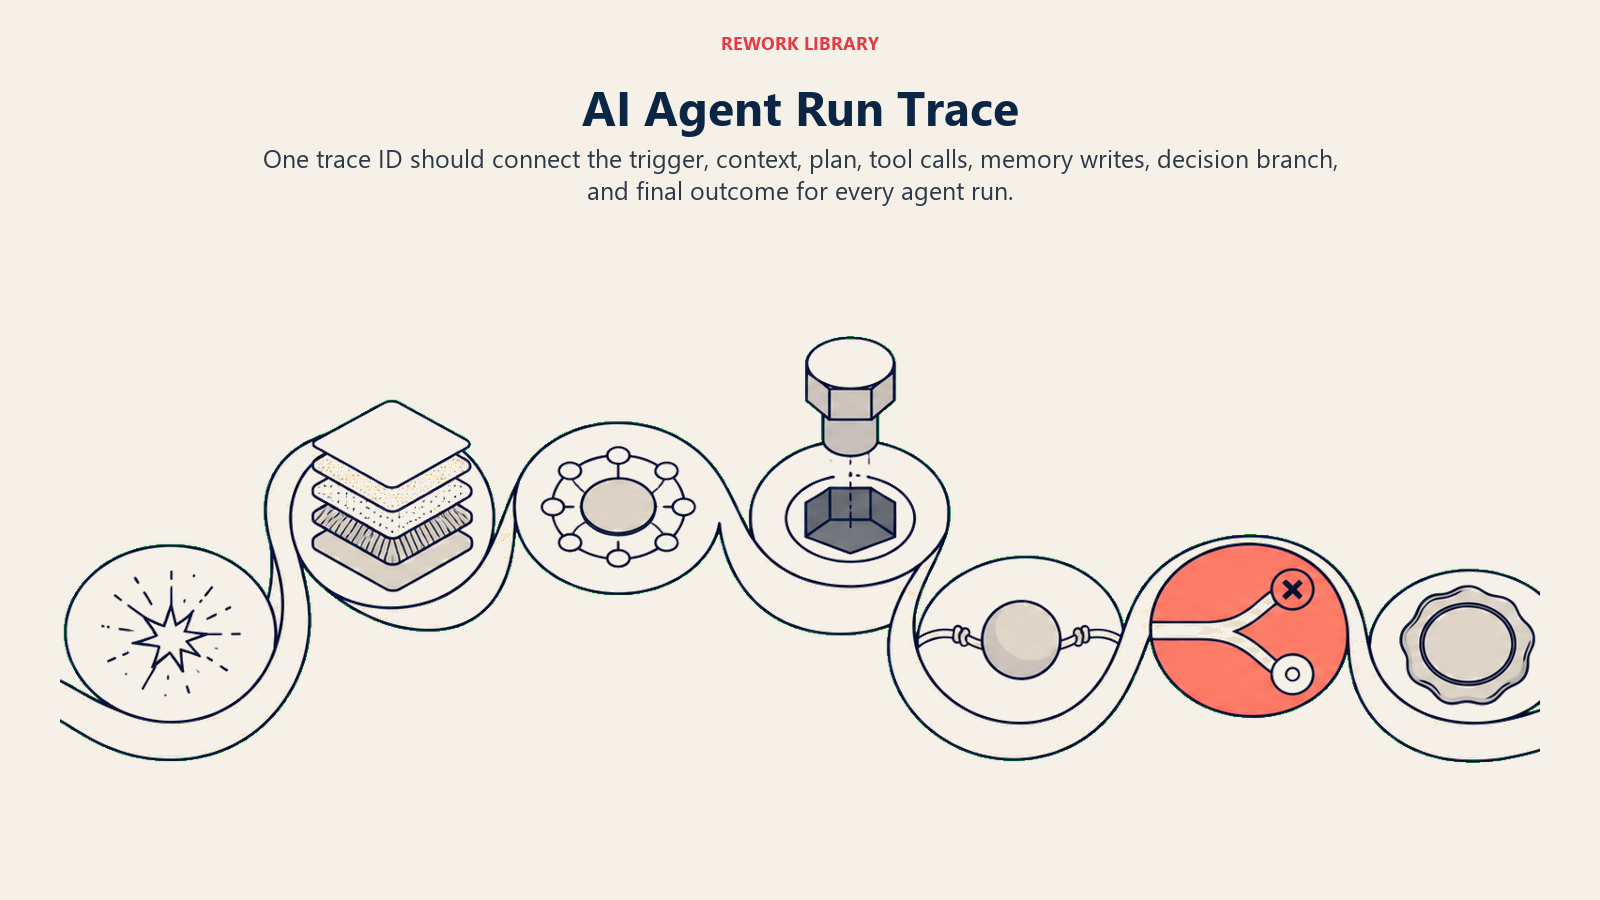
Layan setiap larian agent sebagai satu unit yang boleh dijejak dengan satu ID yang mengikutinya dari mula hingga akhir. Sekurang-kurangnya, rakamkan:
| Peringkat | Apa yang direkodkan |
|---|---|
| Pencetus | Apa yang memulakan larian: mesej baharu, perubahan rekod, jadual |
| Konteks yang diambil | Rekod, dokumen, atau memori mana yang dibaca agent sebelum memutuskan |
| Penaakulan | Pelan atau tindakan seterusnya yang dipilih, dan sebabnya, jika platform anda boleh mendedahkannya |
| Panggilan alat | Setiap alat yang dipanggil, parameter yang dihantar, dan hasil mentah yang dipulangkan |
| Penulisan memori | Apa yang disimpan agent untuk langkah atau larian kemudian |
| Cabang keputusan | Sama ada ia bertindak secara automatik, bertanya soalan penjelasan, atau menyerahkan |
| Hasil | Matlamat tercapai, berhenti awal, dieskalasi, atau gagal, dan sebabnya |
Lajur terakhir itu, "sebab," ialah bahagian yang dilangkau oleh pasukan lalu disesali. Log yang berbunyi "diserahkan kepada manusia" memberitahu anda hampir tiada apa-apa. Log yang berbunyi "diserahkan: balasan mengandungi soalan harga, di luar skop agent menurut peraturan 4" memberitahu anda sama ada agent menyerahkan dengan betul atau sekadar menyerahkan segala-galanya untuk kekal selamat. Blok binaan logik keputusan yang dibincangkan dalam cara AI agent berfungsi ialah tepat apa yang anda audit di sini, dan anda tidak boleh mengaudit peraturan yang tidak pernah anda log.
Metrik yang Benar-Benar Penting untuk Agent
Metrik AI umum (kependaman, kos setiap permintaan, kadar ralat) masih terpakai, tetapi ia tidak menceritakan kisah penuh bagi sesuatu yang berjalan dalam gelung. Segelintir metrik khusus agent menangkap masalah yang terlepas daripada angka umum itu.
| Metrik | Apa yang diberitahunya kepada anda |
|---|---|
| Kadar kejayaan tugas | Daripada semua larian, berapa banyak yang benar-benar mencapai matlamat, bukan sekadar selesai tanpa ranap |
| Lelaran gelung setiap larian | Purata yang meningkat selalunya bermakna agent bergelut, bukan sekadar teliti |
| Kadar ralat panggilan alat | Kekerapan panggilan alat gagal atau memulangkan sesuatu yang disalahkendalikan oleh agent |
| Kadar eskalasi | Berapa bahagian larian yang diserahkan kepada manusia, dan sama ada bahagian itu cenderung naik atau turun |
| Kadar penggantian manusia | Kekerapan seseorang membalikkan atau membetulkan apa yang dilakukan agent, walaupun ia tidak dieskalasi |
| Kos setiap tugas yang selesai | Jumlah token dan panggilan alat yang dibelanjakan bagi setiap hasil yang berjaya, bukan setiap larian |
Kadar eskalasi dan kadar penggantian patut mendapat perhatian lebih daripada yang biasa diberikan. Kadar eskalasi yang meningkat tidak semestinya buruk; ia mungkin bermakna agent mengenali kes yang lebih sukar dengan betul. Tetapi kadar penggantian yang meningkat, manusia secara senyap membetulkan apa yang dilakukan agent selepas kejadian, hampir merupakan isyarat paling jelas yang akan anda dapat bahawa sesuatu dalam logik keputusan telah hanyut. Tiada siapa memberitahu agent ia salah; mereka cuma membersihkan di belakangnya.
Mod Kegagalan yang Hanya Muncul dalam Agent
Beberapa corak kegagalan khusus untuk sistem berasaskan gelung dan tidak akan muncul langsung dalam persediaan kebolehperhatian panggilan tunggal.
Gelung tidak terkawal. Agent terus mencuba variasi tindakan gagal yang sama dan bukan berhenti atau meminta bantuan. Tanpa kiraan lelaran bagi setiap larian, ini kelihatan seperti aktiviti biasa dalam log anda sehingga bil token tiba.
Alat yang salah, keyakinan yang betul. Agent memilih alat yang kedengaran sesuai untuk situasi itu dan memanggilnya dengan betul, tetapi ia alat yang salah untuk matlamat. Panggilan itu berjaya, jadi tiada ralat. Hanya jejak yang dibandingkan dengan hasil sebenar yang menangkapnya.
Kegagalan alat yang senyap. Panggilan alat memulangkan hasil, tetapi bukan yang diperlukan agent: carian kosong, kena cache yang lapuk, rekod separa, dan agent meneruskan seolah-olah ia sudah mempunyai apa yang diperlukan. Rangka kerja Risiko Halusinasi mengikut Corak AI berguna di sini walaupun di luar konteks pengambilan semata-mata: agent yang tidak menyemak sama ada konteks yang diambilnya benar-benar mencukupi akan bertindak dengan yakin atas kekosongan.
Hanyutan logik keputusan. Tingkah laku agent bagi sesuatu jenis situasi berubah perlahan-lahan, bukan kerana anda mengedit peraturan, tetapi kerana versi model asas berubah, format output alat berubah, atau kes pinggiran mula muncul lebih kerap. Inilah yang dibina untuk dikendalikan oleh evals: mensampel larian yang selesai berbanding rubrik tetap mengikut jadual, bukan hanya apabila sesuatu rosak dengan jelas.
Ini juga, bukan secara kebetulan, hampir sama dengan sebab projek agentic AI terbantut. Gartner meramalkan bahawa lebih 40% projek agentic AI akan dibatalkan menjelang akhir 2027, dengan menyebut kos yang meningkat, nilai perniagaan yang tidak jelas, dan kawalan risiko yang tidak memadai sebagai sebab utama. Ketiga-tiganya ialah masalah kebolehperhatian yang menyamar. Anda tidak boleh mengurus kos yang tidak anda jejak bagi setiap tugas, anda tidak boleh membuktikan nilai perniagaan yang tidak anda ukur berbanding kadar kejayaan, dan anda tidak boleh mengawal risiko yang tidak dapat anda lihat.
Jurang keterlihatan itu juga boleh diukur. Dalam tinjauan Cloud Security Alliance 2026 tentang mengamankan agent autonomi, hanya 28% organisasi menyatakan mereka boleh menjejak tindakan agent kembali kepada manusia atau sistem secara boleh dipercayai merentas semua persekitaran mereka, dan hanya 45% mempunyai penjejakan sesi hujung ke hujung sama sekali. Kebanyakan pasukan yang menjalankan agent hari ini terbang dengan instrumen yang tidak lengkap.
Tindanan Permulaan yang Praktikal
Anda tidak memerlukan platform penuh pada hari pertama. Susunan pembinaan yang munasabah:
- Pengelogan berstruktur bagi setiap larian dahulu. Pencetus, ID jejak, setiap panggilan alat dan hasil, hasil akhir. Ini sahaja menjadikan penyahpepijatan larian buruk tertentu mungkin dan bukan sekadar agakan.
- Sampel dan semak agent berimpak tertinggi anda. Pilih satu agent dengan tindakan paling berakibat, yang menyentuh wang, data pelanggan, atau komunikasi luaran, dan minta seseorang membaca 20 hingga 50 larian-nya seminggu. Ini menangkap hanyutan lama sebelum metrik berbuat demikian.
- Tambah penjejakan teragih setelah larian menjadi panjang. Apabila agent merantai beberapa alat, anda memerlukan data masa dan hasil pada setiap langkah, bukan sekadar masa mula dan tamat.
- Lapiskan evals automatik paling akhir, setelah anda mempunyai cukup larian yang disemak manusia untuk menentukur rupa "baik." Penilai automatik tanpa garis asas manusia hanya memberikan anda angka yang yakin tetapi tidak berasas.
Perkakas penilaian dan penjejakan yang sama yang digunakan untuk kebolehperhatian AI umum, jenis yang dibincangkan dalam ringkasan kebolehperhatian AI, juga berfungsi untuk agent. Yang berbeza ialah apa yang anda tujukan kepadanya: bukan satu respons, tetapi keseluruhan larian.
Jika anda sedang menilai perkakas kejuruteraan untuk membina instrumentasi ini, perbandingan alat dev kami merangkumi platform yang menyokong penjejakan dan pemantauan seperti ini, dan cara memilih platform DevOps membimbing anda melalui soalan CI/CD dan pemantauan yang patut ditanya sebelum anda komited kepada satu.
Fakta Utama
- Kebolehperhatian agent menjejak keseluruhan gelung (tanggap, nalar, bertindak, perhati, ulang) merentas satu larian, bukan sekadar satu output model.
- Log setiap panggilan alat, parameternya, hasilnya, cabang keputusan yang diambil, dan sebab keputusan itu, semuanya di bawah satu ID jejak bagi setiap larian.
- Kadar kejayaan tugas, lelaran gelung, kadar eskalasi, dan kadar penggantian manusia menangkap masalah yang terlepas daripada kependaman dan kadar ralat.
- Hanya 28% organisasi dapat menjejak tindakan agent kembali kepada manusia atau sistem secara boleh dipercayai merentas semua persekitaran, menurut tinjauan Cloud Security Alliance 2026.
- Gartner mengaitkan lebih 40% pembatalan projek agentic AI menjelang 2027 dengan kos, nilai yang tidak jelas, dan kawalan risiko yang lemah, semuanya perkara yang kebolehperhatian dibina untuk menangkapnya.
Soalan Lazim tentang Kebolehperhatian AI Agent
Apakah kebolehperhatian AI agent?
Ia ialah amalan memasang instrumen pada AI agent supaya anda dapat melihat apa yang berlaku merentas keseluruhan larian-nya: pencetus, konteks yang diambilnya, setiap panggilan alat dan hasil, keputusan yang dibuatnya, dan bagaimana ia berakhir. Ia memanjangkan kebolehperhatian AI umum untuk merangkumi gelung berbilang langkah yang dijalankan agent dan bukan satu panggilan model.
Bagaimana kebolehperhatian agent berbeza daripada kebolehperhatian AI biasa?
Kebolehperhatian AI umum memerhati log, metrik, dan jejak sesebuah sistem, biasanya berpusat pada panggilan model individu. Kebolehperhatian agent memerhati rantaian penuh keputusan dan panggilan alat yang membentuk satu larian, di bawah satu ID jejak, kerana kegagalan dalam agent boleh bersembunyi dalam mana-mana langkah rantaian itu walaupun tiada satu langkah pun melemparkan ralat.
Apakah yang patut dilog untuk setiap larian agent?
Sekurang-kurangnya: pencetus, konteks yang diambil agent, pelan atau tindakan yang dipilihnya, setiap panggilan alat beserta parameter dan hasilnya, apa-apa yang ditulis ke memori, cabang keputusan yang diambilnya (bertindak, bertanya, atau menyerahkan), dan hasil akhir beserta sebab.
Apakah metrik yang paling penting untuk AI agent?
Kadar kejayaan tugas, lelaran gelung setiap larian, kadar ralat panggilan alat, kadar eskalasi, dan kadar penggantian manusia. Kadar penggantian khususnya, kekerapan seseorang secara senyap membetulkan apa yang dilakukan agent, ialah salah satu tanda awal paling jelas bagi hanyutan logik keputusan.
Adakah anda memerlukan alat khusus untuk kebolehperhatian agent?
Tidak untuk bermula. Pengelogan berstruktur dengan ID jejak yang konsisten membawa anda sebahagian besar jalan. Platform penjejakan dan penilaian yang dibina khas membantu apabila anda mempunyai beberapa agent yang berjalan dalam pengeluaran dan perlu membandingkan larian pada skala besar, tetapi ia ialah peningkatan, bukan prasyarat.
Ke Mana Selepas Ini
Kebolehperhatian memberitahu anda apa yang sebenarnya dilakukan agent anda. Menggandingkannya dengan keselamatan AI agent melengkapkan separuh lagi gambaran: mengetahui bukan sahaja apa yang dilakukan agent, tetapi sama ada ia diperdaya untuk melakukannya. Jika anda masih menentukan skop fungsi mana yang sedia untuk agent pada mulanya, bila hendak menggunakan AI agent ialah bacaan seterusnya yang baik, dan pelan pembinaan AI Risk Monitoring Agent serta AI Security Monitoring Agent juga wajar dikaji, kerana kedua-duanya dibina hampir sepenuhnya di sekeliling corak perhati-dan-amaran yang diterangkan oleh artikel ini.
