Memori AI Agent: Jangka Pendek, Jangka Panjang, dan Stor Vektor
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Memori AI agent ialah cara agent menjejak apa yang telah berlaku, sama ada dalam satu tugas mahupun merentas setiap interaksi akan datang dengan akaun atau pengguna yang sama. Memori jangka pendek (kerja) menyimpan larian semasa supaya agent tidak mengulangi dirinya atau kehilangan benang cerita. Memori jangka panjang (berterusan), biasanya disimpan dalam pangkalan data atau stor vektor yang boleh dicari oleh agent, menyimpan fakta dan sejarah merentas sesi supaya agent tidak bermula dari kosong setiap kali. Tanpa kedua-duanya, agent sama ada melupakan apa yang baru dilakukannya, atau melupakan segala-galanya yang pernah dipelajarinya tentang anda sebaik sahaja perbualan tamat.
Mengapa Agent Memerlukan Memori
Memori ialah salah satu daripada lima bahagian yang menjadikan perisian sebagai agent dan bukan chatbot atau skrip biasa, bersama persepsi, penaakulan, alat, dan autonomi terhad. Model bahasa biasa tidak mempunyai memori secara lalai. Tanyakan sesuatu, ia menjawab, dan soalan seterusnya bermula dari awal melainkan anda menampal semula keseluruhan perbualan terdahulu. Itu baik untuk satu soalan. Ia runtuh sebaik sahaja tugas memerlukan lebih daripada satu langkah.
Bayangkan agent yang menjalankan jujukan susulan jualan, AI Follow-Up Agent ialah contoh sebenar. Langkah pertama dihantar. Tiga hari berlalu tanpa balasan. Langkah kedua perlu datang dari sudut yang berbeza daripada langkah pertama, kerana mengulangi pitch yang sama kelihatan seperti spam dan seorang wakil jualan tidak akan melakukannya. Satu-satunya cara agent tahu untuk mempelbagaikan mesej ialah jika ia mengingat apa yang telah dihantarnya, kepada siapa, dan bagaimana mereka bertindak balas. Itulah memori yang melakukan kerja sebenar, bukan sekadar tambahan yang menyenangkan.
Memori Jangka Pendek: Apa yang Mengekalkan Satu Larian Koheren
Memori jangka pendek, atau memori kerja, menyimpan segala-galanya yang berkaitan dengan tugas yang sedang berjalan: perbualan setakat ini, langkah yang telah diambil, pelan yang sedang dilalui agent. Ia lazimnya berada dalam tetingkap konteks model, iaitu jumlah teks yang boleh dipertimbangkan oleh model sekali gus, dan ia hilang apabila tugas tamat melainkan sesuatu sengaja menulisnya ke tempat yang lebih kekal terlebih dahulu.
Had praktikal di sini bukan sekadar berapa banyak teks yang boleh dimuatkan. Tetingkap konteks telah berkembang besar, model termaju moden kini menawarkan tetingkap daripada ratusan ribu hingga melepasi sejuta token, tetapi tetingkap yang lebih besar tidak sama dengan penggunaan yang boleh dipercayai bagi segala-galanya di dalamnya. Penyelidikan Chroma 2025 tentang prestasi konteks panjang, yang menguji 18 model terkemuka, mendapati bahawa ketepatan boleh mula merosot jauh sebelum model kehabisan ruang, kadangkala seawal 50,000 token dalam tetingkap 200,000 token, dan bahawa model dengan tetingkap 1 juta token tidak bernalar secara boleh dipercayai merentasi seluruh sejuta itu. Para penyelidik mendapati bahawa walaupun pada model 2 juta token, bajet selamat untuk kerja berketepatan tinggi cenderung jatuh lebih hampir kepada 150,000 hingga 400,000 token, jauh di bawah nombor pada label. Kajian akademik yang berkaitan dan sering dipetik, Liu et al., "Lost in the Middle", mendapati model jauh lebih baik menggunakan maklumat yang diletakkan di permulaan atau penghujung konteks yang panjang berbanding maklumat yang tertimbus di tengah, walaupun model itu dibina secara eksplisit untuk mengendalikan input yang panjang.
Pengajaran bagi sesiapa yang membina agent: jangan layan tetingkap konteks sebagai ruang conteng tanpa had. Memasukkan setiap mesej lampau, setiap dokumen yang diambil, dan setiap hasil alat "untuk berjaga-jaga" merosakkan prestasi dan bukan memperbaikinya. Hadkan memori kerja kepada apa yang sebenarnya diperlukan oleh langkah semasa, dan tolak segala-galanya yang lain ke storan jangka panjang yang boleh dikueri agent apabila diperlukan.
Memori Jangka Panjang: Apa yang Bertahan Melepasi Larian Semasa
Memori jangka panjang ialah apa yang menjadikan agent konsisten dari satu interaksi ke interaksi seterusnya dan bukan mempelajari semula akaun, keutamaan, dan sejarah anda setiap kali. Ia berada di luar model, lazimnya dalam pangkalan data, CRM, atau pangkalan data vektor yang dibina untuk carian persamaan pantas, dan agent mengkuerinya seperti mengkueri mana-mana alat lain.
Tiga bentuk memori jangka panjang yang paling kerap muncul dalam amalan:
- Memori episodik, rekod peristiwa lampau yang khusus, seperti apa yang ditanya pelanggan kali terakhir atau apa yang diputuskan dalam mesyuarat terdahulu. Meeting Notes Agent ialah contoh langsung: ia menghasilkan rekod berstruktur yang bercop masa tentang keputusan dan tindakan susulan khusus supaya soalan akan datang ("adakah kita sudah komited kepada ini?") mempunyai jawapan sebenar untuk diambil dan bukan sekadar angkat bahu.
- Memori semantik, fakta umum dan keutamaan yang dipelajari daripada corak dari semasa ke semasa, seperti mengetahui bahawa akaun tertentu sentiasa mahukan ringkasan eksekutif di bawah 300 perkataan, atau bahawa segmen pelanggan tertentu cenderung churn selepas eskalasi sokongan.
- Konteks prosedur, keadaan tentang kedudukan semasa proses berbilang langkah dan berbilang sesi. AI Customer Onboarding Agent perlu mengingat pencapaian persediaan mana yang telah diselesaikan oleh sesebuah akaun merentas proses yang boleh berjalan selama beberapa minggu, supaya ia mengingatkan langkah seterusnya yang belum selesai dan bukan mengulangi yang sudah siap atau, lebih buruk, melangkau yang belum.
Bagaimana Memori Jangka Panjang Sebenarnya Disimpan dan Dicari
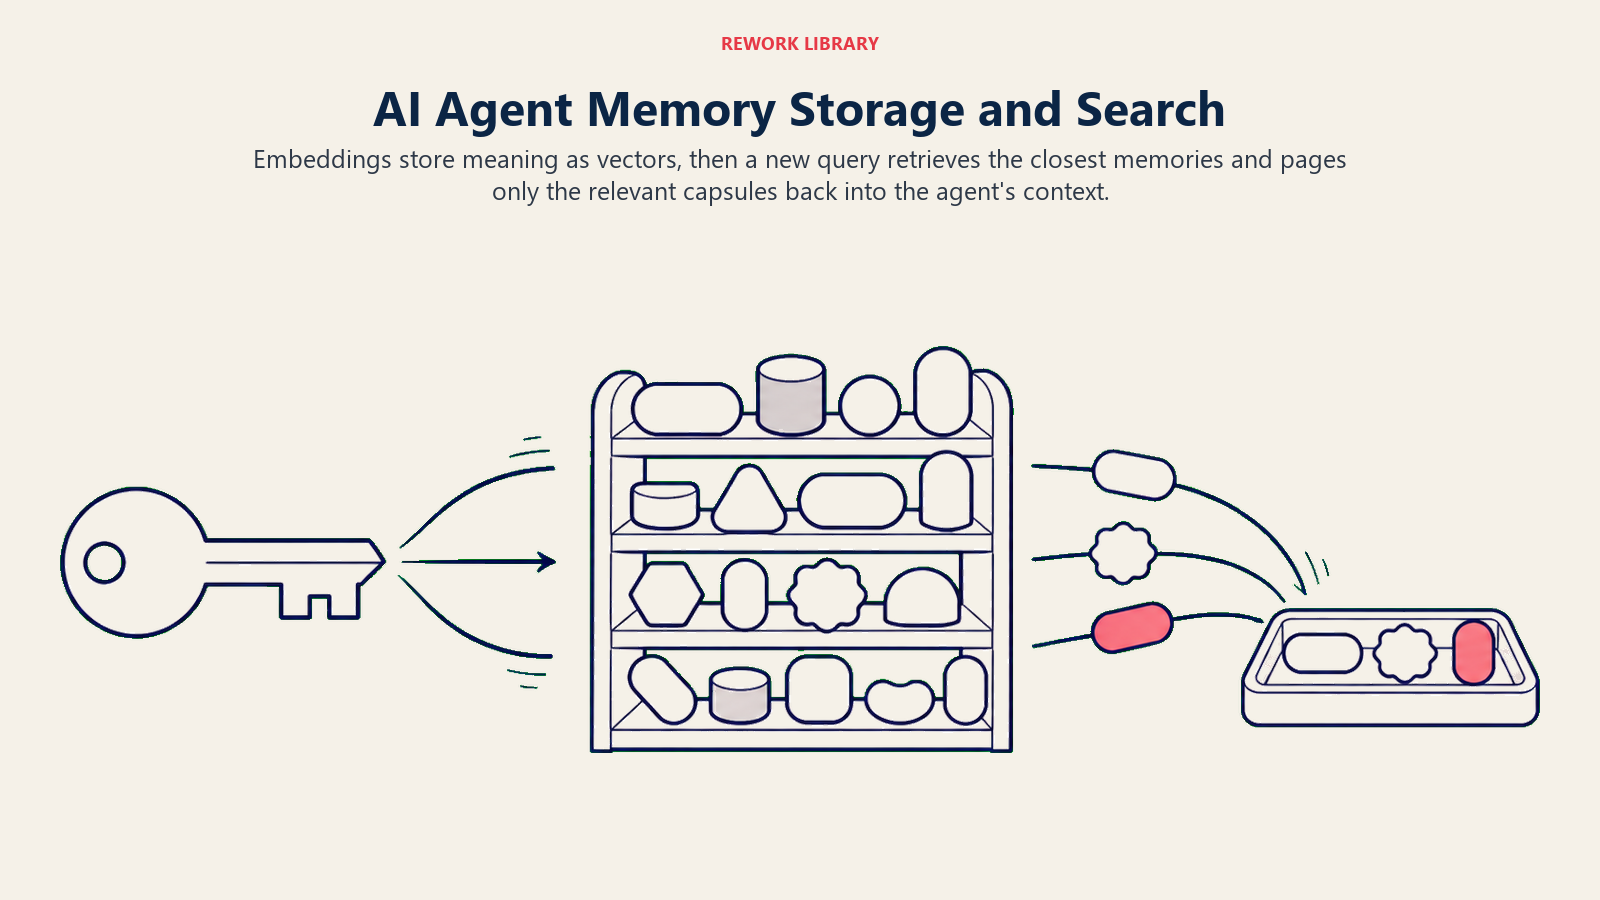
Kebanyakan memori jangka panjang yang perlu dicari mengikut makna dan bukan dirujuk melalui ID tepat akhirnya berada dalam pangkalan data vektor. Fakta, perbualan lampau, dan potongan dokumen ditukar kepada vektor, perwakilan angka bagi maknanya, melalui model embedding, dan kueri ditukar dengan cara yang sama. Sistem kemudian mencari vektor tersimpan yang paling hampir dengan kueri, itulah cara agent boleh mengambil semula "keutamaan kediaman data pelanggan" walaupun asalnya dirumuskan secara berbeza sepenuhnya tiga bulan lalu. Ini ialah mekanisme asas yang sama yang dibincangkan dalam RAG untuk AI Agent: memori jangka panjang dan retrieval-augmented generation kerap berjalan pada infrastruktur yang serupa. Perbezaannya kebanyakannya pada apa yang disimpan, sejarah terkumpul agent sendiri berbanding dokumen rujukan syarikat anda, dan bukan cara ia diambil.
Cadangan seni bina yang berpengaruh bernama MemGPT menggambarkan ini dengan baik. Ia meminjam idea memori berperingkat daripada sistem pengendalian, menyimpan sedikit maklumat "panas" dalam konteks segera model dan memindahkan segala-galanya yang lain ke storan luaran yang lebih perlahan dan lebih besar, memaparkan semula maklumat hanya apabila ia benar-benar diperlukan. Itu model mental yang berguna walaupun anda tidak pernah menyentuh pelaksanaan dalam kertas itu: layan tetingkap konteks seperti memori yang pantas, mahal, dan terhad, dan segala-galanya yang lain seperti stor yang lebih besar dan lebih murah yang sengaja dikueri agent dan bukan dibawa ke mana-mana secara kekal.
Jika memori jangka panjang yang sebenarnya anda perlukan ialah rekod pelanggan bersama dan bukan stor vektor binaan khas, ringkasan alat CRM ialah titik permulaan yang lebih terus, dan panduan pembelian perisian knowledge base merangkumi versi seluruh organisasi bagi masalah yang sama.
Perangkap Memori yang Benar-Benar Menggigit
Menganggap tetingkap konteks yang membesar sebagai memori. Utas sembang yang panjang tidak sama dengan memori jangka panjang. Ia hilang sebaik sahaja sesi tamat, dan menurut penyelidikan kemerosotan konteks di atas, model tidak menggunakan konteks yang dipenuhkan secara boleh dipercayai walaupun sesi masih terbuka.
Tiada laluan pengesahan atau pembetulan memori. Agent boleh mengingat sesuatu dengan salah, terutamanya jika ia salah pada kali pertama disimpan, atau jika ia sekadar sudah lapuk. Bina cara untuk seseorang membetulkan atau memadam memori yang buruk, seperti anda membetulkan medan yang salah dalam rekod CRM, atau ralat akan bertimbun secara senyap setiap kali agent menggunakannya semula.
Memori tanpa sempadan privasi. Memori jangka panjang yang merentasi pelanggan atau akaun memerlukan kawalan akses yang sama seperti mana-mana stor data sensitif yang lain. Agent yang secara teknikalnya boleh melihat sejarah pelanggan lain memerlukan peraturan eksplisit terhadap pendedahannya, bukan sekadar andaian bahawa ia tidak akan timbul. Tadbir Urus AI merangkumi sisi dasar dalam menetapkan sempadan itu.
Memori yang tidak pernah dipangkas. Bukan segala-galanya bernilai disimpan selama-lamanya. Stor memori yang mengumpul setiap butiran tanpa had menjadi lebih perlahan untuk dicari dan lebih bising untuk diambil. Tentukan apa yang tamat tempoh, apa yang diringkaskan dari semasa ke semasa, dan apa yang benar-benar perlu kekal.
Untuk mekanik yang lebih mendalam tentang cara sistem AI membina dan mengurus kefahaman berterusan seperti ini secara umum, bukan hanya dalam satu agent, lihat Memori AI, yang merangkumi seni bina memori (berasaskan sesi, berskop pengguna, berskop organisasi, dan khusus domain) serta rangka kerja privasi yang patut menyelubungi kesemuanya. Halaman ini hanya menumpukan secara sempit pada bagaimana ia berlaku dalam gelung agent itu sendiri.
Fakta Utama
- Memori jangka pendek mengekalkan satu tugas yang koheren dan lazimnya berada dalam tetingkap konteks model. Memori jangka panjang bertahan merentas sesi dan lazimnya berada dalam pangkalan data luaran atau stor vektor.
- Tetingkap konteks yang lebih besar tidak sama dengan memori yang boleh dipercayai. Penyelidikan daripada Chroma dan kajian akademik "Lost in the Middle" kedua-duanya mendapati ketepatan model merosot jauh sebelum had konteks yang diiklankan dicapai, terutamanya bagi maklumat yang tertimbus di tengah input yang panjang.
- Memori jangka panjang dan RAG kerap berjalan pada infrastruktur pangkalan data vektor yang sama. Perbezaannya ialah apa yang disimpan: sejarah agent sendiri berbanding dokumen rujukan organisasi anda.
- Memori yang tidak disahkan, tidak dipangkas, atau tanpa kawalan akses ialah risiko sebenar. Bina laluan pembetulan, dasar tamat tempoh, dan sempadan privasi yang eksplisit sebelum memori agent merentasi berbilang pelanggan atau akaun.
Soalan Lazim tentang Memori AI Agent
Apakah memori AI agent?
Memori AI agent ialah cara agent menjejak apa yang telah berlaku, sama ada dalam satu tugas (memori jangka pendek atau memori kerja) mahupun merentas setiap interaksi akan datang dengan akaun atau pengguna yang sama (memori jangka panjang atau berterusan). Memori jangka pendek lazimnya berada dalam tetingkap konteks model. Memori jangka panjang berada dalam pangkalan data luaran atau stor vektor yang dikueri oleh agent.
Apakah perbezaan antara memori agent jangka pendek dengan jangka panjang?
Memori jangka pendek menyimpan tugas semasa: perbualan setakat ini, langkah yang telah diambil, pelan yang sedang berjalan. Ia hilang apabila larian tamat. Memori jangka panjang menyimpan fakta, interaksi lampau, dan keadaan yang perlu bertahan merentas sesi, disimpan di luar model dalam pangkalan data atau stor vektor, dan ia ialah apa yang menjadikan agent konsisten dari satu interaksi ke interaksi seterusnya.
Adakah tetingkap konteks yang lebih besar menyelesaikan masalah memori?
Tidak dengan sendirinya. Penyelidikan yang menguji 18 model terkemuka mendapati ketepatan boleh merosot jauh sebelum tetingkap konteks penuh, dan model mengendalikan maklumat yang diletakkan di permulaan atau penghujung konteks panjang dengan lebih baik daripada maklumat yang tertimbus di tengah. Layan tetingkap konteks sebagai ruang conteng yang pantas dan terhad, dan tolak apa-apa yang perlu bertahan ke storan jangka panjang dan bukan sekadar memanjangkan prompt.
Bagaimana memori agent berbeza daripada RAG?
Keduanya kerap berkongsi infrastruktur asas yang sama, pangkalan data vektor yang menyimpan dan mengambil maklumat mengikut makna. Perbezaannya ialah apa yang disimpan dan mengapa: RAG lazimnya mengambil daripada dokumen rujukan organisasi anda untuk mengukuhkan jawapan, manakala memori jangka panjang mengambil sejarah terkumpul agent sendiri dengan tugas, pengguna, atau akaun tertentu.
Bolehkah memori AI agent salah?
Boleh. Agent boleh menyimpan sesuatu dengan salah pada kali pertama, atau fakta tersimpan boleh menjadi lapuk apabila keadaan berubah. Sistem memori pengeluaran memerlukan cara untuk seseorang menyemak, membetulkan, atau memadam memori yang buruk, disiplin yang sama seperti yang anda terapkan pada mana-mana sistem rekod lain, atau ralat akan bertimbun secara senyap setiap kali agent menggunakannya semula.
Ke Mana Selepas Ini
Memori ialah apa yang membolehkan agent bertindak secara konsisten dan bukan mempelajari semula perniagaan anda dari awal setiap larian. Gandingkan dengan RAG untuk AI Agent untuk mengukuhkan agent dalam dokumen yang tidak perlu dihafalnya, dan dengan cara menilai dan menguji AI agent untuk menangkap hanyutan memori, seperti fakta lapuk atau konteks yang membesar yang secara senyap menjejaskan ketepatan, sebelum ia sampai kepada pelanggan. Untuk blok binaan yang menjadi tempat memori itu bernaung dengan lebih luas, cara AI agent berfungsi merangkumi gelung penuh.
