Bahasa Indonesia
Memori AI Agent: Jangka Pendek, Jangka Panjang, dan Vector Store
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Memori AI agent adalah cara agent melacak apa yang sudah terjadi, baik dalam satu tugas maupun di seluruh interaksi mendatang dengan akun atau pengguna yang sama. Memori jangka pendek (memori kerja) menyimpan proses yang sedang berjalan agar agent tidak mengulang dirinya sendiri atau kehilangan benang merah. Memori jangka panjang (persisten), yang biasanya disimpan dalam database atau vector store yang dapat dicari agent, menyimpan fakta dan riwayat lintas sesi agar agent tidak memulai dari nol setiap saat. Tanpa keduanya, agent akan melupakan apa yang baru saja dilakukannya, atau melupakan semua yang pernah dipelajarinya tentang Anda begitu percakapan berakhir.
Mengapa Agent Membutuhkan Memori
Memori adalah salah satu dari lima bagian yang menjadikan software sebuah agent dan bukan sekadar chatbot atau skrip biasa, bersama persepsi, penalaran, tool, dan otonomi terbatas. Model bahasa biasa tidak memiliki memori secara default. Anda bertanya, ia menjawab, dan pertanyaan berikutnya dimulai dari awal kecuali Anda menempelkan kembali seluruh percakapan sebelumnya. Itu tidak masalah untuk satu pertanyaan. Pendekatan itu runtuh begitu sebuah tugas membutuhkan lebih dari satu langkah.
Bayangkan agent yang menjalankan urutan tindak lanjut penjualan, AI Follow-Up Agent adalah contoh nyatanya. Langkah pertama terkirim. Tiga hari berlalu tanpa balasan. Langkah kedua harus datang dari sudut yang berbeda dari langkah pertama, karena mengulang pitch yang sama terbaca sebagai spam dan seorang sales tidak akan melakukannya. Satu-satunya cara agent tahu untuk memvariasikan pesan adalah jika ia mengingat apa yang sudah dikirimnya, kepada siapa, dan bagaimana mereka merespons. Itulah memori yang bekerja nyata, bukan sekadar pelengkap.
Memori Jangka Pendek: Yang Menjaga Satu Proses Tetap Koheren
Memori jangka pendek, atau memori kerja, menyimpan semua yang relevan dengan tugas yang sedang berjalan: percakapan sejauh ini, langkah yang sudah diambil, rencana yang sedang dijalani agent. Memori ini biasanya berada di dalam context window model, yaitu jumlah teks yang dapat dipertimbangkan model sekaligus, dan menghilang ketika tugas berakhir kecuali ada sesuatu yang secara sengaja menuliskannya ke tempat yang lebih permanen terlebih dahulu.
Batas praktisnya bukan hanya seberapa banyak teks yang muat. Context window telah tumbuh sangat besar, model frontier modern kini menawarkan window dari ratusan ribu hingga lebih dari satu juta token, tetapi window yang lebih besar tidak sama dengan penggunaan yang andal atas semua isinya. Riset Chroma 2025 tentang performa konteks panjang, yang menguji 18 model terkemuka, menemukan bahwa akurasi dapat mulai menurun jauh sebelum model kehabisan ruang, kadang sedini 50.000 token dalam window 200.000 token, dan bahwa model dengan window 1 juta token tidak dapat bernalar secara andal di seluruh satu juta itu. Para peneliti menemukan bahwa bahkan pada model 2 juta token, anggaran aman untuk pekerjaan berakurasi tinggi cenderung berada di kisaran 150.000 hingga 400.000 token, jauh di bawah angka pada labelnya. Studi akademik terkait yang banyak dikutip, Liu dkk. "Lost in the Middle", menemukan bahwa model jauh lebih baik dalam memanfaatkan informasi yang ditempatkan di awal atau akhir konteks panjang dibandingkan informasi yang terkubur di tengah, bahkan ketika model itu memang dirancang untuk menangani input panjang.
Pelajaran bagi siapa pun yang membangun agent: jangan perlakukan context window sebagai ruang coretan tanpa batas. Memasukkan setiap pesan lama, setiap dokumen yang diambil, dan setiap hasil tool "untuk berjaga-jaga" justru menurunkan performa, bukan meningkatkannya. Batasi memori kerja pada apa yang benar-benar dibutuhkan langkah saat ini, dan pindahkan semua yang lain ke penyimpanan jangka panjang yang dapat di-query agent sesuai kebutuhan.
Memori Jangka Panjang: Yang Bertahan Melewati Proses Saat Ini
Memori jangka panjang adalah yang membuat agent konsisten dari satu interaksi ke interaksi berikutnya, alih-alih mempelajari ulang akun, preferensi, dan riwayat Anda setiap kali. Memori ini berada di luar model, biasanya dalam database, CRM, atau vector database yang dibangun untuk pencarian kemiripan yang cepat, dan agent meng-query-nya seperti meng-query tool lainnya.
Tiga bentuk memori jangka panjang paling sering muncul dalam praktik:
- Memori episodik, catatan peristiwa spesifik di masa lalu, seperti apa yang ditanyakan pelanggan terakhir kali atau apa yang diputuskan dalam rapat sebelumnya. Meeting Notes Agent adalah contoh langsungnya: ia menghasilkan catatan terstruktur berstempel waktu tentang keputusan dan action item, khusus agar pertanyaan di kemudian hari ("apakah kita sudah berkomitmen soal ini?") memiliki jawaban nyata untuk diambil, bukan sekadar angkat bahu.
- Memori semantik, fakta dan preferensi yang digeneralisasi dari pola sepanjang waktu, seperti mengetahui bahwa akun tertentu selalu menginginkan ringkasan eksekutif di bawah 300 kata, atau bahwa segmen pelanggan tertentu cenderung churn setelah eskalasi dukungan.
- Konteks prosedural, status tentang di mana posisi sebuah proses multi-langkah dan multi-sesi saat ini. AI Customer Onboarding Agent harus mengingat milestone penyiapan mana yang sudah diselesaikan sebuah akun sepanjang proses yang bisa berjalan berminggu-minggu, sehingga ia mengingatkan langkah berikutnya yang belum selesai, bukan mengulang langkah yang sudah selesai atau, lebih buruk lagi, melewatkan langkah yang belum.
Bagaimana Memori Jangka Panjang Sebenarnya Disimpan dan Dicari
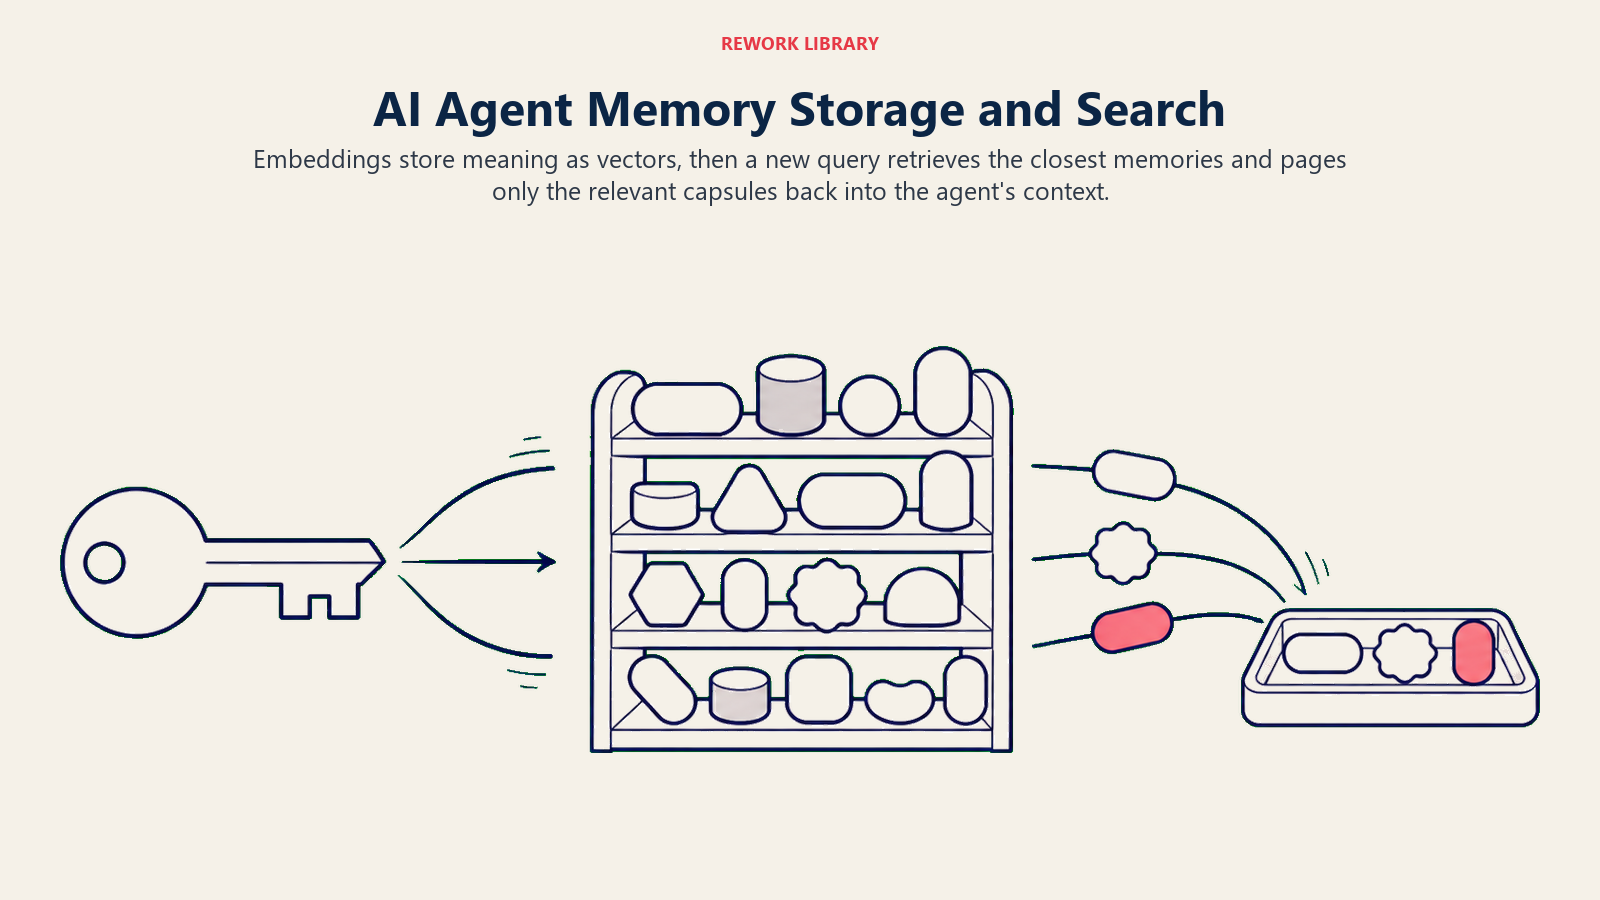
Sebagian besar memori jangka panjang yang perlu dicari berdasarkan makna, bukan dicari dengan ID yang persis, berakhir di vector database. Fakta, percakapan lama, dan potongan dokumen dikonversi menjadi vektor, representasi numerik dari maknanya, melalui model embedding, dan sebuah query dikonversi dengan cara yang sama. Sistem kemudian menemukan vektor tersimpan yang paling dekat dengan query, dan begitulah agent dapat mengambil "preferensi residensi data klien" meskipun awalnya dirumuskan dengan kalimat yang sama sekali berbeda tiga bulan lalu. Ini adalah mekanisme dasar yang sama dengan yang dibahas dalam RAG untuk AI Agent: memori jangka panjang dan retrieval-augmented generation sering berjalan di infrastruktur yang identik. Perbedaannya sebagian besar terletak pada apa yang disimpan, yaitu riwayat yang dikumpulkan agent sendiri versus dokumen referensi perusahaan Anda, bukan pada cara pengambilannya.
Sebuah proposal arsitektur berpengaruh bernama MemGPT membingkai hal ini dengan baik. Proposal itu meminjam gagasan memori berjenjang dari sistem operasi, menyimpan sedikit informasi "panas" dalam konteks langsung model dan memindahkan semua yang lain ke penyimpanan eksternal yang lebih lambat dan lebih besar, lalu memanggil kembali informasi hanya ketika benar-benar dibutuhkan. Itu model mental yang berguna meskipun Anda tidak pernah menyentuh implementasi dalam makalahnya: perlakukan context window seperti memori yang cepat, mahal, dan terbatas, dan semua yang lain seperti penyimpanan yang lebih besar dan lebih murah yang sengaja di-query agent, bukan dibawa terus-menerus.
Jika memori jangka panjang yang Anda butuhkan sebenarnya adalah catatan pelanggan bersama, bukan vector store buatan sendiri, rangkuman tool CRM adalah titik awal yang lebih langsung, dan panduan pembelian software knowledge base membahas versi tingkat organisasi dari masalah yang sama.
Jebakan Memori yang Benar-Benar Menggigit
Menganggap context window yang membesar sebagai memori. Thread chat yang panjang tidak sama dengan memori jangka panjang. Thread itu menghilang begitu sesi berakhir, dan menurut riset degradasi konteks di atas, model tidak memakai konteks yang penuh sesak secara andal bahkan ketika sesi masih terbuka.
Tidak ada jalur verifikasi atau koreksi memori. Agent dapat mengingat sesuatu secara keliru, terutama jika salah sejak pertama kali disimpan, atau jika sudah usang. Bangun cara agar seseorang dapat mengoreksi atau menghapus memori yang buruk, seperti Anda memperbaiki kolom yang salah dalam record CRM, atau kesalahan akan menumpuk secara diam-diam setiap kali agent menggunakannya kembali.
Memori tanpa batas privasi. Memori jangka panjang yang mencakup beberapa pelanggan atau akun membutuhkan kontrol akses yang sama seperti penyimpanan data sensitif lainnya. Agent yang secara teknis dapat melihat riwayat pelanggan lain membutuhkan aturan eksplisit untuk tidak menampilkannya, bukan sekadar asumsi bahwa hal itu tidak akan muncul. Tata Kelola AI membahas sisi kebijakan dalam menetapkan batas tersebut.
Memori yang tidak pernah dipangkas. Tidak semuanya layak disimpan selamanya. Penyimpanan memori yang menumpuk setiap detail tanpa batas waktu menjadi lebih lambat dicari dan lebih berisik untuk diambil. Tentukan apa yang kedaluwarsa, apa yang diringkas seiring waktu, dan apa yang benar-benar perlu bertahan.
Untuk mekanisme yang lebih mendalam tentang bagaimana sistem AI membangun dan mengelola pemahaman persisten semacam ini secara umum, bukan hanya di dalam satu agent, lihat Memori AI, yang membahas arsitektur memori (berbasis sesi, berlingkup pengguna, berlingkup organisasi, dan spesifik domain) serta kerangka privasi yang seharusnya melingkupi semuanya. Halaman ini berfokus secara sempit pada bagaimana hal itu berjalan di dalam loop agent itu sendiri.
Key Facts
- Memori jangka pendek menjaga satu tugas tetap koheren dan biasanya berada di context window model. Memori jangka panjang bertahan lintas sesi dan biasanya berada di database eksternal atau vector store.
- Context window yang lebih besar tidak sama dengan memori yang andal. Riset dari Chroma dan studi akademik "Lost in the Middle" sama-sama menemukan bahwa akurasi model menurun jauh sebelum batas konteks yang diiklankan tercapai, terutama untuk informasi yang terkubur di tengah input panjang.
- Memori jangka panjang dan RAG sering berjalan di infrastruktur vector database yang sama. Perbedaannya adalah apa yang disimpan: riwayat agent sendiri versus dokumen referensi organisasi Anda.
- Memori yang tidak diverifikasi, tidak dipangkas, atau tanpa kontrol akses adalah risiko nyata. Bangun jalur koreksi, kebijakan kedaluwarsa, dan batas privasi yang eksplisit sebelum memori agent mencakup beberapa pelanggan atau akun.
Pertanyaan yang Sering Diajukan tentang Memori AI Agent
Apa itu memori AI agent?
Memori AI agent adalah cara agent melacak apa yang sudah terjadi, baik dalam satu tugas (memori jangka pendek atau memori kerja) maupun di seluruh interaksi mendatang dengan akun atau pengguna yang sama (memori jangka panjang atau persisten). Memori jangka pendek biasanya berada di context window model. Memori jangka panjang berada di database eksternal atau vector store yang di-query agent.
Apa perbedaan antara memori agent jangka pendek dan jangka panjang?
Memori jangka pendek menyimpan tugas saat ini: percakapan sejauh ini, langkah yang sudah diambil, rencana yang sedang berjalan. Memori ini menghilang ketika proses berakhir. Memori jangka panjang menyimpan fakta, interaksi lampau, dan status yang perlu bertahan lintas sesi, disimpan di luar model dalam database atau vector store, dan itulah yang membuat agent konsisten dari satu interaksi ke interaksi berikutnya.
Apakah context window yang lebih besar menyelesaikan masalah memori?
Tidak dengan sendirinya. Riset yang menguji 18 model terkemuka menemukan bahwa akurasi dapat menurun jauh sebelum context window penuh, dan bahwa model menangani informasi di awal atau akhir konteks panjang lebih baik daripada informasi yang terkubur di tengah. Perlakukan context window sebagai ruang coretan yang cepat dan terbatas, dan pindahkan apa pun yang perlu bertahan ke penyimpanan jangka panjang, bukan sekadar memperpanjang prompt.
Apa perbedaan memori agent dengan RAG?
Keduanya sering berbagi infrastruktur dasar yang sama, yaitu vector database yang menyimpan dan mengambil informasi berdasarkan makna. Perbedaannya ada pada apa yang disimpan dan mengapa: RAG biasanya mengambil dari dokumen referensi organisasi Anda untuk mendasari sebuah jawaban, sedangkan memori jangka panjang mengambil riwayat yang dikumpulkan agent sendiri dengan tugas, pengguna, atau akun tertentu.
Bisakah memori AI agent salah?
Bisa. Agent dapat menyimpan sesuatu secara keliru sejak awal, atau fakta yang tersimpan bisa menjadi usang seiring perubahan keadaan. Sistem memori produksi membutuhkan cara bagi seseorang untuk meninjau, mengoreksi, atau menghapus memori yang buruk, disiplin yang sama dengan yang Anda terapkan pada sistem pencatatan lainnya, atau kesalahan akan menumpuk secara diam-diam setiap kali agent menggunakannya kembali.
Langkah Selanjutnya
Memori adalah yang memungkinkan agent bertindak secara konsisten, bukan mempelajari ulang bisnis Anda dari nol pada setiap proses. Padukan dengan RAG untuk AI Agent untuk mendasari agent pada dokumen yang tidak perlu dihafalnya, dan dengan cara mengevaluasi dan menguji AI agent untuk menangkap drift memori, seperti fakta yang usang atau konteks yang membesar dan diam-diam merugikan akurasi, sebelum sampai ke pelanggan. Untuk blok penyusun yang lebih luas tempat memori berada, cara kerja AI agent membahas loop lengkapnya.
