AI Agent Memory: Kurzzeitgedächtnis, Langzeitgedächtnis und Vector Stores
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AI Agent Memory ist die Art, wie ein Agent nachhält, was bereits geschehen ist, sowohl innerhalb einer einzelnen Aufgabe als auch in jeder künftigen Interaktion mit demselben Account oder Nutzer. Das Kurzzeitgedächtnis (Arbeitsgedächtnis) hält den aktuellen Durchlauf fest, damit sich der Agent nicht wiederholt oder den Faden verliert. Das Langzeitgedächtnis (persistent), meist in einer Datenbank oder einem Vector Store abgelegt, den der Agent durchsuchen kann, hält Fakten und Verlauf über Sitzungen hinweg fest, damit der Agent nicht jedes Mal bei null anfängt. Ohne beides vergisst ein Agent entweder, was er gerade getan hat, oder er vergisst alles, was er je über Sie gelernt hat, sobald das Gespräch endet.
Warum ein Agent überhaupt Gedächtnis braucht
Gedächtnis ist einer der fünf Teile, die Software zu einem Agent statt zu einem simplen Chatbot oder Skript machen, neben Wahrnehmung, Schlussfolgern, Tools und begrenzter Autonomie. Ein reines Sprachmodell hat standardmäßig kein Gedächtnis. Sie fragen etwas, es antwortet, und die nächste Frage beginnt von vorn, es sei denn, Sie fügen das gesamte bisherige Gespräch wieder ein. Für eine einzelne Frage ist das in Ordnung. Es bricht zusammen, sobald eine Aufgabe mehr als einen Schritt braucht.
Stellen Sie sich einen Agent vor, der eine Sales-Follow-up-Sequenz abarbeitet, der AI Follow-Up Agent ist ein reales Beispiel. Schritt eins geht raus. Drei Tage vergehen ohne Antwort. Schritt zwei muss aus einem anderen Blickwinkel kommen als Schritt eins, denn dieselbe Ansprache zu wiederholen wirkt wie Spam, und ein Vertriebsmitarbeiter würde das nie tun. Der Agent weiß nur dann, dass er die Nachricht variieren muss, wenn er sich erinnert, was er bereits gesendet hat, an wen und wie die Person reagiert hat. Das ist Gedächtnis, das echte Arbeit leistet, kein Nice-to-have.
Kurzzeitgedächtnis: Was einen Durchlauf kohärent hält
Das Kurzzeit- oder Arbeitsgedächtnis hält alles, was für die aktuell laufende Aufgabe relevant ist: das bisherige Gespräch, die bereits unternommenen Schritte, den Plan, in dem der Agent gerade steckt. Es liegt typischerweise im Context Window des Modells, der Textmenge, die das Modell gleichzeitig berücksichtigen kann, und verschwindet, wenn die Aufgabe endet, sofern nicht vorher gezielt etwas an einen dauerhafteren Ort geschrieben wird.
Die praktische Grenze ist hier nicht nur, wie viel Text hineinpasst. Context Windows sind enorm gewachsen, moderne Frontier-Modelle bieten heute Fenster von mehreren hunderttausend bis über eine Million Tokens, aber ein größeres Fenster bedeutet nicht, dass alles darin zuverlässig genutzt wird. Chromas Forschung von 2025 zur Long-Context-Leistung, die 18 führende Modelle testete, ergab, dass die Genauigkeit schon deutlich bevor einem Modell der Platz ausgeht nachlassen kann, mitunter schon bei 50.000 Tokens in einem Fenster von 200.000, und dass ein Modell mit einem Fenster von 1 Million Tokens nicht zuverlässig über die vollen 1 Million hinweg schlussfolgert. Die Forscher stellten fest, dass selbst bei Modellen mit 2 Millionen Tokens das sichere Budget für hochgenaue Arbeit eher bei 150.000 bis 400.000 Tokens liegt, deutlich unter der Zahl auf dem Etikett. Eine verwandte, vielzitierte akademische Studie, „Lost in the Middle“ von Liu et al., ergab, dass Modelle Informationen ganz am Anfang oder Ende eines langen Kontexts spürbar besser nutzen als Informationen aus der Mitte, selbst wenn ein Modell ausdrücklich für lange Eingaben gebaut ist.
Die Erkenntnis für alle, die einen Agent bauen: Behandeln Sie das Context Window nicht als unbegrenzten Notizblock. Jede vergangene Nachricht, jedes abgerufene Dokument und jedes Tool-Ergebnis „für alle Fälle“ hineinzustopfen verschlechtert die Leistung, statt sie zu verbessern. Halten Sie das Arbeitsgedächtnis auf das, was der aktuelle Schritt tatsächlich braucht, und schieben Sie alles andere in einen Langzeitspeicher, den der Agent bei Bedarf abfragen kann.
Langzeitgedächtnis: Was über den aktuellen Durchlauf hinaus bleibt
Das Langzeitgedächtnis macht einen Agent von einer Interaktion zur nächsten konsistent, statt dass er Ihren Account, Ihre Präferenzen und Ihren Verlauf jedes Mal neu lernt. Es liegt außerhalb des Modells, typischerweise in einer Datenbank, einem CRM oder einer für schnelle Ähnlichkeitssuche gebauten Vector Database, und der Agent fragt es so ab, wie er jedes andere Tool abfragen würde.
In der Praxis treten am häufigsten drei Formen des Langzeitgedächtnisses auf:
- Episodisches Gedächtnis, eine Aufzeichnung konkreter vergangener Ereignisse, etwa was ein Kunde beim letzten Mal gefragt hat oder was in einem früheren Meeting entschieden wurde. Der Meeting Notes Agent ist ein direktes Beispiel: Er erzeugt strukturierte, zeitgestempelte Aufzeichnungen von Entscheidungen und Aktionspunkten gezielt, damit eine künftige Frage („haben wir uns dazu schon verpflichtet?“) eine echte Antwort zum Abrufen hat statt eines Achselzuckens.
- Semantisches Gedächtnis, verallgemeinerte Fakten und Präferenzen, die aus Mustern über die Zeit gelernt wurden, etwa dass ein bestimmter Account Management-Zusammenfassungen immer unter 300 Wörtern möchte oder dass ein bestimmtes Kundensegment nach einer Support-Eskalation tendenziell abwandert.
- Prozeduraler Kontext, der Stand, wo ein mehrstufiger, sitzungsübergreifender Prozess gerade steht. Der AI Customer Onboarding Agent muss sich merken, welche Setup-Meilensteine ein Account bereits abgeschlossen hat, in einem Prozess, der über Wochen laufen kann, damit er den nächsten offenen Schritt anstößt, statt einen bereits erledigten zu wiederholen oder, schlimmer, einen offenen zu überspringen.
Wie Langzeitgedächtnis tatsächlich gespeichert und durchsucht wird
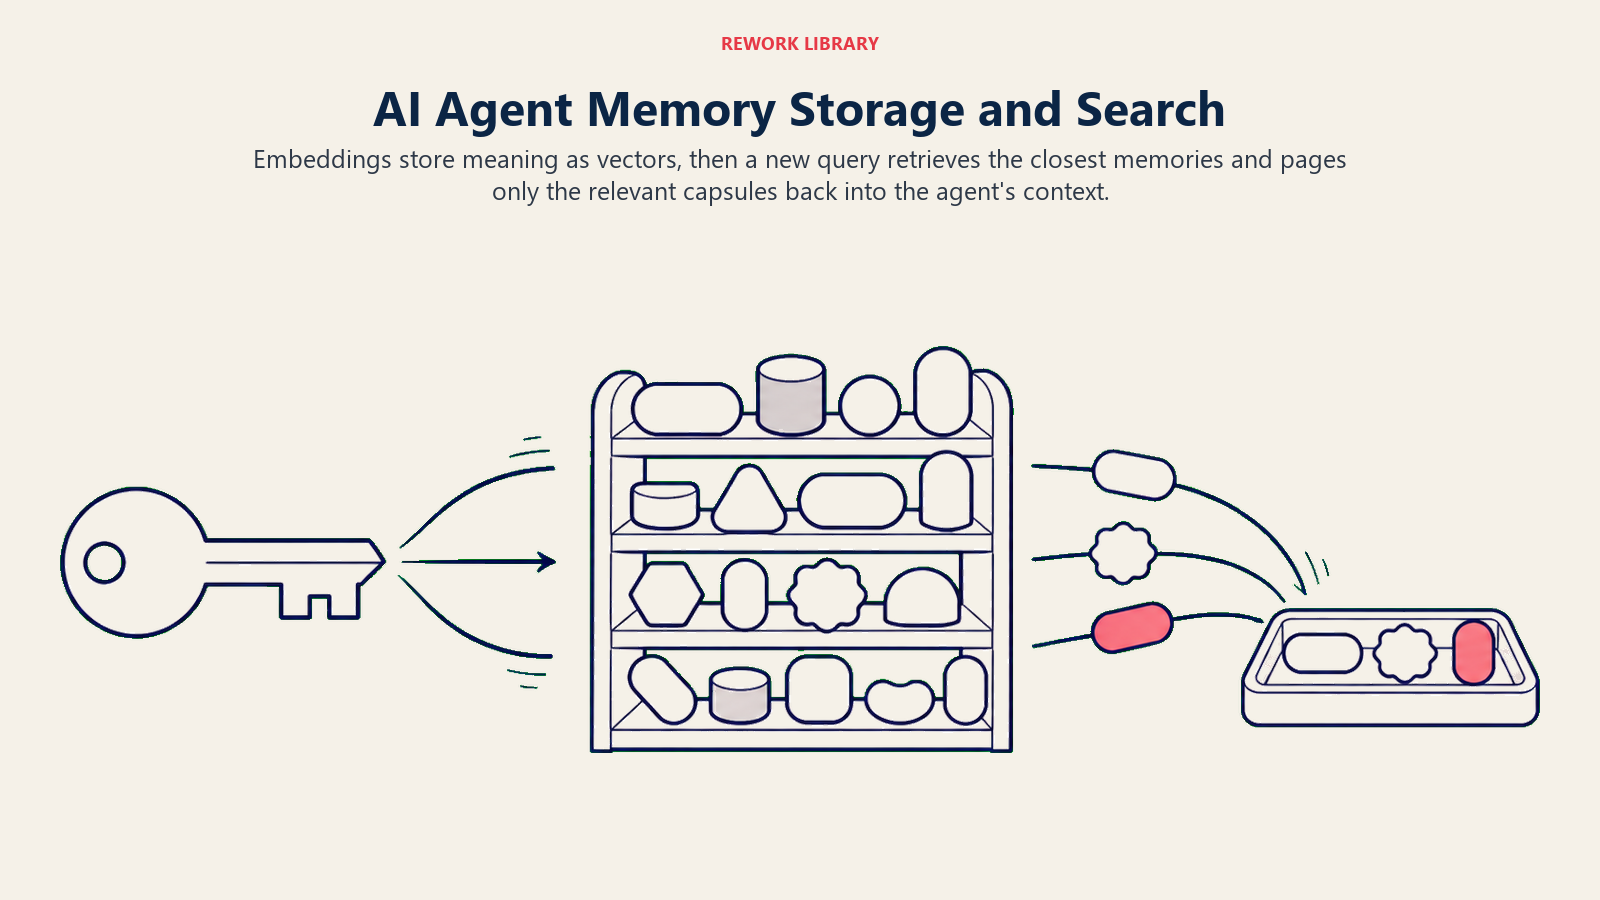
Das meiste Langzeitgedächtnis, das nach Bedeutung statt per exakter ID abgefragt werden muss, landet in einer Vector Database. Fakten, vergangene Gespräche und Dokumentabschnitte werden über ein Embedding-Modell in Vektoren umgewandelt, numerische Darstellungen ihrer Bedeutung, und eine Anfrage wird auf dieselbe Weise umgewandelt. Das System findet dann die gespeicherten Vektoren, die der Anfrage am nächsten liegen. So kann ein Agent „die Präferenz des Kunden zum Datenstandort“ abrufen, auch wenn sie vor drei Monaten ganz anders formuliert wurde. Das ist derselbe zugrunde liegende Mechanismus wie in RAG für AI Agents: Langzeitgedächtnis und Retrieval-Augmented Generation laufen häufig auf identischer Infrastruktur. Der Unterschied liegt meist darin, was gespeichert wird, die eigene angesammelte Historie des Agents gegenüber den Referenzdokumenten Ihres Unternehmens, nicht darin, wie abgerufen wird.
Ein einflussreicher Architekturvorschlag namens MemGPT beschreibt das gut. Er übernimmt die Idee gestufter Speicher aus Betriebssystemen: eine kleine Menge „heißer“ Informationen im unmittelbaren Kontext des Modells halten und alles andere in langsameren, größeren externen Speicher auslagern, und Informationen nur dann wieder einlagern, wenn sie tatsächlich gebraucht werden. Das ist ein nützliches mentales Modell, auch wenn Sie die Implementierung des Papers nie anfassen: Behandeln Sie das Context Window wie schnellen, teuren, begrenzten Speicher und alles andere wie einen größeren, günstigeren Speicher, den der Agent gezielt abfragt, statt ihn dauerhaft mit sich herumzutragen.
Wenn das Langzeitgedächtnis, das Sie tatsächlich brauchen, ein gemeinsamer Kundendatensatz statt eines selbstgebauten Vector Store ist, ist die Übersicht der CRM-Tools ein direkterer Ausgangspunkt, und der Kaufleitfaden für Knowledge-Base-Software behandelt die unternehmensweite Version desselben Problems.
Memory-Fallstricke, die tatsächlich zuschlagen
Ein wachsendes Context Window als Gedächtnis behandeln. Ein langer Chat-Verlauf ist nicht dasselbe wie Langzeitgedächtnis. Er verschwindet, sobald die Sitzung endet, und laut der oben genannten Forschung zur Kontextdegradation nutzt ein Modell einen vollgestopften Kontext nicht zuverlässig, selbst solange die Sitzung noch offen ist.
Kein Weg zur Überprüfung und Korrektur von Erinnerungen. Agents können sich etwas falsch merken, besonders wenn es schon beim ersten Speichern falsch war oder schlicht veraltet ist. Bauen Sie einen Weg ein, auf dem eine Person eine falsche Erinnerung korrigieren oder löschen kann, so wie Sie ein falsches Feld in einem CRM-Datensatz korrigieren würden, sonst potenzieren sich Fehler stillschweigend bei jeder Wiederverwendung durch den Agent.
Gedächtnis ohne Datenschutzgrenze. Langzeitgedächtnis, das Kunden oder Accounts übergreift, braucht dieselben Zugriffskontrollen wie jeder andere sensible Datenspeicher. Ein Agent, der technisch die Historie eines anderen Kunden sehen kann, braucht eine ausdrückliche Regel dagegen, sie auszuspielen, nicht bloß die Annahme, dass es nicht vorkommt. AI Governance behandelt die Richtlinienseite, solche Grenzen zu ziehen.
Gedächtnis, das nie bereinigt wird. Nicht alles ist es wert, ewig behalten zu werden. Ein Gedächtnisspeicher, der unbegrenzt jedes Detail ansammelt, wird langsamer zu durchsuchen und unschärfer beim Abruf. Entscheiden Sie, was verfällt, was mit der Zeit zusammengefasst wird und was wirklich dauerhaft bestehen muss.
Für die tiefere Mechanik, wie AI-Systeme solches dauerhaftes Verständnis aufbauen und verwalten, allgemein und nicht nur innerhalb eines einzelnen Agents, siehe AI Memory, das Gedächtnisarchitekturen (sitzungsbasiert, nutzerbezogen, organisationsbezogen und domänenspezifisch) und die Datenschutz-Frameworks behandelt, die all diese umgeben sollten. Diese Seite hat sich eng darauf konzentriert, wie sich das innerhalb des eigenen Loops eines Agents abspielt.
Key Facts
- Das Kurzzeitgedächtnis hält eine einzelne Aufgabe kohärent und liegt typischerweise im Context Window des Modells. Das Langzeitgedächtnis überdauert Sitzungen und liegt typischerweise in einer externen Datenbank oder einem Vector Store.
- Ein größeres Context Window ist nicht dasselbe wie verlässliches Gedächtnis. Die Forschung von Chroma und die akademische Studie „Lost in the Middle“ ergaben beide, dass die Modellgenauigkeit deutlich vor den beworbenen Kontextgrenzen nachlässt, besonders bei Informationen aus der Mitte einer langen Eingabe.
- Langzeitgedächtnis und RAG laufen häufig auf derselben Vector-Database-Infrastruktur. Der Unterschied ist, was gespeichert wird: die eigene Historie des Agents gegenüber den Referenzdokumenten Ihrer Organisation.
- Ungeprüftes, nie bereinigtes oder zugriffsunkontrolliertes Gedächtnis ist ein reales Risiko. Bauen Sie einen Korrekturweg, eine Verfallsrichtlinie und ausdrückliche Datenschutzgrenzen ein, bevor das Gedächtnis eines Agents mehrere Kunden oder Accounts übergreift.
Häufig gestellte Fragen zu AI Agent Memory
Was ist AI Agent Memory?
AI Agent Memory ist die Art, wie ein Agent nachhält, was bereits geschehen ist, sowohl innerhalb einer einzelnen Aufgabe (Kurzzeit- oder Arbeitsgedächtnis) als auch in jeder künftigen Interaktion mit demselben Account oder Nutzer (Langzeit- oder persistentes Gedächtnis). Das Kurzzeitgedächtnis liegt typischerweise im Context Window des Modells. Das Langzeitgedächtnis liegt in einer externen Datenbank oder einem Vector Store, den der Agent abfragt.
Was ist der Unterschied zwischen Kurzzeit- und Langzeitgedächtnis eines Agents?
Das Kurzzeitgedächtnis hält die aktuelle Aufgabe: das bisherige Gespräch, die bereits unternommenen Schritte, den laufenden Plan. Es verschwindet, wenn der Durchlauf endet. Das Langzeitgedächtnis hält Fakten, vergangene Interaktionen und Zustände, die über Sitzungen hinweg bestehen müssen, außerhalb des Modells in einer Datenbank oder einem Vector Store gespeichert, und es macht einen Agent von einer Interaktion zur nächsten konsistent.
Löst ein größeres Context Window das Gedächtnisproblem?
Nicht von allein. Forschung mit 18 führenden Modellen ergab, dass die Genauigkeit deutlich nachlassen kann, bevor ein Context Window voll ist, und dass Modelle Informationen am Anfang oder Ende eines langen Kontexts besser verarbeiten als solche aus der Mitte. Behandeln Sie das Context Window als schnellen, begrenzten Notizblock und schieben Sie alles, was bestehen bleiben muss, in Langzeitspeicher, statt einfach die Prompts zu verlängern.
Wie unterscheidet sich Agent Memory von RAG?
Beide nutzen häufig dieselbe zugrunde liegende Infrastruktur, eine Vector Database, die Informationen nach Bedeutung speichert und abruft. Der Unterschied liegt darin, was gespeichert wird und wozu: RAG ruft typischerweise aus den Referenzdokumenten Ihrer Organisation ab, um eine Antwort zu fundieren, während das Langzeitgedächtnis die eigene angesammelte Historie des Agents mit einer bestimmten Aufgabe, einem Nutzer oder einem Account abruft.
Kann das Gedächtnis eines AI Agents falsch sein?
Ja. Ein Agent kann etwas schon beim ersten Mal falsch speichern, oder ein gespeicherter Fakt kann mit veränderten Umständen schlicht veralten. Produktive Memory-Systeme brauchen einen Weg, auf dem eine Person eine falsche Erinnerung prüfen, korrigieren oder löschen kann, dieselbe Disziplin wie bei jedem anderen führenden System, sonst potenzieren sich Fehler leise bei jeder Wiederverwendung durch den Agent.
Wie es weitergeht
Gedächtnis ist das, was einen Agent konsistent handeln lässt, statt dass er Ihr Geschäft bei jedem Durchlauf neu lernt. Kombinieren Sie es mit RAG für AI Agents, um den Agent in Dokumenten zu verankern, die er nicht auswendig lernen muss, und mit Wie Sie AI Agents evaluieren und testen, um Memory-Drift, etwa einen veralteten Fakt oder einen wachsenden Kontext, der still die Genauigkeit beeinträchtigt, abzufangen, bevor er einen Kunden erreicht. Für die Bausteine, in die sich Gedächtnis allgemein einfügt, behandelt Wie AI Agents funktionieren den gesamten Loop.

On this page
- Warum ein Agent überhaupt Gedächtnis braucht
- Kurzzeitgedächtnis: Was einen Durchlauf kohärent hält
- Langzeitgedächtnis: Was über den aktuellen Durchlauf hinaus bleibt
- Wie Langzeitgedächtnis tatsächlich gespeichert und durchsucht wird
- Memory-Fallstricke, die tatsächlich zuschlagen
- Key Facts
- Wie es weitergeht