La memoria de los AI agents: corto plazo, largo plazo y vector stores
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
La memoria de un AI agent es la forma en que el agent lleva el registro de lo que ya ha ocurrido, tanto dentro de una sola tarea como en cada interacción futura con la misma cuenta o el mismo usuario. La memoria a corto plazo (o de trabajo) retiene la ejecución en curso para que el agent no se repita ni pierda el hilo. La memoria a largo plazo (o persistente), almacenada normalmente en una base de datos o en un vector store que el agent puede consultar, conserva hechos e historial entre sesiones para que el agent no empiece de cero cada vez. Sin ambas, un agent olvida lo que acaba de hacer o lo olvida todo sobre usted en cuanto termina la conversación.
Por qué un agent necesita memoria
La memoria es una de las cinco partes que convierten a un software en un agent en lugar de un simple chatbot o script, junto con la percepción, el razonamiento, las herramientas y la autonomía acotada. Un modelo de lenguaje simple no tiene memoria por defecto. Usted le pregunta algo, responde, y la siguiente pregunta empieza de cero a menos que vuelva a pegar toda la conversación anterior. Eso está bien para una sola pregunta. Se desmorona en cuanto una tarea requiere más de un paso.
Imagine un agent que ejecuta una secuencia de seguimiento de ventas; el AI Follow-Up Agent es un ejemplo real. Sale el primer paso. Pasan tres días sin respuesta. El segundo paso debe tener un enfoque distinto al primero, porque repetir el mismo discurso parece spam y un representante nunca lo haría. La única forma de que el agent sepa variar el mensaje es recordar qué envió ya, a quién y cómo respondió esa persona. Eso es la memoria haciendo un trabajo real, no un simple extra.
Memoria a corto plazo: lo que mantiene coherente una ejecución
La memoria a corto plazo, o de trabajo, retiene todo lo relevante para la tarea en curso: la conversación hasta ese momento, los pasos ya dados y el plan que el agent lleva a medias. Normalmente vive dentro de la ventana de contexto del modelo, la cantidad de texto que el modelo puede considerar a la vez, y desaparece cuando termina la tarea, a menos que algo la escriba deliberadamente antes en un lugar más permanente.
El límite práctico aquí no es solo cuánto texto cabe. Las ventanas de contexto han crecido enormemente: los modelos de frontera actuales ofrecen ventanas desde cientos de miles hasta más de un millón de tokens, pero una ventana más grande no equivale a un uso confiable de todo lo que contiene. La investigación de 2025 de Chroma sobre el rendimiento con contextos largos, que probó 18 modelos líderes, encontró que la precisión puede empezar a degradarse mucho antes de que un modelo se quede sin espacio, a veces desde los 50,000 tokens en una ventana de 200,000, y que un modelo con una ventana de 1 millón de tokens no razona de forma confiable sobre el millón completo. Los investigadores encontraron que incluso en modelos de 2 millones de tokens, el presupuesto seguro para trabajo de alta precisión tiende a ubicarse más cerca de 150,000 a 400,000 tokens, muy por debajo de la cifra de la etiqueta. Un estudio académico relacionado y muy citado, «Lost in the Middle» de Liu et al., encontró que los modelos aprovechan notablemente mejor la información colocada al inicio o al final de un contexto largo que la enterrada en el medio, incluso cuando el modelo está construido explícitamente para manejar entradas largas.
La conclusión para quien construye un agent: no trate la ventana de contexto como un espacio de borrador ilimitado. Meter cada mensaje pasado, cada documento recuperado y cada resultado de herramienta "por si acaso" degrada el rendimiento en lugar de mejorarlo. Mantenga la memoria de trabajo en lo que el paso actual realmente necesita y envíe todo lo demás a un almacenamiento a largo plazo que el agent pueda consultar bajo demanda.
Memoria a largo plazo: lo que sobrevive a la ejecución actual
La memoria a largo plazo es lo que hace que un agent sea consistente de una interacción a la siguiente, en lugar de volver a aprender su cuenta, sus preferencias y su historial cada vez. Vive fuera del modelo, normalmente en una base de datos, un CRM o una base de datos vectorial creada para la búsqueda rápida por similitud, y el agent la consulta como consultaría cualquier otra herramienta.
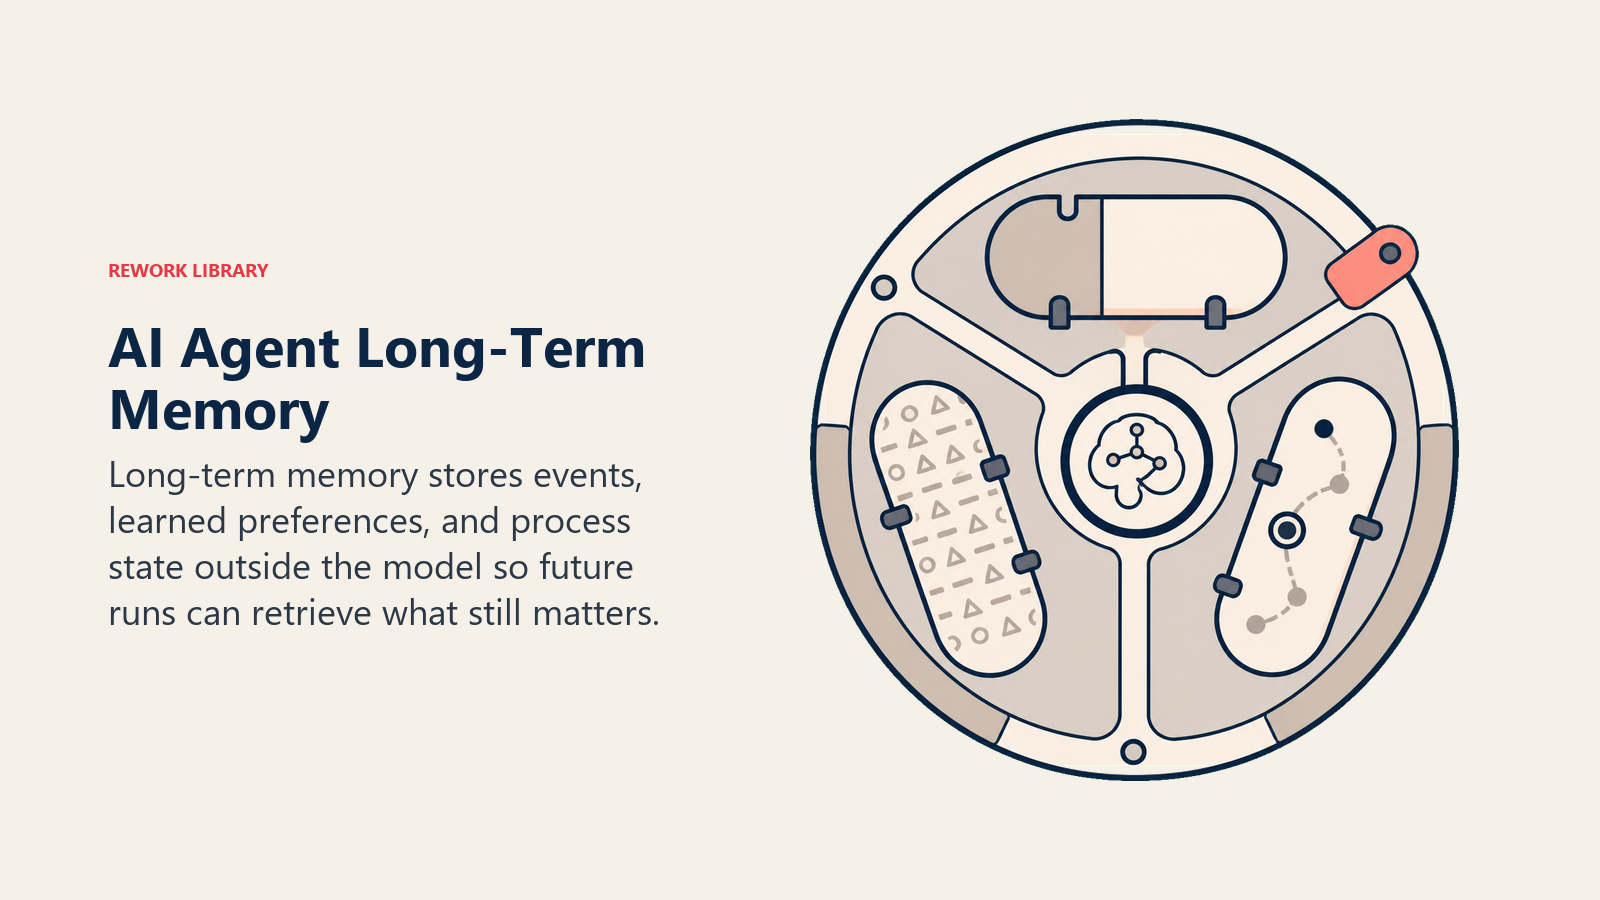
En la práctica aparecen con más frecuencia tres formas de memoria a largo plazo:
- Memoria episódica, un registro de eventos pasados específicos, como lo que un cliente preguntó la última vez o lo que se decidió en una reunión anterior. El Meeting Notes Agent es un ejemplo directo: produce registros estructurados y con marca de tiempo de decisiones y acciones pendientes precisamente para que una pregunta futura ("¿ya nos comprometimos con esto?") tenga una respuesta real que recuperar en lugar de un encogimiento de hombros.
- Memoria semántica, hechos y preferencias generalizados que se aprenden de patrones a lo largo del tiempo, como saber que una cuenta específica siempre quiere resúmenes ejecutivos de menos de 300 palabras, o que un segmento de clientes tiende a hacer churn después de una escalada de soporte.
- Contexto procedimental, el estado de en qué punto está actualmente un proceso de varios pasos y varias sesiones. El AI Customer Onboarding Agent tiene que recordar qué hitos de configuración ya completó una cuenta a lo largo de un proceso que puede durar semanas, de modo que impulse el siguiente paso pendiente en lugar de repetir uno que ya está hecho o, peor, saltarse uno que no lo está.
Cómo se almacena y se busca realmente la memoria a largo plazo
La mayor parte de la memoria a largo plazo que debe buscarse por significado, y no consultarse por un ID exacto, termina en una base de datos vectorial. Los hechos, las conversaciones pasadas y los fragmentos de documentos se convierten en vectores, representaciones numéricas de su significado, mediante un modelo de embeddings, y una consulta se convierte de la misma manera. Luego el sistema encuentra los vectores almacenados más cercanos a la consulta, y así un agent puede recuperar "la preferencia de residencia de datos del cliente" aunque se haya formulado de una manera completamente distinta hace tres meses. Es el mismo mecanismo de fondo que cubre RAG para AI agents: la memoria a largo plazo y la generación aumentada por recuperación (RAG) con frecuencia se ejecutan sobre la misma infraestructura. La diferencia está sobre todo en qué se almacena, el historial acumulado del propio agent frente a los documentos de referencia de su empresa, y no en cómo se recupera.
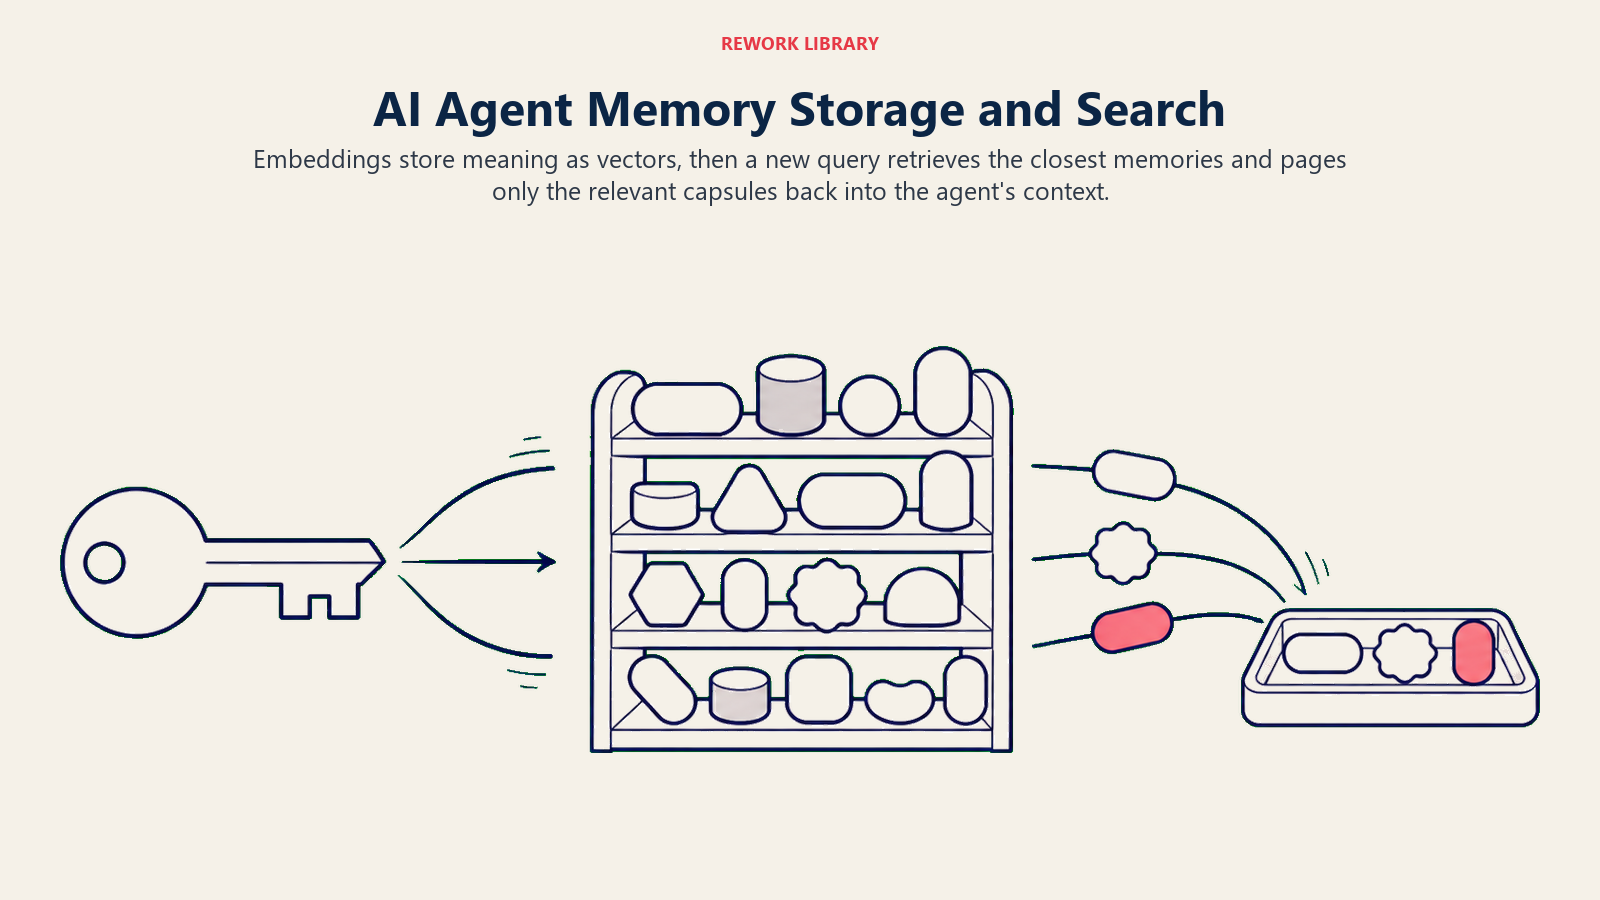
Una propuesta de arquitectura influyente llamada MemGPT lo plantea bien. Toma prestada la idea de memoria por niveles de los sistemas operativos: mantiene una pequeña cantidad de información "caliente" en el contexto inmediato del modelo y traslada todo lo demás a un almacenamiento externo más lento y más grande, devolviendo la información al contexto solo cuando realmente se necesita. Es un modelo mental útil aunque nunca toque la implementación del artículo: trate la ventana de contexto como memoria rápida, cara y limitada, y todo lo demás como un almacén más grande y barato que el agent consulta deliberadamente en lugar de cargarlo permanentemente.
Si la memoria a largo plazo que realmente necesita es un registro de clientes compartido y no un vector store construido a medida, el resumen de herramientas CRM es un punto de partida más directo, y la guía de compra de software de knowledge base cubre la versión a nivel de organización del mismo problema.
Errores de memoria que realmente duelen
Tratar una ventana de contexto en crecimiento como memoria. Un hilo de chat largo no es lo mismo que la memoria a largo plazo. Desaparece en cuanto termina la sesión y, según la investigación sobre degradación del contexto citada antes, un modelo no usa de forma confiable un contexto repleto ni siquiera mientras la sesión sigue abierta.
Sin una vía de verificación ni de corrección de la memoria. Los agents pueden recordar algo de forma incorrecta, sobre todo si estaba mal desde la primera vez que se almacenó o si simplemente quedó desactualizado. Construya una forma de que una persona corrija o elimine un recuerdo erróneo, igual que corregiría un campo equivocado en un registro del CRM, o los errores se acumularán en silencio cada vez que el agent los reutilice.
Memoria sin un límite de privacidad. La memoria a largo plazo que abarca clientes o cuentas necesita los mismos controles de acceso que cualquier otro almacén de datos sensibles. Un agent que técnicamente puede ver el historial de otro cliente necesita una regla explícita contra mostrarlo, no solo la suposición de que no surgirá. La gobernanza de la AI cubre el lado de políticas para establecer esos límites.
Memoria que nunca se depura. No todo merece conservarse para siempre. Un almacén de memoria que acumula cada detalle de forma indefinida se vuelve más lento de consultar y más ruidoso al recuperar. Decida qué caduca, qué se resume con el tiempo y qué realmente necesita persistir.
Para conocer con más profundidad la mecánica de cómo los sistemas de AI construyen y gestionan este tipo de comprensión persistente en general, no solo dentro de un único agent, consulte la memoria de la AI, que cubre las arquitecturas de memoria (por sesión, por usuario, por organización y por dominio) y los marcos de privacidad que deberían rodearlas a todas. Esta página se ha centrado en cómo se desarrolla eso dentro del ciclo propio de un agent.
Datos clave
- La memoria a corto plazo mantiene coherente una sola tarea y normalmente vive en la ventana de contexto del modelo. La memoria a largo plazo sobrevive entre sesiones y normalmente vive en una base de datos externa o en un vector store.
- Una ventana de contexto más grande no equivale a una memoria confiable. La investigación de Chroma y el estudio académico «Lost in the Middle» encontraron que la precisión del modelo se degrada mucho antes de alcanzar los límites de contexto anunciados, sobre todo para la información enterrada en el medio de una entrada larga.
- La memoria a largo plazo y el RAG con frecuencia se ejecutan sobre la misma infraestructura de bases de datos vectoriales. La diferencia es qué se almacena: el historial propio del agent frente a los documentos de referencia de su organización.
- La memoria sin verificar, sin depurar o sin control de acceso es un riesgo real. Construya una vía de corrección, una política de caducidad y límites de privacidad explícitos antes de que la memoria de un agent abarque varios clientes o cuentas.
Preguntas frecuentes sobre la memoria de los AI agents
¿Qué es la memoria de un AI agent?
La memoria de un AI agent es la forma en que un agent lleva el registro de lo que ya ha ocurrido, tanto dentro de una sola tarea (memoria a corto plazo o de trabajo) como en cada interacción futura con la misma cuenta o el mismo usuario (memoria a largo plazo o persistente). La memoria a corto plazo normalmente vive en la ventana de contexto del modelo. La memoria a largo plazo vive en una base de datos externa o en un vector store que el agent consulta.
¿Cuál es la diferencia entre la memoria a corto plazo y la memoria a largo plazo de un agent?
La memoria a corto plazo retiene la tarea actual: la conversación hasta ese momento, los pasos ya dados y el plan en curso. Desaparece cuando termina la ejecución. La memoria a largo plazo retiene hechos, interacciones pasadas y estado que deben persistir entre sesiones, almacenados fuera del modelo en una base de datos o un vector store, y es lo que hace que un agent sea consistente de una interacción a la siguiente.
¿Una ventana de contexto más grande resuelve el problema de la memoria?
No por sí sola. Una investigación que probó 18 modelos líderes encontró que la precisión puede degradarse mucho antes de que una ventana de contexto esté llena, y que los modelos manejan mejor la información colocada al inicio o al final de un contexto largo que la enterrada en el medio. Trate la ventana de contexto como un espacio de borrador rápido y limitado, y envíe lo que deba persistir a un almacenamiento a largo plazo en lugar de simplemente alargar los prompts.
¿En qué se diferencia la memoria del agent del RAG?
Con frecuencia comparten la misma infraestructura de fondo, una base de datos vectorial que almacena y recupera información por significado. La diferencia está en qué se almacena y para qué: el RAG normalmente recupera de los documentos de referencia de su organización para fundamentar una respuesta, mientras que la memoria a largo plazo recupera el historial acumulado del propio agent con una tarea, un usuario o una cuenta específicos.
¿Puede estar equivocada la memoria de un AI agent?
Sí. Un agent puede almacenar algo de forma incorrecta la primera vez, o un hecho almacenado puede simplemente quedar desactualizado a medida que cambian las circunstancias. Los sistemas de memoria en producción necesitan una forma de que una persona revise, corrija o elimine un recuerdo erróneo, la misma disciplina que aplicaría a cualquier otro sistema de registro, o los errores se acumulan en silencio cada vez que el agent los reutiliza.
A dónde ir a continuación
La memoria es lo que permite que un agent actúe de forma consistente en lugar de volver a aprender su negocio desde cero en cada ejecución. Combínela con RAG para AI agents para fundamentar al agent en documentos que no necesita memorizar, y con cómo evaluar y probar AI agents para detectar la deriva de la memoria, como un dato desactualizado o un contexto creciente que perjudica en silencio la precisión, antes de que llegue a un cliente. Para ver los componentes básicos en los que encaja la memoria de forma más amplia, cómo funcionan los AI agents cubre el ciclo completo.
