Memória de AI Agents: Curto Prazo, Longo Prazo e Vector Stores
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
A memória de um AI agent é a forma como ele acompanha o que já aconteceu, tanto dentro de uma única tarefa quanto em todas as interações futuras com a mesma conta ou o mesmo usuário. A memória de curto prazo (de trabalho) guarda a execução atual para que o agent não se repita nem perca o fio da meada. A memória de longo prazo (persistente), geralmente armazenada em um banco de dados ou em um vector store que o agent consegue pesquisar, guarda fatos e histórico entre sessões para que o agent não comece do zero a cada vez. Sem as duas, um agent esquece o que acabou de fazer ou esquece tudo o que já aprendeu sobre você assim que a conversa termina.
Por Que um Agent Precisa de Memória
A memória é uma das cinco partes que fazem de um software um agent em vez de um simples chatbot ou script, ao lado de percepção, raciocínio, ferramentas e autonomia limitada. Um modelo de linguagem comum não tem memória por padrão. Você pergunta, ele responde, e a pergunta seguinte começa do zero, a menos que você cole de volta toda a conversa anterior. Isso basta para uma única pergunta. Desmorona assim que uma tarefa tem mais de uma etapa.
Imagine um agent rodando uma sequência de follow-up de vendas; o AI Follow-Up Agent é um exemplo real. A primeira etapa sai. Passam três dias sem resposta. A segunda etapa precisa vir por um ângulo diferente do da primeira, porque repetir o mesmo discurso parece spam e um vendedor nunca faria isso. A única forma de o agent saber que deve variar a mensagem é lembrar o que já enviou, para quem e como a pessoa respondeu. Isso é a memória fazendo trabalho de verdade, e não um item opcional.
Memória de Curto Prazo: O Que Mantém uma Execução Coerente
A memória de curto prazo, ou de trabalho, guarda tudo o que é relevante para a tarefa em andamento: a conversa até agora, as etapas já executadas, o plano em que o agent está no meio do caminho. Ela normalmente vive dentro da janela de contexto do modelo, a quantidade de texto que o modelo consegue considerar de uma vez, e desaparece quando a tarefa termina, a menos que algo a grave de propósito em um lugar mais permanente antes.
O limite prático aqui não é só quanto texto cabe. As janelas de contexto cresceram enormemente, os modelos de ponta atuais oferecem janelas de centenas de milhares até mais de um milhão de tokens, mas uma janela maior não é o mesmo que uso confiável de tudo o que há dentro dela. A pesquisa de 2025 da Chroma sobre desempenho em contexto longo, que testou 18 modelos de ponta, constatou que a precisão pode começar a cair bem antes de o modelo ficar sem espaço, às vezes já aos 50.000 tokens de uma janela de 200.000, e que um modelo com janela de 1 milhão de tokens não raciocina de forma confiável sobre o milhão inteiro. Os pesquisadores constataram que, mesmo em modelos de 2 milhões de tokens, o orçamento seguro para trabalho de alta precisão tende a ficar mais perto de 150.000 a 400.000 tokens, bem abaixo do número no rótulo. Um estudo acadêmico relacionado e muito citado, o Lost in the Middle de Liu et al., constatou que os modelos usam visivelmente melhor a informação colocada no início ou no fim de um contexto longo do que a enterrada no meio, mesmo quando o modelo foi explicitamente construído para lidar com entradas longas.
A conclusão para quem constrói um agent: não trate a janela de contexto como um espaço de rascunho ilimitado. Encher a janela com todas as mensagens passadas, todos os documentos recuperados e todos os resultados de ferramentas "só por precaução" piora o desempenho em vez de melhorá-lo. Mantenha a memória de trabalho no que a etapa atual realmente precisa e empurre todo o resto para um armazenamento de longo prazo que o agent possa consultar sob demanda.
Memória de Longo Prazo: O Que Sobrevive Além da Execução Atual
A memória de longo prazo é o que torna um agent consistente de uma interação para a outra, em vez de reaprender a sua conta, as suas preferências e o seu histórico toda vez. Ela vive fora do modelo, normalmente em um banco de dados, em um CRM ou em um banco de dados vetorial feito para busca rápida por similaridade, e o agent a consulta como consultaria qualquer outra ferramenta.
Três formatos de memória de longo prazo aparecem com mais frequência na prática:
- Memória episódica, um registro de eventos passados específicos, como o que um cliente perguntou da última vez ou o que foi decidido numa reunião anterior. O Meeting Notes Agent é um exemplo direto: ele produz registros estruturados e com data e hora de decisões e itens de ação justamente para que uma pergunta futura ("já nos comprometemos com isso?") tenha uma resposta real a recuperar, e não um dar de ombros.
- Memória semântica, fatos e preferências generalizados, aprendidos a partir de padrões ao longo do tempo, como saber que uma conta específica sempre quer resumos executivos de menos de 300 palavras, ou que um determinado segmento de clientes costuma fazer churn depois de uma escalação de suporte.
- Contexto procedural, o estado de em que ponto está um processo de várias etapas e várias sessões. O AI Customer Onboarding Agent precisa lembrar quais marcos de configuração uma conta já concluiu ao longo de um processo que pode durar semanas, para empurrar a próxima etapa inacabada em vez de repetir uma já feita ou, pior, pular uma que não foi.
Como a Memória de Longo Prazo é de Fato Armazenada e Pesquisada
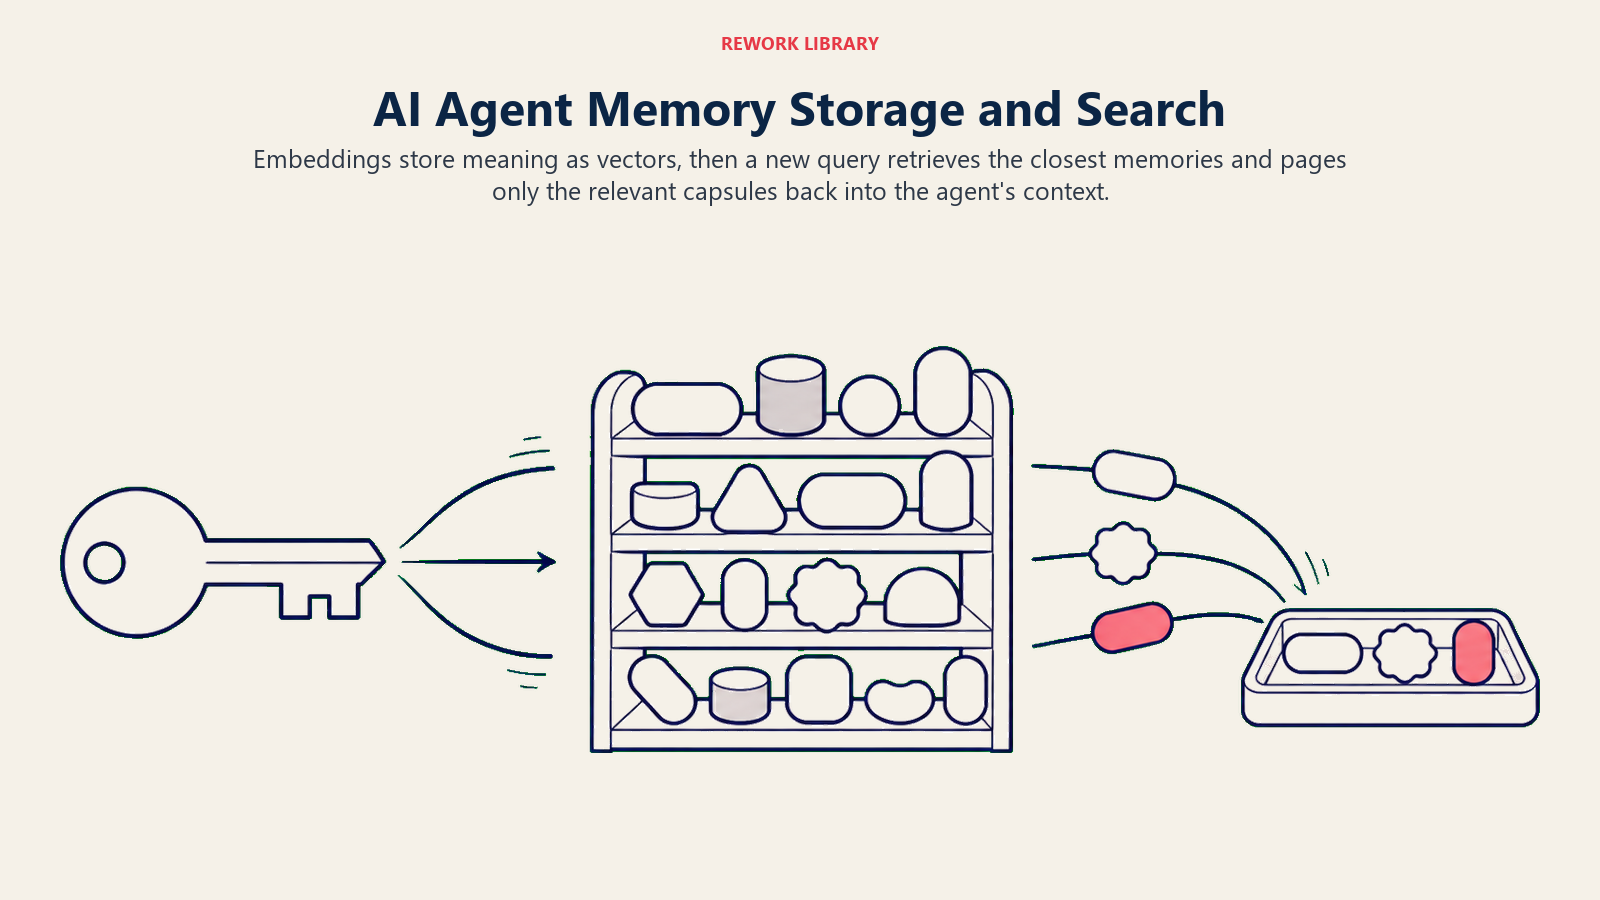
A maior parte da memória de longo prazo que precisa ser pesquisada por significado, e não consultada por um ID exato, acaba em um banco de dados vetorial. Fatos, conversas passadas e trechos de documentos são convertidos em vetores, representações numéricas do seu significado, por meio de um modelo de embedding, e uma consulta é convertida do mesmo modo. O sistema então encontra os vetores armazenados mais próximos da consulta, e é assim que um agent consegue recuperar "a preferência do cliente sobre residência de dados" mesmo que ela tenha sido formulada de um jeito completamente diferente três meses atrás. É o mesmo mecanismo de base abordado em RAG para AI Agents: a memória de longo prazo e a geração aumentada por recuperação (RAG) frequentemente rodam sobre a mesma infraestrutura. A diferença está principalmente no que é armazenado, o histórico acumulado do próprio agent versus os documentos de referência da sua empresa, e não na forma como é recuperado.
Uma proposta de arquitetura influente chamada MemGPT enquadra isso bem. Ela toma emprestada dos sistemas operacionais a ideia de memória em camadas, mantendo uma pequena quantidade de informação "quente" no contexto imediato do modelo e movendo todo o resto para um armazenamento externo mais lento e maior, trazendo a informação de volta apenas quando realmente necessária. É um modelo mental útil mesmo que você nunca toque na implementação do artigo: trate a janela de contexto como uma memória rápida, cara e limitada, e todo o resto como um repositório maior e mais barato que o agent consulta de propósito, em vez de carregá-lo permanentemente.
Se a memória de longo prazo de que você realmente precisa é um registro de cliente compartilhado, e não um vector store construído sob medida, o panorama de ferramentas de CRM é um ponto de partida mais direto, e o guia de compra de software de knowledge base cobre a versão do mesmo problema para toda a organização.
Armadilhas de Memória que Realmente Machucam
Tratar uma janela de contexto crescente como memória. Um longo histórico de chat não é o mesmo que memória de longo prazo. Ele desaparece assim que a sessão termina e, segundo a pesquisa sobre degradação de contexto citada acima, o modelo não usa de forma confiável um contexto entupido, mesmo com a sessão ainda aberta.
Nenhum caminho de verificação ou correção da memória. Os agents podem lembrar algo de forma incorreta, sobretudo se já estava errado quando foi armazenado pela primeira vez, ou se simplesmente ficou desatualizado. Construa uma forma de uma pessoa corrigir ou apagar uma memória ruim, do mesmo jeito que você corrigiria um campo errado em um registro do CRM, ou os erros se acumulam em silêncio a cada vez que o agent os reutiliza.
Memória sem limite de privacidade. A memória de longo prazo que abrange vários clientes ou contas precisa dos mesmos controles de acesso de qualquer outro repositório de dados sensíveis. Um agent que tecnicamente consegue ver o histórico de outro cliente precisa de uma regra explícita contra expô-lo, e não da simples suposição de que isso não vai surgir. Governança de AI cobre o lado das políticas na definição desses limites.
Memória que nunca é podada. Nem tudo vale ser guardado para sempre. Um repositório de memória que acumula cada detalhe indefinidamente fica mais lento para pesquisar e mais ruidoso para recuperar. Decida o que expira, o que é resumido com o tempo e o que realmente precisa persistir.
Para a mecânica mais profunda de como os sistemas de AI constroem e gerenciam esse tipo de entendimento persistente em geral, e não apenas dentro de um único agent, veja Memória de AI, que cobre arquiteturas de memória (por sessão, por usuário, por organização e por domínio) e os frameworks de privacidade que devem cercar todas elas. Esta página se concentrou estritamente em como isso funciona dentro do próprio ciclo de um agent.
Key Facts
- A memória de curto prazo mantém uma única tarefa coerente e normalmente vive na janela de contexto do modelo. A memória de longo prazo sobrevive entre sessões e normalmente vive em um banco de dados externo ou em um vector store.
- Uma janela de contexto maior não é o mesmo que memória confiável. A pesquisa da Chroma e o estudo acadêmico "Lost in the Middle" constataram que a precisão do modelo cai bem antes de os limites de contexto anunciados serem atingidos, sobretudo para informação enterrada no meio de uma entrada longa.
- A memória de longo prazo e o RAG frequentemente rodam sobre a mesma infraestrutura de banco de dados vetorial. A diferença está no que é armazenado: o histórico do próprio agent versus os documentos de referência da sua organização.
- Memória não verificada, não podada ou sem controle de acesso é um risco real. Construa um caminho de correção, uma política de expiração e limites de privacidade explícitos antes de a memória de um agent abranger vários clientes ou contas.
Perguntas Frequentes sobre a Memória de AI Agents
O que é a memória de um AI agent?
A memória de um AI agent é a forma como ele acompanha o que já aconteceu, tanto dentro de uma única tarefa (memória de curto prazo ou de trabalho) quanto em todas as interações futuras com a mesma conta ou o mesmo usuário (memória de longo prazo ou persistente). A memória de curto prazo normalmente vive na janela de contexto do modelo. A de longo prazo vive em um banco de dados externo ou em um vector store que o agent consulta.
Qual é a diferença entre a memória de curto e a de longo prazo de um agent?
A memória de curto prazo guarda a tarefa atual: a conversa até agora, as etapas já executadas, o plano em andamento. Ela desaparece quando a execução termina. A memória de longo prazo guarda fatos, interações passadas e estado que precisam persistir entre sessões, armazenados fora do modelo em um banco de dados ou vector store, e é o que torna um agent consistente de uma interação para a outra.
Uma janela de contexto maior resolve o problema da memória?
Não por si só. Uma pesquisa que testou 18 modelos de ponta constatou que a precisão pode cair bem antes de a janela de contexto ficar cheia, e que os modelos lidam melhor com informação colocada no início ou no fim de um contexto longo do que com a enterrada no meio. Trate a janela de contexto como um espaço de rascunho rápido e limitado e empurre o que precisa persistir para o armazenamento de longo prazo, em vez de apenas alongar os prompts.
Em que a memória de um agent difere do RAG?
Frequentemente compartilham a mesma infraestrutura de base, um banco de dados vetorial que armazena e recupera informação por significado. A diferença está no que é armazenado e por quê: o RAG normalmente recupera dos documentos de referência da sua organização para fundamentar uma resposta, enquanto a memória de longo prazo recupera o histórico acumulado do próprio agent com uma tarefa, um usuário ou uma conta específica.
A memória de um AI agent pode estar errada?
Pode. Um agent pode armazenar algo de forma incorreta na primeira vez, ou um fato armazenado pode simplesmente ficar desatualizado conforme as circunstâncias mudam. Os sistemas de memória em produção precisam de uma forma de uma pessoa revisar, corrigir ou apagar uma memória ruim, a mesma disciplina que você aplicaria a qualquer outro sistema de registro, ou os erros se acumulam em silêncio a cada vez que o agent os reutiliza.
Para Onde Ir Agora
A memória é o que permite a um agent agir de forma consistente em vez de reaprender o seu negócio do zero a cada execução. Combine-a com RAG para AI Agents para fundamentar o agent em documentos que ele não precisa memorizar, e com como avaliar e testar AI agents para pegar a deriva de memória, como um fato desatualizado ou um contexto crescente que prejudica a precisão em silêncio, antes que ela chegue a um cliente. Para os blocos de construção em que a memória se encaixa de forma mais ampla, como os AI agents funcionam cobre o ciclo completo.
